

As profissões de Data Scientist e Data Engineer são frequentemente confundidas. Cada empresa tem sua própria especificidade no trabalho com dados, diferentes objetivos de análise e diferentes percepções sobre qual especialista deve lidar com qual parte do trabalho, portanto, as exigências variam de uma para outra.
Vamos entender qual é a diferença entre esses especialistas, quais problemas de negócios eles resolvem, quais habilidades possuem e quanto ganham. O material acabou sendo extenso, por isso o dividimos em duas publicações.
No primeiro artigo, Elena Gerasimova, chefe da faculdade "" na Netology, explica qual é a diferença entre Data Scientist e Data Engineer e com quais ferramentas eles trabalham.
Como diferenciar as funções de engenheiros e cientistas de dados
O engenheiro de dados é um especialista que, de um lado, desenvolve, testa e mantém a infraestrutura de trabalho com dados: bancos de dados, armazéns e sistemas de processamento em massa. Por outro lado, ele é responsável por limpar e "organizar" os dados para uso por analistas e data scientists, ou seja, cria pipelines de processamento de dados.
O Data Scientist cria e treina modelos preditivos (e não só) usando algoritmos de aprendizado de máquina e redes neurais, ajudando as empresas a encontrar padrões ocultos, prever desenvolvimentos e otimizar processos de negócios cruciais.
A principal diferença entre Data Scientist e Data Engineer é que, geralmente, eles têm objetivos diferentes. Ambos trabalham para que os dados sejam acessíveis e de alta qualidade. No entanto, o Data Scientist procura respostas para suas perguntas e valida hipóteses no ecossistema de dados (por exemplo, em uma base Hadoop), enquanto o Data Engineer cria o pipeline para manter o algoritmo de aprendizado de máquina desenvolvido pelo cientista de dados em um cluster Spark dentro do mesmo ecossistema.
O engenheiro de dados traz valor para o negócio, trabalhando em equipe. Sua tarefa é atuar como um elo importante entre diferentes participantes: desde desenvolvedores até consumidores de relatórios de negócios — e aumentar a produtividade dos analistas — desde os de marketing e de produto até os de BI.
O Data Scientist, por outro lado, participa ativamente da estratégia da empresa e na extração de insights, na tomada de decisões, na implementação de algoritmos de automatização, modelagem e na geração de valor a partir dos dados.
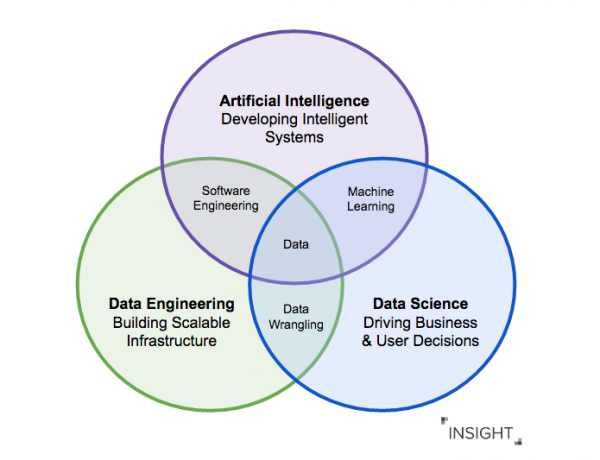
O trabalho com dados segue o princípio GIGO (garbage in — garbage out): se os analistas e cientistas de dados lidarem com dados não preparados e potencialmente incorretos, os resultados, mesmo com os algoritmos de análise mais sofisticados, serão imprecisos.
Os engenheiros de dados resolvem esse problema construindo pipelines para processamento, limpeza e transformação de dados, permitindo que o cientista de dados trabalhe já com dados de qualidade.
No mercado, há muitas ferramentas para trabalhar com dados que cobrem cada uma das etapas: desde o surgimento dos dados até a apresentação em um dashboard para o conselho. E é importante que a decisão de usá-las seja tomada pelo engenheiro, não porque está na moda, mas porque realmente ajudará os outros participantes do processo.
De forma condicional: se uma empresa precisa integrar BI e ETL — carregamento de dados e atualizações de relatórios, aqui está uma típica infraestrutura legada com a qual um Engenheiro de Dados terá que lidar (é bom se, além dele, houver também um arquiteto na equipe).
Responsabilidades do Engenheiro de Dados
- Desenvolvimento, construção e manutenção da infraestrutura de trabalho com dados.
- Tratamento de erros e criação de pipelines de processamento de dados confiáveis.
- Transformação de dados não estruturados de várias fontes dinâmicas em um formato necessário para o trabalho dos analistas.
- Fornecimento de recomendações para aumentar a consistência e a qualidade dos dados.
- Garantia e suporte da arquitetura de dados utilizada pelos cientistas de dados e analistas.
- Processamento e armazenamento de dados de forma sequencial e eficiente em um cluster distribuído de dezenas ou centenas de servidores.
- Avaliação de compromissos técnicos de ferramentas para criar arquiteturas simples, mas robustas, que possam suportar falhas.
- Monitoramento e manutenção dos fluxos de dados e sistemas relacionados (configuração de monitoramento e alertas).
Há uma outra especialização dentro da trajetória do Engenheiro de Dados — o engenheiro de ML. Resumindo, esses engenheiros se especializam em levar modelos de machine learning à produção e uso. Muitas vezes, o modelo fornecido pelo cientista de dados é parte de uma pesquisa e pode não funcionar em condições reais.
Responsabilidades do Cientista de Dados
- Extração de características dos dados para a aplicação de algoritmos de machine learning.
- Uso de diversas ferramentas de aprendizado de máquina para prever e classificar padrões nos dados.
- Melhora do desempenho e da precisão dos algoritmos de aprendizado de máquina por meio do ajuste fino e da otimização dos algoritmos.
- Formação de hipóteses "fortes" de acordo com a estratégia da empresa, que precisam ser testadas.
Tanto o Data Engineer quanto o Data Scientist compartilham uma contribuição significativa para o desenvolvimento da cultura de trabalho com dados, através da qual a empresa pode gerar receita adicional ou reduzir custos.
Com quais linguagens e ferramentas trabalham engenheiros e cientistas de dados
Hoje, as expectativas em relação aos especialistas em processamento de dados mudaram. Antes, os engenheiros criavam grandes consultas SQL, escreviam manualmente MapReduce e processavam dados utilizando ferramentas como Informatica ETL, Pentaho ETL, Talend.
Em 2020, um especialista não pode prescindir do conhecimento de Python e das modernas ferramentas de computação (como Airflow), além do entendimento dos princípios de trabalho com plataformas em nuvem (usando-as para economizar em "hardware", respeitando os princípios de segurança).
SAP, Oracle, MySQL, Redis são ferramentas tradicionais para engenheiros de dados em grandes empresas. Elas são boas, mas o custo das licenças é tão alto que vale a pena aprender a trabalhar com elas apenas em projetos industriais. Neste contexto, existe uma alternativa gratuita na forma do Postgres — é gratuito e serve não só para aprendizado.
Historicamente, a demanda por Java e Scala é comum, embora, à medida que as tecnologias e abordagens evoluam, essas linguagens estejam perdendo espaço.
No entanto, a Big Data hardcore: Hadoop, Spark e outros da mesma categoria já não são requisitos obrigatórios para um engenheiro de dados, mas sim uma variedade de ferramentas para resolver problemas que não podem ser resolvidos com ETL tradicional.
A tendência é serviços que utilizam ferramentas sem o domínio da linguagem em que foram escritas (como Hadoop sem conhecimento de Java), além da oferta de serviços prontos para o processamento de dados em tempo real (como reconhecimento de voz ou imagem em vídeo).
Soluções industriais da SAS e SPSS são populares, enquanto Tableau, Rapidminer, Stata e Julia também são amplamente utilizados por cientistas de dados para tarefas locais.
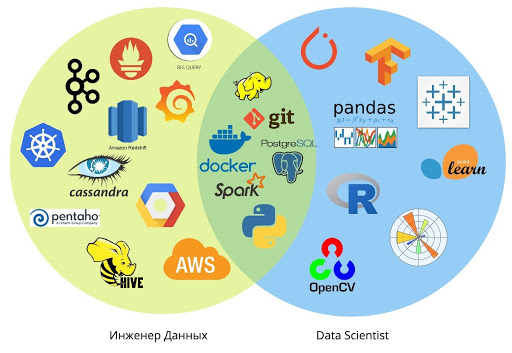
A capacidade de construir pipelines tornou-se disponível para analistas e cientistas de dados há apenas alguns anos: por exemplo, já é possível direcionar dados para um armazenamento baseado em PostgreSQL com scripts relativamente simples.
Geralmente, o uso de pipelines e estruturas de dados integradas permanece sob a responsabilidade dos engenheiros de dados. Mas hoje, mais do que nunca, há uma forte tendência em especialidades T — com amplas competências em áreas relacionadas, já que as ferramentas estão se tornando cada vez mais simples.
Por que Data Engineer e Data Scientist devem trabalhar juntos
Trabalhando em estreita colaboração com engenheiros, os Data Scientists podem se concentrar na parte de pesquisa, criando algoritmos de aprendizado de máquina prontos para uso.
E os engenheiros podem se concentrar na escalabilidade, reutilização de dados e garantir que os pipelines de entrada e saída de dados em cada projeto atendam à arquitetura global.
Essa divisão de responsabilidades assegura a consistência entre os grupos de especialistas que trabalham em diferentes projetos de aprendizado de máquina.
A colaboração ajuda a criar novos produtos de forma eficaz. Velocidade e qualidade são alcançadas através do equilíbrio entre a criação de um serviço para todos (armazenamento global ou integração de dashboards) e a implementação de cada necessidade ou projeto específico (pipeline especializado, conexão com fontes externas).
Trabalhar de perto com cientistas de dados e analistas ajuda os engenheiros a desenvolver habilidades analíticas e de pesquisa para escrever um código de maior qualidade. A troca de conhecimentos entre os usuários de armazenamentos e lagos de dados melhora, tornando os projetos mais flexíveis e proporcionando resultados a longo prazo mais sustentáveis.
Em empresas que visam desenvolver uma cultura de trabalho com dados e estruturar processos de negócios com base neles, Data Scientists e Data Engineers se complementam e criam um sistema completo de análise de dados.
No próximo material, falaremos sobre qual formação deve ter um Data Engineer e Data Scientist, quais habilidades eles precisam desenvolver e como é o mercado.
Da redação da Netologia
Se você está considerando a profissão de Data Engineer ou Data Scientist, convidamos você a explorar os programas de nossos cursos:
- A profissão de “».
- A profissão de “».
Fonte: habr.com
