

O relatório apresenta algumas abordagens que permitem monitorar o desempenho de consultas SQL, quando são milhões por dia, e servidores PostgreSQL gerenciados — centenas.
Quais soluções técnicas nos permitem processar eficientemente esse volume de informações, e como isso facilita a vida do desenvolvedor comum.
Para quem se interessa na análise de problemas específicos e diferentes técnicas de otimização de consultas SQL e na solução de tarefas típicas de DBA no PostgreSQL — pode também sobre este tema.
Meu nome é Kirill Borovikov, eu represento . Especificamente, eu me especializo em trabalhar com bancos de dados em nossa empresa.
Hoje eu vou contar como fazemos a otimização de consultas, quando você precisa não apenas 'diagnosticar' o desempenho de uma única consulta, mas resolver o problema em massa. Quando são milhões de consultas, e você precisa encontrar algumas abordagens para a solução desse grande problema.
De fato, 'Tensor' para um milhão de nossos clientes — é : uma rede social corporativa, soluções para videoconferência, para a troca de documentos internos e externos, sistemas de contabilidade e armazenamento,… Ou seja, um 'megacompressor' para a gestão abrangente de negócios, com mais de 100 projetos internos diferentes.
Para que todos eles funcionem e se desenvolvam corretamente — temos 10 centros de desenvolvimento em todo o país, com mais de 1000 desenvolvedores.
Trabalhamos com PostgreSQL desde 2008 e acumulamos um grande volume do que processamos — são dados de clientes, dados estatísticos, analíticos, dados de sistemas de informação externos — mais de 400TB. Apenas 'em produção' cerca de 250 servidores, e ao todo, os servidores de banco de dados que monitoramos são cerca de 1000.
SQL é uma linguagem declarativa. Você descreve não 'como' algo deve funcionar, mas 'o que' você quer obter. O SGBD sabe melhor como fazer um JOIN — como conectar suas tabelas, quais condições impor, o que irá pelo índice, o que não irá…
Alguns SGBDs aceitam sugestões: 'Não, conecte essas duas tabelas em tal ordem', mas o PostgreSQL não faz assim. Essa é uma posição deliberada dos principais desenvolvedores: 'É melhor melhorarmos o otimizador de consultas do que permitir que os desenvolvedores usem algumas dicas'.
No entanto, apesar de o PostgreSQL não permitir a gestão externa, ele permite entender o que acontece internamente, quando você executa sua consulta, e onde surgem seus problemas.
De modo geral, quais problemas clássicos o desenvolvedor [para o DBA] costuma trazer? "Fizemos uma consulta e tudo está lento, tudo travou, algo está acontecendo… É um desastre!"
As causas são quase sempre as mesmas:
- algoritmo de consulta ineficiente
Desenvolvedor: "Agora tenho 10 tabelas em SQL através de JOIN..." — e espera que suas condições milagrosamente se resolvam eficientemente, e ele obtenha tudo rapidamente. Mas não há milagres, e qualquer sistema com tal variabilidade (10 tabelas em um FROM) sempre apresenta alguma imprecisão. [] - estatísticas desatualizadas
Esse ponto é muito relevante, especialmente para o PostgreSQL, quando você carregou um grande conjunto de dados no servidor, faz uma consulta — e ele está "varrendo" a tabela. Porque ontem havia 10 registros, e hoje 10 milhões, mas o PostgreSQL ainda não está ciente disso e precisa ser informado. [] - um ‘estrangulamento’ de recursos
Você colocou um banco de dados grande e pesado em um servidor fraco, que não tem espaço em disco, memória ou desempenho de CPU suficiente. E é isso... Em algum lugar existe um teto de desempenho, acima do qual você já não consegue ir. - bloqueios
Um ponto complexo, mas que é mais relevante para várias operações modificadoras (INSERT, UPDATE, DELETE) — é um tópico separado e extenso.
Obtenção do plano
… E para todo o resto nós precisamos de um plano! Precisamos ver o que acontece dentro do servidor.
O plano de execução de consulta para o PostgreSQL é uma árvore do algoritmo de execução da consulta em representação textual. É exatamente aquele algoritmo que, após análise pelo planejador, foi considerado o mais eficiente.
Cada nó da árvore é uma operação: extração de dados da tabela ou índice, construção de uma bitmap, junção de duas tabelas, união, interseção ou exclusão de conjuntos. A execução da consulta é a passagem pelos nós dessa árvore.
Para obter o plano da consulta, o método mais simples é executar o operador EXPLAIN. Para obter com todos os atributos reais, ou seja, para realmente executar a consulta no banco — EXPLAIN (ANALYZE, BUFFERS) SELECT ....
Momento ruim: quando você o executa, isso acontece "aqui e agora", portanto, só é adequado para depuração local. Se você pega um servidor de alta carga, que está sob um forte fluxo de mudanças de dados, e vê: "Ai! Aqui temos uma execução lenta de umasolicitação." Meia hora, uma hora atrás — enquanto você corria e tirava essa solicitação dos logs, levando-a novamente ao servidor, todo o seu conjunto de dados e estatísticas tinham mudado. Você a executa para depurar — e ela executa rapidamente! E você não consegue entender "por quê", por que lenta. era Para entender o que aconteceu exatamente no momento em que a solicitação é executada no servidor, pessoas inteligentemente escreveram
o módulo auto_explain Se ele entende que uma determinada solicitação está levando mais tempo do que o limite que você definiu, ele faz
um "snapshot" do plano dessa solicitação e escreve tudo junto no log. Parece que tudo está bom agora, vamos ao log e vemos lá… [bloco de texto]. Mas não podemos dizer nada sobre ele, além do fato de que é um ótimo plano, porque levou 11ms..
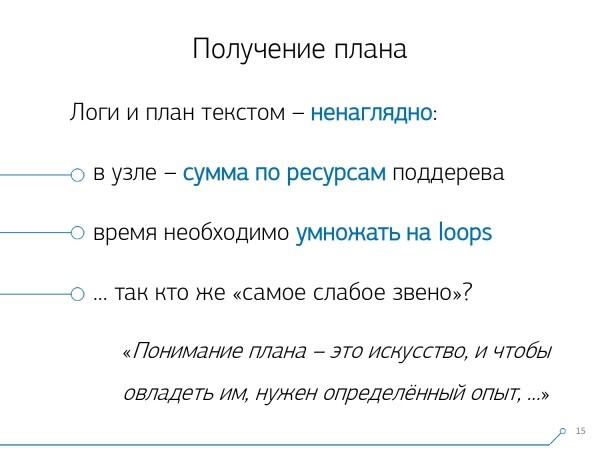
Parece que tudo está bem — mas nada é claro sobre o que realmente aconteceu. Além do tempo geral, não vemos nada em particular. Porque olhar para esse "monte" de texto simples não é muito elucidativo.
Mas mesmo que não seja elucidativo, e seja inconveniente, existem problemas mais sérios:
No nó, é indicado
- o total de recursos de toda a subárvore abaixo dele. Ou seja, não é possível saber apenas assim, quanto tempo foi gasto especificamente nesta digitalização de índice — se houver alguma condição aninhada abaixo dele. Precisamos olhar dinamicamente se não há "filhos" internos e variáveis condicionais, CTE — e subtrair tudo isso "na cabeça". O segundo ponto: o tempo indicado no nó é
- o tempo de execução único do nó . Se esse nó foi executado como resultado, por exemplo, de um loop através das entradas da tabela, várias vezes, então o plano aumenta o número de loops — ciclos desse nó. Mas o tempo de execução atômico permanece o mesmo no plano. Ou seja, para entender quanto tempo esse nó foi executado ao todo, é preciso multiplicar um pelo outro — novamente "na cabeça".. Se esse nó foi executado como resultado, por exemplo, de um loop sobre registros de tabela, várias vezes, então, no plano, aumenta o número de loops — ciclos desse nó. Mas o tempo de execução atômica permanece no plano o mesmo. Ou seja, para entender quantas vezes esse nó foi executado no total, é preciso multiplicar um pelo outro — novamente, 'na mente'.
Com essas condições, entender "Quem é o elo mais fraco?" é praticamente impossível. Portanto, até os próprios desenvolvedores escrevem em seu "manual" que "Entender o plano é uma arte que precisa ser aprendida, uma experiência...".
Mas temos 1000 desenvolvedores, e não é possível transmitir essa experiência a cada um deles. Eu, você, ele — sabemos, mas alguém lá atrás — talvez não. Pode ser que ele aprenda, mas talvez não, mas ele precisa trabalhar agora — e de onde ele tiraria essa experiência.
Visualização do plano
Por isso, entendemos que para lidarmos com esses problemas, precisamos de uma boa visualização do plano.
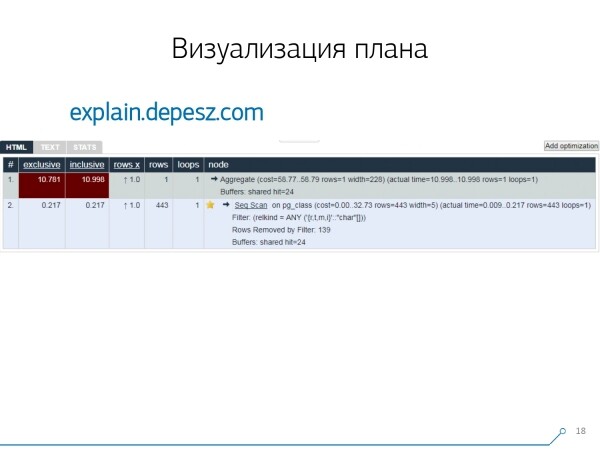
Primeiro, fomos "pelo mercado" — vamos procurar na internet o que existe.
Mas, na verdade, é difícil encontrar soluções "vivas" que estejam mais ou menos desenvolvidas — literalmente, uma: de Hubert Lubaczewski. Você insere uma representação textual do plano, ele te mostra uma tabela com os dados analisados:
- o tempo de execução do nó
- o tempo total de toda a subárvore
- o número de registros que foram extraídos e que eram estatisticamente esperados
- o próprio corpo do nó
Esse serviço também possui a opção de compartilhar um arquivo de links. Você colocou seu plano lá e disse: "Ei, Vasya, aqui está o link, tem algo errado aí".
Mas existem alguns problemas pequenos.
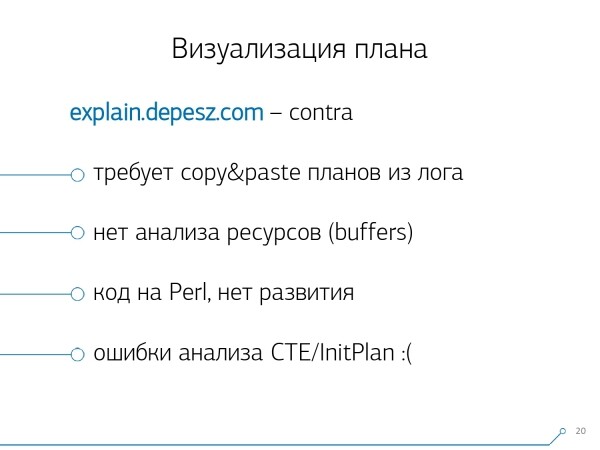
Primeiro, uma quantidade enorme de "copy-paste". Você pega um pedaço do log, insere lá, e novamente, e novamente.
Em segundo lugar, não há análise da quantidade de dados lidos — aqueles mesmos buffers que são exibidos por EXPLAIN (ANALYZE, BUFFERS), aqui não vemos. Ele simplesmente não é capaz de analisá-los, entendê-los e trabalhar com eles. Quando você lê muitos dados e percebe que pode não estar se organizando corretamente no disco e no cache da memória, essa informação é muito importante.
O terceiro ponto negativo — o desenvolvimento deste projeto é muito fraco. Os commits são muito pequenos, se aparecem, é uma vez a cada seis meses, e o código está em Perl.
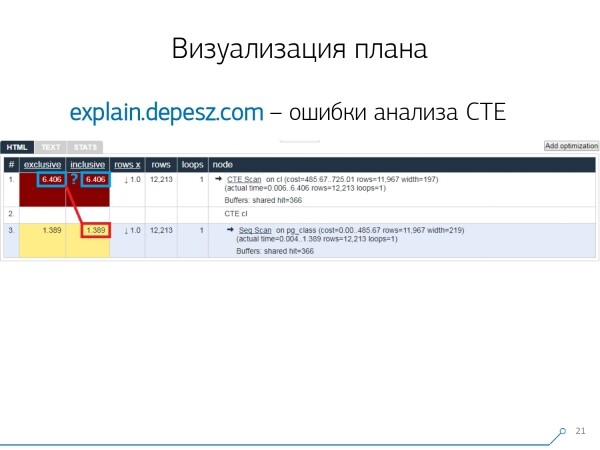
Mas isso é toda "lírica", com isso até poderíamos conviver, mas há uma coisa que realmente nos afastou desse serviço. São os erros na análise de Common Table Expression (CTE) e diferentes nós dinâmicos como InitPlan/SubPlan.
Se acreditarmos nesta imagem, o tempo total de execução de cada nó individual é maior do que o tempo total de execução de toda a consulta. É simples — não descontaram o tempo de geração dessa CTE do nó CTE Scan.. Portanto, já não sabemos a resposta correta sobre quanto tempo levou a própria varredura CTE.
Aqui percebemos que era hora de criar o nosso próprio — uhu! Cada desenvolvedor diz: "Agora vamos escrever o nosso, vai ser super simples!"
Usamos um stack típico para serviços web: núcleo em Node.js + Express, incorporamos o Bootstrap e para os gráficos bonitos — D3.js. E nossas expectativas foram plenamente atendidas — conseguimos o primeiro protótipo em 2 semanas:
- um parser de plano próprio
Ou seja, agora podemos analisar qualquer plano gerado pelo PostgreSQL. - análise correta de nós dinâmicos — CTE Scan, InitPlan, SubPlan
- análise da distribuição de buffers — onde as páginas de dados são lidas da memória, onde do cache local, onde do disco
- obtivemos clareza visual
Para não ter que 'cavar' tudo isso no log, mas ver o 'elo mais fraco' imediatamente na imagem.
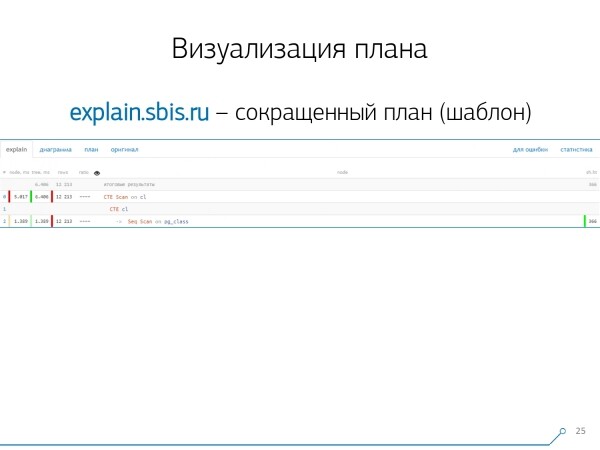
Obtivemos uma imagem semelhante a esta — imediatamente com destaque de sintaxe. Mas geralmente nossos desenvolvedores trabalham não com a representação completa do plano, mas com algo mais curto. Depois de que todos os números foram analisados e deixados de lado, apenas a primeira linha foi mantida, informando qual é o nó: CTE Scan, geração de CTE ou Seq Scan de alguma tabela.
Essa representação resumida chamamos de modelo de plano.
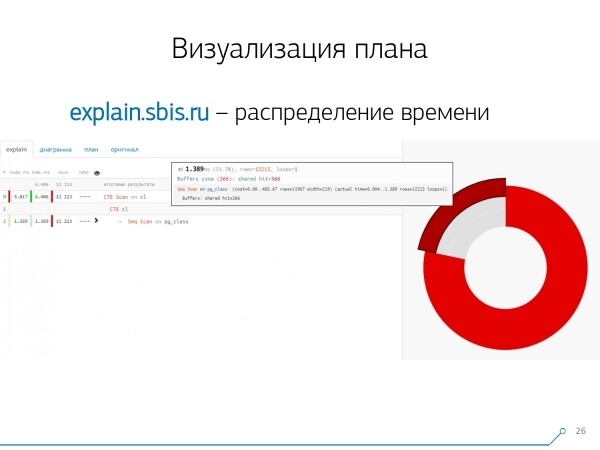
O que mais seria conveniente? Seria útil ver qual a proporção de tempo alocada para cada nó em relação ao total — e simplesmente 'colar' ao lado gráfico de pizza.
Colocamos o mouse sobre o nó e vemos — na verdade, o Seq Scan levou menos de um quarto do tempo total, enquanto os outros 3/4 foram consumidos pelo CTE Scan. Terrível! Esse pequeno comentário sobre a 'rapidez' do CTE Scan, caso você os use ativamente em suas consultas. Eles não são muito rápidos — perdem até para a varredura de tabela comum.
Mas geralmente tais gráficos são mais interessantes e complexos, quando imediatamente ao parar sobre um segmento, vemos, por exemplo, que mais da metade do tempo foi 'consumida' por algum Seq Scan. E ainda dentro dele havia algum Filter, uma tonelada de registros descartados por ele... Podemos simplesmente enviar essa imagem para o desenvolvedor e dizer: "Vasya, aqui está tudo muito ruim! Investigue, olhe — algo não está certo!"
Naturalmente, sem 'trapaças' não foi possível.
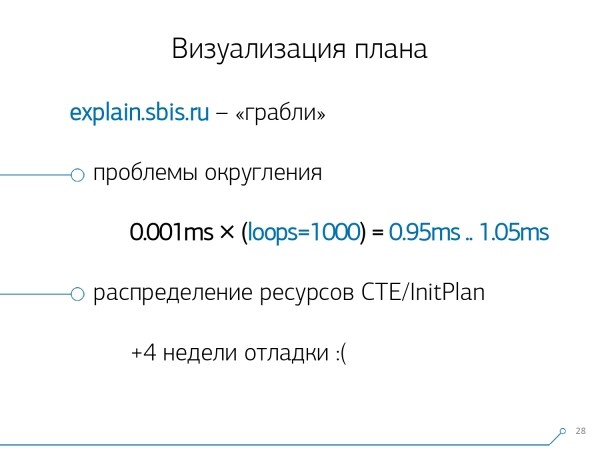
O primeiro problema que encontramos foi o arredondamento. O tempo do nó de cada parte do plano é indicado com uma precisão de 1 µs. E quando o número de ciclos do nó excede, por exemplo, 1000 — após a execução, o PostgreSQL divide com precisão, então ao calcular de volta obtemos um tempo total "entre 0,95 ms e 1,05 ms". Quando lidamos com microssegundos, ainda não é um grande problema, mas quando já estamos lidando com [mil]issegundos, precisamos considerar essa informação ao "desvincular" os recursos entre os nós do plano relacionados a "quem consumiu o quê".
O segundo ponto, mais complexo, é a distribuição de recursos (aqueles buffers) entre os nós dinâmicos. Isso nos custou cerca de quatro semanas adicionais nos primeiros dois meses do protótipo.
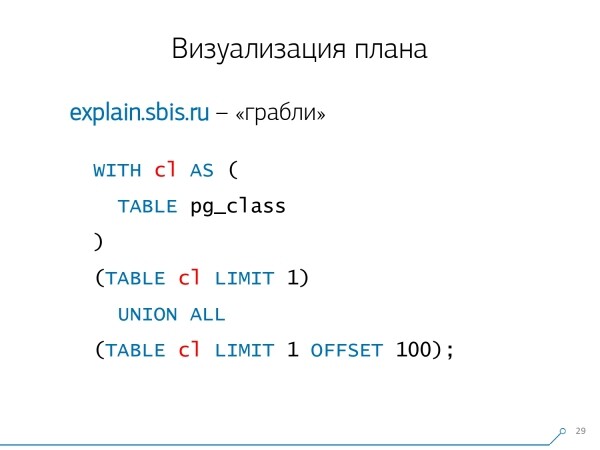
É bastante fácil se deparar com tal problema — criamos um CTE e aparentemente lemos algo nele. Na verdade, o PostgreSQL é "inteligente" e não fará leituras diretas ali. Depois, pegamos o primeiro registro dele, e a partir disso — o centésimo primeiro do mesmo CTE.
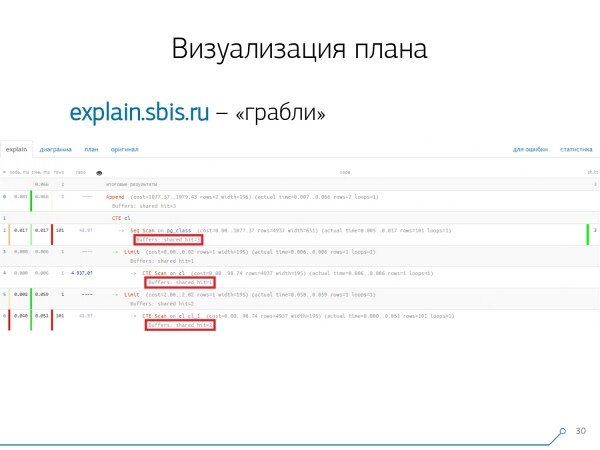
Observamos o plano e percebemos — é estranho, tivemos 3 buffers (páginas de dados) "consumidos" em um Seq Scan, mais 1 em um CTE Scan, e outros 2 em segundo CTE Scan. Ou seja, se somarmos tudo, teremos 6, mas na verdade lemos apenas 3 da tabela! O CTE Scan não lê de nenhum lugar, ele trabalha diretamente com a memória do processo. Então, claramente, algo não está certo!
Na verdade, o que acontece é que essas 3 páginas de dados, que foram solicitadas do Seq Scan, foram inicialmente solicitadas por 1º CTE Scan, depois 2º CTE Scan pediu e leu mais 2. Ou seja, no total, foram lidas 3 páginas de dados, não 6.
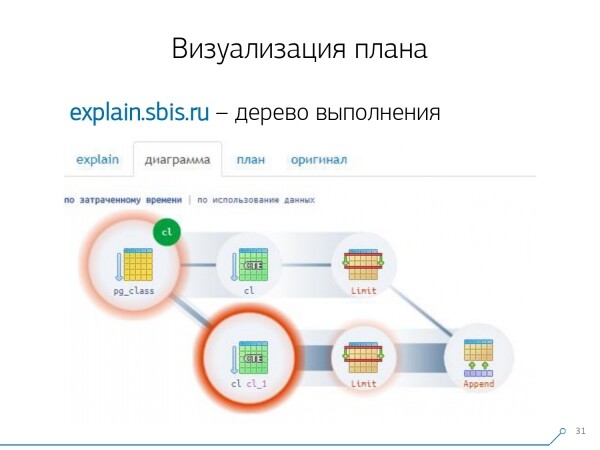
E essa imagem nos levou à compreensão de que a execução do plano não é mais uma árvore, mas apenas algum tipo de grafo acíclico. E acabamos com um diagrama assim, para que pudéssemos entender "de onde veio o quê". Aqui criamos um CTE a partir de pg_class, e a solicitamos duas vezes, e praticamente todo o nosso tempo foi gasto na ramificação quando a pedimos pela segunda vez. É claro que ler o 101º registro é muito mais caro do que simplesmente ler o 1º da tabela.

Nós respiramos aliviados por um tempo. Dissemos: "Agora, Neo, você sabe kung-fu! Agora nossa experiência está bem na sua tela. Agora você pode usá-la."
Consolidação de logs
Nossos 1000 desenvolvedores respiraram aliviados. Mas nós sabemos que temos apenas centenas de servidores "em operação", e toda essa "copia e cola" por parte dos desenvolvedores não é nada conveniente. Percebemos que precisávamos montar isso nós mesmos.
Na verdade, existe um módulo padrão que coleta estatísticas, mas também é necessário ativá-lo na configuração — este é o . Mas não nos satisfez.
Primeiro, para as mesmas consultas em diferentes esquemas dentro de uma mesma base, ele atribui IDs de Consulta diferentes. Ou seja, se fizermos primeiro SET search_path = '01'; SELECT * FROM user LIMIT 1;, e depois SET search_path = '02'; e fizermos a mesma consulta, a estatística desse módulo mostrará registros diferentes, e eu não poderei reunir estatísticas gerais com base nesse perfil de consulta, sem considerar os esquemas.
O segundo ponto que nos impediu de usá-lo foi a falta de planos. Ou seja, não há plano — há apenas a consulta. Vemos o que estava lento, mas não entendemos o porquê. E aqui voltamos ao problema do conjunto de dados em rápida mudança.
E o último ponto é a falta de "fatos". Ou seja, não podemos nos referir a uma instância específica da execução da consulta — ela não existe, apenas estatísticas agregadas. Embora seja possível trabalhar com isso, é muito difícil.
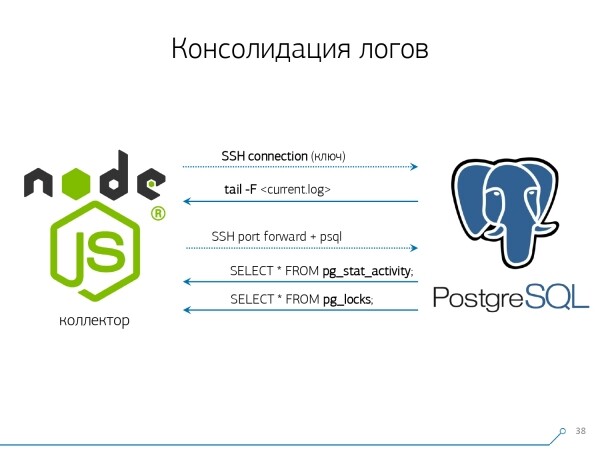
Portanto, decidimos combater a "copia e cola" e começamos a escrever um coletor.
O coletor se conecta via SSH, "estabelece" uma conexão segura até o servidor com o banco de dados usando um certificado e tail -F se "anexa" ao arquivo de log. Dessa forma, nesta sessão obtivemos um completo "espelho" de todo o arquivo de log, que é gerado pelo servidor. A carga no próprio servidor é mínima, pois não estamos fazendo parsing, apenas espelhando o tráfego.
Como já começamos a escrever a interface em Node.js, continuamos a escrever o coletor na mesma tecnologia. E essa tecnologia se mostrou eficaz, porque para trabalhar com dados de texto mal formatados, que são os logs, usar JavaScript é muito conveniente. Além disso, a própria infraestrutura do Node.js como plataforma backend permite trabalhar de forma fácil e conveniente com conexões de rede e, de forma geral, com fluxos de dados.
Assim, estamos "estendendo" duas conexões: a primeira para "ouvir" o log e coletá-lo, e a segunda para perguntar periodicamente ao banco de dados. "Ah, no log foi registrado que a tabela com oid 123 foi bloqueada", mas isso não diz nada ao desenvolvedor, e seria bom perguntar ao banco: "O que é exatamente esse OID = 123?" E assim, perguntamos ao banco periodicamente o que ainda não sabemos.
"Só uma coisa você não considerou, existe um tipo de abelha parecido com um elefante!.." Começamos a desenvolver este sistema quando queríamos monitorar 10 servidores. Os mais críticos em nossa visão, onde surgiam alguns problemas que eram difíceis de resolver. Mas no primeiro trimestre já recebemos para monitoramento uma centena — porque o sistema "pegou", todos quiseram, foi conveniente para todos.
Tudo isso precisa ser acumulado, o fluxo de dados é grande e ativo. Na verdade, o que monitoramos e com o que sabemos lidar — é isso que usamos. Utilizamos também o PostgreSQL como armazenamento de dados. Não há nada mais rápido para "encher" dados nele do que um operador COPY ainda não existe.
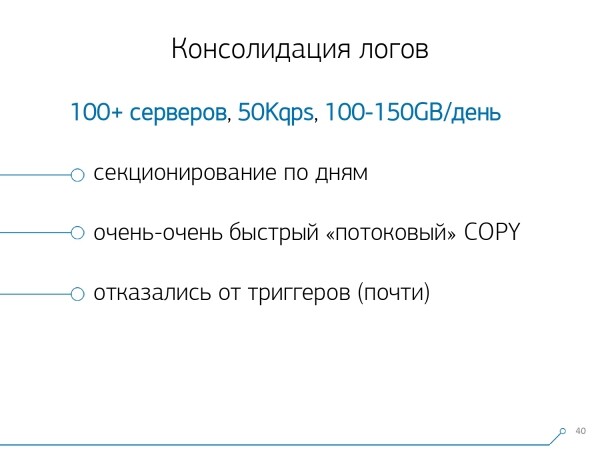
Mas simplesmente "encher" dados não é bem nossa tecnologia. Porque se você tem uma centena de servidores gerando cerca de 50 mil requisições por segundo, isso gera 100-150GB de logs por dia. Portanto, tivemos que trabalhar a base com cuidado.
Em primeiro lugar, fizemos particionamento por dias, porque, na verdade, a correlação entre os dias não interessa a ninguém. Qual é a diferença do que aconteceu ontem, se esta noite você lançou uma nova versão do aplicativo — e já existem novas estatísticas.
Em segundo lugar, aprendemos (fomos obrigados) a escrever muito, muito rápido com a ajuda de COPY. Ou seja, não apenas COPY, porque ele é mais rápido que INSERT, mas até mais rápido.
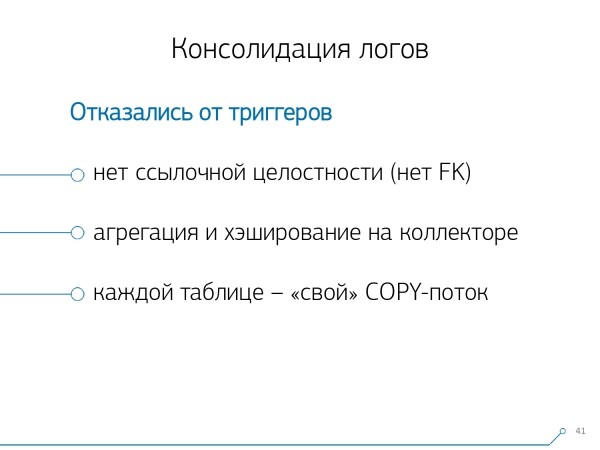
O terceiro ponto — tivemos que abrir mão de gatilhos e, consequentemente, das chaves estrangeiras. Ou seja, não temos integridade referencial de forma alguma. Porque se você tem uma tabela com um par de FKs, e você diz na estrutura do BD que "essa entrada do log se refere por FK, por exemplo, a um grupo de entradas", então, ao inseri-la, o PostgreSQL não tem nada a fazer, exceto executar SELECT 1 FROM master_fk1_table WHERE ... com o identificador que você está tentando inserir — apenas para verificar se essa entrada está lá, se você não está "quebrando" essa chave estrangeira com sua inserção.
Recebemos não apenas uma entrada na tabela de destino e seus índices, mas também lemos de todas as tabelas às quais ela se refere. E isso não é necessário para nós — nosso objetivo é gravar o maior número possível e o mais rápido, com a menor carga. Então, FK — fora!
O próximo ponto é a agregação e a hash. Inicialmente, eles estavam implementados no banco de dados — afinal, é conveniente fazer isso diretamente quando uma entrada chega, em alguma tabelinha. “mais um” diretamente no gatilho.. É bom, conveniente, mas o problema é que você insere uma entrada e é obrigado a ler e gravar algo de outra tabela. E, mais do que isso, não só ler e gravar — você tem que fazer isso toda vez.
Agora imagine que você tem uma tabelinha na qual apenas conta o número de solicitações que passaram por um determinado host: +1, +1, +1, ..., +1. E isso, na verdade, não é necessário — tudo isso pode ser somado na memória no coletor e enviado ao banco de dados de uma só vez. +10.
Sim, no caso de algum problema, a integridade lógica pode "se desmoronar", mas esse é um caso praticamente irreal — porque você tem um servidor normal, uma bateria no controlador, um log de transações, um log no sistema de arquivos... Enfim, não vale a pena. Não vale a perda de desempenho que você obtém em função do funcionamento de gatilhos/FK, os custos que você incorre com isso.
O mesmo se aplica à hash. Chega até você uma solicitação, você calcula um identificador no banco de dados e grava no banco, depois diz a todos. Tudo bem, até o momento da gravação chegar um segundo interessado que queira gravar o mesmo — e você enfrentará um bloqueio, e isso já é ruim. Portanto, se você puder fazer a geração de algum ID no cliente (em relação ao banco), é melhor fazê-lo.
Perfeito para nós foi usar MD5 do texto — solicitação, plano, modelo,... Calculamos isso no lado do coletor e "injetamos" no banco um ID já pronto. O comprimento do MD5 e a partição diária nos permitem não nos preocupar com possíveis colisões.
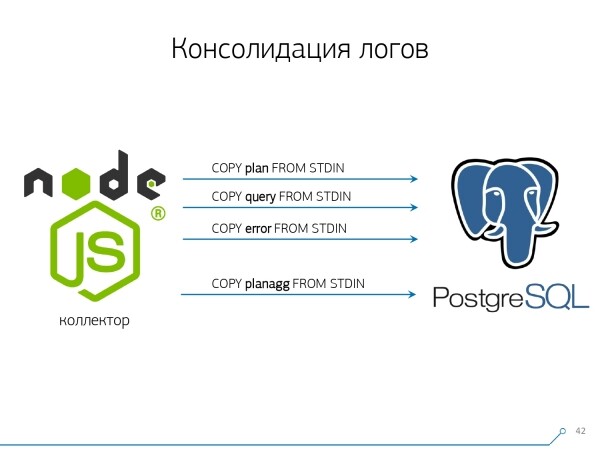
Mas para gravar tudo isso rapidamente, precisávamos modificar o próprio procedimento de gravação.
Como geralmente são escritos os dados? Temos um conjunto de dados, dividimos em várias tabelas e depois fazemos COPY — primeiramente na primeira, depois na segunda, na terceira… É inconveniente, porque parece que estamos escrevendo um único fluxo de dados em três etapas sequenciais. Desagradável. É possível fazer isso mais rápido? Sim!
Para isso, basta distribuir esses fluxos em paralelo uns com os outros. Assim, erros, solicitações, modelos, bloqueios,… estão fluindo em diferentes streams, e escrevemos tudo isso em paralelo. Para isso, é suficiente manter um canal COPY sempre aberto para cada tabela de destino separada.
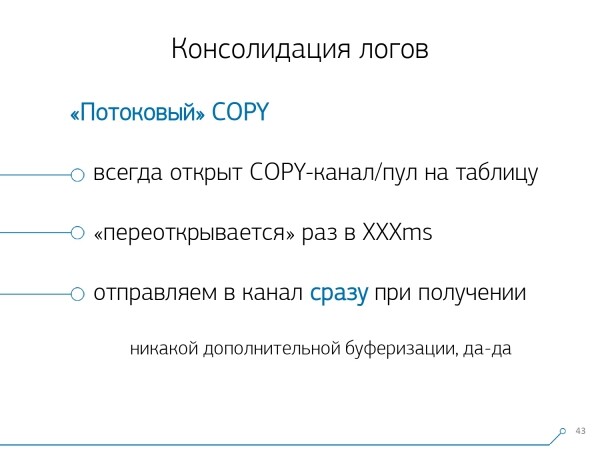
Ou seja, o coletor sempre tem um stream, no qual posso gravar os dados que preciso. Mas para que o banco veja esses dados, e para que ninguém fique preso em bloqueios, esperando que esses dados sejam gravados, o COPY deve ser interrompido com certa periodicidade. Para nós, o período mais eficaz foi de cerca de 100ms — fechamos e imediatamente reabrimos para a mesma tabela. E se tivermos um fluxo insuficiente durante alguns picos, fazemos polling até um limite determinado.
Além disso, descobrimos que para esse perfil de carga, qualquer agregação, quando os registros são coletados em pacotes — isso é um mal. O mal clássico é INSERT ... VALUES e depois 1000 registros. Porque nesse momento, você atinge um pico de gravação no dispositivo, e todos os outros que estão tentando gravar no disco terão que esperar.
Para se livrar de tais anomalias, simplesmente não agregue nada, não bufferize nada. E se a bufferização no disco ainda ocorrer (felizmente, a Stream API no Node.js permite isso), — adie essa conexão. Quando você receber o evento de que ela está disponível novamente — grave nela a partir da fila acumulada. Enquanto estiver ocupada, pegue o próximo livre do pool e grave nele.
Antes da implementação de tal abordagem para gravação de dados, tínhamos cerca de 4K operações de gravação, e com esse método reduzimos a carga em 4 vezes. Agora aumentamos mais 6 vezes devido a novos bancos observáveis — até 100MB/s. E agora armazenamos logs dos últimos 3 meses em um volume de cerca de 10-15TB, esperando que em três meses qualquer problema possa ser resolvido por qualquer desenvolvedor.
Entendemos os problemas
Mas apenas coletar todos esses dados é bom, útil e relevante, mas é pouco — é necessário compreendê-los. Porque são milhões de diferentes planos por dia.
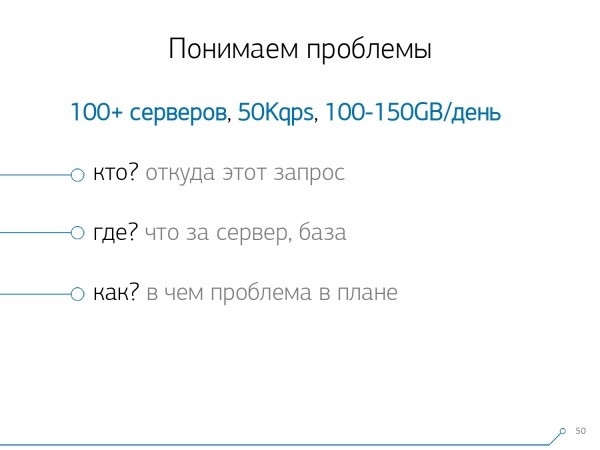
Mas milhões é incontrolável, primeiro precisamos tornar isso "menor". E, em primeiro lugar, devemos decidir como você irá organizar esse "menor".
Destacamos três pontos-chave:
- ele é. essa solicitação foi enviada por
Ou seja, de qual aplicativo ela 'veio': interface web, backend, sistema de pagamento ou algo mais. - onde isso ocorreu
Em qual servidor específico. Porque se você tem vários servidores para um único aplicativo, e de repente um 'parou' (porque 'o disco falhou', 'a memória vazou', algum outro problema), é necessário endereçar especificamente para o servidor. - como a problema se manifestou em um ou outro plano
Para entender 'quem' nos enviou a solicitação, usamos uma ferramenta padrão — definindo uma variável de sessão: SET application_name = '{bl-host}:{bl-method}'; — capturamos o nome do host da lógica de negócios de onde vem a solicitação e o nome do método ou aplicativo que a iniciou.
Depois que passamos o 'proprietário' da solicitação, precisamos registrá-lo no log — para isso, configuramos a variável log_line_prefix = ' %m [%p:%v] [%d] %r %a'. Para quem se interessa, pode , o que tudo isso significa. Assim, vemos no log:
- tempo
- identificadores de processo e transação
- nome do banco
- IP de quem enviou esta solicitação
- e nome do método
Depois, entendemos que não é muito interessante observar a correlação de uma única solicitação entre diferentes servidores. É raro ter uma situação em que seu único aplicativo apresenta o mesmo 'problema' aqui e lá. Mas mesmo que seja igual — olhe para qualquer um desses servidores.
Então, essas divisões 'um servidor — um dia' se mostrou suficiente para qualquer análise.
A primeira divisão analítica — é aquele 'template' — uma forma abreviada de representação do plano, limpa de todos os indicadores numéricos. A segunda divisão — aplicativo ou método, e a terceira — é o nó específico do plano que nos causou problemas.
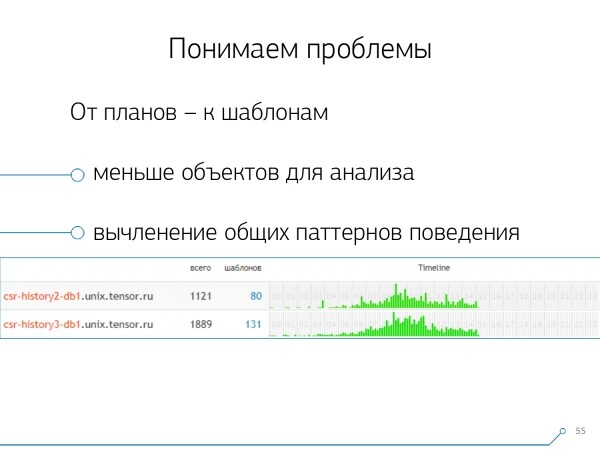
Quando passamos de instâncias específicas para templates, obtivemos imediatamente duas vantagens:
- redução drástica do número de objetos para análise
Já não precisamos analisar o problema com milhares de solicitações ou planos, mas com dezenas de templates. - linha do tempo
Ou seja, resumindo os "fatos" dentro de um determinado contexto, é possível representar sua ocorrência ao longo do dia. E aqui você pode entender que, se há um padrão ocorrendo, por exemplo, uma vez por hora, quando deveria ser uma vez por dia, vale a pena refletir sobre o que deu errado — quem e por que acionou esse padrão, talvez ele sequer devesse existir aqui. Este é mais um método de análise visual, não numérico.
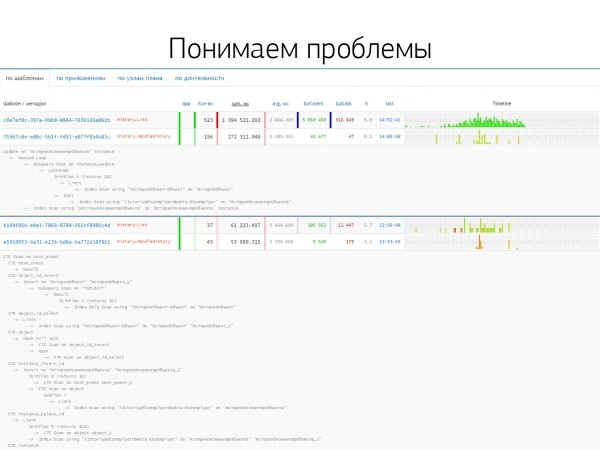
Os outros métodos se baseiam nas métricas que extraímos do plano: quantas vezes esse padrão ocorreu, o tempo total e médio, quantos dados foram lidos do disco e quantos da memória…
Porque, por exemplo, você acessa a página de análise do host, vê — algo está lendo demais do disco. O disco no servidor não está dando conta — quem está lendo dele?
E você pode classificar por qualquer coluna e decidir com o que vai lidar agora — com a carga no CPU ou no disco, ou com o total de requisições… Classificou, viu os "top" e consertou — lançou uma nova versão do aplicativo.
E logo você pode ver diferentes aplicativos que estão usando o mesmo padrão de solicitação do tipo SELECT * FROM users WHERE login = 'Vasya'. Frontend, backend, processamento… E você se pergunta, por que o processamento está lendo o usuário, se não há interação?
O modo inverso — observar diretamente o que o aplicativo está fazendo. Por exemplo, o frontend — isto, isto, isto, e mais isto uma vez por hora (o que o timeline ajuda a mostrar). E a pergunta surge imediatamente — não é função do frontend fazer algo uma vez por hora…
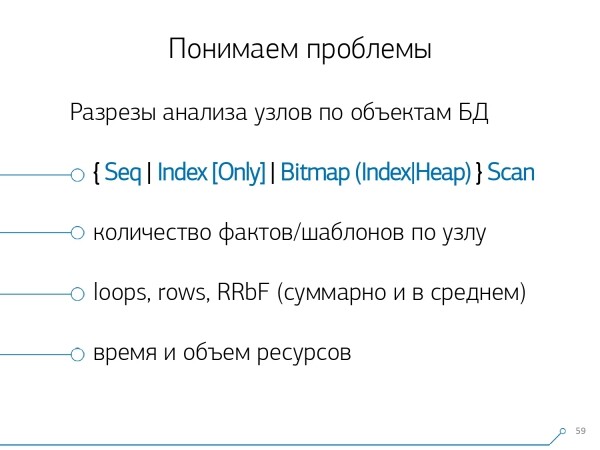
Após algum tempo, percebemos que nos faltava uma estatística agregada da perspectiva dos nós do plano. Nós extraímos dos planos apenas aqueles nós que fazem algo com os dados das próprias tabelas (lendo/escrevendo pelo índice ou não). Na essência, em relação à imagem anterior, só um aspecto é adicionado — quantas entradas esse nó nos trouxe, e quantas descartou (Rows Removed by Filter).
Você não tem um índice apropriado na tabela, faz uma consulta para ela, e ela ignora o índice, caindo em Seq Scan… você filtrou todas as entradas, exceto uma. E por que você teria 100 milhões de entradas filtradas em um dia, não seria melhor ter um índice?
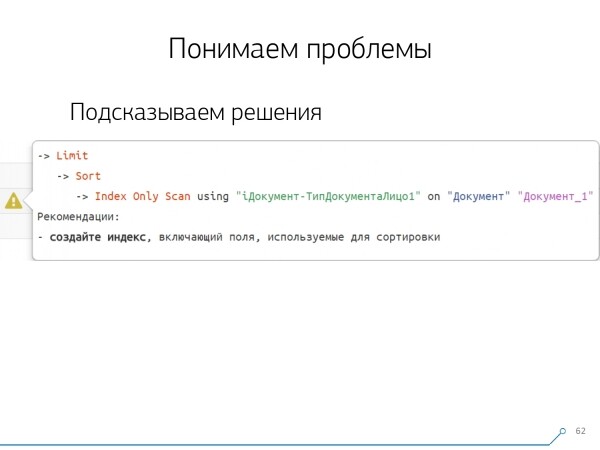
Analisando todos os planos por nós, entendemos que há algumas estruturas típicas nos planos que provavelmente parecem suspeitas. Seria bom sugerir ao desenvolvedor: 'Amigo, aqui você primeiro lê pelo índice, depois classifica e depois corta' — geralmente, há apenas uma entrada lá.
Todos que escreveram consultas com esse padrão, seguramente, já se depararam com: 'Me dê o último pedido do Vitor e sua data'. E se você não tiver um índice pela data, ou se no índice utilizado não houver data, então é exatamente nesses 'percalços' que você vai cair.
Mas sabemos que isso são 'percalços' — então, por que não sugerir imediatamente ao desenvolvedor o que ele deve fazer? Portanto, ao abrir o plano agora, nosso desenvolvedor vê imediatamente uma imagem bonita com dicas, onde lhe dizem diretamente: 'Você tem problemas aqui e aqui, e eles são resolvidos assim e assim.'
Como resultado, o volume da experiência necessária para resolver problemas no início e agora diminuiu drasticamente. Assim, conseguimos esse instrumento.
Fonte: habr.com
