

Na véspera do início do curso preparamos para você a tradução de mais um material útil.
A codificação de Huffman é um algoritmo de compressão de dados que formula a ideia principal da compactação de arquivos. Neste artigo, falaremos sobre codificação de comprimento fixo e variável, códigos unicamente decodificados, regras de prefixo e a construção da árvore de Huffman.
Sabemos que cada símbolo é armazenado como uma sequência de 0 e 1 e ocupa 8 bits. Isso é chamado de codificação de comprimento fixo, pois cada símbolo utiliza a mesma quantidade fixa de bits para armazenamento.
Suponha que temos um texto. Como podemos reduzir a quantidade de espaço necessária para armazenar um único símbolo?
A ideia principal é a codificação de comprimento variável. Podemos usar o fato de que alguns símbolos aparecem no texto com mais frequência do que outros (), para desenvolver um algoritmo que represente a mesma sequência de símbolos usando menos bits. Na codificação de comprimento variável, atribuímos aos símbolos uma quantidade variável de bits dependendo da frequência de sua aparição neste texto. No final, alguns símbolos podem ocupar apenas 1 bit, enquanto outros ocupam 2 bits, 3 ou mais. O problema com a codificação de comprimento variável é apenas a decodificação subsequente da sequência.
Como podemos decodificar a sequência de bits de maneira inequívoca?
Vamos considerar a string «aabacdab». Ela contém 8 símbolos, e ao usar codificação de comprimento fixo, precisaríamos de 64 bits para armazená-la. Observe que a frequência dos símbolos «a», «b», «c» e «d» é 4, 2, 1, 1 respectivamente. Vamos tentar representá-la «aabacdab» com menos bits, usando o fato de que «a» aparece com mais frequência do que «b», e «b» aparece com mais frequência do que «c» e «d». Começaremos atribuindo um bit, que será 0, «a» daremos um código de dois bits 11, e usaremos três bits 100 e 011 para codificar «b» . No final, teremos: «c» e «d».
Assim, a string
a
0
b
11
c
100
d
011
a codificaremos como «aabacdab» , usando os códigos apresentados acima. No entanto, o principal problema estará na decodificação. Quando tentarmos decodificar a string 00110100011011 (0|0|11|0|100|011|0|11), obteremos um resultado ambíguo, pois pode ser representada como: 001101000110110|011|0|100|011|0|11 adacdab 0|0|11|0|100|0|11|011 aabacabd 0|011|0|100|0|11|0|11 adacabab
0|011|0|100|011|0|11    adacdab
0|0|11|0|100|0|11|011   aabacabd
0|011|0|100|0|11|0|11   adacabab
…
etc.
Para evitar essa ambiguidade, devemos garantir que nossa codificação satisfaça o conceito de regra de prefixo, que implica que os códigos podem ser decodificados de apenas uma maneira única. A regra de prefixo garante que nenhum código seja prefixo de outro. Por código, entendemos os bits usados para representar um caráter específico. No exemplo acima, 0 é um prefixo 011, o que viola a regra de prefixo. Portanto, se nossos códigos satisfazem a regra de prefixo, a decodificação pode ser feita de forma única (e vice-versa).
Vamos rever o exemplo acima. Desta vez, atribuíremos a caracteres «a», «b», «c» e «d» códigos que satisfaçam a regra de prefixo.
a
0
b
10
c
110
d
111
Usando essa codificação, a string «aabacdab» será codificada como 00100100011010 (0|0|10|0|100|011|0|10). E aqui 00100100011010 poderemos decodificar de forma única e retornar à nossa string original. «aabacdab».
Codificação de Huffman
Agora que entendemos a codificação de comprimento variável e a regra de prefixo, vamos falar sobre a codificação de Huffman.
O método baseia-se na criação de árvores binárias. Nele, um nó pode ser tanto terminal quanto interno. Inicialmente, todos os nós são considerados folhas (terminais), que representam o próprio caráter e seu peso (ou seja, a frequência de ocorrência). Os nós internos contêm o peso do caráter e referenciam dois nós filhos. Por convenção, o bit "0" representa o seguimento pelo ramo esquerdo, enquanto "1" representa o ramo direito. Em uma árvore completa, N existe um total de folhas e N-1 nós internos. Recomenda-se que, ao construir a árvore de Huffman, símbolos não utilizados sejam descartados para obter códigos de comprimento otimizado.
Usaremos uma fila de prioridade para construir a árvore de Huffman, onde o nó com a menor frequência terá a mais alta prioridade. Os passos para construção são os seguintes:
- Crie um nó folha para cada caráter e adicione-os à fila de prioridade.
- Enquanto houver mais de uma folha na fila, faça o seguinte:
- Remova dois nós com a mais alta prioridade (com a menor frequência) da fila;
- Crie um novo nó interno, onde esses dois nós serão filhos, e a frequência de ocorrência será a soma das frequências desses dois nós.
- Adicione o novo nó à fila de prioridade.
- O único nó restante será a raiz, e a construção da árvore terminará aqui.
Vamos supor que temos um texto que consiste apenas nos caracteres «a», «b», «c», «d» e «e», e as frequências de sua aparição são 15, 7, 6, 6 e 5, respectivamente. Abaixo estão ilustrações que refletem os passos do algoritmo.
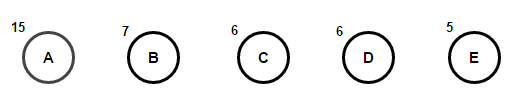
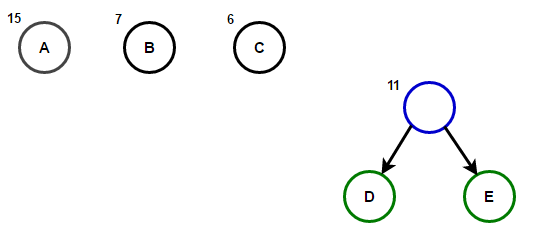
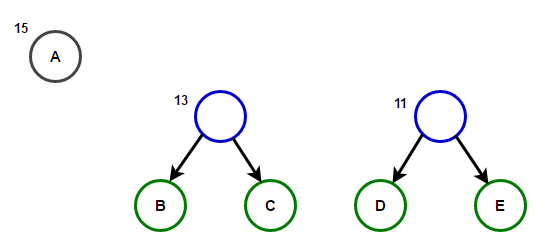
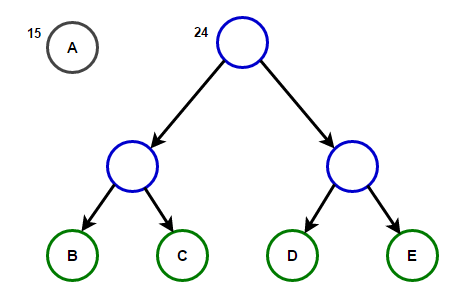
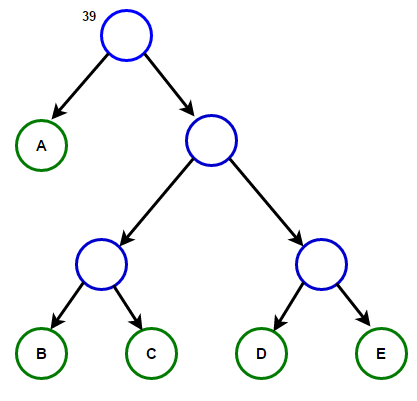
O caminho da raiz a qualquer nó terminal armazenará o código de prefixo otimizado (também conhecido como código de Huffman), correspondente ao caractere associado a esse nó terminal.
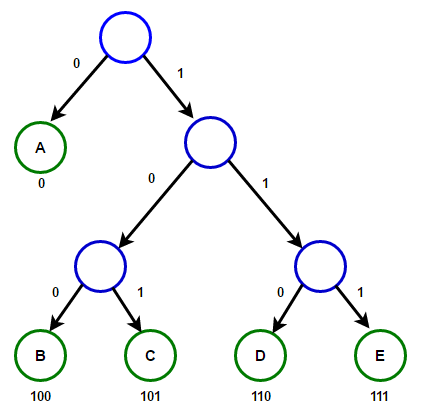
Árvore de Huffman
Abaixo você encontrará a implementação do algoritmo de compressão de Huffman nas linguagens C++ e Java:
#include <iostream>
#include <string>
#include <queue>
#include <unordered_map>
using namespace std;

// A Tree node
struct Node
{
	char ch;
	int freq;
	Node *left, *right;
};

// Function to allocate a new tree node
Node* getNode(char ch, int freq, Node* left, Node* right)
{
	Node* node = new Node();

	node->ch = ch;
	node->freq = freq;
	node->left = left;
	node->right = right;

	return node;
}

// Comparison object to be used to order the heap
struct comp
{
	bool operator()(Node* l, Node* r)
	{
		// highest priority item has lowest frequency
		return l->freq > r->freq;
	}
};

// traverse the Huffman Tree and store Huffman Codes
// in a map.
void encode(Node* root, string str,
			unordered_map<char, string> &huffmanCode)
{
	if (root == nullptr)
		return;

	// found a leaf node
	if (!root->left && !root->right) {
		huffmanCode[root->ch] = str;
	}

	encode(root->left, str + "0", huffmanCode);
	encode(root->right, str + "1", huffmanCode);
}

// traverse the Huffman Tree and decode the encoded string
void decode(Node* root, int &index, string str)
{
	if (root == nullptr) {
		return;
	}

	// found a leaf node
	if (!root->left && !root->right)
	{
		cout << root->ch;
		return;
	}

	index++;

	if (str[index] =='0')
		decode(root->left, index, str);
	else
		decode(root->right, index, str);
}

// Builds Huffman Tree and decode given input text
void buildHuffmanTree(string text)
{
	// count frequency of appearance of each character
	// and store it in a map
	unordered_map<char, int> freq;
	for (char ch: text) {
		freq[ch]++;
	}

	// Create a priority queue to store live nodes of
	// Huffman tree;
	priority_queue<Node*, vector<Node*>, comp> pq;

	// Create a leaf node for each character and add it
	// to the priority queue.
	for (auto pair: freq) {
		pq.push(getNode(pair.first, pair.second, nullptr, nullptr));
	}

	// do till there is more than one node in the queue
	while (pq.size() != 1)
	{
		// Remove the two nodes of highest priority
		// (lowest frequency) from the queue
		Node *left = pq.top(); pq.pop();
		Node *right = pq.top();	pq.pop();

		// Create a new internal node with these two nodes
		// as children and with frequency equal to the sum
		// of the two nodes' frequencies. Add the new node
		// to the priority queue.
		int sum = left->freq + right->freq;
		pq.push(getNode(' ', sum, left, right));
	}

	// root stores pointer to root of Huffman Tree
	Node* root = pq.top();

	// traverse the Huffman Tree and store Huffman Codes
	// in a map. Also prints them
	unordered_map<char, string> huffmanCode;
	encode(root, "", huffmanCode);

	cout << "Huffman Codes are :n" << 'n';
	for (auto pair: huffmanCode) {
		cout << pair.first << " " << pair.second << 'n';
	}

	cout << "nOriginal string was :n" << text << 'n';

	// print encoded string
	string str = "";
	for (char ch: text) {
		str += huffmanCode[ch];
	}

	cout << "nEncoded string is :n" << str << 'n';

	// traverse the Huffman Tree again and this time
	// decode the encoded string
	int index = -1;
	cout << "nDecoded string is: n";
	while (index < (int)str.size() - 2) {
		decode(root, index, str);
	}
}

// Huffman coding algorithm
int main()
{
	string text = "Huffman coding is a data compression algorithm.";

	buildHuffmanTree(text);

	return 0;
}
import java.util.HashMap;
import java.util.Map;
import java.util.PriorityQueue;
// Um nó de árvore
class Node
{
char ch;
int freq;
Node left = null, right = null;
Node(char ch, int freq)
{
this.ch = ch;
this.freq = freq;
}
public Node(char ch, int freq, Node left, Node right) {
this.ch = ch;
this.freq = freq;
this.left = left;
this.right = right;
}
};
class Huffman
{
// percorre a Árvore de Huffman e armazena os Códigos de Huffman
// em um mapa.
public static void encode(Node root, String str,
Map huffmanCode)
{
if (root == null)
return;
// nó folha encontrado
if (root.left == null && root.right == null) {
huffmanCode.put(root.ch, str);
}
encode(root.left, str + "0", huffmanCode);
encode(root.right, str + "1", huffmanCode);
}
// percorre a Árvore de Huffman e decodifica a string codificada
public static int decode(Node root, int index, StringBuilder sb)
{
if (root == null)
return index;
// nó folha encontrado
if (root.left == null && root.right == null)
{
System.out.print(root.ch);
return index;
}
index++;
if (sb.charAt(index) == '0')
index = decode(root.left, index, sb);
else
index = decode(root.right, index, sb);
return index;
}
// Constrói a Árvore de Huffman e huffmanCode e decodifica o texto de entrada fornecido
public static void buildHuffmanTree(String text)
{
// conta a frequência de aparecimento de cada caractere
// e armazena em um mapa
Map freq = new HashMap();
for (int i = 0 ; i < text.length(); i++) {
if (!freq.containsKey(text.charAt(i))) {
freq.put(text.charAt(i), 0);
}
freq.put(text.charAt(i), freq.get(text.charAt(i)) + 1);
}
// Cria uma fila de prioridade para armazenar os nós ativos da árvore de Huffman
// Note que o item de maior prioridade tem menor frequência
PriorityQueue pq = new PriorityQueue(
(l, r) -> l.freq - r.freq);
// Cria um nó folha para cada caractere e o adiciona
// à fila de prioridade.
for (Map.Entry entry : freq.entrySet()) {
pq.add(new Node(entry.getKey(), entry.getValue()));
}
// continue até que haja mais de um nó na fila
while (pq.size() != 1)
{
// Remove os dois nós de maior prioridade
// (menor frequência) da fila
Node left = pq.poll();
Node right = pq.poll();
// Cria um novo nó interno com esses dois nós como filhos
// e com frequência igual à soma das frequências dos dois nós
// Adiciona o novo nó à fila de prioridade.
int sum = left.freq + right.freq;
pq.add(new Node(' ', sum, left, right));
}
// root armazena o ponteiro para a raiz da Árvore de Huffman
Node root = pq.peek();
// percorre a árvore de Huffman e armazena os códigos de Huffman em um mapa
Map huffmanCode = new HashMap();
encode(root, "", huffmanCode);
// imprime os códigos de Huffman
System.out.println("Códigos de Huffman são :\n");
for (Map.Entry entry : huffmanCode.entrySet()) {
System.out.println(entry.getKey() + " " + entry.getValue());
}
System.out.println("\nA string original era :\n" + text);
// imprime a string codificada
StringBuilder sb = new StringBuilder();
for (int i = 0 ; i < text.length(); i++) {
sb.append(huffmanCode.get(text.charAt(i)));
}
System.out.println("\nA string codificada é :\n" + sb);
// percorre a Árvore de Huffman novamente e desta vez
// decodifica a string codificada
int index = -1;
System.out.println("\nA string decodificada é: \n");
while (index < sb.length() - 2) {
index = decode(root, index, sb);
}
}
public static void main(String[] args)
{
String text = "A codificação de Huffman é um algoritmo de compressão de dados.";
buildHuffmanTree(text);
}
}Nota: A memória usada pela string de entrada é 47 * 8 = 376 bits, enquanto a string codificada ocupa apenas 194 bits, ou seja, os dados são comprimidos em cerca de 48%. No programa em C++ acima, usamos a classe string para armazenar a string codificada, tornando o programa mais legível.
Como estruturas de dados eficientes de filas de prioridade exigem tempo para inserção O(log(N)) e em uma árvore binária completa com N folhas há 2N-1 nós, e a árvore de Huffman é uma árvore binária completa, então o algoritmo funciona em O(Nlog(N)) tempo, onde N é o número de símbolos.
Fontes:
Fonte: habr.com
