

O tráfego legítimo na rede DDoS-Guard recentemente superou a marca de cem gigabits por segundo. Atualmente, 50% de todo o nosso tráfego é gerado pelos serviços web de nossos clientes. São dezenas de milhares de domínios, muito diversos e que, na maioria das vezes, requerem uma abordagem individual.
Abaixo — como gerenciamos os front nodes e fazemos a distribuição Certificados SSL para centenas de milhares de sites.
Configurar o front para um único site, mesmo que muito grande, é simples. Pegamos nginx ou haproxy ou lighttpd, configuramos de acordo com os guias e esquecemos. Se precisar mudar algo, fazemos um reload e esquecemos novamente.
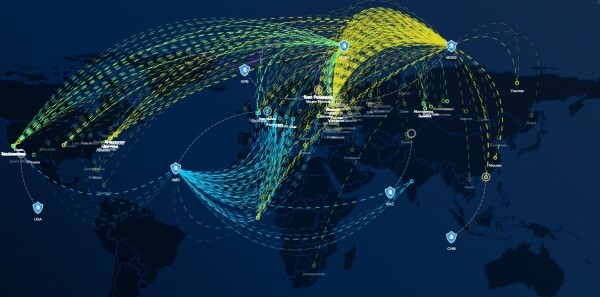
Tudo muda quando você processa volumes altos de tráfego em tempo real, avalia a legitimidade das solicitações, comprime e armazena em cache o conteúdo do usuário, enquanto altera os parâmetros várias vezes por segundo. O usuário quer ver o resultado em todos os nodes externos imediatamente após mudar as configurações em seu painel. Além disso, o usuário pode carregar via API milhares (às vezes dezenas de milhares) de domínios com parâmetros de processamento de tráfego personalizados. Tudo isso também deve funcionar imediatamente na América, na Europa e na Ásia — uma tarefa nada trivial, considerando que apenas em Moscou há vários nós físicos de filtragem espalhados.
Por que tantos grandes e confiáveis nós em todo o mundo?
- A qualidade do atendimento ao tráfego do cliente — as solicitações dos EUA precisam ser processadas exatamente nos EUA (inclusive em relação a ataques, raspagem e outras anomalias), e não encaminhadas para Moscovo ou Europa, aumentando imprevisivelmente a latência do processamento.
- O tráfego de ataque precisa ser localizado — operadores de trânsito podem ter degradação durante os ataques, cujos volumes frequentemente excedem 1Tbps. Transportar tráfego de ataque por links transatlânticos ou transasiáticos não é a melhor ideia. Tivemos casos reais em que operadores de Tier-1 disseram: 'Os volumes de ataque que você está recebendo são perigosos para nós'. É por isso que aceitamos fluxos de entrada o mais próximo possível de suas fontes.
- Exigências rigorosas de continuidade de serviço — os centros de limpeza não devem depender uns dos outros, nem de eventos locais do nosso mundo em rápida mudança. Cortaram a energia de todos os 11 andares do MMTs-9 por uma semana? — Sem problemas. Nenhum cliente que não tenha uma conexão física exatamente neste local será afetado, e os serviços da web não sofrerão sob nenhuma circunstância.
Como gerenciar tudo isso?
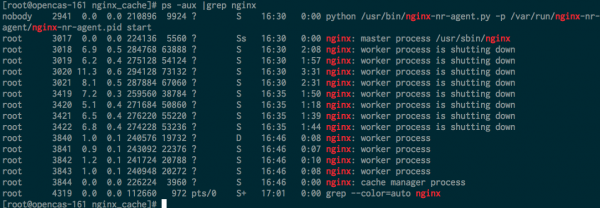
As configurações de serviço devem ser disseminadas o mais rápido possível (idealmente instantaneamente) em todos os nós front-end. Não se pode simplesmente pegar e reestruturar as configurações de texto e reiniciar os demônios a cada alteração — o mesmo nginx mantém processos em finalização (worker shutting down) por vários minutos (ou até horas, se houver longas sessões websocket).
Na reinicialização da configuração, a seguinte situação é bastante normal:
Sobre o uso de memória:
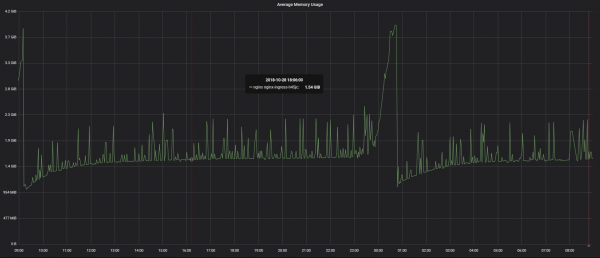
Os antigos workers consomem memória, incluindo, não dependendo linearmente do número de conexões, — isso é normal. Quando as conexões dos clientes forem fechadas, essa memória será liberada.
Por que isso não era um problema quando o nginx começou a se desenvolver? Não havia HTTP/2, nem WebSocket, nem conexões longas massivas de keep-alive. 70% do nosso tráfego web é HTTP/2, o que equivale a conexões muito longas.
A solução é simples — não usar nginx, não gerenciar frontends com base em arquivos de texto e, definitivamente, não enviar configurações de texto compactadas através de canais transoceânicos. Os canais, é claro, são garantidos e reservados, mas isso não os torna menos transcontinentais.
Temos nosso próprio servidor balanceador frontal, cujas funcionalidades descreverei nos próximos artigos. O principal é que ele é capaz de aplicar milhares de alterações de configuração por segundo em tempo real, sem reinicializações, reloads ou picos de consumo de memória. Isso é muito semelhante ao Hot Code Reload, por exemplo, no Erlang. Os dados são armazenados em um banco de dados de chave-valor geograficamente distribuído e são lidos imediatamente pelos mecanismos executores da frente. Ou seja, você carregou o certificado SSL através da interface web ou API em Moscovo, e em poucos segundos ele já está pronto para uso em nosso centro de limpeza em Los Angeles. Se porventura ocorrer uma guerra mundial e a internet cair em todo o mundo, nossos nós continuarão funcionando de forma autônoma e resolverão o split-brain assim que um dos canais dedicados Los Angeles-Amsterdã-Moscovo, Moscovo-Amsterdã-Hong Kong-Los Angeles ou pelo menos um dos canais de sobreposição de reserva se tornarem disponíveis.
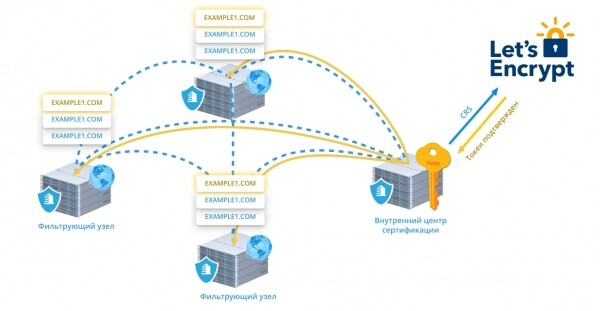
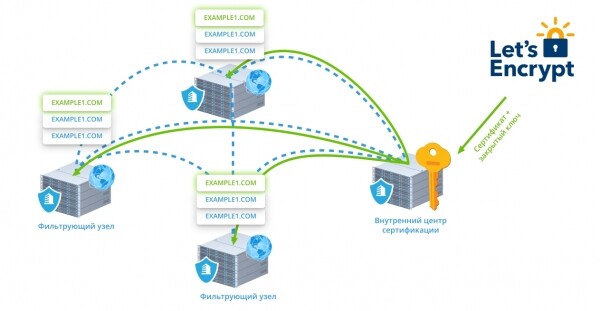
Esse mesmo mecanismo nos permite emitir e renovar certificados Let’s Encrypt instantaneamente. De forma muito simplificada, funciona assim:
- Assim que percebemos pelo menos uma solicitação HTTPS para o domínio de nosso cliente sem um certificado (ou com um certificado expirado), o nó externo que recebeu a solicitação informa ao centro de certificação interno.

- Se o usuário não proibiu a emissão do Let’s Encrypt, o centro de certificação gera um CSR, obtém um token de confirmação da LE e o distribui para todas as frentes através de um canal criptografado. Agora qualquer nó pode confirmar a solicitação de validação da LE.
- Em poucos instantes, receberemos o certificado correto e a chave privada, e igualmente os distribuiremos para as frentes. Novamente, sem reiniciar demônios.
- Sete dias antes da data de expiração, inicia-se o procedimento de reobtenção do certificado.
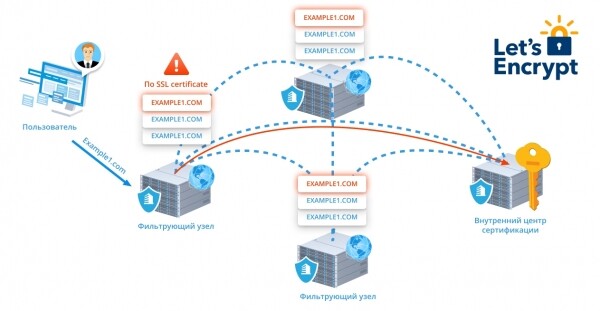
Neste momento, estamos rotacionando em tempo real 350 mil certificados de forma completamente transparente para os usuários.
Nos próximos artigos, falarei sobre outras características do processamento em tempo real de grande tráfego web — por exemplo, sobre a análise de RTT com dados incompletos para melhorar a qualidade do serviço para clientes de trânsito e sobre a proteção do tráfego de trânsito contra ataques de terabit, entrega e agregação de informações sobre o tráfego, WAF, CDN quase ilimitada e muitos mecanismos de otimização de entrega de conteúdo.
Apenas usuários registrados podem participar da pesquisa. Entre, por favor.
Sobre o que você gostaria de saber primeiro?
- 14,3%Algoritmos de clusterização e análise da qualidade do tráfego web<3
- 33,3%Dentro dos balanceadores DDoS-Guard7
- 9,5%Proteção do tráfego de L3/L4 em trânsito2
- 0,0%Proteção de websites no tráfego de trânsito0
- 14,3%Firewall de Aplicação Web3
- 28,6%Proteção contra scraping e cliques fraudulentos6
Votaram 21 usuários. 6 usuários se abstiveram.
Fonte: habr.com
