

Convido você a conferir a transcrição da palestra de Nikolay Samokhvalov "Uma abordagem industrial à otimização do PostgreSQL: experimentos com bancos de dados"
Shared_buffers = 25% – isso é muito ou pouco? Ou é o ideal? Como entender se essa recomendação, já bastante desatualizada, é adequada para o seu caso específico?
Chegou a hora de abordar a questão da escolha de parâmetros do postgresql.conf "de maneira séria". Não por meio de "autotuners" cegos ou conselhos desatualizados de artigos e blogs, mas com base em:
- experimentos rigorosamente controlados em bancos de dados, realizados de forma automatizada, em grande número e em condições o mais próximas possível das "reais".
- uma compreensão profunda das particularidades de funcionamento do SGBD e do sistema operacional.
Usando Nancy CLI (), vamos examinar um exemplo específico – os notórios shared_buffers – em diferentes situações, em diversos projetos e tentaremos descobrir como escolher a configuração ideal para nossa infraestrutura, banco de dados e carga.
Falaremos sobre experimentos em bancos de dados. Esta é uma história que está se desenrolando há pouco mais de seis meses.
Um pouco sobre mim. Tenho mais de 14 anos de experiência com Postgres. Fundei várias empresas em redes sociais. Em todas elas, o Postgres foi utilizado e continua a ser.
Além disso, o grupo RuPostgres no Meetup é o segundo no mundo. Estamos nos aproximando aos poucos de 2.000 pessoas. RuPostgres.org.
E em várias conferências, incluindo a Highload, sou responsável pelos bancos de dados, especialmente pelo Postgres desde a sua fundação.
Nos últimos anos, renovei minha prática de consultoria em Postgres em 11 fusos horários a partir daqui.
E quando fiz isso há alguns anos, tive uma pausa em meu trabalho manual ativo com Postgres, provavelmente desde 2010. Fiquei surpreso com quão pouco mudaram as rotinas diárias dos DBAs, quanta mão de obra ainda era necessária. E pensei imediatamente que algo estava errado, era preciso automatizar mais.
E como tudo isso estava em nuvem, a maioria dos clientes estava em ambientes em nuvem. E já estava muito automatizado, isso é óbvio. Farei mais sobre isso em breve. Ou seja, tudo isso resultou na ideia de que deveria haver um conjunto de ferramentas, uma plataforma que automatizasse praticamente todas as ações do DBA, permitindo gerenciar um grande número de bancos.
Nesta palestra, não haverá:
- Dizer que você deve usar 8 GB ou 25% de shared_buffers e tudo ficará bem é simplista. Não falaremos muito sobre shared_buffers.
- Componentes mais complexos.
E o que acontecerá?
- Haverá princípios de otimização que aplicamos e desenvolvemos. Também surgirão várias ideias ao longo do caminho e diferentes ferramentas que criamos, em sua maioria, em Open Source, ou seja, nossa base é construída em Open Source. Além disso, temos tickets e quase toda a comunicação ocorre em Open Source. Você pode ver o que estamos fazendo atualmente, o que será na próxima versão, etc.
- Além disso, haverá alguma experiência no uso desses princípios e ferramentas em várias empresas: de pequenas startups a grandes corporações.
Como tudo isso se desenvolve?
Primeiro, a principal tarefa de um DBA, além de garantir a criação de instances, implementação de backups, etc., é identificar gargalos e otimizar o desempenho.
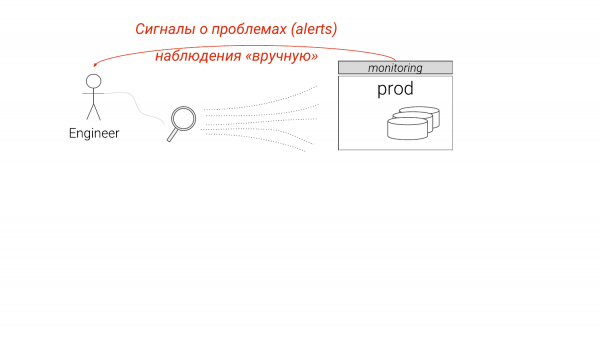
Atualmente, funciona assim. Observamos o monitoramento, vemos algumas coisas, mas nos faltam detalhes. Começamos a investigar mais a fundo, geralmente manualmente, para entender o que fazer.
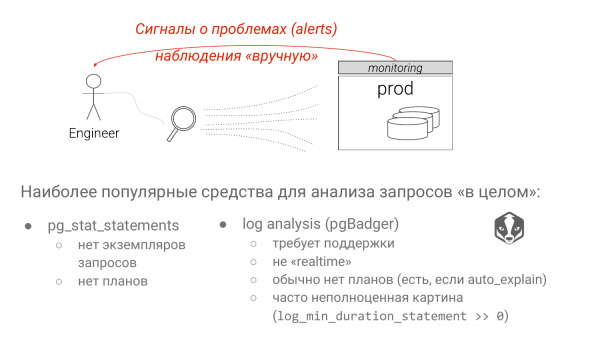
Existem duas abordagens. Pg_stat_statements é a solução padrão para identificar consultas lentas. E a análise de logs do Postgres usando o pgBadger.
Cada uma dessas abordagens tem desvantagens significativas. Na primeira abordagem, todos os parâmetros são descartados. Se vimos grupos de SELECT * FROM table WHERE coluna é igual a '?' ou '$' a partir da versão 10 do Postgres, não sabemos se é index scan ou seq scan. Isso depende muito do parâmetro. Se você inserir um valor raro, será index scan. Se você inserir um valor que representa 90% da tabela, será seq scan, porque o Postgres conhece a estatística. Essa é uma grande desvantagem do pg_stat_statements, embora alguns trabalhos estejam sendo realizados.
A principal desvantagem da análise de logs é que geralmente você não pode permitir 'log_min_duration_statement = 0'. E vamos falar sobre isso também. Portanto, você não vê o quadro completo. Uma consulta que é muito rápida pode consumir uma enorme quantidade de recursos, mas você não a verá porque está abaixo do seu limite.
Como os DBAs resolvem os problemas encontrados?
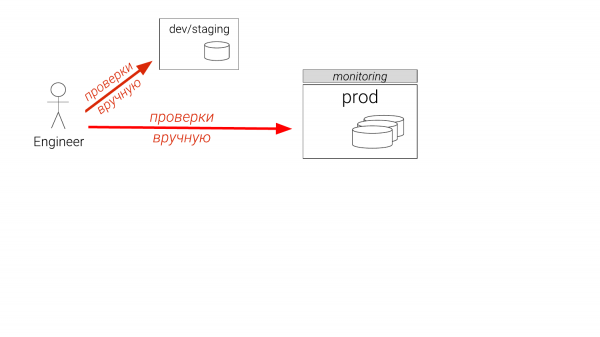
Por exemplo, encontramos um problema. O que normalmente é feito? Se você é um desenvolvedor, você fará algo em uma instância que não é do tamanho certo. Se você é um DBA, você tem um ambiente de staging. E pode haver apenas um. E ele está desatualizado há seis meses. E você pensa que vai para a produção. E até mesmo os DBAs experientes ainda testam na produção, em uma réplica. E às vezes, eles criam um índice temporário, verificam se ele ajuda, o descartam e o entregam aos desenvolvedores para que o incluam nos arquivos de migração. Esse tipo de absurdo está acontecendo agora. E isso é um problema.
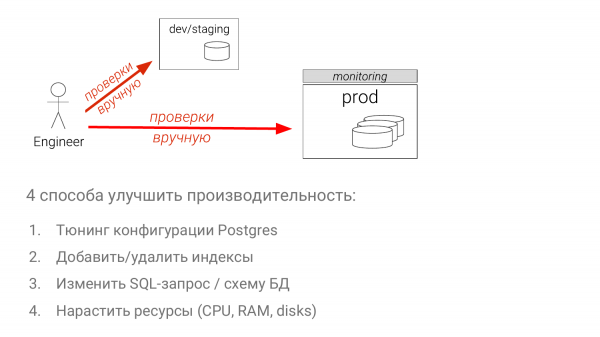
- Ajustar configurações.
- Otimizar o conjunto de índices.
- Modificar a própria consulta SQL (esta é a forma mais difícil).
- Adicionar recursos (a forma mais simples na maioria dos casos).
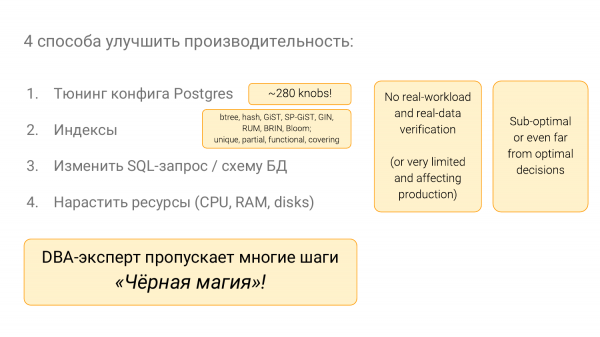
Com essas coisas, há muito a considerar. Existem muitos detalhes no Postgres. É preciso saber muito. Há muitos índices no Postgres, em parte graças aos organizadores desta conferência. E tudo isso deve ser conhecido, e é exatamente isso que causa a impressão nos não DBAs de que os DBAs praticam magia negra. Ou seja, é necessário cerca de 10 anos de experiência para começar a entender tudo isso de maneira adequada.
E eu sou um lutador contra essa magia negra. Quero que haja tecnologia, e não intuição em tudo isso.
Exemplos da vida real
Eu observei isso em pelo menos dois projetos, incluindo o meu. Um novo post no blog nos informa que um valor de 1.000 para default_statistic_target é bom. Certo, vamos tentar na produção.
E aqui estamos nós, usando nossa ferramenta dois anos depois, com experimentos sobre os bancos de dados que discutimos hoje, e podemos comparar o que era e o que se tornou.
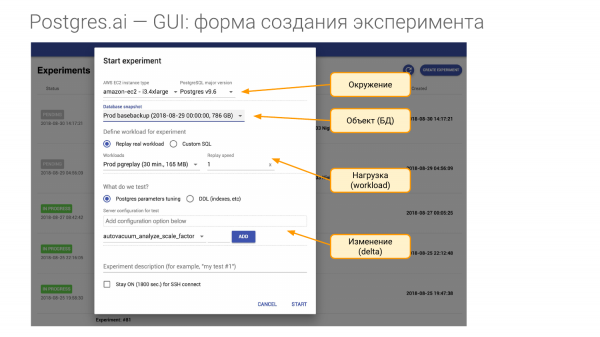
E para isso, precisamos criar um experimento. Ele consiste em quatro partes.
- A primeira parte é o ambiente. Precisamos de hardware. E quando eu chego a alguma empresa e fecho um contrato, digo que quero um hardware igual ao de produção. Para cada um dos seus Mestres, eu preciso de pelo menos um hardware desse tipo. Seja uma instância de máquina virtual na Amazon ou no Google, ou exatamente o mesmo hardware que eu preciso. Ou seja, quero recriar o ambiente. E no conceito de ambiente, incluímos a versão maior do Postgres.
- A segunda parte é o objeto de nossa pesquisa. É o banco de dados. Ele pode ser criado de várias maneiras. Eu vou mostrar como.
- A terceira parte é a carga. Este é o momento mais difícil.
- A quarta parte é o que verificamos, ou seja, o que vamos comparar. Podemos alterar um ou mais parâmetros na configuração, ou podemos criar um índice, entre outras coisas.
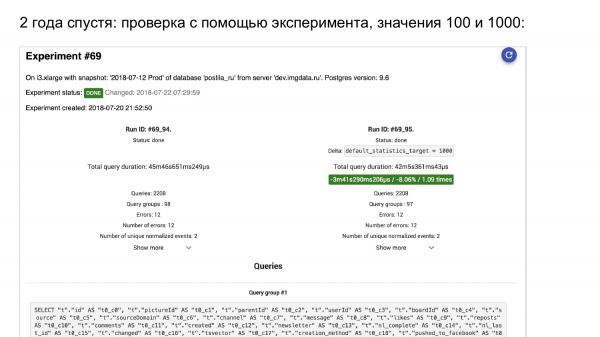
Estamos realizando um experimento. Aqui está o pg_stat_statements. À esquerda, o que era. À direita, o que se tornou.
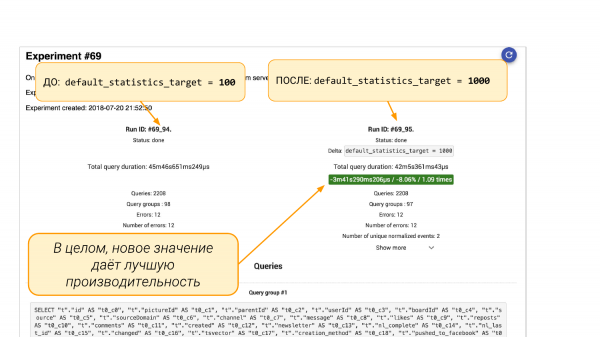
À esquerda, default_statistics_target = 100, à direita = 1 000. Vemos que isso nos ajudou. Tudo melhorou em 8% no geral.
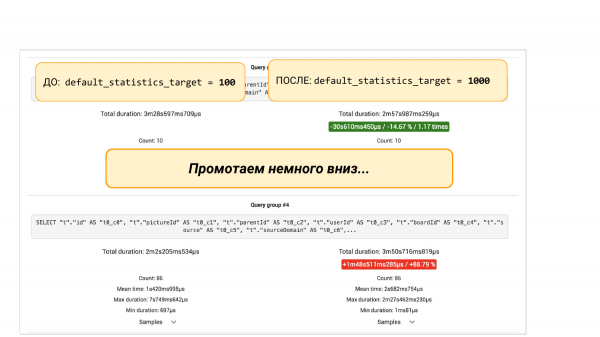
Mas se lembrarmos, lá embaixo estarão grupos de consultas do pgBadger ou do pg_stat_statements. Aqui existem duas opções. Vemos que alguma consulta caiu 88%. E aqui já entra a abordagem de engenharia. Podemos investigar mais a fundo, porque é interessante entender por que caiu. Precisamos entender o que aconteceu com as estatísticas. Por que mais buckets nas estatísticas levam a um resultado pior.
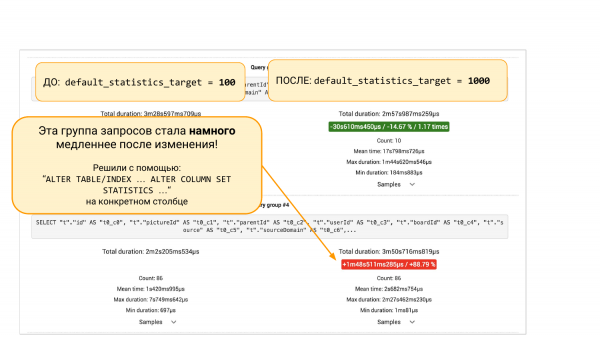
Ou podemos não investigar, mas fazer um "ALTER TABLE … ALTER COLUMN" e retornar 100 buckets para as estatísticas dessa coluna. E então, com mais um experimento, podemos confirmar que esse reparo ajudou. Isso é uma abordagem de engenharia que nos ajuda a ver o quadro e tomar decisões com base em dados, e não em intuições.
Alguns exemplos de outras áreas. Nos testes, os testes de CI já existem há muitos anos. E nenhum projeto com bom senso viveria sem testes automáticos.
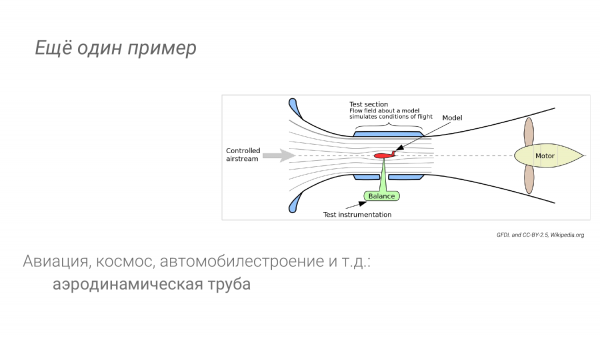
Em outras indústrias: na aviação, na indústria automobilística, quando testamos a aerodinâmica, também temos a oportunidade de realizar experimentos. Não vamos lançar algo do projeto diretamente no espaço ou colocar um carro na pista imediatamente. Por exemplo, existe um túnel de vento.
A partir das observações em outras indústrias, podemos tirar conclusões.
Primeiro, temos um ambiente especial. Ele é próximo da produção, mas não exatamente. Sua principal característica é que deve ser barato, repetível e o mais automatizado possível. Também deve haver ferramentas especiais para realizar análises detalhadas.
Provavelmente, quando lançamos o avião e estamos voando, temos menos oportunidades de estudar cada milímetro da superfície da asa do que em um túnel de vento. Temos mais recursos para diagnóstico. Podemos nos permitir adicionar mais peso, que não podemos carregar no avião no ar. O mesmo acontece com o Postgres. Em alguns casos, podemos ativar o registro completo de consultas durante os experimentos. E não queremos fazer isso em produção. Talvez até mesmo ativemos isso com planos usando auto_explain.
E como já mencionei, um alto nível de automação significa que pressionamos um botão e repetimos. É assim que deve ser, para que tenhamos muitos experimentos, para que isso faça parte do fluxo.
Nancy CLI – a base do "laboratório de DB".
E aqui está o que fizemos. Ou seja, falei sobre essas ideias em junho, quase um ano atrás. E já temos em Open Source o que chamamos de Nancy CLI. Essa é a base para construir um laboratório de banco de dados.
– Isso está em Open Source, no Gitlab. Você pode dizer, pode experimentar. Eu coloquei um link nos slides. Você pode clicar nele e lá estará. sobre todos os parâmetros.
Claro, há muito mais em fase de desenvolvimento. Há muitas ideias. Mas isso já é algo que aplicamos praticamente todos os dias. E quando temos uma ideia – e se ao deletar 40.000.000 de linhas tudo estiver preso em I/O, podemos conduzir um experimento e olhar mais de perto, para entender o que está acontecendo e depois tentar corrigir isso em andamento. Ou seja, fazemos um experimento. Por exemplo, ajustamos algo e vemos o que resulta. E não fazemos isso em produção. Essa é a essência da ideia.
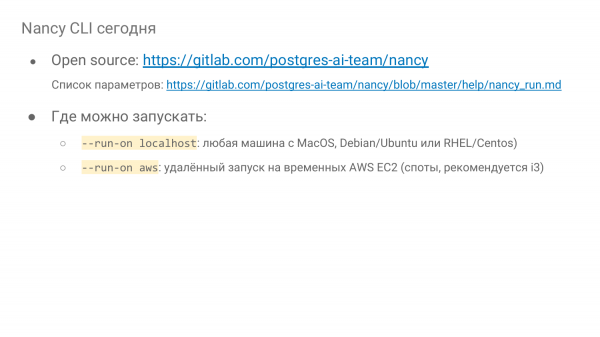
Onde isso pode funcionar? Isso pode funcionar localmente, ou seja, pode ser feito em qualquer lugar, você pode até mesmo rodar em um MacBook. Precisa de Docker, vamos lá. E é isso. Pode ser executado em algum instância de hardware ou em uma máquina virtual, em qualquer lugar.
E ainda há a possibilidade de executar remotamente na Amazon em uma Instância EC2, nas instâncias spot. E isso é uma oportunidade muito interessante. Por exemplo, ontem realizamos mais de 500 experimentos em uma instância i3, começando pela mais básica até a i3-16-xlarge. E esses 500 experimentos nos custaram 64 dólares. Cada um durou 15 minutos. Ou seja, devido ao uso de instâncias spot, isso é muito barato — um desconto de 70%, com cobrança por segundo da Amazon. Você pode fazer muito. Você pode realizar uma pesquisa real.
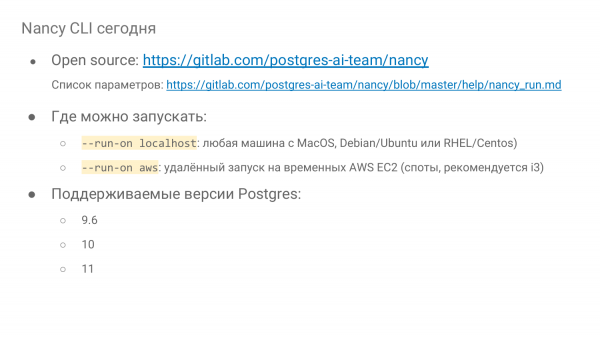
E três versões principais do Postgres são suportadas. Não é tão difícil atualizar algumas antigas e a nova versão 12 também.
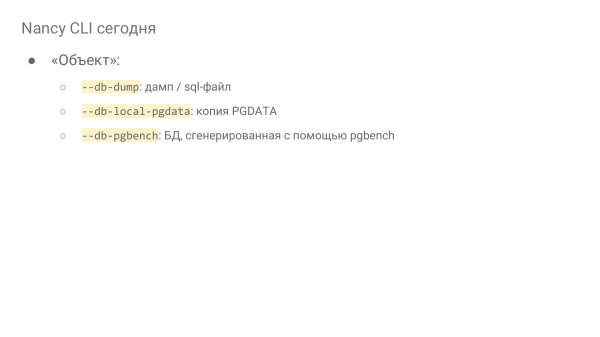
Podemos especificar o objeto de três maneiras. São elas:
- Dump/arquivo sql.
- A principal maneira é clonar o diretório PGDATA. Geralmente é feito a partir de um servidor de backup. Se você tiver backups binários adequados, pode criar clones a partir de lá. Se você estiver na nuvem, então a empresa de nuvem, como a Amazon e o Google, fará isso por você. Este é o método principal para clonar produção real. É assim que estamos implantando.
- E o último método é adequado para pesquisas, quando há o desejo de entender como algo funciona no Postgres. Isso é o pgbench. Você pode gerar com a ajuda do pgbench. É apenas uma opção "db-pgbench". Você diz a ele qual é a escala. E tudo será gerado na nuvem, como está dito.
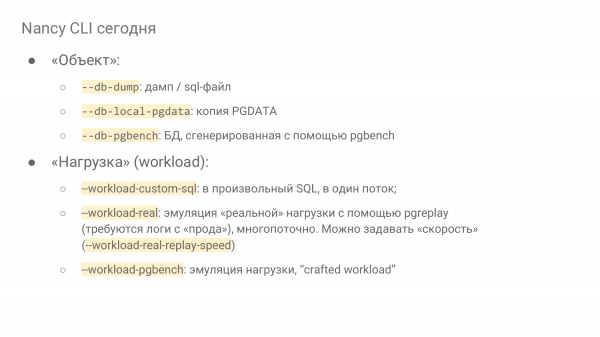
E a carga:
- Podemos executar a carga em um único fluxo SQL. Esta é a maneira mais primitiva.
- Ou podemos emular a carga. E podemos emulá-la principalmente da seguinte forma. Precisamos coletar todos os logs. E isso é doloroso. Eu vou mostrar por quê. E com o pgreplay, que é integrado ao Nancy, nós reproduzimos.
- Ou outra opção. A chamada carga artesanal, que fazemos com um certo esforço. Analisando nossa carga atual no sistema em produção, extraímos os grupos principais de consultas. E com o pgbench podemos emular essa carga em um laboratório.
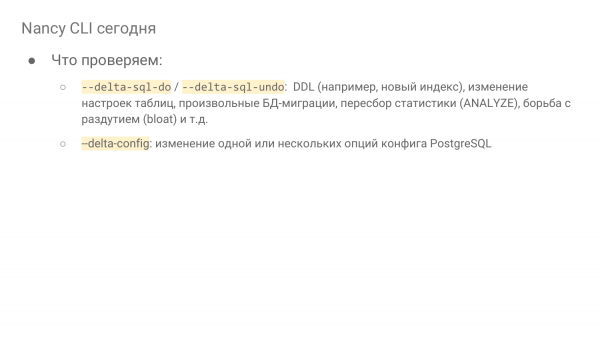
- Ou precisamos executar alguma SQL, ou seja, verificamos uma migração, criamos um índice, executamos ANALYZE. E observamos o que havia antes e depois do vacuum. Em suma, qualquer SQL.
- Ou mudamos um ou mais parâmetros na configuração. Podemos pedir para verificar, por exemplo, 100 valores na Amazon para nosso banco de dados de um terabyte. E em algumas horas você terá o resultado. Geralmente, o banco de dados de um terabyte levará várias horas para ser implantado. Mas na versão de desenvolvimento, há um patch, temos uma série, ou seja, você pode usar o mesmo pgdata no mesmo servidor e testar sequencialmente. O Postgres será reiniciado, os caches serão limpos. E você pode sobrecarregar.
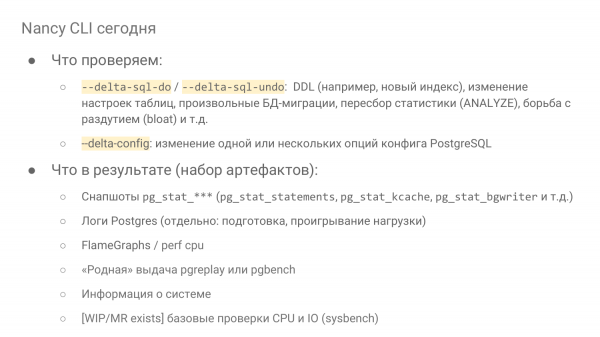
- Uma pasta chega, contendo vários arquivos, começando pelos snapshots do pg.stat***. E o mais interessante lá são o pg_stat_statements e o pg_stat_kcacke. Estas são duas extensões que analisam as consultas. E o pg_stat_bgwriter contém não apenas estatísticas do pgwriter, mas também sobre checkpoints e como os próprios backends expulsam buffers sujos. E é tudo interessante de se observar. Por exemplo, quando configuramos shared_buffers, é muito interessante ver quantos buffers foram expulsos.
- Os logs do Postgres também chegam. Dois logs – o log de preparação e o log de reprodução da carga.
- Um recurso relativamente novo – são os FlameGraphs.
- Além disso, se você usou opções de reprodução de carga como pgreplay ou pgbench, seu resultado original estará lá. E você verá latência e TPS. Será possível entender como eles enxergavam isso.
- Informações do sistema.
- Verificações básicas de CPU e IO. Isso é mais para instâncias EC2 na Amazon, quando você deseja iniciar 100 instâncias idênticas em fluxo e realizar 100 execuções diferentes, terá 10.000 experimentos. E você precisa garantir que não pegou uma instância defeituosa, que já está sendo prejudicada por alguém. Nessa máquina, outros estão se ativando e poucos recursos sobrando para você. Esses resultados são melhores para serem descartados. E é exatamente com a ajuda do sysbench de Alexey Kopytov que fazemos algumas verificações rápidas que chegam e podem ser comparadas com outras, ou seja, você entenderá como a CPU se comporta e como o IO se comporta.
Quais são as dificuldades técnicas ao exemplo de diferentes empresas?
Suponha que queremos replicar uma carga real usando logs. É uma ótima ideia, se isso foi escrito no Open Source pgreplay. Nós o usamos. Mas para que funcione bem, você deve ativar o log completo das consultas com parâmetros e temporização.
Existem algumas complicações em relação à duração e ao timestamp. Vamos deixar essa parte de lado. A questão principal é: você pode se dar a esse luxo ou não pode?
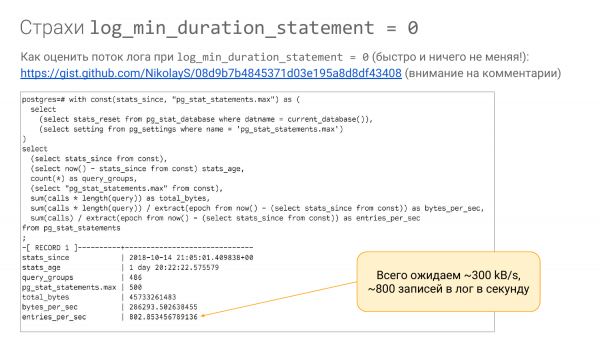
O problema é que isso pode não estar disponível. Você deve, acima de tudo, entender qual fluxo será registrado no log. Se você tiver o pg_stat_statements, pode usar esta consulta (o link estará disponível nos slides) para entender quantos bytes aproximadamente serão registrados por segundo.
Estamos observando o comprimento da consulta. Estamos desconsiderando o fato de que não há parâmetros, mas sabemos o comprimento da consulta e quantas vezes ela foi executada por segundo. Assim, podemos estimar quantos bytes em média por segundo. Podemos errar por um fator de dois, mas, de qualquer forma, teremos uma boa ideia.
Podemos ver que essa consulta é executada 802 vezes por segundo. E vemos que bytes_por_sec – 300 kB/s será registrado, mais ou menos. E, geralmente, podemos nos dar esse fluxo.
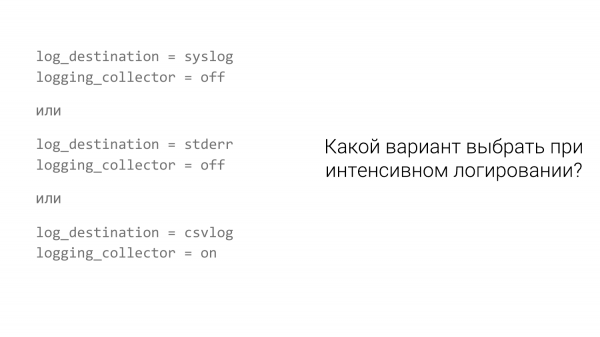
Mas! O fato é que existem diferentes sistemas de registro. E, por padrão, as pessoas geralmente usam 'syslog'.
E se você tiver 'syslog', pode obter uma imagem assim. Vamos pegar o pgbench, ativar o registro de consultas e ver o que acontece.
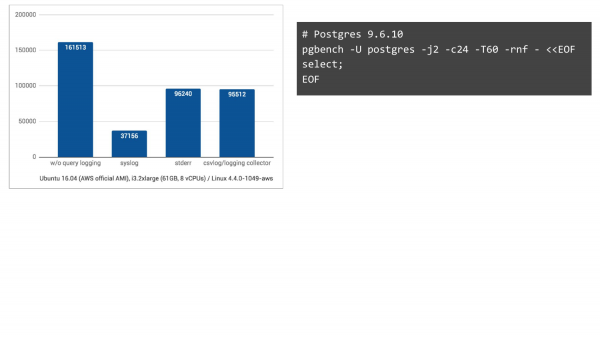
Sem registro – essa é a coluna da esquerda. Tivemos 161 000 TPS. Com 'syslog' – no Ubuntu 16.04 na Amazon, obtemos 37 000 TPS. E se mudarmos para dois outros métodos de registro, a situação melhora muito. Ou seja, esperávamos uma queda, mas não tanto.
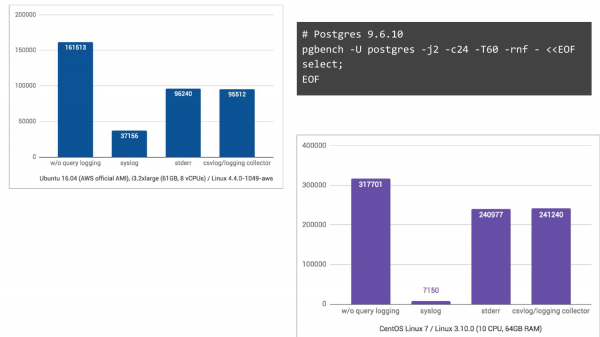
E no CentOS 7, onde o journald também participa, convertendo logs em formato binário para uma busca mais conveniente, a situação é um pesadelo; temos uma queda de 44 vezes no TPS.
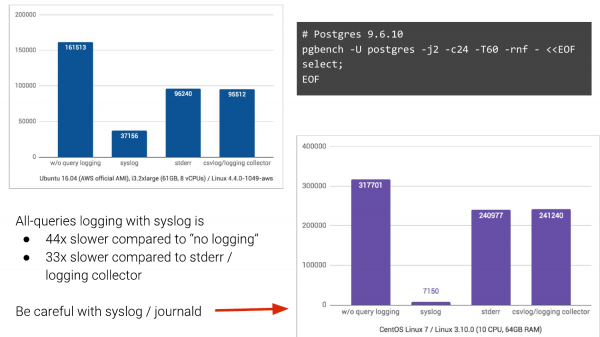
E isso é com o que as pessoas convivem. E muitas vezes nas empresas, especialmente as grandes, é muito difícil mudar. Se você conseguir se afastar do 'syslog', por favor, faça isso.
- Avalie o IOPS e o fluxo de gravação.
- Verifique seu sistema de registro.
- Se a carga prevista for excessivamente alta, considere a opção de amostragem.
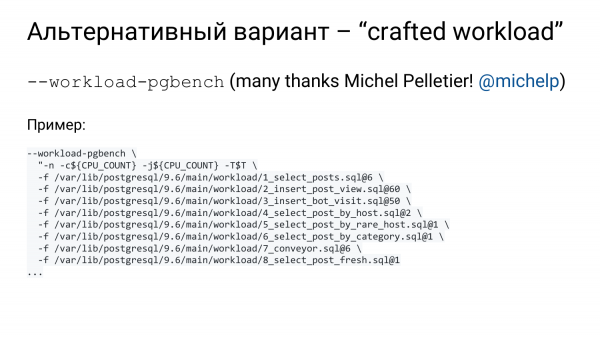
Temos o pg_stat_statements. Como eu disse, ele deve estar presente. E podemos descrever cada grupo de consultas de uma maneira especial em um arquivo. Em seguida, podemos usar um recurso muito conveniente do pgbench – a capacidade de fornecer vários arquivos por meio da opção '-f'.
Ele entende muito sobre «-f». E podemos indicar com «@» no final qual fração deve ser aplicada a cada arquivo. Ou seja, podemos especificar que este deve ser executado em 10% dos casos, e aquele em 20%. Isso nos aproximará do que vemos em produção.
Como entenderemos o que temos em produção? Qual fração e o que exatamente? Aqui há um pequeno desvio. Temos mais um produto. . Também é uma base em Open Source. E estamos atualmente desenvolvendo ativamente.
Ele surgiu um pouco por outras razões. Devido ao fato de que o monitoramento é insuficiente. Ou seja, você chega, analisa a base, observa os problemas existentes. E, geralmente, você faz um health_check. Se você é um DBA experiente, você realiza o health_check. Observou o uso de índices, etc. Se você tiver o OKmeter, ótimo. É uma excelente ferramenta de monitoramento para o Postgres. OKmeter.io – por favor, instale, tudo foi feito de forma muito legal. É pago.
Se você não o possui, geralmente você tem pouco ou nada. O monitoramento normalmente abrange CPU, IO e ainda com ressalvas, e só. Precisamos de mais. Precisamos ver como funciona o autovacuum, como funciona o checkpoint, em IO precisamos separar o checkpoint do bgwriter e dos backends, etc.
O problema é que, quando você ajuda uma grande empresa, eles não conseguem implementar algo rapidamente. Não podem comprar o OKmeter rapidamente. Talvez comprem em seis meses. Não podem instalar pacotes rapidamente.
E tivemos a ideia de que precisamos de uma ferramenta especial que não requer instalação; ou seja, você não precisa instalar nada em produção. Você instala no seu laptop ou em um servidor de observação, de onde você irá executar. E ela irá analisar muitas coisas: tanto o sistema operacional, quanto o sistema de arquivos e o próprio Postgres, realizando algumas consultas leves que podem ser executadas diretamente em produção sem causar problemas.
Nós a chamamos de Postgres-checkup. Se olharmos pelo lado médico, é um exame regular de saúde. Se pensarmos em termos automotivos, é como uma revisão. Você faz a revisão do seu carro a cada seis meses ou um ano, dependendo da marca. E você faz revisões para sua base de dados? Ou seja, faz uma análise profunda regularmente? É necessário fazer isso. Se você faz backups, então faça o checkup também, isso é igualmente importante.
E temos essa ferramenta. Começou a se desenvolver ativamente apenas três meses atrás. Ela ainda é nova, mas já tem muitos recursos.
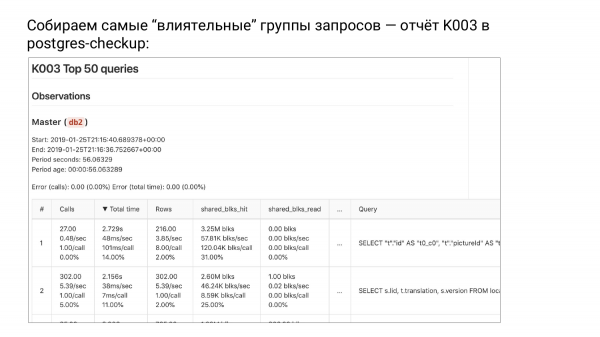
Coletamos os grupos de consultas mais "influentes" – relatório K003 no Postgres-checkup
E lá há um grupo de relatórios K. Três relatórios por enquanto. E há esse relatório K003. Ele contém o topo do pg_stat_statements, ordenado por total_time.
Quando ordenamos por total_time os grupos de consultas, vemos um grupo que mais sobrecarrega nosso sistema, ou seja, consome uma quantidade maior de recursos. Por que eu chamo de grupos de consultas? Porque descartamos os parâmetros. Já não são consultas, mas grupos de consultas, ou seja, estão abstraídos.
E se formos otimizar de cima para baixo, estaremos aliviando nossos recursos e adiando o momento em que teremos que fazer um upgrade. Essa é uma ótima maneira de economizar dinheiro.
Talvez não seja a melhor abordagem em termos de cuidar dos usuários, porque pode ser que não vejamos raros, mas muito incômodos casos em que uma pessoa esperou 15 segundos. No total, são tão raros que não os notamos, mas estamos cuidando dos recursos.
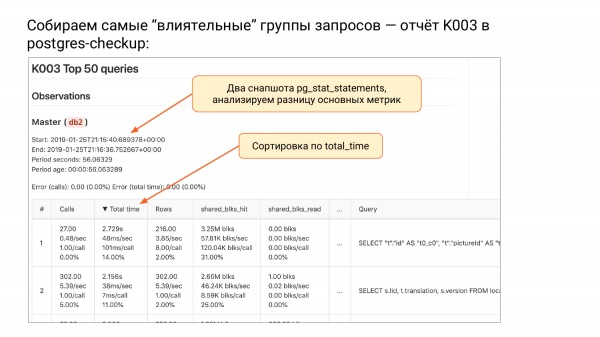
O que aconteceu nesta tabela? Fizemos dois snapshots. O Postgres_checkup lhe dará a delta de cada métrica: total-time, calls, rows, shared_blks_read, etc. Pronto, a delta foi calculada. O pg_stat_statements tem um grande problema, pois ele não se lembra de quando ocorreu o reset. Se o pg_stat_database se lembra, o pg_stat_statements não lembra. Você verá um número de 1.000.000, mas não sabemos de onde ele foi contado.
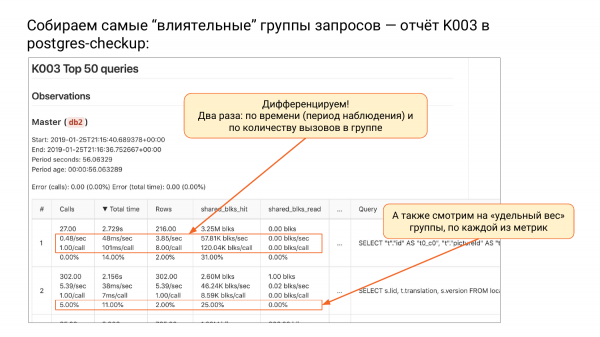
Aqui sabemos, pois temos dois snapshots. Sabemos que a delta foi, nesse caso, 56 segundos. Um intervalo muito pequeno. Ordenado por total_time. E então podemos diferenciar, ou seja, dividimos todas as métricas pela duração. Se dividirmos cada métrica pela duração, teremos o número de chamadas por segundo.
A seguir, total_time por segundo – essa é a minha métrica favorita. Ela é medida em segundos, por segundo, ou seja, quantos segundos o nosso sistema levou para executar esse grupo de consultas por segundo. Se você vê mais de um segundo por segundo, isso significa que você precisava fornecer mais de um núcleo. Essa é uma métrica muito boa. Você pode entender que essa pessoa, por exemplo, precisa de pelo menos três núcleos.
Esta é a nossa novidade, nunca vi algo assim. Observe – é uma coisa muito simples – segundo a segundo. Às vezes, quando sua CPU está a 100%, é meia hora por segundo, ou seja, você ficou meia hora lidando apenas com essas consultas.
Em seguida, vemos as linhas por segundo. Sabemos quantas linhas por segundo foram retornadas.
E há outra coisa interessante. Quantos shared_buffers lemos por segundo do próprio shared_buffers. Os hits já estavam lá, e as linhas foram obtidas do cache do sistema operacional ou do disco. A primeira opção é rápida, e a segunda pode ser rápida, mas também pode não ser, depende da situação.
A segunda forma de diferenciação é dividir o número de consultas neste grupo. Na segunda coluna, você sempre terá uma consulta dividida pela consulta. E então, o que é interessante – quantos milissegundos foram gastos nesta consulta. Sabemos como essa consulta se comporta em média. Foram necessários 101 milissegundos para cada consulta. Essa é uma métrica tradicional que precisamos para nossa compreensão.
Quantas linhas cada consulta retornou em média. Vemos que este grupo retorna 8. Quantas, em média, foram obtidas e lidas do cache. Vemos que tudo está bem cacheado. Muitos hits para o primeiro grupo.
E a quarta linha em cada linha – é quantos por cento do total. Temos chamadas. Digamos, 1.000.000. E podemos entender qual é a contribuição deste grupo. Vemos que, neste caso, o primeiro grupo contribui com menos de 0,01%. Ou seja, é tão lento que não o vemos na imagem geral. O segundo grupo – 5% das chamadas. Ou seja, 5% de todas as chamadas são deste segundo grupo.
Quanto ao total_time, também é interessante. Para o primeiro grupo de consultas, gastamos 14% do tempo total de operação. Para o segundo – 11%, e assim por diante.
Não vou entrar em detalhes, mas há sutilezas. Mostramos um erro acima porque, ao comparar, os snapshots podem variar, ou seja, algumas consultas podem faltar, e no segundo elas podem não estar presentes, enquanto novas podem aparecer. E lá calculamos o erro. Se você vê 0, isso é bom. Isso significa que não há erros. Se a taxa de erro estiver abaixo de 20%, está OK.
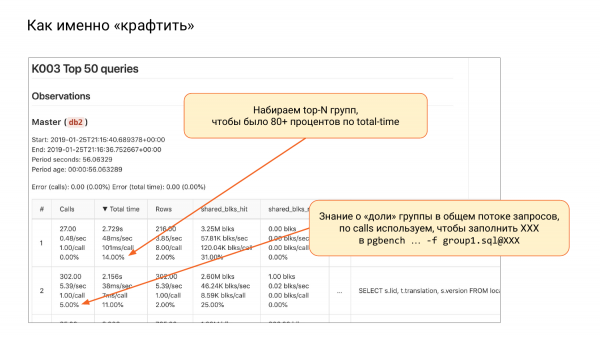
Em seguida, voltamos ao nosso tema. Precisamos craftar o workload. Vamos de cima para baixo, até atingir 80% ou 90%. Normalmente, são 10 a 20 grupos. E fazemos arquivos para pgbench. Usamos random lá. Às vezes, infelizmente, isso não funciona. E no Postgres 12 haverá mais opções para usar essa abordagem.
E assim, acumulamos de 80 a 90% do total_time. O que devemos colocar depois do «@»? Observamos as chamadas, verificamos quantos por cento e entendemos que aqui precisamos de um certo percentual. A partir desses percentuais, podemos entender como equilibrar cada um dos arquivos. Depois disso, utilizamos o pgbench e começamos a trabalhar.
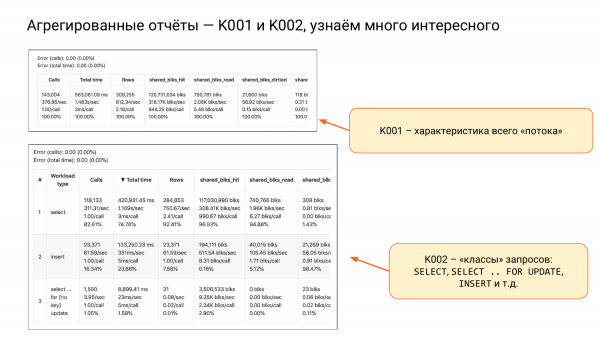
Temos também K001 e K002.
K001 é uma grande string com quatro substrings. Essa é a característica de toda a nossa carga. Observe a segunda coluna e a segunda substring. Vemos que é mais ou menos uma e meia por segundo, ou seja, se tivermos dois núcleos, será bom. A carga será de aproximadamente 75%. E assim funcionará. Se tivermos 10 núcleos, ficaremos tranquilos. Assim, podemos avaliar os recursos.
K002 – eu chamo isso de classes de consultas, ou seja, SELECT, INSERT, UPDATE, DELETE. E separadamente, SELECT FOR UPDATE, pois este bloqueia.
E aqui podemos concluir que os SELECTs normais de leitura representam 82% de todas as chamadas, mas consomem 74% do total_time. Ou seja, são muitas chamadas, mas consomem menos recursos.
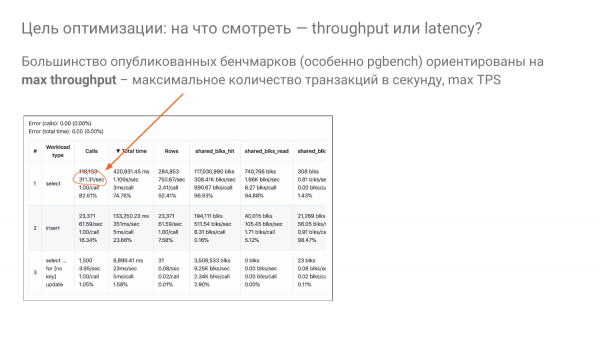
E voltamos à pergunta: «Como podemos escolher corretamente os shared_buffers?». Eu observo que a maioria dos benchmarks é construída com a ideia de – vamos ver qual será a taxa de transferência, ou seja, qual será o throughput. Geralmente, isso é medido em TPS ou QPS.
E tentamos extrair da máquina o máximo de transações por segundo possível através de parâmetros de afinação. Aqui são exatamente 311 por segundo para SELECT.
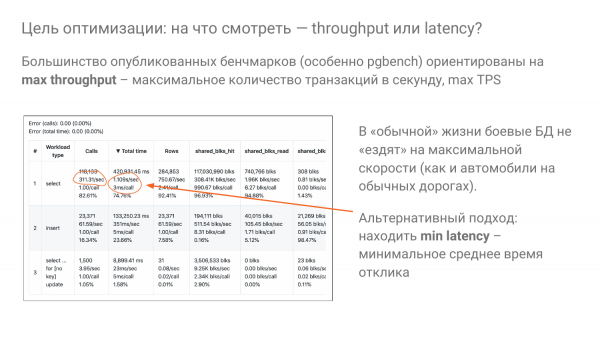
Mas ninguém vai ao trabalho e volta para casa de carro em velocidade máxima. Isso é tolo. Assim são os bancos de dados. Não devemos operar em velocidade máxima, na verdade, ninguém faz isso. Ninguém vive em produção com 100% de CPU. Embora, talvez alguém viva, mas isso não é desejável.
A ideia é que geralmente operamos a cerca de 20% da capacidade, preferencialmente não acima de 50%. E tentamos otimizar o tempo de resposta para nossos usuários acima de tudo. Ou seja, devemos ajustar nossas configurações para que haja a menor latência possível a uma velocidade de 20%, de forma hipotética. Essa é uma ideia que também tentamos aplicar em nossos experimentos.
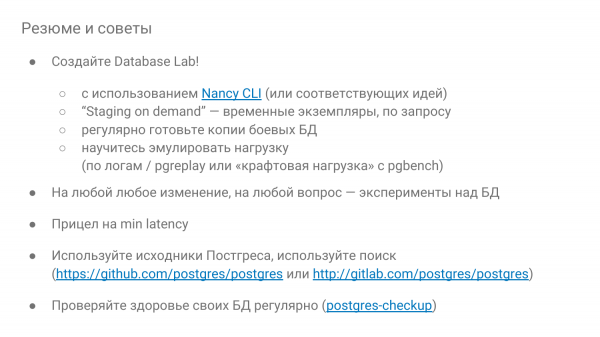
E, para concluir, as recomendações:
- Certifique-se de fazer o Database Lab.
- Sempre que possível, faça on demand, para que seja configurado por um período – brinque e descarte. Se você estiver em nuvem, isso é automático, ou seja, tenha muitos standing.
- Seja curioso. E se algo não estiver certo, experimentem para ver como se comporta. Nancy pode ser usada para se treinar e verificar como funciona o banco de dados.
- E mire o tempo de resposta mínimo.
- E não tenha medo dos códigos-fonte do Postgres. Quando você trabalha com códigos-fonte, precisa saber inglês. Há muitos comentários; tudo está explicado.
- E verifique a saúde do banco regularmente, pelo menos a cada três meses, manualmente ou com o Postgres-checkup.
Perguntas
Muito obrigado! É uma coisa muito interessante.
Duas coisas.
Sim, duas coisas. Só que eu não entendi completamente. Quando trabalhamos com a Nancy, só podemos ajustar um parâmetro ou um grupo inteiro?
Temos o parâmetro delta-config. Você pode ajustar quantos quiser de uma vez. Mas é preciso entender que, ao mudar muita coisa, você pode tirar conclusões erradas.
Sim. Por que eu perguntei? Porque é difícil fazer experimentos quando você apenas tem um parâmetro. Você ajusta ele, vê como funciona, ajusta e depois começa com o próximo.
É possível ajustar vários ao mesmo tempo, mas depende da situação, claro. Mas é melhor testar uma ideia de cada vez. Ontem tivemos uma ideia. Tivemos uma situação muito semelhante. Havia duas configurações e não conseguimos entender por que a diferença era tão grande. E surgiu a ideia de usar a dicotomia para entender e descobrir a diferença. Você pode fazer metade dos parâmetros iguais, depois um quarto, e assim por diante. Tudo é flexível.
E também tenho uma pergunta. O projeto é jovem e está se desenvolvendo. A documentação já está pronta, existe uma descrição detalhada?
Eu fiz um link especial para a descrição dos parâmetros. Isso existe. Mas ainda falta muita coisa. Estou em busca de pessoas com a mesma mentalidade. E eu as encontro quando me apresento. É muito legal. Alguém já está trabalhando comigo, alguém ajudou e fez algo. E se você está interessado nesse tema, dê um retorno – o que falta.
Assim que fizermos o laboratório, pode ser que haja um retorno. Vamos ver. Obrigado!
Olá! Obrigado pela apresentação! Eu vi que há suporte para a Amazon. Está prevista a inclusão do suporte para o GSP?
Boa pergunta. Começamos a fazer. E por enquanto está parado, porque queremos economizar. Ou seja, há suporte usando run on localhost. Você pode criar uma instância e trabalhar localmente. A propósito, é assim que fazemos. No Getlab, eu faço assim, lá no GSP. Mas fazer exatamente essa orquestração ainda não vemos sentido, porque o Google não tem spots baratos. Há instâncias ???, mas elas têm limitações. Primeiro, sempre têm apenas um desconto de 70% e não podemos brincar com o preço. Estendemos os spots em 5-10% no preço para diminuir a probabilidade de sermos derrubados. Ou seja, você economiza com os spots, mas eles podem ser retirados a qualquer momento. Se você definir um preço um pouco mais alto do que os outros, você será derrubado mais tarde. O Google tem uma dinâmica totalmente diferente. E ainda há uma limitação muito ruim – elas vivem apenas 24 horas. E às vezes queremos rodar um experimento por 5 dias. Mas isso é possível com os spots, eles às vezes vivem por meses.
Olá! Obrigado pela apresentação! Você mencionou o checkup. Como você calcula os erros de stat_statements?
Uma pergunta muito boa. Posso mostrar e explicar em detalhes. Em resumo, observamos como o conjunto de grupos de consultas mudou: quantas falharam e quantas novas apareceram. E aí olhamos duas métricas: total_time e calls, então há dois erros. E analisamos qual a contribuição dos grupos que mudaram. Há dois subgrupos: o que saiu e o que entrou. Analisamos qual a contribuição deles para o todo.
E você não tem medo de que ele possa ser processado duas ou três vezes entre os snapshots?
Ou seja, eles se registraram novamente ou como?
Por exemplo, essa consulta já foi expulsa uma vez, depois voltou e foi expulsa novamente, depois voltou outra vez e foi expulsa de novo. E você fez alguma contagem, e onde está tudo isso?
Boa pergunta, precisamos analisar.
Eu fiz algo parecido. Com certeza foi mais simples, eu fiz sozinho. Mas tive que reiniciar, fazer reset stat_statements e me orientar no momento do snapshot, garantindo que estivesse abaixo de uma certa fração para não ter chegado ao teto do quanto stat_statements pode acumular. E eu me baseio no fato de que, provavelmente, nada foi expulso.
Sim, sim.
Mas não consigo entender como fazer isso de forma confiável de outra maneira.
Infelizmente, não me lembro exatamente – usamos o texto da consulta ou queryid do pg_stat_statements e nos baseamos nisso. Se nos baseamos no queryid, então, idealmente, estamos comparando coisas comparáveis.
Não, ele pode ser substituído várias vezes entre os snapshots e retornar novamente.
Com este mesmo id?
Sim.
Vamos estudar isso. Boa pergunta. Precisamos analisar. Mas por enquanto o que vemos é que temos 0 escrito...
Isso, claro, é um caso raro, mas fiquei chocado quando descobri que stat_statements pode ser substituído.
No Pg_stat_statements pode haver muita coisa. Já nos deparamos com o fato de que se você tiver track_utility = on, seus conjuntos também são rastreados.
Sim, claro.
E se você tiver Java Hibernate, que é aleatório, começa a haver bloqueios na tabela hash. E assim que você desativa um aplicativo muito carregado, você fica com 50-100 grupos. E tudo fica mais ou menos estável. Uma das formas de lidar com isso é aumentar pg_stat_statements.max.
Sim, mas é necessário saber quanto. E é preciso monitorá-lo. Eu faço isso. Ou seja, tenho pg_stat_statements.max. E vejo que no momento do snapshot não cheguei a 70%. Bem, isso significa que não perdemos nada. Fazemos um reset. E acumulamos novamente. Se no próximo snapshot estiver abaixo de 70, significa que provavelmente não perdemos nada novamente.
Sim. O padrão atualmente é 5.000. E muitos acham isso suficiente.
Normalmente – sim.
Vídeo:
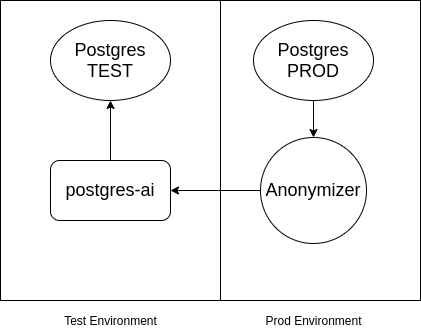
P.S. Adiciono que se houver dados confidenciais no Postgres que não podem ir para o ambiente de teste, você pode utilizar . O esquema é mais ou menos o seguinte:
Fonte: habr.com
