

Convido você a conferir a transcrição da apresentação no início de 2020 de Georgy Rylov "WAL-G: novas oportunidades e expansão da comunidade"
Os mantenedores de open-source enfrentam muitos problemas à medida que crescem. Como escrever cada vez mais recursos necessários, corrigir mais bugs e acompanhar mais pull requests? Usando o exemplo do WAL-G (ferramenta de backup para PostgreSQL), vou falar sobre como resolvemos esses problemas, lançando um curso de desenvolvimento open-source na universidade, o que alcançamos e para onde vamos a seguir.
Olá a todos novamente! Sou desenvolvedor na Yandex, de Ekaterinburgo. E hoje eu vou falar sobre o WAL-G.
No título da apresentação não foi mencionado que se tratava de backups. Alguém não sabe o que é o WAL-G? Ou todos sabem? Levante a mão quem não sabe. Incrível, você veio para a apresentação e não sabe sobre o que é.
Vamos lá, eu vou explicar o que teremos hoje. Acontece que nossa equipe tem lidado com backups há bastante tempo. E esta é mais uma apresentação em uma série em que falamos sobre como armazenamos dados de forma segura, confiável, conveniente e eficiente.
Nas edições anteriores, houve muitas apresentações de Andrey Borodin, Vladimir Leskov. Éramos muitos. E todos nós falamos sobre o WAL-G já há muitos anos.
clck.ru/F8ioz —
clck.ru/Ln8Qw —
Esta apresentação será um pouco diferente das outras, pois as anteriores trataram mais da parte técnica, enquanto aqui eu vou falar sobre como enfrentamos problemas relacionados ao crescimento da comunidade. E como tivemos a ideia que nos ajuda a lidar com isso.
Alguns anos atrás, o WAL-G era um projeto relativamente pequeno que herdamos da Citus Data. E nós apenas o pegamos. E estava sendo desenvolvido por uma única pessoa.
E só o que não tinha no WAL-G:
- Backup a partir da réplica.
- Não havia backups incrementais.
- Não havia backups WAL-Delta.
- E ainda muitas outras coisas estavam faltando.
Ao longo desses anos, o WAL-G cresceu consideravelmente.
E até 2020, tudo que foi mencionado já estava presente. E ainda adicionamos o que temos agora:
- Mais de 1.000 estrelas no GitHub.
- 150 forks.
- Cerca de 15 PRs abertos.
- E muitos contribuidores.
- E issues abertas constantemente. E isso considerando que acessamos lá literalmente todos os dias, tratando de algo.
E chegamos à conclusão de que este projeto exige mais da nossa atenção, mesmo quando não precisamos implementar nada para o nosso serviço de Managed Databases na Yandex.
E em algum momento no outono de 2018, tivemos uma ideia. Normalmente, a equipe tem algumas maneiras de implementar funções ou corrigir bugs se não houver mãos suficientes. Por exemplo, pode-se contratar mais um desenvolvedor e pagar por isso. Ou pode-se trazer um estagiário por um tempo e também pagar a ele um salário. Mas há um grupo considerável de pessoas, parte das quais já sabe realmente escrever código. Você apenas nem sempre sabe qual é a qualidade desse código.
Nós pensamos e decidimos tentar envolver estudantes. Mas os estudantes não participarão de tudo. Eles farão apenas uma parte do trabalho. E, por exemplo, eles escreverão testes, corrigirão bugs, implementarão funções que não afetam a funcionalidade principal. A funcionalidade principal é a criação de backups e a recuperação de backups. Se ocorrer um bug na criação de um backup, teremos perda de dados. E ninguém quer isso, claro. Todos querem que tudo seja muito confiável. Portanto, o código em que confiamos menos do que no nosso próprio não queremos liberar. Ou seja, qualquer código não crítico é o que gostaríamos de receber de nossas mãos de trabalho adicionais.
Sob quais condições um PR de estudante é aceito
- Eles são obrigados a cobrir seu código com testes. Tudo deve passar no CI.
- E também passamos por 2 revisões. Uma do Andrei Borodin e uma minha.
- E adicionalmente, para verificar se isso não quebrará nada no nosso serviço, faço uma construção separada com este commit. E verificamos em testes end-to-end se nada está quebrando.
Curso especial sobre Open Source
Um pouco sobre por que isso é necessário e por que, na minha opinião, é uma ideia legal.
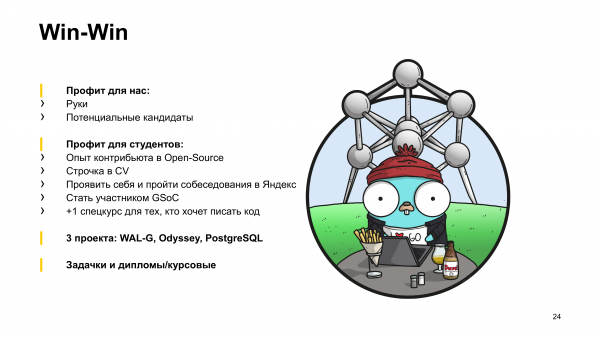
Para nós, o benefício é óbvio:
- Recebemos mãos adicionais.
- E buscamos candidatos para a equipe entre estudantes competentes que escrevem um bom código.
Qual é o benefício para os estudantes?
Eles podem ser menos óbvios, porque os estudantes, no mínimo, não recebem dinheiro pelo código que escrevem, mas apenas notas para seus registros.
Eu perguntei a eles sobre isso. E pelas palavras deles:
- Experiência como colaborador em Open Source.
- Conseguir uma linha no currículo.
- Mostrar seu potencial e passar por uma entrevista na Yandex.
- Participar do GSoC.
- +1 curso especial para aqueles que querem escrever código.
Não vou falar sobre como o curso foi organizado. Vou apenas dizer que o WAL-G foi o projeto principal. Além disso, incluímos neste curso projetos como Odyssey, PostgreSQL e ClickHouse.
E não apenas oferecíamos tarefas neste curso, mas também diplomas e trabalhos de conclusão de curso.
E o lucro para os usuários?
Agora vamos para a parte que provavelmente mais interessa a você. Qual é o benefício disso? O benefício é que os estudantes corrigiram muitos bugs. E fizeram solicitações de recursos que vocês pediram que fizéssemos.
E deixem-me falar sobre as coisas que vocês há muito tempo desejavam e que foram implementadas.
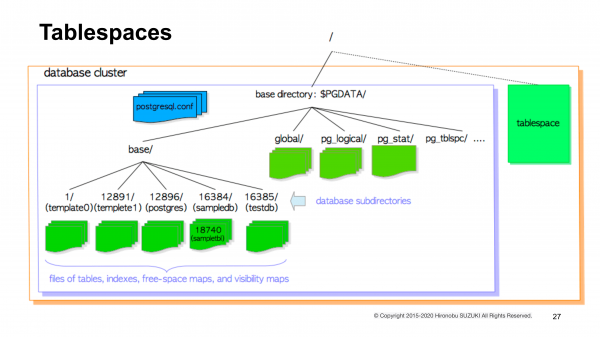
Suporte a tablespaces. O suporte a tablespaces no WAL-G era esperado, provavelmente, desde o momento do lançamento do WAL-G, porque o WAL-G é o sucessor de outra ferramenta de backup, o WAL-E, onde foram suportados backups de bancos de dados com tablespaces.
Deixe-me relembrar rapidamente o que é isso e por que tudo isso é necessário. Normalmente, todos os seus dados Postgres ocupam um único diretório no sistema de arquivos, que é chamado de diretório base. E este diretório já contém todos os arquivos e subdiretórios necessários para o Postgres.
Tablespaces são diretórios onde os dados do Postgres estão armazenados, mas eles não estão fora do diretório base. No slide, é visível que os tablespaces estão fora do diretório base.
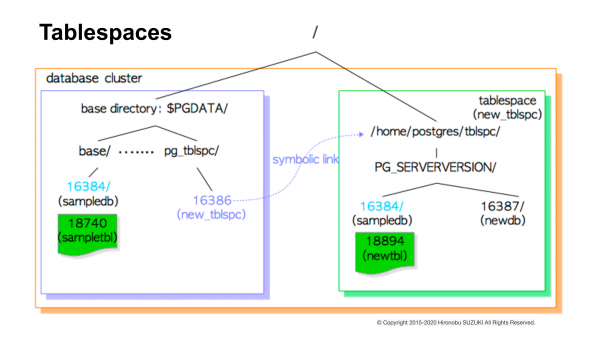
Como isso parece para o próprio Postgres? No diretório base, há um subdiretório separado chamado pg_tblspc. E dentro dele, há links simbólicos para diretórios onde os dados do Postgres realmente residem fora do diretório base.
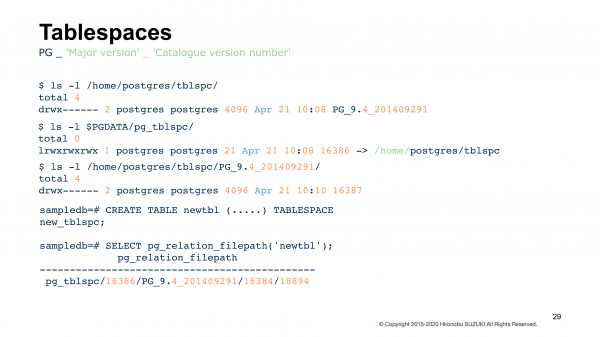
Quando você usa tudo isso, esses comandos podem parecer assim para você. Ou seja, você cria uma tabela em um tablespace especificado e vê onde ela está agora. Essas duas últimas linhas, os dois últimos comandos chamados. E lá é visível que há algum caminho. Mas na verdade, esse não é o caminho verdadeiro. É um caminho com um prefixo do diretório base para o tablespace. E a partir daí, ele é vinculado por um link simbólico que leva aos seus dados reais.
Nós não usamos isso em nossa equipe, mas muitos outros usuários do WAL-E pediram para migrar para o WAL-G, mas isso os impedia. Agora isso é suportado.
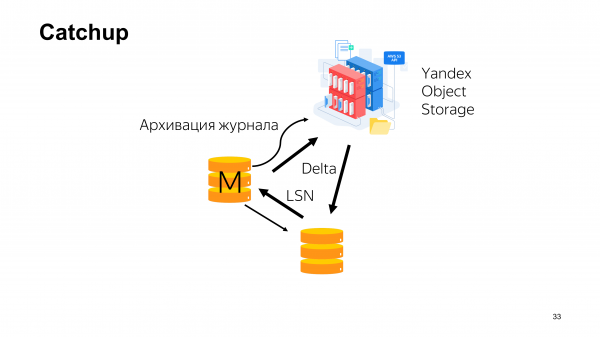
Outra funcionalidade que nosso curso especial trouxe foi o catchup. Pessoas que provavelmente trabalharam mais com Oracle do que com Postgres conhecem o catchup.
Um resumo do que é isso. Assim pode ser normalmente a topologia de um cluster em nosso serviço. Temos um mestre. Há uma réplica que faz stream do write-ahead log. A réplica informa ao mestre em qual LSN ela se encontra atualmente. E, em algum lugar, paralelamente a isso, o log pode ser arquivado. Além da arquivação do log, backups também são enviados para a nuvem. E delta-backups são enviados.
Qual pode ser o problema? Quando você tem um banco de dados bastante grande, pode acontecer que a réplica comece a se atrasar muito em relação ao mestre. E ela se atrasa tanto que nunca consegue alcançá-lo. Esse problema geralmente precisa ser resolvido de alguma forma.
E a maneira mais simples é remover a réplica e reconfigurá-la, porque ela nunca irá alcançá-lo, e precisamos resolver o problema. Mas isso é bastante demorado, porque restaurar um backup completo de um banco de dados de 10 TB é muito, muito longo. E queremos fazer isso o mais rápido possível se esses problemas surgirem. E é exatamente para isso que serve o catchup.
O catchup permite usar delta-backups que são salvos na nuvem dessa forma. Você diz em qual LSN a réplica atrasada está agora e o inclui no comando catchup para criar um delta-backup entre esse LSN e o LSN em que seu cluster está atualmente. E depois você restaura esse backup na réplica que estava atrasada.
Outros bancos
Além disso, os estudantes nos trouxeram muitas funcionalidades de uma vez. Como estamos no Yandex desenvolvendo não apenas Postgres, mas também temos MySQL, MongoDB, Redis, ClickHouse, em algum momento precisávamos que pudéssemos fazer backups com recuperação ponto a ponto para MySQL, e que houvesse a possibilidade de carregá-los na nuvem.
E queríamos fazer isso de uma maneira semelhante à que o WAL-G faz. E decidimos experimentar e ver como tudo isso ficaria.
No início, sem dividir essa lógica, escrevemos o código em um fork. Vimos que tínhamos um modelo funcional e isso poderia funcionar. Depois pensamos que nossa principal comunidade são os usuários de Postgres, que usam WAL-G. Portanto, precisamos separar essas partes de alguma forma. Ou seja, quando o código for ajustado para Postgres, não quebramos o MySQL, e quando ajustamos o MySQL, não quebramos o Postgres.
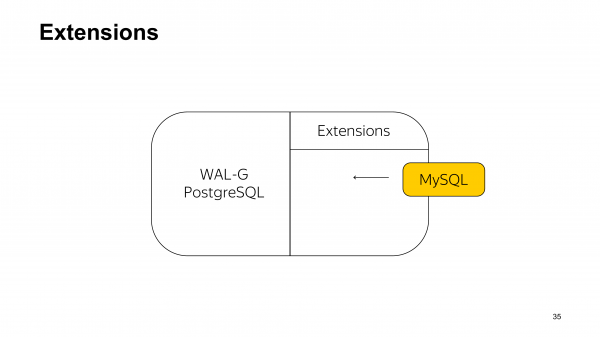
A primeira ideia sobre como dividir isso foi usar a mesma abordagem utilizada nas extensões do PostgreSQL. E, na verdade, para fazer backup do MySQL, você precisava instalar alguma biblioteca dinâmica.
Mas aqui já se percebe a assimetria dessa abordagem. Quando você faz backup do Postgres, você instala um backup normal para o Postgres e tudo funciona bem. Para o MySQL, no entanto, parece que você instala um backup para o Postgres e, além disso, precisa instalar uma biblioteca dinâmica para o MySQL. Isso soa estranho. Nós também pensamos assim e decidimos que essa não era a solução que precisávamos.
Versões diferentes para Postgres, MySQL, MongoDB, Redis
Mas isso nos permitiu, como achamos, chegar à solução correta - destacar versões diferentes para diferentes bancos de dados. Isso permitiu isolar a lógica relacionada aos backups de várias bases de dados, que irão acessar uma API comum implementada pelo WAL-G.
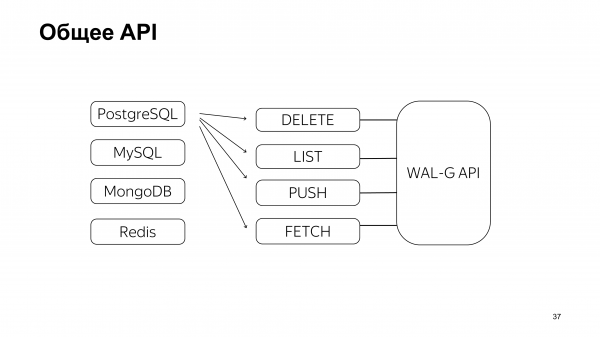
Esta é a parte que escrevemos nós mesmos - antes de dar tarefas aos alunos. Ou seja, esta é precisamente a parte onde eles poderiam fazer algo errado, então decidimos que era melhor fazermos algo nós mesmos e tudo ficaria ótimo.
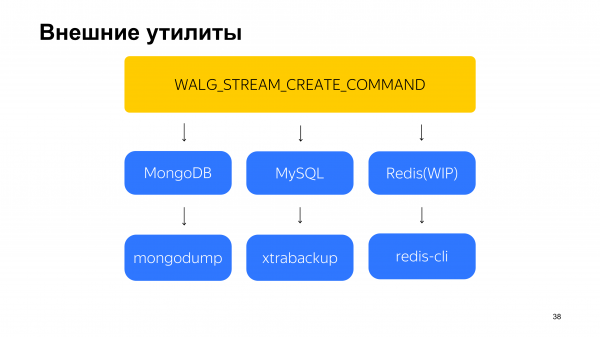
Depois disso, apresentamos as tarefas. Elas foram rapidamente tomadas. Os alunos precisavam suportar três bases de dados.
Esse é o MySQL, que fazemos backup usando o WAL-G dessa maneira há mais de um ano.
E agora o MongoDB já está se aproximando do ambiente de produção, onde está sendo aprimorado. Basicamente, nós escrevemos a estrutura para tudo isso. Depois, os alunos escreveram algumas soluções funcionais. E então nós as refinamos até um estado que podemos aceitar em nossa produção.
Essas tarefas não pareciam que os alunos precisavam escrever ferramentas de backup completas para cada um desses bancos. Não estávamos enfrentando esse problema. Nosso problema era que queríamos recuperação de ponto no tempo e queríamos fazer backup na nuvem. Pedimos aos alunos que escrevessem algum código que resolveria isso. Os alunos utilizaram ferramentas de backup já existentes, que de alguma forma realizam backups, e depois uniram tudo isso ao WAL-G, que transferia tudo para a nuvem. E também adicionaram recuperação de ponto no tempo.
O que mais os alunos trouxeram? Eles trouxeram ao WAL-G suporte para criptografia Libsodium.
Além disso, agora temos políticas de retenção de backups. Agora os backups podem ser marcados como permanentes. E é mais conveniente para o seu serviço automatizar o processo de armazenamento deles.
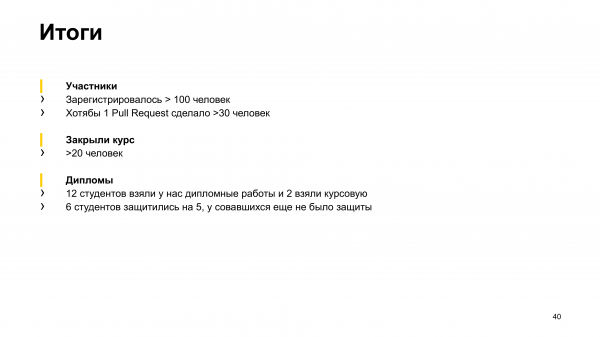
Quais foram os resultados deste experimento?
Inicialmente, mais de 100 pessoas se inscreveram no curso. No começo, não mencionei que a universidade em Yekaterinburgo é a Universidade Federal dos Urais. Anunciamos tudo lá. 100 pessoas se inscreveram. Na verdade, muito menos começou a fazer algo, cerca de 30 pessoas.
Ainda menos pessoas completaram o curso, porque era necessário escrever testes para os códigos que já existiam. Além disso, consertar algum bug ou implementar algum recurso. E uma parte dos alunos conseguiu concluir o curso.
Atualmente, os alunos consertaram cerca de 14 questões e implementaram 10 recursos de diferentes tamanhos. E, na minha opinião, isso é uma substituição completa de um a dois desenvolvedores.
Além de tudo isso, emitimos diplomas e trabalhos de curso. E 12 receberam diplomas. 6 deles já se defenderam com nota '5'. Os demais ainda não tiveram a defesa, mas acredito que também irão se sair bem.
Planos futuros
Quais são nossos planos para o futuro?
Pelo menos os pedidos de recursos que já ouvimos dos usuários e queremos implementar. São eles:
- Monitoramento da correção do acompanhamento da linha do tempo no arquivo de backups do cluster HA. Com o WAL-G, isso pode ser feito. E, acredito que encontraremos alunos que irão assumir essa tarefa.
- Já temos uma pessoa responsável pela transferência de backups e do WAL entre os clouds.
- E recentemente publicamos a ideia de que podemos acelerar o WAL-G ainda mais, mediante a descompactação de backups incrementais sem sobrescrever páginas e a otimização dos arquivos que enviamos.
Vocês podem compartilhá-los aqui
Qual foi o objetivo desta apresentação? O fato de que atualmente, além de nós, os 4 que mantêm este projeto, temos mãos adicionais, que são numerosas. Especialmente se eles forem contatados em particular. E se você está fazendo backup dos seus dados e utilizando o WAL-G ou gostaria de migrar para o WAL-G, suas solicitações podem ser consideradas facilmente.
Este é um QR code e um link. Você pode acessá-los e escrever todas as suas solicitações. Por exemplo, um bug que não estamos consertando. Ou um recurso que você realmente deseja, mas que ainda não está disponível em nenhum serviço de backup, inclusive o nosso. Certifique-se de mencioná-lo.
Perguntas
Olá! Obrigado pela apresentação! Tenho uma pergunta sobre WAL-G, mas não sobre Postgres. O WAL-G faz backup do MySQL e chama o backup extra. Se você pegar instalações modernas no CentOS e fizer yum install MySQL, o MariaDB será instalado. A partir da versão 10.3, o backup extra não é suportado, apenas o backup do MariaDB. Como vocês estão lidando com isso?
No momento, não tentamos fazer backup do MariaDB. Tivemos solicitações de suporte para o FoundationDB, mas, em geral, se houver esse pedido, podemos encontrar pessoas que o façam. Não é tão demorado e não é tão complicado, como me parece.
Boa tarde! Obrigado pela apresentação! Tenho uma pergunta sobre potenciais novos recursos. Vocês estão prontos para fazer o WAL-G funcionar com fitas, para que possamos fazer backup em fitas?
O backup em armazenamento em fita é o que está sendo mencionado, certo?
Sim.
Há o Andrei Borodin, que pode responder a essa pergunta melhor do que eu.
(Andrei) Sim, obrigado pela pergunta! Tivemos um pedido para transferir o backup para fita a partir do armazenamento em nuvem. E para isso a transferência entre nuvens. Porque a transferência entre nuvens é uma versão generalizada da transferência para fita. Além disso, temos uma arquitetura expansível na parte de Armazenamentos. A propósito, muitos Armazenamentos foram escritos por estudantes. E se você escrever um Armazenamento para fita, ele será, claro, suportado. Estamos prontos para considerar pull requests. É necessário escrever um arquivo, ler um arquivo. Se essas coisas forem feitas em Go, geralmente resulta em 50 linhas de código. Então o WAL-G terá suporte para fita.
Obrigado pela apresentação! É um processo de desenvolvimento interessante. O backup é uma parte séria da funcionalidade que deve ser bem coberta por testes. Quando vocês implementaram a funcionalidade para novos bancos, os testes também foram escritos por estudantes ou vocês mesmos escreveram os testes e depois entregaram a implementação aos estudantes?
Os testes também foram escritos por estudantes. Mas os estudantes escreveram mais para recursos como novos bancos. Eles escreveram testes de integração. E eles escreveram testes unitários. Se os testes de integração passam, ou seja, atualmente é um cenário que vocês executam manualmente ou que o cron faz, por exemplo. Ou seja, é um cenário bem compreensível.
Os estudantes não têm muita experiência. Quanto tempo é gasto na revisão?
Sim, a revisão leva bastante tempo. Ou seja, geralmente, quando vários desenvolvedores chegam e dizem que eu fiz isso, eu fiz aquilo, é necessário pensar e reservar meio dia para entender o que eles escreveram. Porque o código precisa ser lido com atenção. Eles não passaram por uma entrevista. Não os conhecemos muito bem, por isso isso leva um tempo considerável.
Obrigado pela apresentação! Anteriormente, Andrey Borodin afirmou que archive_command no WAL-G deve ser chamado diretamente. Mas em caso de algum cluster patrono, precisamos de uma lógica adicional para determinar qual nó deve enviar os logs. Como você resolve esse problema?
Qual é o seu problema aqui? Por exemplo, você tem uma réplica síncrona da qual você está fazendo backups? Ou algo assim?
(Andrey) O fato é que realmente o WAL-G prevê o uso sem a necessidade de scripts shell. Se algo estiver faltando, vamos adicionar a lógica que deve estar dentro do WAL-G. Quanto à origem da arquivação, acreditamos que a arquivação deve ser feita a partir do mestre atual no cluster. Arquivar a partir de uma réplica é uma má ideia. Pode haver vários cenários problemáticos, especialmente com a arquivação de linhas do tempo e informações adicionais. Obrigado pela pergunta!
(Esclarecimento: Eliminamos a dependência de scripts shell )
Boa noite! Obrigado pela apresentação! A funcionalidade de catchup que você mencionou me interessou. Já enfrentamos situações de atraso de réplica que não conseguiam alcançar o estado atual. E não encontrei a descrição dessa funcionalidade na documentação do WAL-G.
Catchup surgiu literalmente nos últimos dias de janeiro de 2020. Pode ser que a documentação precise de uma revisão mais cuidadosa. Nós mesmos estamos escrevendo e não está perfeito. Também talvez deva começar a exigir que os alunos contribuam para a documentação.
Ela já está disponível na versão?
O pull request já foi mesclado, ou seja, eu o verifiquei. Testei isso em um cluster de teste. Até agora, não tivemos uma situação em que pudéssemos testá-lo em um caso real.
Quando podemos esperar isso?
Eu não sei. Espere um mês, vamos verificar com certeza.
Fonte: habr.com
