

Recentemente, falei sobre como usar receitas típicas em um banco de dados PostgreSQL. Hoje, vamos discutir como tornar a gravação no banco de dados mais eficiente sem usar quaisquer 'configurações complexas' — apenas organizando corretamente os fluxos de dados.
#1. Секционирование
Este artigo é sobre como e por que devemos organizar que já foi discutido, e aqui falaremos sobre a prática da aplicação de algumas abordagens dentro do nosso .
“Tempos que já passaram...”
Inicialmente, como qualquer MVP, nosso projeto começou com uma carga bastante baixa — o monitoramento era feito apenas para uma dezena de servidores críticos, com todas as tabelas relativamente compactas... Mas o tempo passou, o número de hosts monitorados começou a crescer, e ao tentar mais uma vez resolver um problema com uma das tabelas de 1.5TB, percebemos que era possível continuar assim, mas muito inconveniente.
Os tempos eram quase lendários, e diferentes versões do PostgreSQL 9.x eram relevantes, portanto, todo o particionamento teve que ser feito 'manual' — através de herança de tabelas e gatilhos de roteamento dinâmico. EXECUTAR.
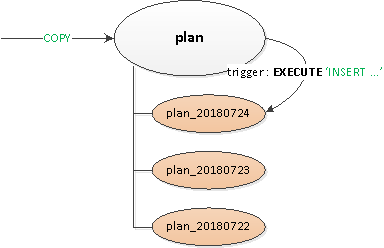
A solução resultante se mostrou bastante universal, permitindo ser aplicada a todas as tabelas:
- Uma tabela parent 'vazia' foi declarada, na qual todos os índices e gatilhos necessários foram descritos..
- A gravação do ponto de vista do cliente era feita na tabela 'raiz', e internamente, usando um gatilho de roteamento
BEFORE INSERT, a gravação era 'fisicamente' inserida na seção apropriada. Se essa ainda não existisse — capturávamos a exceção e... - ... usando segundo o modelo da tabela parent, uma seção com limitação na data necessária era criada, para que ao extrair dados, a leitura fosse feita apenas nela.
PG10: a primeira tentativa
Mas o particionamento por herança historicamente não era muito adaptado para trabalhar com um fluxo ativo de gravação ou um grande número de seções-filhas. Por exemplo, é lembrado que o algoritmo para escolher a seção correta tinha complexidade quadrática, o que, com 100+ seções, funciona como você pode imaginar...
No PG10, essa situação foi significativamente otimizada, implementando o suporte para . Portanto, tentamos aplicá-lo imediatamente após a migração do armazenamento, mas…
Como descobrimos depois de analisar o manual, a tabela segmentada nativamente nesta versão:
- não suporta a descrição de índices
- não suporta triggers
- não pode ser descendente de ninguém
- não suporta
INSERT ... ON CONFLICT - não consegue gerar a seção automaticamente
Após levar uma pancada na cabeça, entendemos que não conseguiríamos evitar a modificação do aplicativo, e adiamos as investigações por seis meses.
PG10: uma segunda chance
Assim, começamos a resolver os problemas que surgiram um por um:
- Como os triggers e
ON CONFLICTse mostraram úteis em algumas situações, para sua implementação fizemos uma tabela proxy. - Eliminamos o ‘routed’ nos triggers — ou seja, a
EXECUTAR. - Separámos uma tabela modelo com todos os índices, para que eles nem sequer estivessem presentes na tabela proxy.
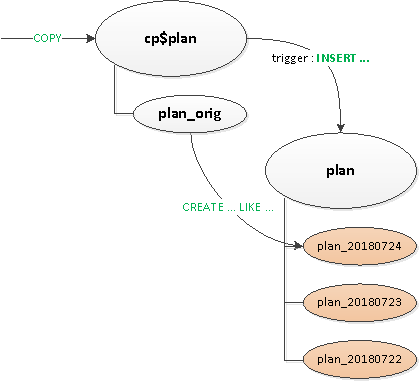
Finalmente, depois de tudo isso, segmentamos nativamente a tabela principal. A criação de uma nova seção ainda ficou a cargo do aplicativo.
Estamos ‘desenvolvendo’ dicionários
Como em qualquer sistema analítico, nós também tínhamos ‘fatos’ e ‘cortes’ (dicionários). No nosso caso, neste papel atuavam, por exemplo, de consultas lentas homogêneas ou o texto da própria consulta.
Os ‘fatos’ já estavam segmentados por dias há muito tempo, então conseguimos deletar seções antigas sem problemas (os logs, claro!). Mas tivemos problemas com os dicionários…
Não posso dizer que havia muitos deles, mas cerca de para 100TB de ‘fatos’ houve um dicionário de 2.5TB.Dessa tabela, não se consegue deletar nada de forma prática, não se consegue compactar em um tempo razoável, e escrever nela foi se tornando gradualmente mais lento.
Parece que um dicionário… cada entrada deve aparecer exatamente uma vez… e isso está certo, mas!.. Ninguém impede que tenhamos um dicionário separado para cada dia! Sim, isso traz certa redundância, mas permite:
- escrever/ler mais rapidamente graças ao tamanho menor da seção
- consumir menos memória graças ao trabalho com índices mais compactos
- armazenar menos dados graças à possibilidade de deletar rapidamente os obsoletos
Como resultado de todo esse conjunto de medidas a carga de CPU foi reduzida em cerca de 30%, e a carga no disco em cerca de 50%:
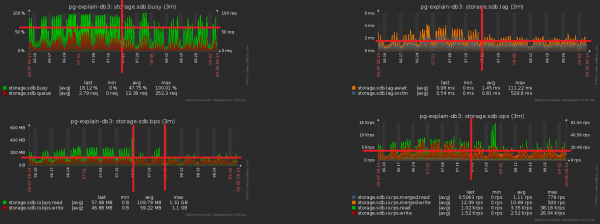
Continuamos a escrever na base exatamente a mesma coisa, apenas com uma carga menor.
#2. Эволюция и рефакторинг БД
Assim, paramos no ponto em que temos uma seção específica para cada dia com dados. Na verdade, CHECK (dt = '2018-10-12'::date) é a chave de particionamento e a condição para que o registro pertença a uma seção específica.
Como todos os relatórios em nosso serviço são construídos em termos de uma data específica, os índices, que já existiam desde os tempos 'não particionados', eram todos do tipo (Servidor, Data, Modelo de plano), (Servidor, Data, Nó do plano), (Data, Classe de erro, Servidor),…
Mas agora, em cada seção, existem suas próprias instâncias de cada um desses índices... E dentro de cada seção a data é uma constante... Assim, agora estamos apenas inserindo essa constante como um dos campos em cada um desses índices, o que aumenta tanto o seu volume quanto o tempo de busca, mas não traz nenhum resultado. Nos deixamos pegar por isso, ups... A direção da otimização é óbvia — simplesmente
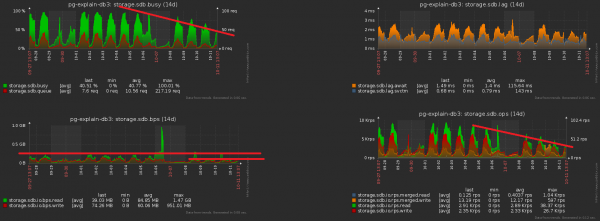
removemos o campo da data de todos os índices nas tabelas particionadas. Com nosso volume, a economia é de cerca de 1TB/semana Agora, vamos notar que esse terabyte ainda precisava ser gravado de alguma forma. Ou seja, tivemos que!
carregar o disco menos agora ! Nesta imagem, é bem visível o efeito obtido da limpeza que dedicamos uma semana:Uma das grandes dores em sistemas sobrecarregados é a
#3. «Размазываем» пиковую нагрузку
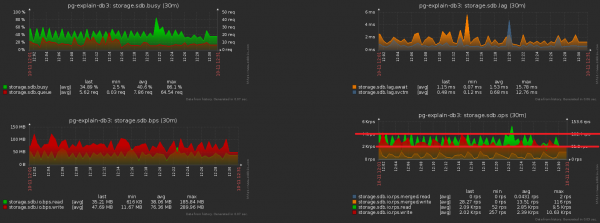
sincronização excessiva de algumas operações que não a requerem. Às vezes, "porque não notamos", outras vezes "porque era mais fácil", mas cedo ou tarde é necessário se livrar disso. Aproximamos a imagem anterior — e vemos que o disco
"carrega" com uma amplitude dobrada entre as medições adjacentes, o que claramente "estatisticamente" não deveria acontecer com essa quantidade de operações: É bastante simples conseguir isso. Já tínhamos monitorado quase
1000 servidores, cada um processado por um fluxo lógico separado, e cada fluxo descarrega as informações acumuladas para enviar à base com certa periodicidade, aproximadamente assim:setInterval(sendToDB, interval)
O problema aqui está exatamente no fato de quetodos os fluxos começam aproximadamente ao mesmo tempo , por isso os momentos de envio deles quase sempre coincidem "até a vírgula". Ups nº 2...Felizmente, isso pode ser corrigido com facilidade,
adicionando um "deslocamento aleatório" no tempo: por tempo:
setInterval(sendToDB, interval * (1 + 0.1 * (Math.random() - 0.5)))#4. Кэшируем, что нужно можно
O terceiro problema tradicional do highload — a falta de cache onde ele poderia deve estar.
Por exemplo, nós possibilitamos a análise em relação aos nós do plano (todos esses Seq Scan on users), mas logo se pensou que eram, em massa, idênticos — esqueceram.
Não, claro, nada é reescrito no banco, isso elimina o gatilho com INSERT ... ON CONFLICT DO NOTHING. Mas esses dados ainda chegam ao banco, e há uma leitura extra para verificar conflitos que precisa ser feita. Uups nº 3…
A diferença no número de registros enviados ao banco antes/depois da ativação do cache — é óbvia:
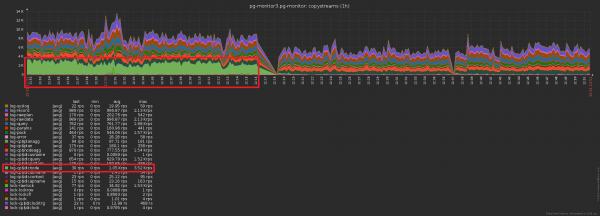
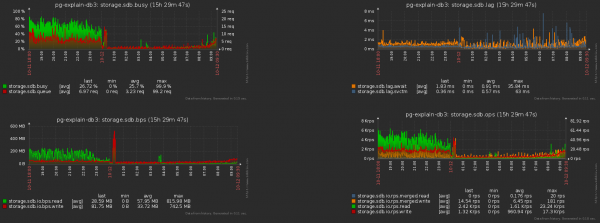
E isso — uma queda associada na carga de armazenamento:
Total
«Terabyte-por-dia» só soa assustador. Se você fizer tudo certo, na verdade é apenas 2^40 bytes / 86400 segundos = ~12.5MB/s, que já eram suportados até por discos IDE de mesa. 🙂
E se formos sérios, mesmo com um «desequilíbrio» de carga dez vezes maior ao longo do dia, você pode facilmente se adequar às capacidades dos SSDs modernos.
Fonte: habr.com
