

A arquitetura de microsserviços, assim como tudo neste mundo, tem suas vantagens e desvantagens. Alguns processos se tornam mais simples, enquanto outros se tornam mais complexos. E, em nome da velocidade das mudanças e de uma melhor escalabilidade, é preciso fazer sacrifícios. Um deles é a complexidade da análise. Enquanto em um monólito toda a análise operacional pode ser reduzida a consultas SQL a uma réplica analítica, na arquitetura de múltiplos serviços, cada serviço possui seu próprio banco de dados, e parece que não é possível contornar isso com uma única consulta (ou talvez seja?). Para aqueles que estão interessados em como resolvemos o problema da análise operacional em nossa empresa e como aprendemos a conviver com essa solução — sejam bem-vindos.
Meu nome é Pavel Sivash, e na Domclick trabalho na equipe responsável pela manutenção do armazém de dados analíticos. Nossa atividade pode ser resumida como engenharia de dados, mas, na verdade, o espectro de tarefas é muito mais amplo. Existem as funções padrão da engenharia de dados, como ETL/ELT, suporte e adaptação de ferramentas para análise de dados, e o desenvolvimento de nossas próprias ferramentas. Em particular, para relatórios operacionais, decidimos "fingir" que temos um monólito e dar aos analistas um único banco de dados, que contenha todas as informações necessárias para eles.
No geral, consideramos várias opções. Poderíamos construir um armazenamento completo — até tentamos, mas, para ser honesto, não conseguimos alinhar as mudanças frequentes na lógica com o processo relativamente lento de construção do armazenamento e a inclusão de alterações nele (se alguém conseguiu, escreva nos comentários como). Poderíamos ter dito aos analistas: "Pessoal, aprendam Python e usem réplicas analíticas", mas isso seria um requisito adicional na seleção de pessoal e parecia que poderíamos evitar esse custo, se possível. Decidimos experimentar a tecnologia FDW (Foreign Data Wrapper): essencialmente, é um dblink padrão que existe no padrão SQL, mas com uma interface muito mais conveniente. Com base nisso, criamos uma solução que acabou se consolidando e foi a que escolhemos. Os detalhes dela são tema de um artigo à parte, ou talvez mais de um, já que há muito a se contar: desde a sincronização de esquemas de bancos até a gestão de acesso e a desidentificação de dados pessoais. Também é necessário esclarecer que esta solução não substitui bancos analíticos reais e armazéns de dados; ela resolve apenas uma tarefa específica.
Em um nível mais alto, isso parece assim:
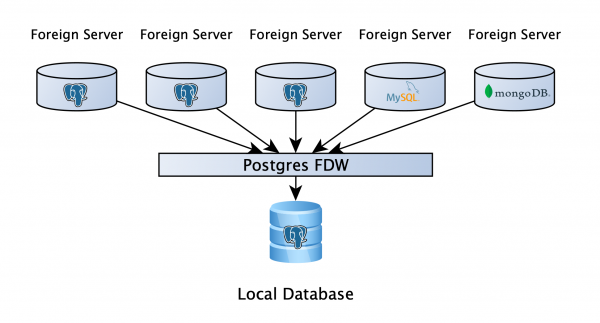
Há um banco de dados PostgreSQL, onde os usuários podem armazenar seus dados de trabalho, e o mais importante — a esse banco está conectado, através do FDW, as réplicas analíticas de todos os serviços. Isso possibilita escrever uma consulta para vários bancos, independentemente de serem: PostgreSQL, MySQL, MongoDB ou qualquer outra coisa (um arquivo, API, se não houver um wrapper adequado, você pode escrever o seu próprio). Bem, isso é tudo, maravilha! Vamos embora?
Se tudo terminasse tão rapidamente e facilmente, provavelmente não haveria artigo algum.
É importante ter uma compreensão clara de como o PostgreSQL processa consultas a servidores remotos. Isso parece lógico, no entanto, muitas vezes não se presta atenção a isso: o PostgreSQL divide a consulta em partes que são executadas nos servidores remotos de forma independente, coleta esses dados e realiza os cálculos finais, portanto, a velocidade de execução da consulta dependerá muito de como ela é escrita. Também é importante observar: quando os dados chegam de um servidor remoto, eles já não possuem índices, não têm nada que ajude o planejador, portanto, só podemos ajudar e orientar usando nosso próprio trabalho. E é exatamente isso que quero detalhar mais.
Consulta simples e plano com ele
Para mostrar como o PostgreSQL executa uma consulta em uma tabela com 6 milhões de linhas remotamente servidor, vamos dar uma olhada em um plano simples.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table;

Aggregate  (cost=418383.23..418383.24 rows=1 width=8) (actual time=3857.198..3857.198 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..402376.14 rows=6402838 width=0) (actual time=4.874..3256.511 rows=6406868 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table
Planning time: 0.986 ms
Execution time: 3857.436 ms
O uso da instrução VERBOSE permite ver a consulta que será enviada ao servidor remoto e os resultados que obteremos para processamento adicional (linha RemoteSQL).
Vamos dar um passo além e adicionar alguns filtros à nossa consulta: um por booleano campo, um por ocorrência timestamp em intervalo e um por jsonb.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta->>'source' = 'test';

Aggregate  (cost=577487.69..577487.70 rows=1 width=8) (actual time=27473.818..25473.819 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..577469.21 rows=7390 width=0) (actual time=31.369..25372.466 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)))
        Rows Removed by Filter: 5046843
        Remote SQL: SELECT created_dt, is_active, meta FROM fdw_schema.table
Planning time: 0.665 ms
Execution time: 27474.118 ms
É exatamente aqui que está o ponto a ser observado ao escrever consultas. Os filtros não foram enviados para o servidor remoto, o que significa que, para executá-los, o PostgreSQL puxa todas as 6 milhões de linhas para depois filtrar localmente (linha Filter) e realizar a agregação. O segredo do sucesso é escrever a consulta de forma que os filtros sejam enviados à máquina remota, resultando apenas nas linhas que precisamos.
Isso é uma verdadeira bobagem
Com campos booleanos, tudo é simples. No pedido original, o problema surgiu devido ao operador is. Se substituirmos por =, obteremos o seguinte resultado:
explicar analisar detalhadamente
SELECIONE count(1)
DE fdw_schema.tabela
ONDE is_active = Verdadeiro
E created_dt ENTRE A DATA_ATUAL - INTERVALO '7 meses'
E A DATA_ATUAL - INTERVALO '6 meses'
E meta->>'source' = 'teste';

Agregado (custo=508010.14..508010.15 linhas=1 largura=8) (tempo real=19064.314..19064.314 linhas=1 loops=1)
  Saída: count(1)
  -> Digitalizar Remota em fdw_schema."tabela" (custo=100.00..507988.44 linhas=8679 largura=0) (tempo real=33.035..18951.278 linhas=1360025 loops=1)
        Saída: "tabela".id, "tabela".is_active, "tabela".meta, "tabela".created_dt
        Filtro: ((("tabela".meta ->> 'source'::text) = 'teste'::text) E ("tabela".created_dt >= (('agora'::cstring)::data - '7 meses'::intervalo)) E ("tabela".created_dt <= ((('agora'::cstring)::data)::timestamp com fuso horário - '6 meses'::intervalo)))
        Linhas Removidas pelo Filtro: 3567989
        SQL Remoto: SELECIONE created_dt, meta DE fdw_schema.tabela ONDE (is_active)
Tempo de planejamento: 0.834 ms
Tempo de execução: 19064.534 ms
Como você pode ver, o filtro foi para o servidor remoto, e o tempo de execução diminuiu de 27 para 19 segundos.
Vale a pena notar que o operador is diferencia-se do operador = porque ele pode lidar com o valor Nulo. Isso significa que não é Verdadeiro no filtro deixará valores Falsos e Nulos, enquanto que != Verdadeiro deixará apenas valores Falsos. Portanto, ao substituir o operador não é deve-se passar no filtro duas condições com o operador OU, por exemplo, ONDE (col != Verdadeiro) OU (col é nulo).
Resolvido o booleano, vamos seguir em frente. Enquanto isso, vamos retornar o filtro sobre o valor booleano ao seu estado original, para analisar de forma independente o efeito de outras mudanças.
timestamptz? hz
Na verdade, muitas vezes é necessário experimentar como escrever corretamente uma consulta que envolva servidores remotos, e depois buscar explicações para o que acontece. Há muito pouca informação sobre isso disponível na Internet. Em nossos experimentos, descobrimos que o filtro por data fixa funciona bem no servidor remoto, mas quando tentamos definir a data dinamicamente, como now() ou CURRENT_DATE, isso não acontece. No nosso exemplo, adicionamos tal filtro para que a coluna created_at contivesse dados exatamente de 1 mês atrás (BETWEEN CURRENT_DATE - INTERVAL ‘7 meses’ AND CURRENT_DATE - INTERVAL ‘6 meses’). O que fizemos nesse caso?
explicar analisar detalhadamente
SELECIONE contagem(1)
DE fdw_schema.tabela
ONDE is_active é Verdadeiro
E created_dt >= (SELECIONE CURRENT_DATE::timestamptz - INTERVALO '7 meses')
E created_dt >'source' = 'teste';

Agregado (custo=306875,17..306875,18 linhas=1 largura=8) (tempo real=4789,114..4789,115 linhas=1 loops=1)
  Saída: contagem(1)
  InitPlan 1 (retorna $0)
    -> Resultado (custo=0.00..0.02 linhas=1 largura=8) (tempo real=0,007..0,008 linhas=1 loops=1)
          Saída: ((('agora'::cstring)::data)::timestamp com fuso horário - '7 meses'::intervalo)
  InitPlan 2 (retorna $1)
    -> Resultado (custo=0.00..0.02 linhas=1 largura=8) (tempo real=0,002..0,002 linhas=1 loops=1)
          Saída: ((('agora'::cstring)::data)::timestamp com fuso horário - '6 meses'::intervalo)
  -> Busca Externa na fdw_schema."tabela" (custo=100,02..306874,86 linhas=105 largura=0) (tempo real=23,475..4681,419 linhas=1360025 loops=1)
        Saída: "tabela".id, "tabela".is_active, "tabela".meta, "tabela".created_dt
        Filtro: (("tabela".is_active É VERDADEIRO) E (("tabela".meta ->> 'source'::texto) = 'teste'::texto))
        Linhas Removidas pelo Filtro: 76934
        SQL Remoto: SELECIONE is_active, meta DA fdw_schema.tabela ONDE ((created_dt >= $1::timestamp com fuso horário)) E ((created_dt < $2::timestamp com fuso horário))
Tempo de planejamento: 0,703 ms
Tempo de execução: 4789,379 ms
Nós dissemos ao planejador para calcular antecipadamente a data na subconsulta e passar uma variável já pronta para o filtro. E essa dica nos deu um resultado excelente, a consulta ficou quase 6 vezes mais rápida!
Mais uma vez, é importante ter cuidado: o tipo de dado na subconsulta deve ser o mesmo que o do campo pelo qual filtramos, caso contrário, o planejador decidirá que como os tipos são diferentes, é necessário obter todos os dados e filtrar localmente.
Vamos retornar o filtro de data para seu valor original.
Freddy vs. Jsonb
De fato, os campos booleanos e as datas já aceleraram bastante nossa consulta, mas ainda havia um tipo de dado restante. A batalha para filtrá-lo, honestamente, ainda não acabou, embora tenhamos feito progressos aqui também. Então, aqui está como conseguimos passar o filtro por jsonb campo para o servidor remoto.
explicar analisar detalhadamente
SELECIONE contagem(1)
DE fdw_schema.tabela
ONDE is_active é Verdadeiro
E created_dt ENTRE CURRENT_DATE - INTERVALO '7 meses'
E CURRENT_DATE - INTERVALO '6 meses'
E meta @> '{"source":"teste"}'::jsonb;

Agregado (custo=245463,60..245463,61 linhas=1 largura=8) (tempo real=6727,589..6727,590 linhas=1 loops=1)
  Saída: contagem(1)
  -> Busca Externa na fdw_schema."tabela" (custo=1100,00..245459,90 linhas=1478 largura=0) (tempo real=16,213..6634,794 linhas=1360025 loops=1)
        Saída: "tabela".id, "tabela".is_active, "tabela".meta, "tabela".created_dt
        Filtro: (("tabela".is_active É VERDADEIRO) E ("tabela".created_dt >= (('agora'::cstring)::data - '7 meses'::intervalo)) E ("tabela".created_dt  '{"source": "teste"}'::jsonb))
Tempo de planejamento: 0,747 ms
Tempo de execução: 6727,815 ms
Em vez de operadores de filtragem, deve-se usar o operador de existência de um jsonb em outro. 7 segundos em vez dos 29 originais. Até agora, esta é a única opção bem-sucedida de transferência de filtros por jsonb para um servidor remoto, mas aqui é importante considerar uma limitação: estamos usando a versão 9.6 do banco de dados, no entanto, até o final de abril, planejamos concluir os últimos testes e migrar para a versão 12. Assim que atualizarmos, escreveremos sobre como isso afetou, pois há muitas mudanças nas quais temos grandes esperanças: json_path, novo comportamento de CTE, push down (existente desde a versão 10). Estamos ansiosos para experimentar.
Acabe com ele
Verificamos como cada alteração afeta a velocidade da consulta individualmente. Agora vamos ver o que acontece quando os três filtros são escritos corretamente.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 month')
AND created_dt  '{"source":"test"}'::jsonb;

Aggregate  (cost=322041.51..322041.52 rows=1 width=8) (actual time=2278.867..2278.867 rows=1 loops=1)
  Output: count(1)
  InitPlan 1 (returns $0)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.010..0.010 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '7 mons'::interval)
  InitPlan 2 (returns $1)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.003..0.003 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.02..322041.41 rows=25 width=0) (actual time=8.597..2153.809 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table WHERE (is_active) AND ((created_dt >= $1::timestamp with time zone)) AND ((created_dt  '{"source": "test"}'::jsonb))
Planning time: 0.820 ms
Execution time: 2279.087 ms
Sim, a consulta parece mais complexa, é um preço a ser pago, mas a velocidade de execução é de 2 segundos, o que é mais de 10 vezes mais rápido! E estamos falando de uma consulta simples a um conjunto de dados relativamente pequeno. Nas consultas reais, vimos aumentos de até várias centenas de vezes.
Vamos resumir: se você estiver usando PostgreSQL com FDW, sempre verifique se todos os filtros estão sendo enviados para o servidor remoto, e você será feliz... Pelo menos, até você chegar aos joins entre tabelas de diferentes servidores. Mas essa é uma história para outro artigo.
Obrigado pela atenção! Ficarei feliz em ouvir perguntas, comentários, bem como histórias sobre sua experiência nos comentários.
Fonte: habr.com
