

O efeito de inchaço de tabelas e índices (bloat) é amplamente conhecido e está presente não apenas no Postgres. Existem maneiras de combatê-lo “fora da caixa”, como VACUUM FULL ou CLUSTER, mas eles bloqueiam as tabelas durante o funcionamento e, portanto, nem sempre podem ser utilizados.
Neste artigo, haverá um pouco de teoria sobre como o bloat surge, como podemos combatê-lo, sobre restrições deferred e sobre os problemas que elas trazem ao uso da extensão pg_repack.
Este artigo foi baseado em na PgConf.Russia 2020.
Por que o bloat ocorre
A base do Postgres é um modelo multiversionado (). Sua essência é que cada linha em uma tabela pode ter várias versões, enquanto as transações veem no máximo uma dessas versões, mas não necessariamente a mesma. Isso permite que várias transações operem simultaneamente, sem afetar uma à outra.
É evidente que todas essas versões precisam ser armazenadas. O Postgres opera na memória página por página, e uma página é a quantidade mínima de dados que pode ser lida do disco ou gravada. Vamos considerar um pequeno exemplo para entender como isso acontece.
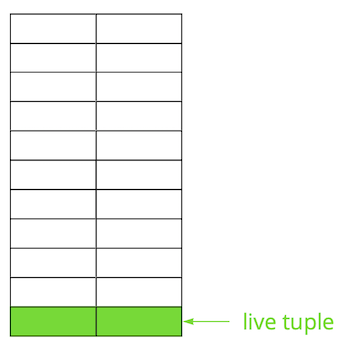
Suponha que temos uma tabela na qual adicionamos algumas entradas. Na primeira página do arquivo onde a tabela é guardada, novos dados foram inseridos. Essas são as versões ativas das linhas, que estão disponíveis para outras transações após o commit (para simplificar, vamos considerar o nível de isolamento Read Committed).
Em seguida, atualizamos uma das entradas, marcando assim a versão antiga como obsoleta.
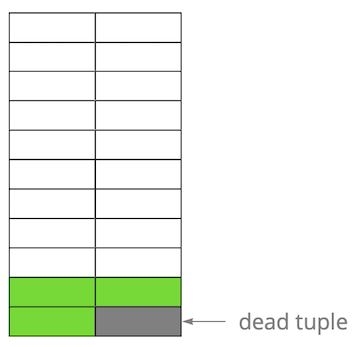
Passo a passo, ao atualizar e remover versões de linhas, obtemos uma página na qual aproximadamente metade dos dados é “lixo”. Esses dados não são visíveis para nenhuma transação.
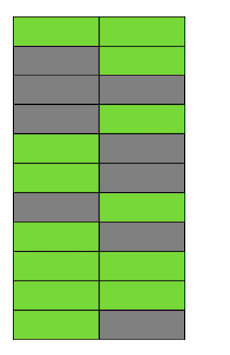
No Postgres, existe um mecanismo , que remove versões obsoletas e libera espaço para novos dados. Mas se ele não estiver configurado de forma suficientemente agressiva ou estiver ocupado com trabalho em outras tabelas, os “dados lixo” permanecem, e temos que usar páginas adicionais para novos dados.
Assim, em nosso exemplo, em algum momento a tabela consistirá em quatro páginas, mas os dados válidos nela serão apenas a metade. Como resultado, ao acessar a tabela, estaremos lendo muito mais dados do que o necessário.
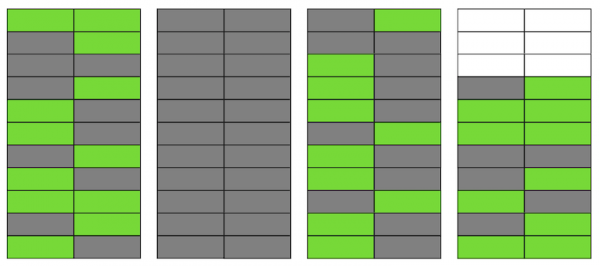
Mesmo que o VACUUM remova todas as versões obsoletas de linhas agora, a situação não melhorará drasticamente. Teremos espaço livre em páginas ou até mesmo páginas inteiras para novas linhas, mas ainda assim, vamos ler mais dados do que o necessário.
Aliás, se uma página completamente vazia (a segunda em nosso exemplo) estivesse no final do arquivo, o VACUUM poderia cortá-la. Mas agora ela está no meio, então não há nada que se possa fazer.
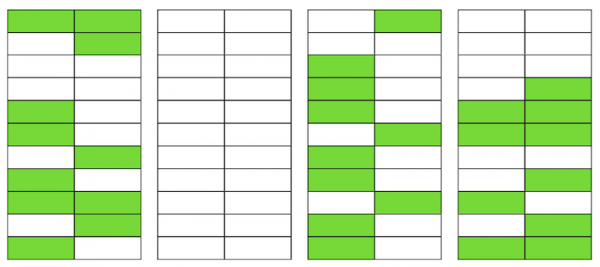
Quando o número de páginas vazias ou muito esparsas se torna grande, o que chamamos de bloat, isso começa a afetar o desempenho.
Toda a mecânica acima descreve como o bloat se origina nas tabelas. Nos índices, isso ocorre de maneira semelhante.
E eu tenho bloat?
Existem várias maneiras de determinar se você tem bloat. A ideia da primeira é usar as estatísticas internas do Postgres, que contêm informações aproximadas sobre o número de linhas nas tabelas, o número de linhas 'vivas', etc. Na internet, você pode encontrar muitas variações de scripts prontos. Nós adotamos como base do PostgreSQL Experts, que pode avaliar o bloat das tabelas juntamente com o toast e o bloat de índices btree. Pela nossa experiência, sua margem de erro é de 10-20%.
Outra maneira é usar a extensão , que permite olhar dentro das páginas e obter tanto uma estimativa quanto um valor exato de bloat. Mas, neste segundo caso, será necessário escanear toda a tabela.
Um valor pequeno de bloat, até 20%, é considerado aceitável. Ele pode ser considerado um análogo do fillfactor para e . Com 50% ou mais, podem surgir problemas de desempenho.
Maneiras de combater o bloat
No Postgres, existem várias maneiras de combater o bloat 'de fábrica', mas nem sempre essas opções são adequadas para todos.
Configurar o AUTOVACUUM para evitar que o bloat ocorra. E se formos mais precisos, para que ele se mantenha em um nível aceitável para você. Pode parecer um conselho “de capitão”, mas na realidade isso nem sempre é fácil de alcançar. Por exemplo, se você estiver desenvolvendo activamente com alterações regulares no esquema de dados, ou se estiver ocorrendo alguma migração de dados. Como resultado, seu perfil de carga pode mudar frequentemente e, na maioria das vezes, é diferente para diferentes tabelas. Isso significa que você precisa trabalhar um pouco à frente e ajustar o AUTOVACUUM ao perfil em mudança de cada tabela. Mas, claramente, fazer isso não é simples.
Outra causa comum para o AUTOVACUUM não conseguir processar as tabelas é a presença de transações longas, que impedem que ele limpe os dados, pois esses dados estão disponíveis para essas transações. A recomendação aqui também é óbvia – livrar-se das transações “penduradas” e minimizar o tempo das transações ativas. Mas se a carga do seu aplicativo é uma mistura de OLAP e OLTP, você pode ter ao mesmo tempo muitas atualizações frequentes e consultas curtas, assim como operações longas – por exemplo, a geração de algum relatório. Nessa situação, vale a pena considerar a distribuição da carga em diferentes bancos de dados, o que permitirá um ajuste mais fino de cada um deles.
Outro exemplo – mesmo que o perfil seja homogêneo, mas o BD esteja sob uma carga muito alta, mesmo o AUTOVACUUM mais agressivo pode não dar conta, e o bloat surgirá. Escalar (vertical ou horizontalmente) é a única solução.
Como devemos proceder na situação em que você configurou o AUTOVACUUM, mas o bloat continua a crescer.
Time VACUUM FULL reorganiza o conteúdo das tabelas e dos índices, deixando apenas os dados atuais. Para eliminar o bloat, funciona perfeitamente, mas durante sua execução, uma bloqueio exclusivo na tabela (AccessExclusiveLock) é adquirido, o que impede a execução de consultas nessa tabela, incluindo selects. Se você pode se permitir parar seu serviço ou parte dele por algum tempo (de dezenas de minutos a várias horas, dependendo do tamanho do BD e do seu hardware), então essa opção é a melhor. Infelizmente, não conseguimos executar o VACUUM FULL no tempo programado de manutenção, portanto essa abordagem não nos serve.
Time CLUSTER também reorganiza o conteúdo das tabelas, assim como o VACUUM FULL, permitindo especificar um índice segundo o qual os dados serão fisicamente ordenados no disco (mas, no futuro, a ordem não é garantida para novas linhas). Em certas situações, isso é uma boa otimização para várias consultas – ao ler várias entradas por índice. A desvantagem deste comando é a mesma que a do VACUUM FULL – ele bloqueia a tabela durante a execução.
Time REINDEX é semelhante aos dois anteriores, mas executa a reconstrução de um índice específico ou de todos os índices da tabela. Os bloqueios são um pouco mais fracos: ShareLock na tabela (impede modificações, mas permite executar selects) e AccessExclusiveLock no índice que está sendo reconstruído (bloqueia consultas que utilizam este índice). No entanto, na versão 12 do Postgres surgiu o parâmetro , que permite reconstruir o índice sem bloquear a adição, alteração ou exclusão paralela de registros.
Em versões anteriores do Postgres, é possível obter um resultado semelhante ao REINDEX CONCURRENTLY usando . Ele permite criar um índice sem um bloqueio estrito (ShareUpdateExclusiveLock, que não impede consultas paralelas), em seguida, substituir o índice antigo pelo novo e remover o índice antigo. Isso ajuda a eliminar o bloat dos índices, sem interromper o funcionamento da sua aplicação. É importante considerar que ao reconstruir os índices haverá uma carga adicional no subsistema de disco.
Assim, se existem maneiras de eliminar o bloat dos índices "em quente", não existem maneiras para as tabelas. Aqui entram várias extensões externas: (anteriormente pg_reorg), , e outras. Neste artigo, não farei comparações e falarei apenas sobre o pg_repack, que após alguns ajustes usamos internamente.
Como funciona o pg_repack
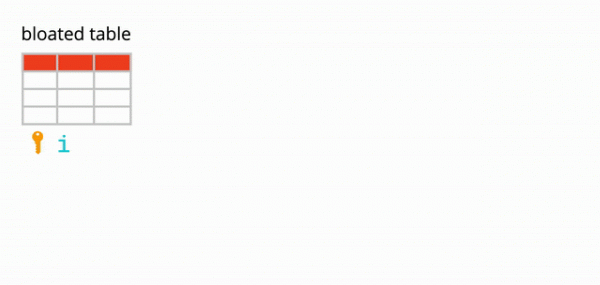
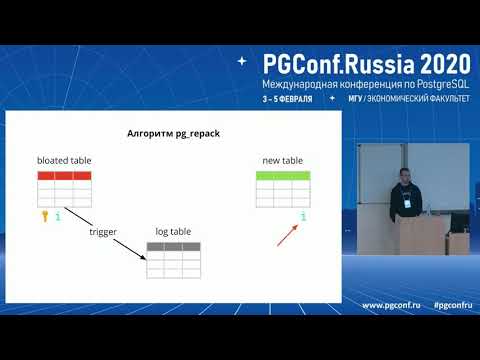
Suponhamos que temos uma tabela bastante comum – com índices, restrições e, infelizmente, com bloat. O primeiro passo do pg_repack é criar uma tabela de log para armazenar dados sobre todas as alterações durante a execução. O gatilho irá replicar essas alterações em cada insert, update e delete. Em seguida, cria-se uma tabela, semelhante à original em estrutura, mas sem índices e restrições, para não atrasar o processo de inserção de dados.
Em seguida, o pg_repack transfere para uma nova tabela os dados da antiga, filtrando automaticamente todas as linhas obsoletas e, em seguida, cria índices para a nova tabela. Durante a execução de todas essas operações, as alterações se acumulam na tabela de log.
A próxima etapa é transferir as alterações para a nova tabela. A transferência é realizada em várias iterações e, quando a tabela de log contém menos de 20 registros, o pg_repack adquire um bloqueio rigoroso, transfere os dados finais e substitui a tabela antiga pela nova nas tabelas de sistema do Postgres. Este é o único e muito curto momento em que você não poderá trabalhar com a tabela. Após isso, a tabela antiga e a tabela de logs são excluídas, liberando espaço no sistema de arquivos. O processo está concluído.
Na teoria, tudo parece ótimo, mas como é na prática? Nós testamos o pg_repack sem carga e sob carga, verificamos seu funcionamento em caso de parada prematura (em outras palavras, com Ctrl+C). Todos os testes foram positivos.
Fomos para o ambiente de produção – e aqui tudo não saiu como esperávamos.
O primeiro erro em produção
No primeiro cluster, recebemos um erro sobre violação de restrição única:
$ ./pg_repack -t tablename -o id
INFO: reorganizando tabela "tablename"
ERROR: a consulta falhou:
    ERROR: valor de chave duplicado viola a restrição única "index_16508"
DETALHES:  Chave (id, index)=(100500, 42) já existe.
Essa restrição tinha um nome gerado automaticamente, index_16508 – foi criada pelo pg_repack. Com os atributos que a compõem, identificamos uma “nossa” restrição correspondente. O problema é que não se trata de uma restrição comum, mas sim de uma restrição adiada (), ou seja, sua verificação é realizada posteriormente à execução do comando SQL, o que leva a consequências inesperadas.
Restrições adiadas: por que são necessárias e como funcionam
Um pouco de teoria sobre restrições adiadas.
Vamos considerar um exemplo simples: temos uma tabela de referência de carros com dois atributos – nome e ordem do carro na referência.
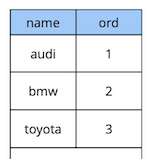
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique
);
Suponha que precisemos trocar os primeiros e segundos carros de lugar. A solução “frontal” seria atualizar o primeiro valor para o segundo e o segundo para o primeiro:
begin;
  update cars set ord = 2 where name = 'audi';
  update cars set ord = 1 where name = 'bmw';
commit;
Porém, ao executar esse código, esperamos receber uma violação de restrição, pois a ordem dos valores na tabela é única:
[23305] ERRO: valor de chave duplicado viola a restrição única “uk_cars”
Detalhe: A chave (ord)=(2) já existe.
Como fazer diferente? Primeira opção: adicionar uma substituição de valor adicional para uma ordem que não exista garantidamente na tabela, por exemplo “-1”. Na programação, isso é chamado de “troca de valores entre duas variáveis usando uma terceira”. A única desvantagem desse método é a atualização adicional.
Segunda opção: redesenhar a tabela para usar um tipo de dados de ponto flutuante para o valor da ordem, em vez de números inteiros. Assim, ao atualizar um valor de 1, por exemplo, para 2.5, o primeiro registro automaticamente ficará entre o segundo e o terceiro. Essa solução funciona, mas há duas limitações. Primeiro, ela não servirá se o valor for utilizado em algum lugar na interface. Em segundo lugar, dependendo da precisão do tipo de dados, você terá um número limitado de inserções possíveis antes de realizar o reescrita de valores de todos os registros.
Terceira opção: tornar a restrição adiada, para que seja verificada apenas no momento do commit:
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique deferrable initially deferred
);
Uma vez que a lógica de nossa consulta inicial garante que, no momento do commit, todos os valores são únicos, ela será executada com sucesso.
O exemplo acima, claro, é muito sintético, mas revela a ideia. Em nosso aplicativo, usamos restrições adiadas para implementar a lógica que resolve conflitos quando usuários trabalham simultaneamente com objetos compartilhados (widgets) no painel. O uso dessas restrições nos permite tornar o código aplicativo um pouco mais simples.
No geral, dependendo do tipo de restrição no Postgres, existem três níveis de granularidade para verificação: nível de linha, transação e expressão.
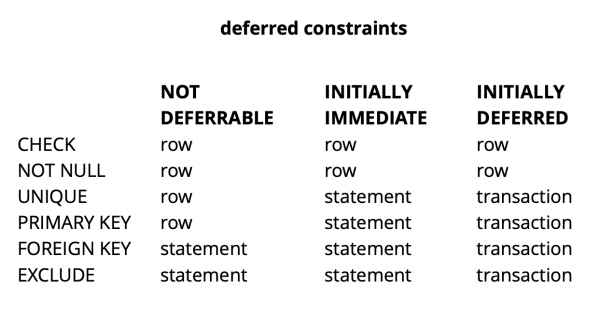
Fonte:
CHECK e NOT NULL são sempre verificadas no nível de linha; para outras restrições, como pode ser visto na tabela, existem diferentes opções. Você pode ler mais sobre isso. .
Em resumo, as restrições adiadas em várias situações proporcionam um código mais legível e um menor número de comandos. No entanto, isso vem à custa de um processo de depuração mais complicado, pois o momento em que ocorre um erro e o momento em que você toma conhecimento dele são separados no tempo. Outro problema possível está relacionado ao fato de que o planejador nem sempre consegue construir um plano otimizado se a consulta incluir uma restrição adiada.
Aprimoramento do pg_repack
Agora que entendemos o que são as restrições adiadas, como elas estão relacionadas ao nosso problema? Lembre-se do erro que recebemos anteriormente:
$ ./pg_repack -t tablename -o id
INFO: reorganizando tabela "tablename"
ERROR: a consulta falhou:
    ERROR: valor de chave duplicado viola a restrição única "index_16508"
DETALHES:  Chave (id, index)=(100500, 42) já existe.
Ele ocorre no momento da cópia dos dados da tabela de log para a nova tabela. Isso parece estranho, pois os dados na tabela de log são confirmados juntamente com os dados da tabela original. Se eles atendem às restrições da tabela original, como podem violar as mesmas restrições na nova?
A raiz do problema está no passo anterior do trabalho do pg_repack, onde apenas os índices são criados, mas não as restrições: na tabela antiga havia uma restrição única, enquanto na nova foi criado um índice único em seu lugar.
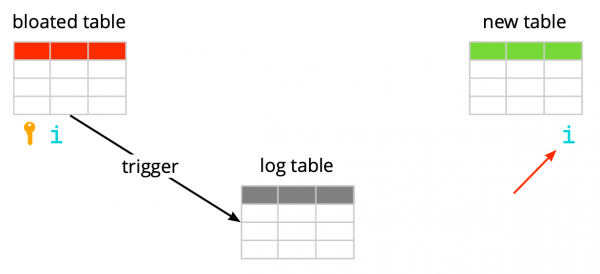
É importante notar que se a restrição for comum e não adiada, o índice único criado em seu lugar é equivalente a essa restrição, pois as restrições únicas no Postgres são implementadas por meio da criação de um índice único. Mas no caso de uma restrição adiada, o comportamento não é o mesmo, pois o índice não pode ser adiado e sempre é verificado no momento da execução do comando SQL.
Assim, a essência do problema reside na "adiamento" da verificação: na tabela original, ela ocorre no momento do commit, enquanto na nova – no momento da execução do comando SQL. Portanto, precisamos garantir que as verificações sejam realizadas de maneira idêntica em ambos os casos: ou sempre adiadas, ou sempre imediatamente.
Então, quais ideias tivemos.
Criar um índice, semelhante ao deferred
A primeira ideia é realizar ambas as verificações em modo imediato. Isso pode gerar alguns falsos positivos nas ativações do limite, mas se forem poucos, isso não deve impactar o trabalho dos usuários, uma vez que tais conflitos são situações normais para eles. Isso ocorre, por exemplo, quando dois usuários começam a editar o mesmo widget ao mesmo tempo, e o cliente do segundo usuário não tem tempo de receber a informação de que o widget já foi bloqueado para edição pelo primeiro usuário. Nessa situação, o servidor responde ao segundo usuário com uma rejeição, e seu cliente reverte as mudanças e bloqueia o widget. Um pouco mais tarde, quando o primeiro usuário termina a edição, o segundo receberá a informação de que o widget não está mais bloqueado, e poderá repetir sua ação.
Para garantir que as verificações sejam sempre em modo urgente, criamos um novo índice, semelhante ao limite original adiado:
CREATE UNIQUE INDEX CONCURRENTLY uk_tablename__immediate ON tablename (id, index);
-- execute pg_repack
DROP INDEX CONCURRENTLY uk_tablename__immediate;
No ambiente de teste, obtivemos apenas alguns erros esperados. Sucesso! Reiniciamos o pg_repack em produção e obtivemos 5 erros no primeiro cluster em uma hora de operação. Este é um resultado aceitável. No entanto, já no segundo cluster, o número de erros aumentou consideravelmente e tivemos que parar o pg_repack.
Por que isso aconteceu? A probabilidade de erro depende de quantos usuários estão trabalhando simultaneamente com os mesmos widgets. Aparentemente, naquele momento, havia muito menos mudanças concorrentes nos dados armazenados no primeiro cluster do que nos outros, ou seja, simplesmente 'tivemos sorte'.
A ideia não funcionou. Naquele momento, consideramos duas outras opções de solução: reescrever nosso código aplicativo para eliminar os limites adiados, ou 'ensinar' o pg_repack a trabalhar com eles. Optamos pela segunda.
Substituir os índices na nova tabela por limites adiados da tabela original.
O objetivo da modificação era claro – se a tabela original tiver um limite adiado, então para a nova deverá ser criado tal limite, e não um índice.
Para verificar nossas mudanças, escrevemos um teste simples:
- tabela com limite adiado e uma entrada;
- inserimos em um loop dados que entram em conflito com a entrada existente;
- fazemos o update – os dados já não conflitam;
- commite as alterações.
create table test_table
(
  id serial,
  val int,
  constraint uk_test_table__val unique (val) deferrable initially deferred
);
INSERT INTO test_table (val) VALUES (0);
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (0) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    COMMIT;
  END;
END LOOP;
A versão original do pg_repack sempre falhava na primeira inserção, a versão revisada funcionou sem erros. Ótimo.
Estamos indo para produção e novamente recebemos um erro na mesma fase de cópia de dados da tabela de log para a nova:
$ ./pg_repack -t tablename -o id
INFO: reorganizando tabela "tablename"
ERROR: a consulta falhou:
    ERROR: valor de chave duplicado viola a restrição única "index_16508"
DETALHES:  Chave (id, index)=(100500, 42) já existe.
Situação clássica: em ambientes de teste tudo funciona, mas na produção – não?!
APPLY_COUNT e a junção de dois lotes
Começamos a analisar o código literalmente linha por linha e descobrimos um ponto importante: a transferência de dados da tabela de log para a nova acontece em lotes, a constante APPLY_COUNT indicava o tamanho do lote:
for (;;)
{
num = apply_log(connection, table, APPLY_COUNT);

if (num > MIN_TUPLES_BEFORE_SWITCH)
     continue;
/* pode haver ainda algumas tuplas, repetir. */
...
}
O problema é que os dados da transação original, na qual várias operações podem potencialmente violar a restrição, durante a transferência podem cair na junção de dois lotes – metade dos comandos será comitada no primeiro lote, e a outra metade – no segundo. E aqui depende da sorte: se os comandos no primeiro lote não violam nada, tudo bem, mas se violam – ocorre um erro.
APPLY_COUNT é igual a 1000 registros, o que explica por que nossos testes passaram com sucesso – eles não cobriam o caso da "junção de lotes". Usamos dois comandos – insert e update, portanto exatamente 500 transações com dois comandos sempre cabiam no lote e não enfrentamos problemas. Após a adição de um segundo update, nossa correção parou de funcionar:
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (1) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    UPDATE test_table set val = i where id = v_id; -- mais um update
    COMMIT;
  END;
END LOOP;
Então, a próxima tarefa é fazer com que os dados da tabela original, que foram alterados em uma transação, sejam inseridos na nova tabela também dentro de uma única transação.
Abandono do batching
E e nós novamente tínhamos duas opções de solução. A primeira: vamos desistir completamente da divisão em lotes e transferir os dados em uma única transação. A favor dessa solução estava sua simplicidade – as mudanças de código necessárias eram mínimas (por sinal, em versões mais antigas, o pg_reorg funcionava exatamente assim). Mas há um problema – criamos uma transação longa, e isso, como foi mencionado anteriormente, representa uma ameaça ao surgimento de novos bloats.
A segunda solução — mais complexa, mas, provavelmente, mais correta: criar na tabela de log uma coluna com o identificador da transação que adicionou os dados à tabela. Assim, ao copiar os dados, poderemos agrupá-los por esse atributo e garantir que as alterações relacionadas sejam transferidas em conjunto. O lote será formado por várias transações (ou uma grande) e seu tamanho variará dependendo de quantos dados foram alterados nessas transações. É importante notar que, uma vez que os dados de diferentes transações são inseridos na tabela de log em uma ordem aleatória, não será mais possível lê-la sequencialmente, como antes. O seqscan em cada consulta com filtragem por tx_id é muito caro, precisamos de um índice, mas isso também atrasará o método devido ao overhead de sua atualização. Em geral, como sempre, é preciso sacrificar alguma coisa.
Então, decidimos começar pela primeira opção, por ser mais simples. Primeiro, era necessário entender se a transação longa seria um verdadeiro problema. Como a principal transferência de dados da tabela antiga para a nova também ocorre em uma única transação longa, a questão se transformou em "quanto iremos aumentar essa transação?" A duração da primeira transação depende principalmente do tamanho da tabela. A duração da nova – de quantas mudanças se acumulam na tabela durante o fluxo de dados, ou seja, da intensidade da carga. A execução do pg_repack ocorreu durante a mínima carga do serviço, e o volume de alterações foi insignificavelmente pequeno em comparação com o volume original da tabela. Decidimos que poderíamos ignorar o tempo da nova transação (para comparação, em média, isso leva 1 hora e 2-3 minutos).
Os experimentos foram positivos. A implementação em produção também. Para ilustrar – uma imagem com o tamanho de um dos bancos de dados após a execução:
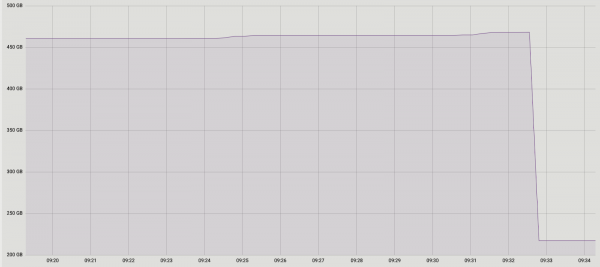
Como esta solução nos satisfez completamente, decidimos não tentar implementar a segunda, mas estamos considerando a possibilidade de discutir isso com os desenvolvedores da extensão. Infelizmente, nossa atualização atual ainda não está pronta para publicação, pois resolvemos o problema apenas com restrições adiadas únicas, e para um patch completo é necessário adicionar suporte a outros tipos. Esperamos conseguir fazer isso no futuro.
Você pode estar se perguntando por que nos envolvemos nessa história de aprimoramento do pg_repack e não decidimos usar suas alternativas, por exemplo? Em algum momento, também pensamos nisso, mas a experiência positiva anterior com seu uso em tabelas sem restrições adiadas nos motivou a tentar entender a essência do problema e corrigi-lo. Além disso, o uso de outras soluções também requer tempo para testes, então decidimos primeiro tentar resolver o problema nele, e se percebermos que não conseguiremos fazer isso em um tempo razoável, começaremos a considerar alternativas.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
O que podemos recomendar com base em nossa própria experiência:
- Monitore seu bloat. Com base nos dados de monitoramento, você poderá entender o quão bem configurado está o autovacuum.
- Configure o AUTOVACUUM para manter o bloat dentro de um nível aceitável.
- Se o bloat continuar crescendo e você não puder combatê-lo com ferramentas “prontas para uso”, não hesite em usar extensões externas. O principal é testá-las adequadamente.
- Não tenha medo de adaptar soluções externas para suas necessidades – às vezes, isso pode ser mais eficaz e até mais fácil do que modificar seu próprio código.
Fonte: habr.com
