

Nota do tradutor.: este material do projeto educacional — é a resposta para uma pergunta popular ao projetar infraestrutura baseada em Kubernetes. Esperamos que as descrições detalhadas dos prós e contras de cada uma das opções ajudem a tomar a melhor decisão para seu projeto.
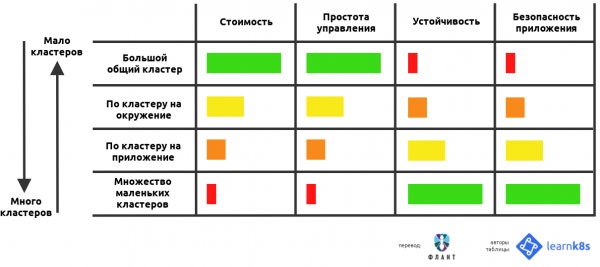
TL;DR: o mesmo conjunto de cargas de trabalho pode ser executado em vários grandes clusters (cada cluster terá um grande número de workloads) ou em muitos pequenos (com poucas cargas em cada cluster).
Abaixo está uma tabela avaliando os prós e contras de cada abordagem:
Ao utilizar Kubernetes como plataforma para operação de aplicativos, várias questões fundamentais sobre as nuances da configuração de clusters frequentemente surgem:
- Quantos clusters usar?
- Qual deve ser o tamanho deles?
- O que cada cluster deve incluir?
Neste artigo, tentarei responder a todas essas perguntas, analisando os prós e contras de cada abordagem.
Enunciado do Problema
Como criador de software, é provável que você desenvolva e opere simultaneamente vários aplicativos.
Além disso, muitos instâncias desses aplicativos provavelmente são executadas em diferentes ambientes — por exemplo, podem ser dev, test e prod.
Como resultado, cria-se uma verdadeira matriz de aplicativos e ambientes:
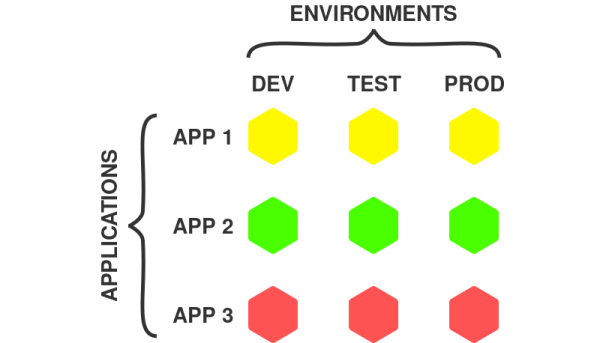
Aplicativos e Ambientes
No exemplo acima, estão apresentados 3 aplicativos e 3 ambientes, totalizando 9 combinações possíveis.
Cada instância de aplicativo representa uma unidade de deployment autossuficiente, com a qual se pode trabalhar de forma independente.
Observe que instância de aplicativo pode consistir em múltiplos componentes, como frontend, backend, banco de dados etc. No caso de um aplicativo de microserviços, a instância incluirá todos os microserviços.
Como resultado, os usuários do Kubernetes têm algumas perguntas:
- Devo hospedar todas as instâncias de aplicativo em um único cluster?
- Devo criar um cluster separado para cada instância de aplicativo?
- Ou talvez deva utilizar uma combinação das abordagens mencionadas?
Todas essas opções são viáveis, pois o Kubernetes é um sistema flexível que não limita as possibilidades do usuário.
Aqui estão alguns dos caminhos possíveis:
- um grande cluster compartilhado;
- múltiplos clusters pequenos e especializados;
- um cluster para cada aplicativo;
- um cluster para cada ambiente.
Como mostrado abaixo, as duas primeiras abordagens estão em extremidades opostas da escala de opções:
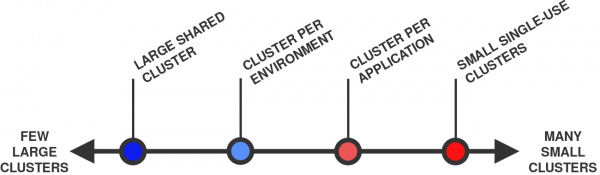
De vários clusters grandes (à esquerda) a muitos pequenos (à direita)
De maneira geral, considera-se que um cluster é "maior" que o outro se tiver mais nós e pods no total. Por exemplo, um cluster com 10 nós e 100 pods é maior que um cluster com 1 nó e 10 pods.
Bem, vamos começar!
1. Um grande cluster compartilhado
A primeira opção é alocar todas as cargas de trabalho em um único cluster:
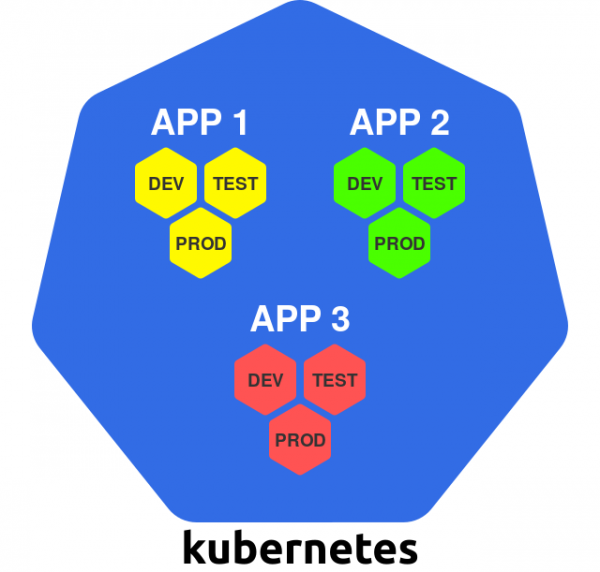
Um grande cluster
Dentro dessa abordagem, o cluster é utilizado como uma plataforma de infraestrutura — tudo o que você precisa é simplesmente implantado no cluster Kubernetes existente. Namespaces
Vamos analisar os prós e contras dessa abordagem.
+ Uso eficiente de recursos
No caso de um único cluster, apenas uma cópia de todos os recursos necessários para iniciar e gerenciar o cluster Kubernetes será necessária.
Por exemplo, isso é válido para os nós mestres. Normalmente, há 3 nós mestres para cada cluster Kubernetes, então para um único cluster esse número permanecerá o mesmo (para comparação, 10 clusters precisarão de 30 nós mestres).
Essa sutileza acima se aplica a outros serviços que funcionam em todo o cluster, como balanceadores de carga, controladores Ingress, sistemas de autenticação, registro e monitoramento.
Em um único cluster, todos esses serviços podem ser usados simultaneamente para todas as cargas de trabalho (não é necessário criar suas cópias, como acontece em vários clusters).
+ Barateza
Como consequência do que foi exposto, um número menor de clusters geralmente é mais barato, pois não há despesas com recursos redundantes.
Isso é especialmente verdadeiro para nós mestres, que podem custar bastante independetemente da forma de implantação (on-premises ou na nuvem).
Alguns serviços Kubernetes gerenciados, como
Google Kubernetes Engine (GKE) ou , fornece uma camada de gerenciamento gratuitamente. Neste caso, a questão de custos é menos problemática.
Também existem serviços gerenciados que cobram uma taxa fixa pelo funcionamento de cada cluster Kubernetes (por exemplo, ).
+ Administração eficiente
Gerenciar um cluster é mais fácil do que gerenciar vários.
A administração pode incluir as seguintes tarefas:
- atualização da versão do Kubernetes;
- configuração do pipeline CI/CD;
- instalação do plugin CNI;
- configuração do sistema de autenticação de usuários;
- instalação do controlador de acesso;
e muitos outros…
No caso de um único cluster, tudo isso precisa ser feito apenas uma vez.
Para múltiplos clusters, as operações precisam ser repetidas várias vezes, o que provavelmente exigirá alguma automação de processos e ferramentas para garantir sistematicidade e uniformidade no processo.
Agora, algumas palavras sobre as desvantagens.
− Ponto único de falha
No caso de falha do único cluster, as tudo cargas de trabalho param de funcionar imediatamente!
Existem inúmeras situações em que algo pode dar errado:
- a atualização do Kubernetes pode resultar em efeitos colaterais inesperados;
- um componente do cluster (por exemplo, o plugin CNI) começa a funcionar de forma diferente do esperado;
- um dos componentes do cluster está configurado incorretamente;
- falha na infraestrutura subjacente.
Um único incidente pode causar danos significativos a todas as cargas de trabalho hospedadas no cluster compartilhado.
− Falta de isolamento rigoroso
Trabalhar em um cluster compartilhado significa que os aplicativos compartilham recursos de hardware, capacidades de rede e o sistema operacional nos nós do cluster.
De certa forma, dois contêineres com dois aplicativos diferentes, executando no mesmo nó, são semelhantes a dois processos funcionando na mesma máquina sob o mesmo núcleo do SO.
Os contêineres Linux fornecem uma forma de isolamento, mas não é tão forte quanto a que é fornecida, por exemplo, por máquinas virtuais. Em essência, o processo em um contêiner é o mesmo processo executado no sistema operacional do host.
Isso pode se tornar um problema do ponto de vista da segurança: tal organização teoricamente permite que aplicativos não relacionados interajam entre si (intencionalmente ou acidentalmente).
Além disso, todas as cargas de trabalho no cluster Kubernetes compartilham alguns serviços comuns de cluster, como — isso permite que os aplicativos encontrem os serviços de outros aplicativos no cluster.
Todos os pontos mencionados acima podem ter significados diferentes dependendo dos requisitos de segurança dos aplicativos.
O Kubernetes fornece várias ferramentas para evitar problemas de segurança, como e . No entanto, para configurá-las corretamente, é necessário certa experiência, além disso, elas não conseguem fechar todas as brechas de segurança.
É importante sempre lembrar que o Kubernetes foi projetado originalmente para uso compartilhado, e não para isolamento e segurança.
− Ausência de multi-tenancy rígido
Dada a abundância de recursos compartilhados no cluster Kubernetes, existem várias maneiras de como diferentes aplicativos podem 'pisar no calo' uns dos outros.
Por exemplo, um aplicativo pode monopolizar um recurso compartilhado (como CPU ou memória) e privar outros aplicativos que estão rodando no mesmo nó de acesso a ele.
O Kubernetes oferece vários mecanismos de controle para esse comportamento, como (veja também o artigo “' - nota do tradutor.), e . No entanto, assim como acontece com a segurança, sua configuração é bastante complexa e não consegue prevenir todos os efeitos colaterais imprevistos.
− Grande número de usuários
No caso de um único cluster, é preciso abrir o acesso a muitas pessoas. E quanto maior o número delas, maior é o risco de que algo seja 'quebrado'.
Dentro do cluster, é possível controlar quem e o que pode fazer por meio de (veja o artigo “' - nota do tradutor.). Contudo, isso não impedirá que os usuários 'quebrem' algo dentro de sua zona de responsabilidade.
− Os clusters não podem crescer infinitamente
Um cluster que é usado para todas as cargas de trabalho provavelmente será bastante grande (em número de nós e pods).
Mas aqui surge outro problema: clusters no Kubernetes não podem crescer infinitamente.
Há um limite teórico para o tamanho do cluster. No Kubernetes, esse limite é de aproximadamente .
No entanto, na vida real, os problemas podem começar muito antes — por exemplo, com apenas .
O fato é que grandes clusters impõem uma alta carga na camada de controle do Kubernetes. Em outras palavras, para manter o cluster em funcionamento e usar os recursos de forma eficiente, é necessária uma configuração cuidadosa.
Esse problema é abordado no artigo correspondente no blog original intitulado «».
Mas vamos considerar a abordagem oposta: muitos clusters pequenos.
2. Muitos clusters pequenos e especializados
Com essa abordagem, você utiliza um cluster separado para cada elemento a ser implantado:
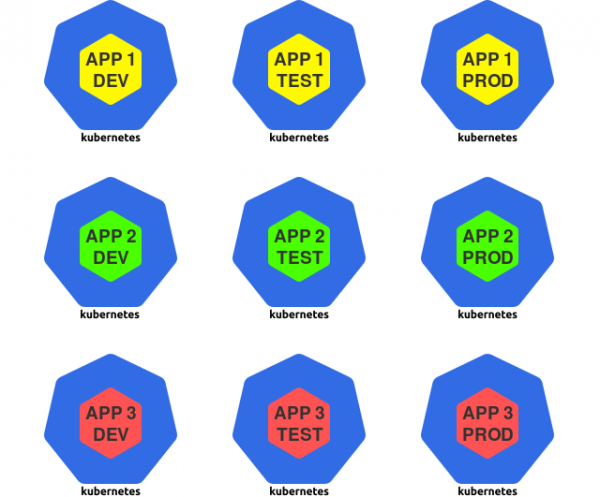
Muitos clusters pequenos
Para os propósitos deste artigo, um elemento a ser implantado refere-se a uma instância de aplicativo — por exemplo, a versão dev de um aplicativo específico.
Nesta estratégia, o Kubernetes é utilizado como um ambiente de execução para instâncias individuais de aplicativo.
+ Uso eficiente de recursos
+ Raio de explosão limitado
Quando um cluster falha, as consequências negativas são limitadas apenas às cargas de trabalho que estavam implantadas nesse cluster. Todas as outras workloads permanecem intactas.
+ Isolamento
As cargas de trabalho alocadas em clusters individuais não compartilham recursos, como CPU, memória, sistema operacional, rede ou outros serviços.
Como resultado, obtemos um isolamento rigoroso entre aplicativos não relacionados, o que pode beneficiar sua segurança.
+ Poucos usuários
Considerando que cada cluster contém apenas um conjunto limitado de cargas de trabalho, o número de usuários com acesso é reduzido.
Quanto menos pessoas tiverem acesso ao cluster, menor o risco de algo "quebrar".
Vamos olhar para as desvantagens.
− Uso ineficiente de recursos
Como mencionado anteriormente, cada cluster Kubernetes requer um determinado conjunto de recursos de gerenciamento: nós mestres, componentes da camada de controle, soluções de monitoramento e registros.
Com um grande número de clusters pequenos, é necessário alocar uma parcela maior de recursos para gerenciamento.
− Custo elevado
O uso ineficiente de recursos automaticamente leva a custos elevados.
Por exemplo, ter 30 nós mestre em vez de três com a mesma capacidade de computação certamente impactará os custos.
− Dificuldades de administração
Administrar muitos clusters Kubernetes é muito mais complexo do que trabalhar com um único.
Por exemplo, será necessário configurar autenticação e autorização para cada cluster. A atualização da versão do Kubernetes também terá que ser realizada várias vezes.
Provavelmente, será necessário aplicar automação para aumentar a eficiência de todas essas tarefas.
Agora, vamos considerar cenários menos extremos.
3. Um cluster para cada aplicativo
Nesse approach, você cria um cluster separado para todas as instâncias de um aplicativo específico:
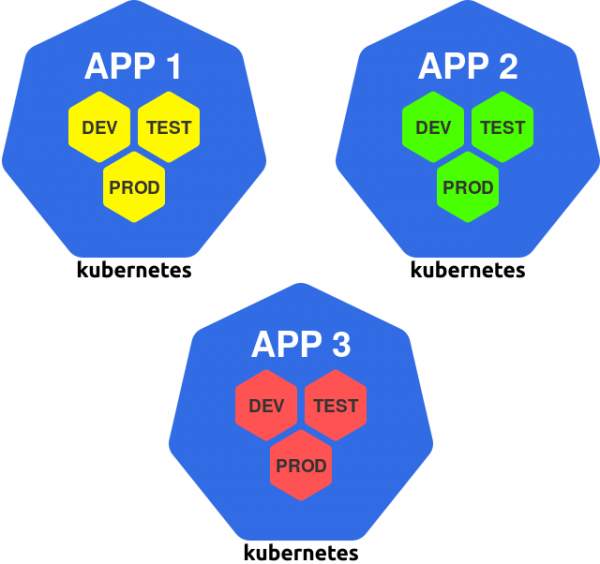
Cluster por aplicativo
Esse caminho pode ser considerado uma generalização do princípio "um cluster separado por equipe", uma vez que normalmente uma equipe de engenheiros se ocupa do desenvolvimento de um ou mais aplicativos.
+ Uso eficiente de recursos
+ O cluster pode ser ajustado para o aplicativo
Se o aplicativo tiver necessidades especiais, elas podem ser implementadas no cluster sem afetar outros clusters.
Essas necessidades podem incluir workers com GPU, determinados plugins CNI, service mesh ou algum outro serviço.
Cada cluster pode ser ajustado para o aplicativo que está nele operando, de modo que contenha apenas o que é necessário.
− Diferentes ambientes em um único cluster
A desvantagem desse approach é que as instâncias de aplicativos de diferentes ambientes coexistem em um único cluster.
Por exemplo, a versão em produção do aplicativo roda no mesmo cluster que a versão de desenvolvimento. Isso também significa que os desenvolvedores operam no mesmo cluster em que a versão de produção do aplicativo está em operação.
Se, devido às ações dos desenvolvedores ou falhas da versão de desenvolvimento, houver uma falha no cluster, a versão de produção pode sofrer, o que é uma grande desvantagem desse approach.
E, finalmente, o último cenário na nossa lista.
4. Um cluster para cada ambiente
Esse cenário prevê a alocação de um cluster separado para cada ambiente:
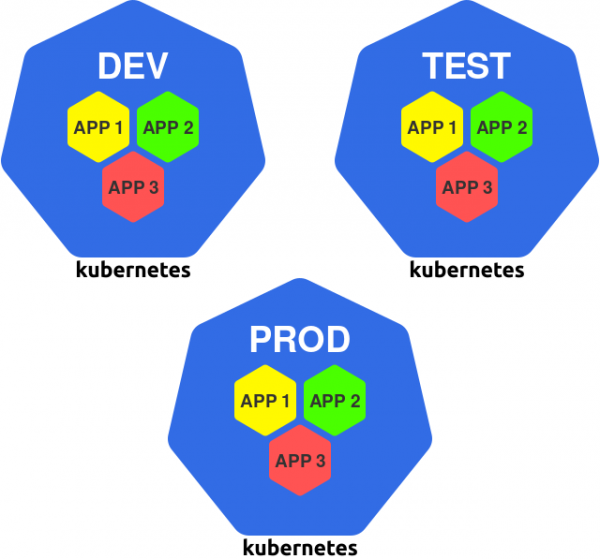
Um cluster para cada ambiente
Por exemplo, você pode ter clusters dev, test e prod, nos quais você executará todas as instâncias do aplicativo destinadas a um ambiente específico.
Aqui estão os prós e contras desse approach.
+ Isolamento do ambiente de produção
Neste enfoque, todos os ambientes são isolados uns dos outros. No entanto, na prática, isso é especialmente importante para o ambiente de produção.
As versões de produção do aplicativo agora não dependem do que acontece em outros clusters e ambientes.
Assim, se ocorrer um problema inesperado no cluster de desenvolvimento, as versões em produção dos aplicativos continuarão a funcionar como se nada tivesse acontecido.
+ O cluster pode ser ajustado para o ambiente
Cada cluster pode ser ajustado para o seu ambiente. Por exemplo, é possível:
- instalar ferramentas de desenvolvimento e depuração no cluster de desenvolvimento;
- instalar frameworks e ferramentas de teste no cluster; test;
- usar hardware mais potente e canais de rede no cluster; prod.
Isso permite aumentar a eficiência tanto do desenvolvimento quanto da operação dos aplicativos.
+ Limitação de acesso ao cluster de produção
A necessidade de trabalhar diretamente com o cluster de produção não surge com frequência, portanto, é possível restringir significativamente o número de pessoas que têm acesso a ele.
É possível ir ainda mais longe e eliminar completamente o acesso humano a esse cluster, realizando todos os deploys por meio de uma ferramenta de CI/CD automatizada. Essa abordagem reduzirá ao máximo o risco de erros humanos exatamente onde isso é mais crítico.
Agora, algumas palavras sobre as desvantagens.
− Falta de isolamento entre aplicativos
A principal desvantagem do abordagem é a falta de isolamento de hardware e recursos entre os aplicativos.
Aplicativos desconectados compartilham recursos do cluster: núcleo do sistema, processador, memória e alguns outros serviços.
Como já mencionado, isso pode ser potencialmente perigoso.
− Impossibilidade de localizar as dependências dos aplicativos
Se um aplicativo tiver requisitos especiais, é necessário atendê-los em todos os clusters.
Por exemplo, se um aplicativo precisar de GPU, então cada cluster deve conter pelo menos um worker com GPU (mesmo que seja usado apenas por esse aplicativo).
Como resultado, corremos o risco de ter custos mais altos e uso ineficaz dos recursos.
Conclusão
Com um conjunto específico de aplicativos, eles podem ser implantados em vários grandes clusters ou em muitos pequenos.
O artigo discute os prós e contras de diferentes abordagens, começando por um único cluster global e terminando com vários clusters pequenos e especializados:
- um grande cluster comum;
- múltiplos clusters pequenos e especializados;
- um cluster para cada aplicativo;
- um cluster para cada ambiente.
Então, qual abordagem escolher?
Como de costume, a resposta depende do cenário de uso: é necessário pesar os prós e contras de diferentes abordagens e escolher a opção mais otimizada.
No entanto, a escolha não se limita aos exemplos acima — pode-se usar qualquer combinação deles!
Por exemplo, pode-se organizar um par de clusters para cada equipe: um cluster para desenvolvimento (onde estarão os ambientes dev e test) e um cluster para production (onde estará o ambiente de produção).
Com base nas informações deste artigo, você poderá otimizar adequadamente os prós e contras para um cenário específico. Boa sorte!
P.S.
Confira também em nosso blog:
- «»;
- «»;
- «»;
- «».
Fonte: habr.com
