

Com a escassez de endereços IPv4, muitos provedores de telecomunicações se viram na necessidade de organizar o acesso de seus clientes à rede por meio de tradução de endereços. Neste artigo, vou explicar como obter um desempenho de nível Carrier Grade NAT em servidores comuns.
Um pouco de história
A questão da escassez do espaço de endereços IPv4 já não é nova. Em algum momento, surgiram filas de espera na RIPE, depois surgiram mercados onde blocos de endereços eram negociados e contratos de aluguel eram firmados. Gradualmente, os provedores de telecomunicações começaram a oferecer serviços de acesso à Internet por meio de tradução de endereços e portas. Alguns não conseguiram obter endereços suficientes para atribuir um endereço 'público' a cada assinante, enquanto outros começaram a economizar, desistindo da compra de endereços no mercado secundário. Os fabricantes de equipamentos de rede apoiaram essa ideia, pois essa funcionalidade geralmente requer módulos de expansão ou licenças adicionais. Por exemplo, a Juniper, em sua linha de roteadores MX (exceto os mais recentes MX104 e MX204), pode executar NAPT em um cartão de serviço MS-MIC separado, no Cisco ASR1k é necessária uma licença CGN, e no Cisco ASR9k — um módulo A9K-ISM-100 separado com a licença A9K-CGN-LIC correspondente. Em resumo, o prazer custa caro.
IPTables
A tarefa de realizar NAT não requer recursos computacionais especializados, podendo ser realizada por processadores de uso geral, como os que estão instalados, por exemplo, em qualquer roteador doméstico. Em escala de provedores de telecomunicações, essa tarefa pode ser resolvida utilizando servidores comuns rodando FreeBSD (ipfw/pf) ou GNU/Linux (iptables). Não vamos considerar o FreeBSD, pois há bastante tempo desisti de usar esse SO, por isso vamos nos concentrar no GNU/Linux.
Ativar a tradução de endereços não é difícil. Para começar, é necessário adicionar uma regra ao iptables na tabela nat:
iptables -t nat -A POSTROUTING -s 100.64.0.0/10 -j SNAT --to - --persistent
O sistema operacional irá carregar o módulo nf_conntrack, que monitorará todas as conexões ativas e realizará as transformações necessárias. Aqui existem algumas nuances. Primeiro, como se trata de NAT em uma escala de operadora, é necessário ajustar os timeouts, pois, com os valores padrão, o tamanho da tabela de traduções rapidamente crescerá até números catastróficos. Abaixo está um exemplo de configurações que usei em meus servidores:
net.ipv4.ip_forward = 1
net.ipv4.ip_local_port_range = 8192 65535

net.netfilter.nf_conntrack_generic_timeout = 300
net.netfilter.nf_conntrack_tcp_timeout_syn_sent = 60
net.netfilter.nf_conntrack_tcp_timeout_syn_recv = 60
net.netfilter.nf_conntrack_tcp_timeout_established = 600
net.netfilter.nf_conntrack_tcp_timeout_fin_wait = 60
net.netfilter.nf_conntrack_tcp_timeout_close_wait = 45
net.netfilter.nf_conntrack_tcp_timeout_last_ack = 30
net.netfilter.nf_conntrack_tcp_timeout_time_wait = 120
net.netfilter.nf_conntrack_tcp_timeout_close = 10
net.netfilter.nf_conntrack_tcp_timeout_max_retrans = 300
net.netfilter.nf_conntrack_tcp_timeout_unacknowledged = 300
net.netfilter.nf_conntrack_udp_timeout = 30
net.netfilter.nf_conntrack_udp_timeout_stream = 60
net.netfilter.nf_conntrack_icmpv6_timeout = 30
net.netfilter.nf_conntrack_icmp_timeout = 30
net.netfilter.nf_conntrack_events_retry_timeout = 15
net.netfilter.nf_conntrack_checksum=0
E em segundo lugar, uma vez que o tamanho da tabela de traduções por padrão não é projetado para operação em um ambiente de operadora, ele precisa ser aumentado:
net.netfilter.nf_conntrack_max = 3145728
Também é necessário aumentar o número de buckets para a tabela de hash que armazena todas as traduções (esta é uma opção do módulo nf_conntrack):
options nf_conntrack hashsize=1572864
Após essas simples manobras, obtemos uma estrutura funcionando completamente capaz de traduzir um grande número de endereços de clientes para um pool externo. No entanto, o desempenho desta solução deixa a desejar. Em minhas primeiras tentativas de usar GNU/Linux para NAT (cerca de 2013), consegui obter um desempenho de cerca de 7 Gbit/s a 0,8 Mpps em um único servidor (Xeon E5-1650v2). Desde então, muitas otimizações foram feitas no stack de rede do kernel GNU/Linux; o desempenho de um servidor com o mesmo hardware cresceu praticamente para 18-19 Gbit/s a 1,8-1,9 Mpps (valores máximos), mas a demanda por volume de tráfego processado por um único servidor cresceu muito mais rapidamente. Como resultado, esquemas de balanceamento de carga para diferentes servidores foram desenvolvidos, mas tudo isso aumentou a complexidade da configuração, manutenção e qualidade dos serviços prestados.
NFTables
Atualmente, uma tendência popular no "empilhamento de pacotes" é o uso de DPDK e XDP. Muitos artigos foram escritos sobre o tema, diversas apresentações foram feitas e produtos comerciais estão surgindo (como SKAT da VasExperts). No entanto, devido à escassez de programadores nas operadoras de telecomunicações, desenvolver uma solução própria baseada nesses frameworks é bastante problemático. A utilização subsequente de tal solução será muito mais complexa, pois será necessário desenvolver ferramentas de diagnóstico. Por exemplo, o tcpdump padrão não funcionará com DPDK, e os pacotes enviados de volta pelos cabos usando XDP não serão "vistos" por ele. Entre todas as discussões sobre novas tecnologias de encaminhamento de pacotes para o espaço do usuário, ficaram sem atenção. e Pablo Neira Ayuso, mantenedor do iptables, sobre o desenvolvimento do flow offloading no nftables. Vamos examinar esse mecanismo mais detalhadamente.
A ideia principal é que, se um roteador passou pacotes de uma sessão em ambas as direções do fluxo (a sessão TCP passou para o estado ESTABLISHED), não há necessidade de passar os pacotes subsequentes dessa sessão por todas as regras do firewall, pois todas essas verificações acabarão resultando na transmissão do pacote para o roteamento. E também não é necessário escolher a rota — já sabemos para qual interface e qual host devemos encaminhar os pacotes dentro dessa sessão. Apenas é necessário salvar essas informações e utilizá-las para o roteamento na fase inicial de processamento do pacote. Ao realizar NAT, é necessário também preservar informações sobre as mudanças de endereços e portas, que foram transformadas pelo módulo nf_conntrack. Sim, claro, nesse caso diversas políticas e outras regras informativas-estatísticas no iptables deixam de funcionar, mas para a tarefa de um NAT isolado ou, por exemplo, na borda, isso não é tão importante, pois os serviços estão distribuídos entre os dispositivos.
Configuração
Para aproveitar essa funcionalidade, precisamos:
- Usar um núcleo recente. Apesar de o recurso ter surgido no núcleo 4.16, ele permaneceu muito "imaturado" por um bom tempo e frequentemente causava kernel panic. A estabilização ocorreu por volta de dezembro de 2019, quando os núcleos LTS 4.19.90 e 5.4.5 foram lançados.
- Reescrever as regras do iptables no formato do nftables, usando uma versão relativamente recente do nftables. Funciona corretamente na versão 0.9.0.
Se o primeiro ponto está basicamente claro, o principal é não esquecer de incluir o módulo na configuração durante a compilação (CONFIG_NFT_FLOW_OFFLOAD=m), o segundo ponto requer algumas explicações. As regras do nftables são descritas de maneira completamente diferente das do iptables. cobre praticamente todos os aspectos, também existem conversores especiais A configuração do NAT é muito simples:
Com flow offload é um pouco mais complicado, mas ainda compreensível:
#! /usr/sbin/nft -f

table nat {
        chain postrouting {
                type nat hook postrouting priority 100;
                oif <o_if> snat to <pool_addr_start>-<pool_addr_end> persistent
        }
}
Aqui está toda a configuração. Agora todo o tráfego TCP/UDP irá para a tabela fastnat e será processado muito mais rapidamente.
#! /usr/sbin/nft -f

table inet filter {
        flowtable fastnat {
                hook ingress priority 0
                devices = { <i_if>, <o_if> }
        }

        chain forward {
                type filter hook forward priority 0; policy accept;
                ip protocol { tcp , udp } flow offload @fastnat;
        }
}
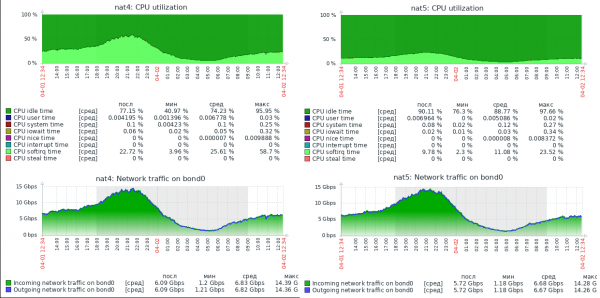
Para entender o quanto isso é "muito mais rápido", vou anexar uma captura de tela da carga em dois servidores reais, com a mesma configuração (Xeon E5-1650v2), configurados da mesma forma, utilizando o mesmo núcleo do Linux, mas realizando NAT no iptables (NAT4) e no nftables (NAT5).
Resultados
Na captura de tela não há gráfico de pacotes por segundo, mas no perfil de carga desses servidores, o tamanho médio do pacote está em torno de 800 bytes, portanto, os valores chegam a 1.5Mpps. Como pode ser visto, a margem de desempenho do servidor com nftables é enorme. Atualmente, esse servidor processa até 30Gbit/s com 3Mpps e claramente pode atingir o limite físico da rede de 40Gbps, mantendo recursos de CPU livres.
Espero que este material seja útil para engenheiros de redes que estão tentando melhorar o desempenho de seus servidores.
À medida que os endereços IPv4 se esgotam, muitos provedores de serviços estão enfrentando a necessidade de organizar o acesso de seus clientes à rede por meio da tradução de endereços.
Fonte: habr.com
