

Em sistemas ERP complexos muitas entidades possuem uma natureza hierárquica, onde objetos homogêneos se organizam em uma árvore de relações «pai — filho» — isso inclui tanto a estrutura organizacional da empresa (todas essas filiais, departamentos e grupos de trabalho), quanto o catálogo de produtos, áreas de trabalho, e a geografia dos pontos de venda,…
De fato, não existe uma única , onde ao menos alguma hierarquia não apareceria como resultado. Mas mesmo que você não trabalhe «para o negócio», ainda pode facilmente se deparar com relações hierárquicas. Basta pensar que até sua árvore genealógica ou o diagrama de andares de um shopping representam a mesma estrutura.
Existem muitas maneiras de armazenar essa árvore em um SGBD, mas hoje vamos nos concentrar apenas em uma opção:
CREATE TABLE hier(
  id
    integer
      PRIMARY KEY
, pid
    integer
      REFERENCES hier
, data
    json
);

CREATE INDEX ON hier(pid); -- não esqueça que FK não implica na criação automática de índice, ao contrário do PK
E enquanto você examina a profundidade da hierarquia, ela pacientemente espera, ansiosa para ver quão [in]eficazes serão seus modos «ingênuos» de trabalhar com essa estrutura.
Vamos discutir as tarefas comuns que surgem, sua implementação em SQL e tentar melhorar seu desempenho.
#1. Насколько глубока кроличья нора?
Vamos, para esclarecimento, assumir que essa estrutura refletirá a subordinação de departamentos na estrutura organizacional: departamentos, divisões, setores, filiais, grupos de trabalho,… — como quiser chamá-los.
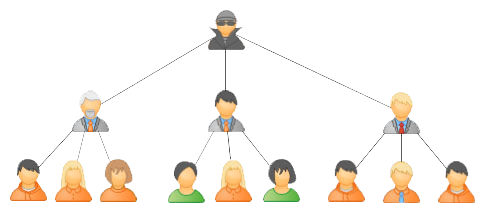
Primeiro, vamos gerar nossa 'árvore' com 10K elementos
INSERT INTO hier
WITH RECURSIVE T AS (
  SELECT
    1::integer id
  , '{1}'::integer[] pids
UNION ALL
  SELECT
    id + 1
  , pids[1:(random() * array_length(pids, 1))::integer] || (id + 1)
  FROM
    T
  WHERE
    id < 10000
)
SELECT
  pids[array_length(pids, 1)] id
, pids[array_length(pids, 1) - 1] pid
FROM
  T;
Começaremos pela tarefa mais simples — encontrar todos os funcionários que trabalham dentro de um setor específico, ou em termos hierárquicos — encontrar todos os descendentes de um nó. E também seria bom obter a «profundidade» do descendente... Tudo isso pode ser necessário, por exemplo, para construir uma .
Tudo bem, se houver apenas alguns níveis de descendentes e a quantidade for em torno de uma dezena, mas se houver mais de 5 níveis e os descendentes já forem dezenas — podem surgir problemas. Vamos ver como funcionam as opções tradicionais de pesquisa ‘para baixo na árvore’. Mas primeiro, vamos definir quais nós serão mais interessantes para nossas pesquisas.
Os mais ‘profundos’ subárvores:
WITH RECURSIVE T AS (
  SELECT
    id
  , pid
  , ARRAY[id] path
  FROM
    hier
  WHERE
    pid IS NULL
UNION ALL
  SELECT
    hier.id
  , hier.pid
  , T.path || hier.id
  FROM
    T
  JOIN
    hier
      ON hier.pid = T.id
)
TABLE T ORDER BY array_length(path, 1) DESC;
id | pid | path
---------------------------------------------
7624 | 7623 | {7615,7620,7621,7622,7623,7624}
4995 | 4994 | {4983,4985,4988,4993,4994,4995}
4991 | 4990 | {4983,4985,4988,4989,4990,4991}
...Os mais ‘ampla’ subárvores:
...
SELECT
  path[1] id
, count(*)
FROM
  T
GROUP BY
  1
ORDER BY
  2 DESC;
id | count
------------
5300 | 30
450 | 28
1239 | 27
1573 | 25
Para essas consultas, utilizamos um típico JOIN recursivo:
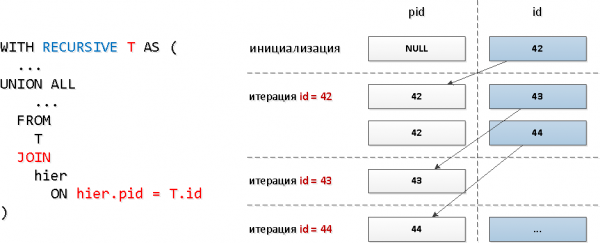
É claro que, com esse modelo de consulta, o número de iterações será igual ao total de descendentes (que são dezenas), e isso pode consumir recursos consideráveis e, como consequência, tempo.
Vamos testar na subárvore ‘mais ampla’:
WITH RECURSIVE T AS (
  SELECT
    id
  FROM
    hier
  WHERE
    id = 5300
UNION ALL
  SELECT
    hier.id
  FROM
    T
  JOIN
    hier
      ON hier.pid = T.id
)
TABLE T; 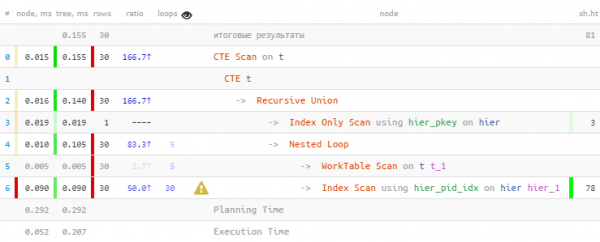
Como esperávamos, encontramos todos os 30 registros. Mas gastamos 60% do tempo total — porque fizemos também 30 pesquisas no índice. E é possível fazer menos?
Leitura em massa pelo índice
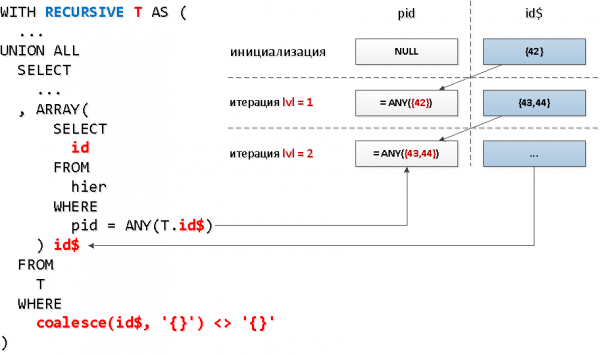
É necessário fazer uma consulta separada ao índice para cada nó? Aparentemente, não — podemos ler do índice de imediato por várias chaves em uma única chamada com = ANY(array).
E para cada um desses grupos de identificadores, podemos pegar todos os IDs encontrados na etapa anterior por ‘nós’. Ou seja, em cada etapa seguinte, estaremos buscando todos os descendentes de um determinado nível de uma só vez..
Apenas, o problema é que na seleção recursiva não podemos nos referir a nós mesmos em uma consulta aninhada, e precisamos filtrar apenas o que foi encontrado no nível anterior… Aparentemente, não é possível fazer uma consulta aninhada em toda a seleção — mas é possível em um campo específico dela. E esse campo pode ser um array — que é exatamente o que precisamos para usar ANY.
Isso parece um pouco estranho, mas na prática — tudo é simples.
COM CTE RECURSIVA T COMO (
  SELECIONE
    ARRAY[id] id$
  DE
    hier
  ONDE
    id = 5300
UNIÃO TODA
  SELECIONE
    ARRAY(
      SELECIONE
        id
      DE
        hier
      ONDE
        pid = QUALQUER(T.id$)
    ) id$
  DE
    T
  ONDE
    coalesce(id$, '{}')  '{}' -- condição de saída do loop - array vazio
)
SELECIONE
  unnest(id$) id
DE
T; 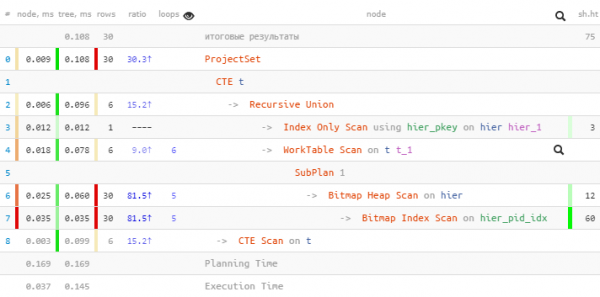
E aqui o mais importante nem mesmo é o ganho de 1,5 vezes em tempo, mas o fato de que subtraímos menos buffers, uma vez que as chamadas ao índice foram apenas 5 em vez de 30!
Um bônus adicional é o fato de que, após o último unnest, os identificadores permanecerão ordenados por "níveis."
Indicador de nó
A próxima consideração que ajudará a melhorar o desempenho é que "folhas" não podem ter filhos, ou seja, para elas não há necessidade de procurar "para baixo". Na formulação do nosso problema, isso significa que, se chegamos a um funcionário por meio de uma cadeia de departamentos, não há por que continuar a busca ao longo desse ramo.
Vamos introduzir em nossa tabela um adicional booleano-campo, que nos dirá imediatamente se este registro específico em nossa árvore é um "nó" — ou seja, se pode haver descendentes.
ALTER TABLE hier
  ADICIONAR COLUNA branch boolean;

ATUALIZAR
  hier T
SET
  branch = TRUE
ONDE
  EXISTE(
    SELECIONE
      NULO
    DE
      hier
    ONDE
      pid = T.id
    LIMIT 1
);
-- Consulta executada com sucesso: 3033 linhas alteradas em 42 ms.
Ótimo! Descobrimos que apenas pouco mais de 30% de todos os elementos da árvore têm descendentes.
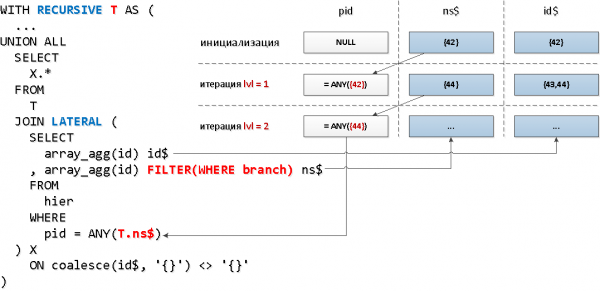
Agora aplicaremos uma mecânica ligeiramente diferente — conexões com a parte recursiva através LATERAL, o que nos permitirá acessar diretamente os campos da "tabela" recursiva, e usaremos a função agregada com condição de filtragem com base no símbolo do nó para reduzir o conjunto de chaves:
COM CTE RECURSIVA T COMO (
  SELECIONE
    array_agg(id) id$
  , array_agg(id) FILTRAR(ONDE branch) ns$
  DE
    hier
  ONDE
    id = 5300
UNIÃO TODA
  SELECIONE
    X.*
  DE
    T
  JUNTE LATERAL (
    SELECIONE
      array_agg(id) id$
    , array_agg(id) FILTRAR(ONDE branch) ns$
    DE
      hier
    ONDE
      pid = QUALQUER(T.ns$)
  ) X
    ON coalesce(T.ns$, '{}')  '{}'
)
SELECIONE
  unnest(id$) id
DE
T; 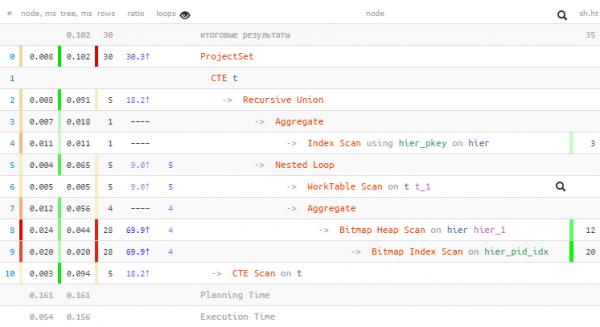
Conseguimos reduzir mais uma chamada ao índice e ganhamos mais de 2 vezes em volume extrair.
#2. Вернемся к корням
Este algoritmo será útil se você precisar coletar registros para todos os elementos "acima da árvore", mantendo ao mesmo tempo a informação de qual folha original (e quais métricas) provocou sua inclusão na seleção — por exemplo, para a elaboração de um relatório consolidado com agregação em nós.
O que vem a seguir deve ser visto exclusivamente como um proof-of-concept, pois a consulta se torna bastante complexa. Mas se ela domina sua base — vale a pena pensar em aplicar metodologias semelhantes.
Vamos começar com algumas afirmações simples:
- A mesma entrada da base é melhor lida apenas uma vez.
- Entradas da base são mais eficazes quando lidas em "lote", em vez de individualmente.
Agora vamos tentar construir a consulta que precisamos.
Passo 1
É evidente que, na inicialização da recursão (como não poderia ser diferente!), teremos que ler as entradas das folhas de acordo com o conjunto de identificadores de origem:
WITH RECURSIVE tree AS (
  SELECT
    rec -- esta é a entrada completa da tabela
  , id::text chld -- este é o "conjunto" que levou as folhas de origem a cá
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  ...
Se alguém achou estranho que o "conjunto" é armazenado como uma string e não como um array, há uma explicação simples para isso. Para strings, existe uma função de agregação incorporada chamada "string_agg" string_agg, e para arrays — não. Embora seja .
Passo 2
Agora queremos obter o conjunto de IDs das seções que precisaremos ler a seguir. Quase sempre eles estarão duplicados em diferentes entradas do conjunto de origem — portanto, precisamos agrupá-los, mantendo as informações sobre as folhas de origem.
Mas aqui nos aguardam três problemas desagradáveis:
- A parte "sub-recursiva" da consulta não pode conter funções agregadas com
GROUP BY. - Referências à "tabela" recursiva não podem estar em uma subconsulta aninhada.
- Consultas na parte recursiva não podem conter CTE.
Felizmente, todos esses problemas podem ser contornados com facilidade. Vamos começar pelo final.
CTE na parte recursiva
Funciona assim: não WITH RECURSIVE tree AS ( ... UNION ALL WITH T (...) SELECT ... )
E assim — funciona, os parênteses resolvem!WITH RECURSIVE tree AS ( ... UNION ALL ( WITH T (...) SELECT ... ) )
A consulta aninhada à "tabela" recursivaHmm… A referência à CTE recursiva não pode estar em uma subconsulta aninhada. Mas pode estar dentro da CTE! E a subconsulta pode referir-se a essa CTE!
GROUP BY dentro da recursão
Desagradável, mas… Temos uma maneira simples de simular o GROUP BY com
DISTINCT ON e funções de janela! SELECT (rec).pid id , string_agg(chld::text, ',') chld FROM tree WHERE (rec).pid IS NOT NULL GROUP BY 1 -- não funciona!
E assim — funciona!SELECT DISTINCT ON((rec).pid) (rec).pid id , string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld FROM tree WHERE (rec).pid IS NOT NULL
SELECT DISTINCT ON((rec).pid)
  (rec).pid id
, string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
FROM
  tree
WHERE
  (rec).pid IS NOT NULL
Agora vemos por que o ID numérico foi transformado em texto — para que eles possam ser concatenados com vírgula!
Passo 3
Para a finalização, nos resta apenas pouco:
- estamos revisando os registros das 'seções' por meio do conjunto de IDs agrupados
- comparamos as seções revisadas com os 'conjuntos' de folhas de origem
- desdobramos a string-conjunto usando
unnest(string_to_array(chld, ',')::integer[])
WITH RECURSIVE tree AS (
  SELECT
    rec
  , id::text chld
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  (
    WITH prnt AS (
      SELECT DISTINCT ON((rec).pid)
        (rec).pid id
      , string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
      FROM
        tree
      WHERE
        (rec).pid IS NOT NULL
    )
    , nodes AS (
      SELECT
        rec
      FROM
        hier rec
      WHERE
        id = ANY(ARRAY(
          SELECT
            id
          FROM
            prnt
        ))
    )
    SELECT
      nodes.rec
    , prnt.chld
    FROM
      prnt
    JOIN
      nodes
        ON (nodes.rec).id = prnt.id
  )
)
SELECT
  unnest(string_to_array(chld, ',')::integer[]) leaf
, (rec).*
FROM
tree; 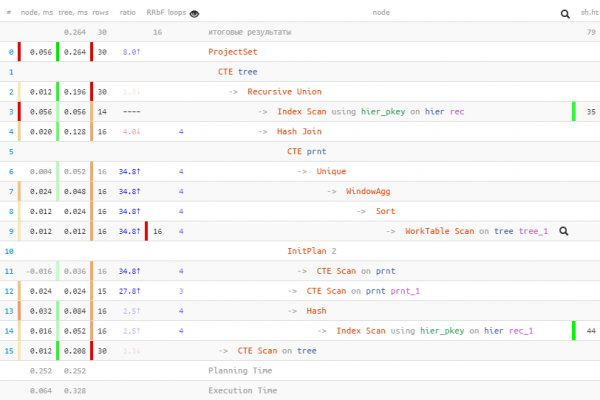
Fonte: habr.com
