

A tradução do artigo foi preparada especialmente para os alunos do curso .
— desenvolvedor de software, entusiasta de Go e amante de resolver problemas complexos. Também é mantenedor do Prometheus e cofundador do Kubernetes SIG instrumentation. No passado, foi engenheiro de produção no SoundCloud e liderou o grupo de monitoramento na CoreOS. Atualmente, trabalha no Google.
— engenheiro de infraestrutura na Improbable. É apaixonado por novas tecnologias e desafios em sistemas distribuídos. Tem experiência em programação de baixo nível na Intel, experiência como contribuinte no Mesos e experiência em SRE em escala mundial na Improbable. Está focado em melhorar o mundo dos microsserviços. Suas três paixões: Golang, código aberto e vôlei.
Olhando para nosso produto flagship SpatialOS, você pode imaginar que a Improbable precisa de uma infraestrutura de nuvem de alta dinâmica em escala global com dezenas de clusters Kubernetes. Fomos um dos primeiros a começar a usar o sistema de monitoramento . O Prometheus é capaz de monitorar milhões de métricas em tempo real e vem com uma poderosa linguagem de consulta que permite extrair as informações necessárias.
A simplicidade e confiabilidade do Prometheus é uma de suas principais vantagens. No entanto, ao passar por uma certa escala, encontramos algumas desvantagens. Para resolver esses problemas, desenvolvemos — um projeto de código aberto criado pela Improbable, para a transformação sem costura de clusters existentes do Prometheus em um único sistema de monitoramento com armazenamento ilimitado de dados históricos. O Thanos está disponível no Github .
Nossos objetivos com o Thanos
Em uma certa escala, surgem problemas que vão além das capacidades do Prometheus vanilla. Como armazenar de forma confiável e econômica petabytes de dados históricos? É possível fazer isso sem comprometer o tempo de resposta das consultas? É possível acessar todas as métricas localizadas em diferentes servidores Prometheus através de uma única solicitação API? É possível, de alguma forma, combinar dados replicados coletados com o Prometheus HA?
Para responder a essas perguntas, criamos o Thanos. Nas seções a seguir, abordamos como enfrentamos essas questões e explicamos os objetivos que buscamos.
Consulta de dados de várias instâncias do Prometheus (consulta global)
Prometheus oferece uma abordagem funcional para sharding. Mesmo um único servidor Prometheus fornece escalabilidade suficiente para liberar os usuários das complexidades do sharding horizontal na maioria dos casos de uso.
Embora este seja um excelente modelo de implantação, frequentemente é necessário acessar dados de diferentes servidores Prometheus por meio de uma única API ou UI — visão global. Claro, é possível exibir várias consultas em um único painel Grafana, mas cada consulta só pode ser realizada em um servidor Prometheus. Por outro lado, com o Thanos, você pode consultar e agregar dados de vários servidores Prometheus, uma vez que todos estão acessíveis a partir de um único endpoint.
Anteriormente, para obter uma visão global na Improbable, organizamos nossas instâncias Prometheus em uma hierarquia de . Isso significava criar um metaserver Prometheus que coleta parte das métricas de cada servidor "folha".
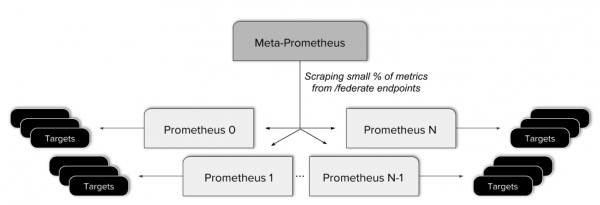
Essa abordagem se mostrou problemática. Ela resultou em uma configuração mais complicada, adicionando um ponto de falha potencial adicional e aplicando regras complexas para fornecer ao endpoint federado apenas os dados necessários. Além disso, federações desse tipo não permitem obter uma verdadeira visão global, uma vez que nem todos os dados estão disponíveis em uma única solicitação de API.
Isso está intimamente relacionado à visão unificada dos dados coletados em servidores Prometheus de alta disponibilidade (high-availability, HA). O modelo HA do Prometheus coleta dados de forma independente duas vezes, sendo tão simples que não poderia ser mais fácil. No entanto, usar uma visão combinada e deduplicada de ambos os fluxos seria muito mais conveniente.
Claro, existe a necessidade de servidores Prometheus de alta disponibilidade. Na Improbable, levamos a monitorização em tempo real de dados muito a sério, mas ter uma única instância do Prometheus em um cluster é um ponto único de falha. Qualquer erro de configuração ou falha de hardware pode potencialmente resultar na perda de dados importantes. Até mesmo uma implantação simples pode levar a breves falhas na coleta de métricas, uma vez que um reinício pode levar consideravelmente mais tempo do que o intervalo de raspagem.
Armazenamento confiável de dados históricos
Um armazenamento de métricas econômico, rápido e de longo prazo é o nosso sonho (compartilhado pela maioria dos usuários do Prometheus). Na Improbable, tivemos que configurar o período de retenção de métricas para nove dias (para o Prometheus 1.8). Isso impõe limitações óbvias sobre o quão longe podemos olhar para trás.
O Prometheus 2.0 melhorou nesse aspecto, pois a quantidade de séries temporais não afeta mais o desempenho geral do servidor (veja ). No entanto, o Prometheus armazena dados no disco local. Embora uma Compressão de Dados altamente eficiente possa reduzir significativamente o uso do SSD local, ainda assim existe um limite para a quantidade de dados históricos armazenados.
Além disso, na Improbable, nos preocupamos com confiabilidade, simplicidade e custo. Discos locais grandes são mais difíceis de operar e fazer backup. Eles são mais caros e requerem mais ferramentas para backup, resultando em complexidade excessiva.
Downsampling
Assim que começamos a trabalhar com dados históricos, percebemos que existem complexidades fundamentais com O-grande, que tornam as consultas cada vez mais lentas se trabalharmos com dados de semanas, meses e anos.
A solução padrão para esse problema é — reduzir a frequência de amostragem do sinal. Ao diminuir a amostragem, podemos 'ampliar' para um intervalo de tempo maior e manter o mesmo número de amostras, o que ajuda a manter a responsividade das consultas.
O downsampling de dados antigos é um requisito inevitável de qualquer solução de armazenamento de longo prazo e vai além do Prometheus vanilla.
Objetivos adicionais
Um dos objetivos iniciais do projeto Thanos era a integração perfeita com quaisquer instalações existentes do Prometheus. O segundo objetivo era uma operação simples com uma barreira de entrada mínima. Quaisquer dependências devem ser facilmente atendidas tanto para usuários pequenos quanto para grandes, implicando também um custo básico insignificante.
Arquitetura do Thanos
Depois de listar nossos objetivos na seção anterior, vamos trabalhar neles e ver como o Thanos aborda esses desafios.
Visão global
Para obter uma visão global sobre as instâncias existentes do Prometheus, precisamos conectar um único ponto de entrada de solicitações a todos os servidores. É exatamente isso que o componente Thanos faz. . Ele é implantado ao lado de cada servidor Prometheus e atua como um proxy, atendendo aos dados locais do Prometheus através da interface gRPC Store API, que permite selecionar dados de séries temporais por rótulos e intervalo de tempo.
Do outro lado, temos o componente Querier, que é escalável horizontalmente e sem estado, e que faz um pouco mais do que apenas responder a solicitações PromQL através da API HTTP padrão do Prometheus. Os componentes Querier, Sidecar e outros do Thanos interagem por meio do .
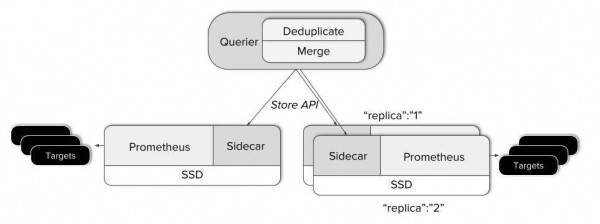
- Quando o Querier recebe uma solicitação, ele se conecta ao servidor correspondente da Store API, ou seja, aos nossos Sidecars, e obtém os dados de séries temporais dos servidores Prometheus correspondentes.
- Depois disso, ele combina as respostas e executa a consulta PromQL sobre elas. O Querier pode combinar dados que não se sobrepõem, bem como dados duplicados de servidores HA do Prometheus.
Isso resolve a maior parte do nosso quebra-cabeça — combinar dados de servidores do Prometheus isolados em uma única visão. De fato, o Thanos pode ser utilizado apenas por causa dessa capacidade. Não são necessárias alterações nos servidores Prometheus existentes!
Armazenamento ilimitado!
No entanto, mais cedo ou mais tarde, desejaremos armazenar dados que ultrapassam o período de retenção comum do Prometheus. Para o armazenamento de dados históricos, escolhemos o armazenamento de objetos. Ele está amplamente disponível em qualquer nuvem, bem como em data centers locais e é muito econômico. Além disso, praticamente qualquer armazenamento de objetos é acessível através da famosa API S3.
O Prometheus grava dados da memória para o disco a cada duas horas. Um bloco de dados armazenados contém todos os dados para um intervalo de tempo fixo e é imutável. Isso é muito conveniente, pois o Thanos Sidecar pode simplesmente observar o diretório de dados do Prometheus e, à medida que novos blocos aparecem, carregá-los nos buckets do armazenamento de objetos.
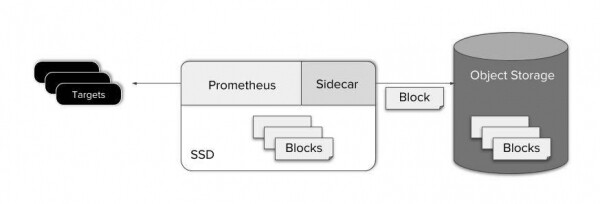
Fazer o upload para o armazenamento de objetos imediatamente após a gravação no disco também permite manter a simplicidade do 'scraper' (Prometheus e Thanos Sidecar), o que simplifica a manutenção, o custo e o design do sistema.
Como você pode ver, o backup de dados é implementado de forma muito simples. Mas e quanto à consulta de dados em um armazenamento de objetos?
O componente Thanos Store atua como um proxy para a obtenção de dados do armazenamento de objetos. Assim como o Thanos Sidecar, ele participa do cluster gossip e implementa a API Store. Assim, os Querier existentes podem vê-lo como um Sidecar, como outra fonte de dados de séries temporais — nenhuma configuração especial é necessária.
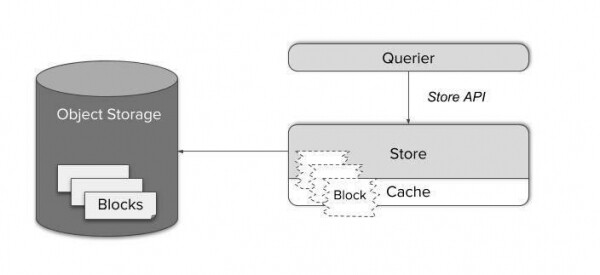
Os blocos de dados de séries temporais consistem em vários arquivos grandes. Carregá-los sob demanda seria bastante ineficiente, e o cache local exigiria uma enorme quantidade de memória e espaço de armazenamento.
Em vez disso, o Store Gateway sabe como lidar com o formato de armazenamento do Prometheus. Graças a um planejador de consultas inteligente e ao cache apenas das partes de índice necessárias dos blocos, foi possível reduzir consultas complexas ao mínimo de solicitações HTTP para os arquivos do armazenamento de objetos. Assim, o número de solicitações pode ser reduzido em quatro a seis ordens de magnitude e alcançar um tempo de resposta que é, em geral, difícil de distinguir das consultas de dados em um SSD local.
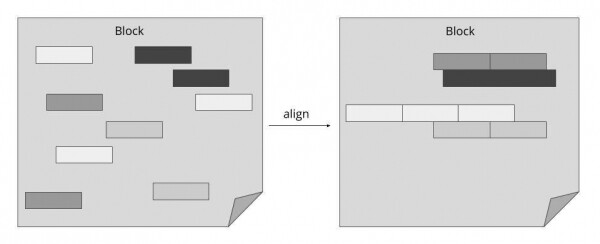
Como mostrado no diagrama acima, o Thanos Querier reduz significativamente o custo por consulta de dados no armazenamento de objetos, utilizando o formato de armazenamento do Prometheus e colocando dados relacionados próximos uns dos outros. Usando essa abordagem, podemos combinar várias solicitações individuais em um número mínimo de operações em lote.
Compactação e downsampling
Depois que um novo bloco de dados de séries temporais é carregado com sucesso no armazenamento de objetos, o consideramos como dados "históricos", que imediatamente se tornam disponíveis através do Store Gateway.
No entanto, após algum tempo, os blocos de uma fonte (Prometheus com Sidecar) se acumulam e já não utilizam todo o potencial de indexação. Para resolver esse problema, introduzimos mais um componente chamado Compactor. Ele simplesmente aplica o mecanismo de compactação local do Prometheus aos dados históricos no armazenamento de objetos e pode ser executado como uma simples tarefa em lote periódica.
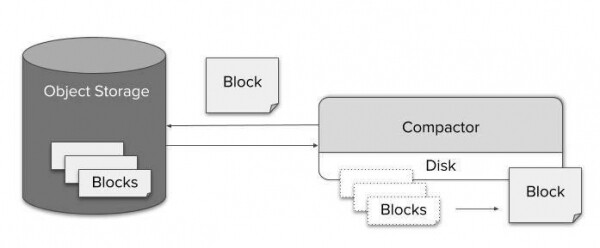
Graças à compactação eficiente, uma solicitação ao armazenamento por um longo período de tempo não apresenta problemas em termos de tamanho de dados. No entanto, o custo potencial de descompactar bilhões de valores e processá-los através do manipulador de consultas inevitavelmente levará a um aumento acentuado no tempo de execução da consulta. Por outro lado, como cada pixel da tela corresponde a centenas de pontos de dados, torna-se impossível até mesmo visualizar os dados em plena resolução. Assim, o downsampling não só é viável, mas também não resultará em uma perda significativa de precisão.
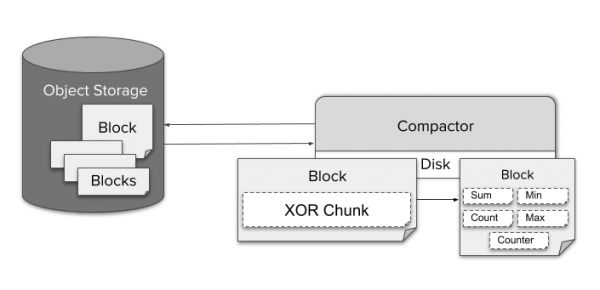
Para o downsampling de dados, o Compactor agrega continuamente dados com resolução de cinco minutos e uma hora. Para cada fragmento bruto codificado com compactação TSDB XOR, diferentes tipos de dados agregados são armazenados, como min, max ou sum para um bloco. Isso permite que o Querier selecione automaticamente a agregação que se adapta à consulta PromQL dada.
Para usar dados com menor precisão, o usuário não precisa de nenhuma configuração especial. O Querier alterna automaticamente entre diferentes resoluções e dados brutos à medida que o usuário aumenta ou diminui o zoom. Se desejado, o usuário pode gerenciar isso diretamente através do parâmetro “step” na consulta.
Como o custo de armazenamento de um GB é pequeno, por padrão o Thanos armazena dados brutos, dados com resolução de cinco minutos e uma hora. Não há necessidade de excluir dados brutos.
Regras de gravação
Mesmo com o Thanos, as regras de gravação são uma parte essencial da pilha de monitoramento. Elas reduzem a complexidade, a latência e o custo das consultas. Também são convenientes para os usuários que desejam obter dados agregados por métricas. O Thanos baseia-se em instâncias vanilla do Prometheus, portanto, é perfeitamente aceitável armazenar regras de gravação e regras de alerta no servidor Prometheus existente. No entanto, em alguns casos, isso pode não ser suficiente:
- Alertas e regras globais (por exemplo, um alerta quando o serviço não está funcionando em mais de dois dos três clusters).
- Regra para dados fora do armazenamento local.
- O desejo de armazenar todas as regras e alertas em um único lugar.
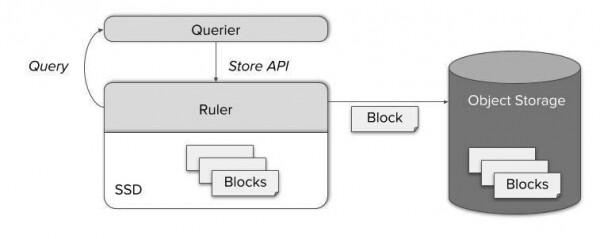
Para todos esses casos, o Thanos inclui um componente separado chamado Ruler, que calcula as regras e alertas por meio de consultas Thanos. Fornecendo uma StoreAPI bem conhecida, o nó Query pode acessar métricas recém-calculadas. Mais tarde, elas também são armazenadas em um armazenamento de objetos e se tornam acessíveis por meio do Store Gateway.
O Poder do Thanos
O Thanos é suficientemente flexível para ser configurado de acordo com suas necessidades. Isso é especialmente útil ao migrar de um Prometheus simples. Vamos rapidamente relembrar, com um pequeno exemplo, o que aprendemos sobre os componentes do Thanos. Aqui está como transferir seu Prometheus vanilla para o mundo de “armazenamento ilimitado de métricas”:
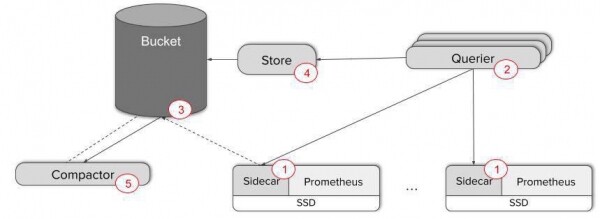
- Adicione o Thanos Sidecar aos seus servidores Prometheus — por exemplo, como um contêiner adjacente em um pod do Kubernetes.
- Implante várias réplicas do Thanos Querier para visualização dos dados. Neste estágio, é fácil configurar o gossip entre o Scraper e o Querier. Para verificar a interação entre os componentes, use a métrica ‘thanos_cluster_members’.
Apenas esses dois passos são suficientes para garantir uma visão global e uma deduplicação perfeitamente integrada dos dados de potenciais réplicas HA do Prometheus! Basta conectar seus painéis ao endpoint HTTP do Querier ou usar diretamente a interface do Thanos UI.
No entanto, se você precisar de backup de métricas e armazenamento a longo prazo, serão necessários mais três passos:
- Crie um bucket AWS S3 ou GCS. Configure o Sidecar para copiar dados para esses buckets. Agora você pode minimizar o armazenamento local de dados.
- Implante o Store Gateway e conecte-o ao cluster gossip existente. Agora você pode fazer consultas aos dados nos backups!
- Implante o Compactor para aumentar a eficiência das consultas para longos intervalos de tempo, utilizando compactação e downsampling.
Se você quiser saber mais, não hesite em conferir nossos e !
Em apenas cinco passos, transformamos o Prometheus em um sistema de monitoramento confiável com uma visão global, tempo de armazenamento ilimitado e alta disponibilidade potencial das métricas.
Solicitação de pull: precisamos de você!
desde o início, foi um projeto de código aberto. A integração perfeita com o Prometheus e a capacidade de usar apenas uma parte do Thanos tornam-no uma excelente escolha para escalar o sistema de monitoramento sem esforço extra.
Estamos sempre abertos a Pull Requests e Issues do GitHub. Ao mesmo tempo, sinta-se à vontade para entrar em contato conosco através de Issues do Github ou pelo Slack., se você tiver perguntas ou feedback, ou quiser compartilhar sua experiência de uso! Se você gosta do que fazemos na Improbable, não hesite em nos contatar — !
Fonte: habr.com
