

Do editor do blog do Google: Você já se perguntou como os engenheiros de Soluções Técnicas do Google Cloud (TSE) tratam suas solicitações de suporte? A responsabilidade dos engenheiros de suporte técnico TSE é identificar e resolver as fontes de problemas relatadas pelos usuários. Alguns desses problemas são bastante simples, mas às vezes aparece um chamado que requer a atenção de vários engenheiros. Neste artigo, um membro da equipe TSE nos contará sobre um problema bastante complicado de sua experiência recente — . Ao longo desta narrativa, veremos como os engenheiros conseguiram resolver a situação e o que aprenderam ao corrigir o erro. Esperamos que esta história não apenas explique um bug profundamente enraizado, mas também ofereça insights sobre os processos envolvidos ao enviar uma solicitação de suporte para o Google Cloud.
A solução de problemas é, ao mesmo tempo, ciência e arte. Tudo começa com a formulação de uma hipótese sobre a causa do comportamento anômalo do sistema, que é então testada. No entanto, antes de formular uma hipótese, devemos definir e articular claramente o problema. Se a questão parecer vaga demais, você precisará analisá-la a fundo; esta é a essência da "arte" da solução de problemas.
No contexto do Google Cloud, esses processos se tornam significativamente mais complexos, pois o Google Cloud se esforça para garantir a privacidade de seus usuários. Como resultado, os engenheiros TSE não têm acesso à edição de seus sistemas, nem podem visualizar as configurações tão amplamente quanto os usuários. Portanto, para verificar qualquer uma de nossas hipóteses, nós (engenheiros) não podemos modificar rapidamente o sistema.
Alguns usuários acreditam que resolveremos tudo como mecânicos em uma oficina, simplesmente nos enviando o ID da máquina virtual, enquanto na realidade o processo acontece em formato de diálogo: coleta de informações, formulação e confirmação (ou refutação) de hipóteses, e, por fim, a solução do problema se baseia na comunicação com o cliente.
O problema em questão
Hoje, temos uma história com um final feliz. Uma das razões para a resolução bem-sucedida do caso proposto é a descrição muito detalhada e precisa do problema. Abaixo, você pode ver uma cópia do primeiro ticket (editado para ocultar informações confidenciais):
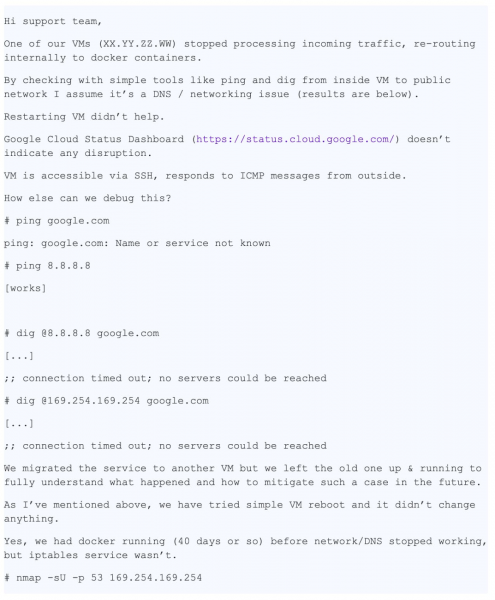
Esta mensagem contém muitas informações úteis para nós:
- Uma VM específica é mencionada
- O problema em si é mencionado — DNS não funciona
- É indicado onde o problema se manifesta — na VM e no contêiner
- Os passos que o usuário realizou para identificar o problema são mencionados
A solicitação foi registrada como "P1: Impacto Crítico — Serviço Inoperante em produção", o que significa monitoramento contínuo da situação 24/7 no esquema "Follow the Sun" (você pode ler mais sobre ), com a transferência de uma equipe de suporte técnico para outra a cada mudança de fuso horário. Na prática, quando o problema chegou à nossa equipe em Zurique, ele já havia contornado o globo. Nesse momento, o usuário tomou medidas para mitigar as consequências, mas temia a repetição da situação em produção, já que a causa principal ainda não havia sido descoberta.
Quando o ticket chegou a Zurique, já tínhamos as seguintes informações:
- Conteúdo
/etc/hosts - Conteúdo
/etc/resolv.conf - Saída
iptables-save - Coletado pela equipe
ngreparquivo pcap
Com esses dados, estávamos prontos para iniciar a fase de investigação e solução de problemas.
Nossos primeiros passos
Primeiramente, verificamos os logs e o status do servidor de metadados e confirmamos que estava funcionando corretamente. O servidor de metadados responde ao IP 169.254.169.254 e, entre outras coisas, é responsável pelo controle dos nomes de domínio. Também redistribuímos a verificação para garantir que o firewall estava funcionando corretamente com a VM e não estava bloqueando pacotes.
Era um problema estranho: a verificação com nmap refutou nossa hipótese principal sobre a perda de pacotes UDP, então mentalmente formulamos mais algumas opções e formas de verificá-las:
- Os pacotes estão se perdendo de forma seletiva? => Verificar as regras do iptables
- É muito pequeno? ? => Проверить вывод
ip a show - O problema afeta apenas pacotes UDP ou também TCP? => Executar
dig +tcp - Os pacotes gerados pelo dig estão retornando? => Executar
tcpdump - O libdns está funcionando corretamente? => Executar
stracepara verificar a transmissão de pacotes em ambas as direções
Aqui decidimos ligar para o usuário para resolver problemas ao vivo.
Durante a chamada, conseguimos verificar várias coisas:
- Após várias verificações, excluímos as regras do iptables da lista de causas
- Verificamos as interfaces de rede e as tabelas de roteamento, e rechecamos a correção do MTU
- Descobrimos que
dig +tcp google.comfunciona como deveria, masdig google.com(UDP) não funciona - Executando
tcpdumpfunciona por enquantodig, descobrimos que os pacotes UDP estão retornando - Executamos
strace dig google.come vemos como o dig chama corretamentesendmsg()erecvmsg(), mas o segundo é interrompido por timeout
Infelizmente, o turno acaba e somos obrigados a passar o problema para o próximo fuso horário. No entanto, o ticket despertou o interesse da nossa equipe, e um colega sugere criar o pacote DNS usando o módulo scrapy do Python.
from scapy.all import *

answer = sr1(IP(dst="169.254.169.254")/UDP(dport=53)/DNS(rd=1,qd=DNSQR(qname="google.com")),verbose=0)
print ("169.254.169.254", answer[DNS].summary())
Esse fragmento cria um pacote DNS e envia a solicitação para o servidor de metadados.
O usuário executa o código, a resposta DNS é retornada e o aplicativo a recebe, confirmando a ausência de problemas no nível da rede.
Após mais uma ‘viagem ao redor do mundo’, o ticket retorna à nossa equipe, e eu o pego completamente, achando que será mais conveniente para o usuário se o ticket parar de circular.
Enquanto isso, o usuário gentilmente concorda em fornecer uma imagem do sistema. Isso é uma ótima notícia: a capacidade de testar o sistema por conta própria acelera significativamente a resolução de problemas, pois não preciso mais pedir ao usuário para executar comandos, enviar-me os resultados e analisá-los; posso fazer tudo sozinho!
Meus colegas começam a sentir um pouco de inveja. Durante o almoço, discutimos o ticket, mas ninguém tem ideias sobre o que está acontecendo. Felizmente, o próprio usuário já tomou medidas para mitigar o problema e não está com pressa, então temos tempo para dissecar o problema. E como temos a imagem, podemos realizar qualquer teste que quisermos. Ótimo!
Voltando um passo atrás
Uma das perguntas mais populares em entrevistas para engenheiros de sistemas é: 'O que acontece quando você faz ping em' ?» Вопрос шикарный, так как кандидату необходимо описать пусть от оболочки до пользовательского пространства, до ядра системы и далее к сети. Я улыбаюсь: иногда вопросы с интервью оказываются полезны и в реальной жизни…
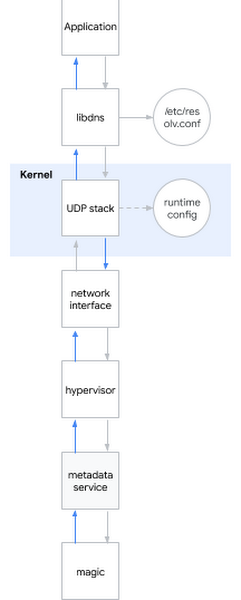
Decido aplicar essa pergunta de RH ao problema atual. Grosso modo, quando você tenta resolver um nome DNS, acontece o seguinte:
- O aplicativo chama uma biblioteca do sistema, como libdns
- libdns verifica a configuração do sistema sobre a qual servidor DNS deve ser consultado (na diagrama é 169.254.169.254, servidor de metadados)
- libdns usa chamadas de sistema para criar um socket UDP (SOCKET_DGRAM) e transmitir pacotes UDP com a consulta DNS em ambas as direções
- Através da interface sysctl, é possível configurar a pilha UDP no nível do kernel
- O kernel interage com o hardware para enviar pacotes pela rede através da interface de rede
- O hipervisor captura e transmite o pacote para o servidor de metadados ao contatá-lo
- O servidor de metadados, com sua mágica, determina o nome DNS e retorna a resposta da mesma forma
Lembro quais hipóteses já discutimos:
Hipótese: As bibliotecas estão corrompidas
- Teste 1: executar strace no sistema, verificar se o dig está fazendo as chamadas de sistema corretas
- Resultado: as chamadas de sistema estão corretas
- Teste 2: usar srapy para verificar se conseguimos identificar nomes ignorando as bibliotecas do sistema
- Resultado: conseguimos
- Teste 3: executar rpm -V no pacote libdns e md5sum dos arquivos da biblioteca
- Resultado: o código da biblioteca é idêntico ao código do sistema operacional em funcionamento
- Teste 4: montar a imagem do sistema raiz do usuário em uma VM sem comportamento semelhante, executar chroot e verificar se o DNS funciona
- Resultado: o DNS funciona corretamente
Conclusão com base nos testes: o problema não está nas bibliotecas
Hipótese: Há um erro nas configurações de DNS
- Teste 1: verificar tcpdump e observar se os pacotes DNS são enviados e recebidos corretamente após a execução do dig
- Resultado: os pacotes estão sendo transmitidos corretamente
- Teste 2: reverificar no servidor
/etc/nsswitch.confe/etc/resolv.conf - Resultado: tudo correto
Conclusão com base nos testes: o problema não está na configuração do DNS
Hipótese: o kernel está corrompido
- Teste: instalar um novo kernel, verificar a assinatura, reiniciar
- Resultado: comportamento análogo
Conclusão com base nos testes: o kernel não está corrompido
Hipótese: comportamento incorreto da rede do usuário (ou da interface de rede do hipervisor)
- Teste 1: verificar as configurações do firewall
- Resultado: o firewall permite pacotes DNS tanto no host quanto no GCP
- Teste 2: capturar tráfego e rastrear a correção da transmissão e retorno das consultas DNS
- Resultado: tcpdump confirma a recepção dos pacotes de retorno pelo host
Conclusão com base nos testes: o problema não está na rede
Hipótese: o servidor de metadados não está funcionando
- Teste 1: verificar os logs do servidor de metadados em busca de anomalias
- Resultado: não há anomalias nos logs
- Teste 2: contornar o servidor de metadados através de
dig @8.8.8.8 - Resultado: a resolução falha mesmo sem usar o servidor de metadados
Conclusão com base nos testes: o problema não está no servidor de metadados
Resultado: testamos todos os subsistemas, exceto configurações do ambiente de execução!
Aprofundando-se nas configurações do ambiente de execução do núcleo
Para configurar o ambiente de execução do núcleo, você pode usar as opções da linha de comando (grub) ou a interface sysctl. Eu dei uma olhada em /etc/sysctl.conf e, acredite, encontrei várias configurações personalizadas. Sentindo que estava prestes a descobrir algo, eu descartei todas as configurações que não eram de rede ou não-tcp, ficando apenas com um punhado de configurações net.core. Então, fui à pasta onde as VM armazenam as permissões do host e comecei a aplicar as configurações da VM quebrada uma a uma até encontrar o culpado:
net.core.rmem_default = 2147483647Aqui está, a configuração que quebra o DNS! Eu encontrei a arma do crime. Mas por que isso acontece? Eu ainda precisava de um motivo.
A configuração do tamanho base do buffer dos pacotes DNS é feita através de net.core.rmem_default. O valor típico varia em torno de 200KiB, no entanto, se seu servidor receber muitos pacotes DNS, você pode aumentar o tamanho do buffer. Se, no momento da chegada de um novo pacote, o buffer estiver cheio, por exemplo, porque o aplicativo não o processa rapidamente o suficiente, você começará a perder pacotes. Nosso cliente aumentou corretamente o tamanho do buffer porque temia a perda de dados, uma vez que utilizava um aplicativo de coleta de métricas através de pacotes DNS. O valor que ele definiu foi o máximo possível: 231-1 (se definir 231, o núcleo retornará "ARGUMENTO INVÁLIDO").
De repente, percebi por que nmap e scapy funcionavam corretamente: eles usavam soquetes brutos! Soquetes brutos são diferentes dos convencionais: eles funcionam contornando o iptables e não têm buffer!
Mas por que um "buffer muito grande" causa problemas? Ele claramente não está funcionando como deveria.
Nesse ponto, eu poderia reproduzir o problema em vários núcleos e diversas distribuições. O problema já se manifestava no núcleo 3.x e agora também aparecia no núcleo 5.x.
De fato, ao executar
sysctl -w net.core.rmem_default=$((2**31-1))o DNS parava de funcionar.
Comecei a procurar valores funcionais através de um simples algoritmo de busca binária e descobri que o sistema funcionava com 2147481343, no entanto, esse número não fazia sentido para mim. Sugeri ao cliente tentar esse número, e ele respondeu que o sistema funcionou com google.com, mas ainda apresentava erro com outros domínios, então continuei minha investigação.
Instalei , uma ferramenta que eu deveria ter usado antes: ela mostra exatamente onde o pacote atinge o núcleo. A função responsável foi identificada como udp_queue_rcv_skb. Baixei o código-fonte do núcleo e adicionei algumas para monitorar exatamente onde o pacote estava indo. Rapidamente identifiquei a condição necessária if, e por um tempo apenas fiquei olhando para ela, pois foi então que tudo finalmente se encaixou em uma imagem coesa: 231-1, um número sem sentido, um domínio não funcional… A questão estava em um pedaço de código em __udp_enqueue_schedule_skb:
if (rmem > (size + sk->sk_rcvbuf))
		goto uncharge_drop;
Observe:
rmemé do tipo inttamanhoé do tipo u16 (int sem sinal de dezesseis bits) e armazena o tamanho do pacotesk->sk_rcybufé do tipo int e armazena o tamanho do buffer, que por definição iguala-se ao valor emnet.core.rmem_default
Quando sk_rcvbuf aproximando-se de 231, a soma do tamanho do pacote pode levar a . E como é um int, seu valor torna-se negativo, assim a condição torna-se verdadeira quando deveria ser falsa (mais sobre isso pode ser encontrado em ).
O erro é corrigido de forma trivial: convertendo para unsigned int. Apliquei a correção e reiniciei o sistema, após o que o DNS voltou a funcionar.
O gosto da vitória
Enviei minhas descobertas ao cliente e enviei o do núcleo. Estou satisfeito: cada pedaço do quebra-cabeça se uniu, posso explicar exatamente por que observamos o que observamos e, mais importante, conseguimos encontrar a solução para o problema através da colaboração!
Devo reconhecer que o caso foi raro e, felizmente, recebemos raramente consultas tão complexas dos usuários.
Fonte: habr.com
