

Olá, Habr! Meu nome é Maxim Vasiliev, sou analista e gerente de projetos na FINCH. Hoje gostaria de contar como, com a ajuda do ElasticSearch, conseguimos processar 15 milhões de solicitações em 6 minutos e otimizar a carga diária no site de um de nossos clientes. Infelizmente, teremos que fazer isso sem nomes, pois temos um NDA, esperamos que o conteúdo do artigo não sofra com isso. Vamos lá.
Como o projeto é estruturado
Em nosso back-end, criamos serviços que garantem o funcionamento dos sites e do aplicativo móvel de nosso cliente. A estrutura geral pode ser vista no diagrama:
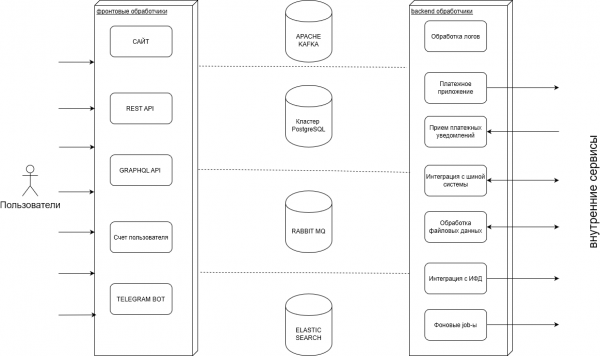
Durante o trabalho, processamos uma grande quantidade de transações: compras, pagamentos, operações com os saldos dos usuários, para as quais armazenamos muitos logs, além de importar e exportar esses dados para sistemas externos.
Além disso, existem processos inversos, quando recebemos dados do cliente e os transmitimos aos usuários. Além disso, também existem processos relacionados a pagamentos e programas de bônus.
Uma breve história
Inicialmente, utilizamos o PostgreSQL como o único armazenamento de dados. Suas vantagens padrão para SGBD: transações, linguagem de consulta de dados desenvolvida, ampla ferramenta de integração; combinadas com uma boa performance, atenderam nossas necessidades por bastante tempo.
Armazenávamos tudo no Postgres: desde transações até notícias. Mas o número de usuários estava crescendo, assim como o número de solicitações.
Para entender, o número anual de sessões em 2017 no site desktop foi de apenas 131 milhões. Em 2018, foi de 125 milhões. Em 2019, novamente 130 milhões. Adicione mais 100-200 milhões da versão móvel do site e do aplicativo móvel, e você terá uma quantidade colossal de solicitações.
Com o crescimento do projeto, o Postgres parou de aguentar a carga, não estávamos conseguindo — surgiu uma grande quantidade de solicitações variadas, para as quais não conseguimos criar um número suficiente de índices.
Percebemos que era necessário ter outros sistemas de armazenamento de dados que atendesse nossas necessidades e aliviasse a carga do PostgreSQL. Consideramos como opções o Elasticsearch e o MongoDB. Este último ficou atrás nos seguintes pontos:
- A velocidade lenta de indexação com o aumento do volume de dados nos índices. No Elastic, a velocidade não depende do volume de dados.
- Nenhuma pesquisa em texto completo
Assim, escolhemos o Elastic e nos preparamos para a transição.
Transição para o Elastic
1. Começamos a transição com o serviço de busca de pontos de venda. Nosso cliente possui aproximadamente 70.000 pontos de venda e requer vários tipos de busca no site e no aplicativo:
- Busca textual pelo nome da localidade
- Geoposição em um raio definido a partir de um ponto. Por exemplo, se o usuário deseja ver quais pontos de venda estão mais próximos de sua casa.
- Busca em um quadrado definido – o usuário desenha um quadrado no mapa e vê todos os pontos dentro desse raio.
- Busca por filtros adicionais. Os pontos de venda diferem entre si quanto ao sortimento
Em termos de organização, temos no Postgres a fonte de dados tanto para o mapa quanto para as notícias, enquanto no Elastic fazemos snapshots dos dados originais. O fato é que, inicialmente, o Postgres não estava conseguindo lidar com a busca por todos os critérios. Não só havia muitos índices, como eles podiam se sobrepor, fazendo com que o planejador do Postgres se confundisse e não entendesse qual índice usar.
2. O próximo a ser tratado foi a seção de notícias. O site publica diariamente conteúdos e, para que o usuário não se perca em meio ao fluxo de informações, os dados precisam ser organizados antes da apresentação. Para isso, a busca é necessária: no site é possível fazer buscas por correspondência de texto e também ativar filtros adicionais, já que eles também foram implementados através do Elastic.
3. Depois, transferimos o processamento das transações. Os usuários podem comprar um determinado produto no site e participar de sorteios. Após tais compras, processamos uma grande quantidade de dados, especialmente nos fins de semana e feriados. Para comparação, em dias normais o número de compras gira em torno de 1,5-2 milhões, enquanto nos feriados esse número pode atingir 53 milhões.
Além disso, os dados precisam ser processados em menor tempo possível — os usuários não gostam de esperar dias pelo resultado. Através do Postgres, esses prazos são inviáveis — frequentemente enfrentávamos bloqueios, e enquanto processávamos todas as requisições, os usuários não podiam verificar se ganharam prêmios ou não. Isso não é muito agradável para os negócios, então transferimos o processamento para o Elasticsearch.
Periodicidade
Atualmente, as atualizações estão configuradas para serem acionadas em função das seguintes condições:
- Pontos de venda. Assim que recebemos dados de uma fonte externa, iniciamos imediatamente a atualização.
- Notícias. Quando uma notícia é editada no site, ela é automaticamente enviada para o Elastic.
Aqui vale a pena mencionar novamente as vantagens do Elastic. No Postgres, ao enviar uma consulta, é necessário esperar que ele processe todas as entradas. No Elastic, é possível enviar 10 mil registros e começar a trabalhar imediatamente, sem esperar que os dados se dispersem entre todos os Shards. Claro, algum Shard ou Réplica pode não ver os dados imediatamente, mas logo tudo estará disponível.
Métodos de integração
Existem 2 maneiras de integrar com o Elastic:
- Através do cliente nativo por TCP. O driver nativo está gradualmente desaparecendo: está sendo descontinuado, possui uma sintaxe muito inconveniente. Portanto, quase não o utilizamos e tentamos nos afastar completamente dele.
- Através da interface HTTP, que pode usar tanto consultas JSON quanto a sintaxe Lucene. Este último é um mecanismo de texto que o Elastic utiliza. Neste caso, obtemos a capacidade de Batch por meio de consultas JSON via HTTP. Este é o formato que tentamos usar.
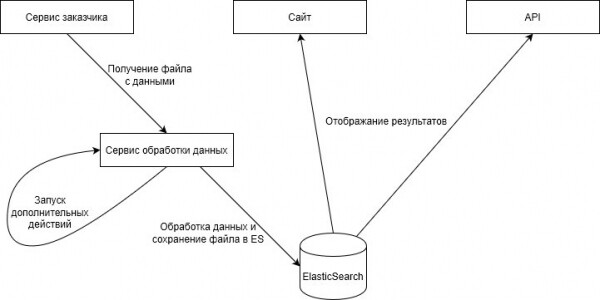
Graças à interface HTTP, podemos usar bibliotecas que oferecem uma implementação assíncrona do cliente HTTP. Podemos aproveitar a Batch e a API assíncrona, o que, no final das contas, resulta em alta performance que foi muito útil em dias de grandes promoções (sobre isso abaixo)
Um pouco de números para comparação:
- Salvamento de usuários que receberam prêmios no Postgres em 20 threads sem agrupamentos: 460713 registros em 42 segundos
- Elastic + cliente reativo em 10 threads + batch em 1000 elementos: 596749 registros em 11 segundos
- Elastic + cliente reativo em 10 threads + batch em 1000 elementos: 23801684 registros em 4 minutos
Atualmente, escrevemos um gerenciador de requisições HTTP que constrói JSON, como Batch/não Batch e envia através de qualquer cliente HTTP, independentemente da biblioteca. Também é possível escolher enviar requisições de forma síncrona ou assíncrona.
Em algumas integrações, ainda utilizamos o transport client oficial, mas isso é apenas uma questão de reestruturação próxima. Para o processamento, usamos um cliente próprio, construído com base no Spring WebClient.
Grande promoção
Uma vez por ano, realizamos uma grande promoção para os usuários - é essa a verdadeira Highload, pois durante esse período trabalhamos com dezenas de milhões de usuários simultaneamente.
Normalmente, os picos de carga ocorrem nos dias festivos, mas esta promoção é um nível completamente diferente. No ano retrasado, no dia da promoção, vendemos 27.580.890 unidades de produto. Os dados foram processados por mais de meia hora, o que causou desconforto aos usuários. Os usuários ganharam prêmios pela participação, mas ficou claro que o processo precisava ser acelerado.
No início de 2019, decidimos que precisávamos do ElasticSearch. Passamos um ano organizando o processamento dos dados recebidos no Elastic e sua entrega na API do aplicativo móvel e do site. Como resultado, no ano seguinte, durante a promoção, processamos 15.131.783 registros em 6 minutos.
Como temos muitos interessados em comprar produtos e participar do sorteio de prêmios nas promoções, essa é uma medida temporária. Atualmente, estamos enviando informações atualizadas para o Elastic, mas planejamos posteriormente transferir as informações arquivadas dos meses anteriores para o Postgres, como armazenamento permanente. Isso evitará a saturação do índice Elastic, que também possui suas limitações.
Conclusão / resumos
Atualmente, transferimos para o Elastic todos os serviços que desejávamos e fizemos uma pausa nisso por enquanto. Agora, estamos construindo um índice no Elastic sobre o principal armazenamento persistente no Postgres, que assume a carga dos usuários.
No futuro, planejamos transferir serviços se entendermos que a solicitação de dados se torna muito diversificada e está sendo pesquisada em um número ilimitado de colunas. Essa já não é uma tarefa para o Postgres.
Se precisarmos de busca de texto completo em nossas funcionalidades ou se tivermos muitos critérios de busca variados, já sabemos que isso precisa ser transferido para o Elastic.
⌘⌘⌘
Obrigado por ler. Se na sua empresa também utilizam o ElasticSearch e têm seus próprios casos de implementação, compartilhe conosco. Vai ser interessante saber como os outros fazem 🙂
Fonte: habr.com
