

Uma breve palavra de introdução
Acredito que faríamos mais coisas se tivéssemos instruções passo a passo que nos dissessem o que e como fazer. Lembro de momentos na minha vida em que não consegui começar algo porque era difícil entender por onde começar. Talvez, há muito tempo atrás, você tenha visto as palavras "Ciência de Dados" na internet e pensado que estava longe disso, como se as pessoas que trabalham com isso estivessem em outro mundo. Mas não, elas estão bem aqui. E, talvez, graças a pessoas desse campo, um artigo tenha aparecido no seu feed. Existem muitos cursos que podem ajudá-lo a dominar essa habilidade, e aqui vou ajudá-lo a dar seu primeiro passo.
Então, você está pronto? Vou logo avisá-lo que você precisará saber Python 3, pois é isso que vou usar aqui. Também recomendo que instale o Jupyter Notebook ou veja como utilizar o google colab com antecedência.
Passo um
Kaggle é um grande aliado nesse processo. Na verdade, é possível passar sem ele, mas falarei sobre isso em outro artigo. É uma plataforma onde são realizados competições de Ciência de Dados. Em cada competição, nas fases iniciais, você ganhará uma quantidade incrível de experiência em resolver diversos tipos de problemas, desenvolvimento e trabalho em equipe, que é muito importante nos dias de hoje.
Vamos pegar nosso desafio de lá. Chama-se "Titanic". A tarefa é a seguinte: prever se cada pessoa sobrevivente vai sobreviver. Em termos gerais, a função de alguém que trabalha com Ciência de Dados é coletar dados, processá-los, treinar um modelo, fazer previsões e assim por diante. No Kaggle, nós podemos pular a etapa de coleta de dados — eles estão disponíveis na plataforma. Precisamos carregá-los e podemos começar o trabalho!
Você pode fazer isso da seguinte maneira:
na aba Dados, estão os arquivos que contêm os dados


Carregamos os dados, preparamos nossos notebooks do Jupyter e…
Passo dois
Como vamos carregar esses dados agora?
Primeiro, vamos importar as bibliotecas necessárias:
import pandas as pd
import numpy as np
O Pandas nos permitirá carregar arquivos .csv para processamento posterior.
O Numpy é necessário para que possamos representar nossa tabela de dados como uma matriz de números.
Vamos em frente. Vamos pegar o arquivo train.csv e carregá-lo para nós:
dataset = pd.read_csv('train.csv')
Vamos nos referir ao nosso conjunto de dados train.csv através da variável dataset. Vamos dar uma olhada no que há lá:
dataset.head()
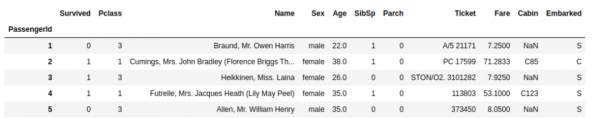
A função head() nos permite visualizar as primeiras linhas do dataframe.
A coluna Survived são exatamente os nossos resultados, que são conhecidos neste dataframe. Sobre o problema, precisamos prever a coluna Survived para os dados do test.csv. Esses dados contêm informações sobre outros passageiros do Titanic, para os quais, nós que estamos resolvendo o problema, não conhecemos os resultados.
Assim, vamos dividir nossa tabela em dados dependentes e independentes. Aqui tudo é simples. Dados dependentes são aqueles que dependem de dados independentes, ou seja, que estão nos resultados. Dados independentes são aqueles que influenciam o resultado.
Por exemplo, temos este conjunto de dados:
“Vova estudou informática - não.
Vova obteve 2 em informática.”
A nota em informática depende da resposta à pergunta: Vova estudou informática? Entendido? Vamos em frente, já estamos mais perto do objetivo!
A variável tradicional para dados independentes é X. Para dependentes, é y.
Fazemos o seguinte:
X = dataset.iloc[ : , 2 : ]
y = dataset.iloc[ : , 1 : 2 ]
O que é isso? Com a função iloc[:, 2: ] estamos dizendo ao Python: quero ver na variável X dados começando da segunda coluna (inclusiva e considerando que a contagem começa do zero). Na segunda linha, dizemos que queremos ver na y os dados da primeira coluna.
[ a:b, c:d ] — essa é a construção que usamos entre parênteses. Se não especificarmos algumas variáveis, elas permanecerão como padrão. Ou seja, podemos especificar [:,: d] e assim obteremos no dataframe todas as colunas, exceto aquelas que começam com o número d e em diante. As variáveis a e b definem as linhas, mas precisamos de todas, então deixamos como padrão.
Vamos ver o que conseguimos:
X.head() 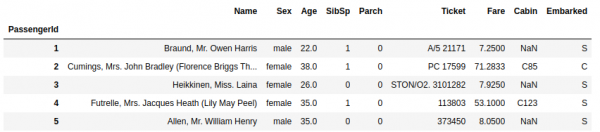
y.head() 
Para simplificar esta pequena lição, vamos remover as colunas que exigem um "cuidado" especial, ou que não afetam a sobrevivência. Elas contêm dados do tipo str.
count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X.drop(count, inplace=True, axis=1)
Ótimo! Vamos para o próximo passo.
Passo três
Aqui precisamos codificar nossos dados para que a máquina entenda melhor como esses dados influenciam no resultado. Mas vamos codificar apenas os dados do tipo str que deixamos. A coluna 'Sexo'. Como queremos codificar? Vamos considerar os dados sobre o gênero de uma pessoa como um vetor: 10 — masculino, 01 — feminino.
Para começar, vamos converter nossas tabelas em uma matriz NumPy:
X = np.array(X)
y = np.array(y)
Agora vamos ver:
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder

ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X = np.array(ct.fit_transform(X))
A biblioteca sklearn é uma biblioteca incrível que nos permite realizar todo o trabalho em Data Science. Ela contém uma grande quantidade de modelos interessantes de aprendizado de máquina, além de permitir que façamos a preparação dos dados.
O OneHotEncoder nos permitirá codificar o gênero de uma pessoa na representação como descrevemos. Serão criadas 2 classes: masculino e feminino. Se a pessoa for um homem, 1 será registrado na coluna 'masculino' e, respectivamente, 0 na 'feminino'.
Após o OneHotEncoder() está [1] — isso significa que queremos codificar a coluna de número 1 (contagem a partir de zero).
Ótimo. Vamos em frente!
Como regra geral, às vezes acontece de alguns dados estarem vazios (ou seja, NaN — not a number). Por exemplo, há informações sobre uma pessoa: seu nome, gênero. Mas os dados sobre sua idade não estão disponíveis. Nesse caso, vamos aplicar o seguinte método: encontraremos a média aritmética de todas as colunas e, se alguns dados em uma coluna estiverem ausentes, preencheremos o vazio com a média aritmética.
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X)
X = imputer.transform(X)
Agora vamos considerar que há situações em que os dados estão muito dispersos. Alguns dados estão na faixa [0:1], enquanto outros podem ultrapassar centenas ou milhares. Para excluir essa variabilidade e tornar os cálculos mais precisos, escalaremos os dados, vamos padronizá-los. Vamos garantir que todos os números não ultrapassem três. Para isso, usaremos a função StandardScaler.
from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X[:, 2:] = sc.fit_transform(X[:, 2:])
Agora nossos dados parecem assim:

Clássico. Estamos cada vez mais próximos do nosso objetivo!
Passo quatro
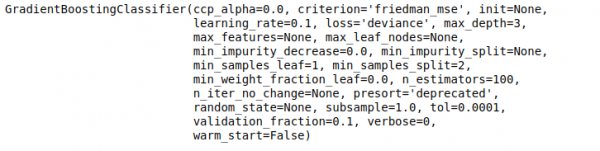
Vamos treinar nosso primeiro modelo! Da biblioteca sklearn, podemos encontrar uma enorme quantidade de coisas interessantes. Eu apliquei à esta tarefa o modelo Gradient Boosting Classifier. Usamos um classificador, pois a nossa tarefa é uma tarefa de classificação. Precisamos prever se a pessoa sobreviveu (1) ou não (0).
from sklearn.ensemble import GradientBoostingClassifier
gbc = GradientBoostingClassifier(learning_rate=0.5, max_depth=5, n_estimators=150)
gbc.fit(X, y)
A função fit diz ao Python: Deixe o modelo encontrar as dependências entre X e y.
Menos de um segundo e o modelo está pronto.
Como aplicá-lo? Vamos ver agora!
Passo cinco. Conclusão
Agora precisamos carregar a tabela com nossos dados de teste, para os quais precisamos fazer previsões. Para esta tabela, faremos todas as mesmas operações que fizemos para X.
X_test = pd.read_csv('test.csv', index_col=0)

count = ['Name', 'Ticket', 'Cabin', 'Embarked']
X_test.drop(count, inplace=True, axis=1)

X_test = np.array(X_test)

from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
ct = ColumnTransformer(transformers=[('encoder', OneHotEncoder(), [1])],
                       remainder='passthrough')
X_test = np.array(ct.fit_transform(X_test))

from sklearn.impute import SimpleImputer
imputer = SimpleImputer(missing_values=np.nan, strategy='mean')
imputer.fit(X_test)
X_test = imputer.transform(X_test)

from sklearn.preprocessing import StandardScaler
sc = StandardScaler()
X_test[:, 2:] = sc.fit_transform(X_test[:, 2:])
Vamos aplicar nosso modelo já!
gbc_predict = gbc.predict(X_test)
Tudo. Fizemos a previsão. Agora precisamos gravá-la em um csv e enviar para o site.
np.savetxt('my_gbc_predict.csv', gbc_predict, delimiter=",", header = 'Survived')
Pronto. Obtivemos um arquivo contendo as previsões para cada passageiro. Agora, só falta subir essas soluções ao site e obter a avaliação da previsão. Essa solução simples fornece não apenas 74% de respostas corretas no público, mas também um impulso em Data Science. Os mais curiosos podem me enviar mensagens a qualquer momento e fazer perguntas. Muito obrigado!
Fonte: habr.com
