

Olá, recentemente encontrei uma tarefa interessante de configurar um armazenamento para backup de um grande número de dispositivos de bloco.
Toda semana realizamos o backup de todas as máquinas virtuais em nossa nuvem, assim precisamos ser capazes de gerenciar milhares de backups e fazê-lo da maneira mais rápida e eficiente possível.
Infelizmente, as configurações padrão RAID5, RAID6 neste caso não serão adequadas, uma vez que o processo de recuperação em discos tão grandes quanto os nossos será dolorosamente longo e provavelmente nunca terminará.
Vamos considerar quais são as alternativas:
— Semelhante ao RAID5, RAID6, mas com um nível de paridade configurável. Neste caso, a proteção não é feita por bloco, mas para cada objeto individualmente. A maneira mais simples de experimentar erasure coding é implementar .
— esta é uma funcionalidade ainda não lançada do ZFS. Ao contrário do RAIDZ, o DRAID possui um bloco de paridade distribuído e, durante a recuperação, utiliza todos os discos da matriz, o que melhora a resistência a falhas e acelera a recuperação após uma falha.
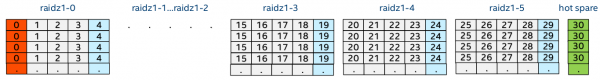
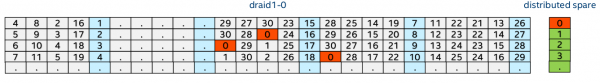
Temos à disposição um servidor Fujitsu Primergy RX300 S7 com processador Intel Xeon CPU E5-2650L 0 @ 1.80GHz, nove módulos de memória RAM Samsung DDR3-1333 8Gb PC3L-10600R ECC Registered (M393B1K70DH0-YH9), uma unidade de disco Supermicro SuperChassis 847E26-RJBOD1, conectada através de Dual LSI SAS2X36 Expander e 45 discos Seagage ST6000NM0115-1YZ110 para 6TB cada um.
Antes de decidir algo, precisamos primeiro testar tudo adequadamente.
Para isso, me preparei e realizei testes de várias configurações. Usei o minio, que atuou como backend S3, e o executei em diferentes modos com diferentes quantidades de alvos.
O foco principal dos testes foi o caso do minio em erasure coding contra software RAID com a mesma quantidade de discos e discos de paridade, ou seja: RAID6, RAIDZ2 e DRAID2.
Para referência: quando você executa o minio com apenas um único alvo, ele funciona em modo de gateway S3, apresentando seu sistema de arquivos local como um armazenamento S3. No entanto, se você iniciar o minio especificando vários alvos, o modo Erasure Coding será ativado automaticamente, espalhando os dados entre seus alvos e fornecendo resistência a falhas.
Por padrão, o minio divide os alvos em grupos de 16 discos, onde cada grupo possui 2 paridades. Ou seja, até dois discos podem falhar simultaneamente sem perda de dados.
Para testar o desempenho, utilizei 16 discos de 6TB cada e escrevi objetos pequenos de 1MB, o que descreveu com precisão nossa carga de trabalho futura, uma vez que todas as ferramentas modernas de backup dividem os dados em blocos de alguns megabytes e os gravam dessa forma.
Para realizar o benchmark, usei a ferramenta s3bench, executada em um servidor remoto, que enviava dezenas de milhares de objetos ao minio em cem threads. Após isso, tentei solicitá-los de volta da mesma maneira.
Os resultados do benchmark estão na tabela a seguir:
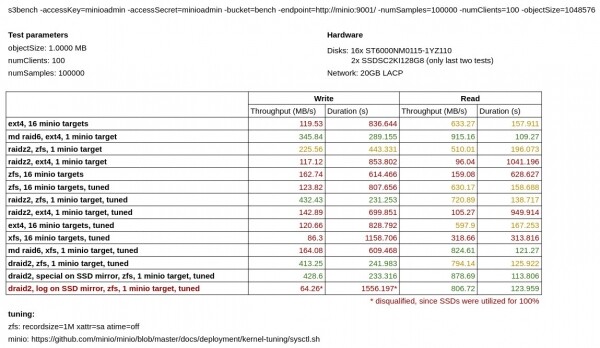
Como podemos ver, o minio em modo de erasure coding próprio apresenta desempenho de gravação significativamente inferior em comparação ao minio rodando sobre RAID6, RAIDZ2 e DRAID2 na mesma configuração.
Separadamente, fui para testar o minio no ext4 vs XFS. Surpreendentemente, para meu tipo de carga, o XFS se mostrou significativamente mais lento que o ext4.
No primeiro grupo de testes, o Mdadm demonstrou superioridade sobre o ZFS, mas mais tarde , que a performance do ZFS poderia ser melhorada ao definir as seguintes opções:
xattr=sa atime=off recordsize=1Me após isso, os testes com ZFS melhoraram muito.
Também é possível notar que o DRAID não oferece um ganho significativo de desempenho em relação ao RAIDZ, mas teoricamente deve ser muito mais seguro.
Nos últimos dois testes, também tentei mover os metadados (special) e ZIL (log) para um espelho SSD. No entanto, a remoção dos metadados não trouxe um ganho significativo na velocidade de gravação, e ao mover o ZIL, minha chegou ao limite com 100% de utilização, então considero este teste como falhado. Não descarto que, se tivesse SSDs mais rápidos, isso poderia melhorar significativamente meus resultados, mas, infelizmente, não os tinha.
No fim, decidi continuar usando o DRAID e, apesar de seu status beta, ele é a solução mais rápida e eficaz para armazenamento no nosso caso.
Criei um simples DRAID2 na configuração com três grupos e dois spares distribuídos:
# zpool status data
  pool: data
 state: ONLINE
  scan: none requested
config:

    NAME                 STATE     READ WRITE CKSUM
    data                 ONLINE       0     0     0
      draid2:3g:2s-0     ONLINE       0     0     0
        sdy              ONLINE       0     0     0
        sdam             ONLINE       0     0     0
        sdf              ONLINE       0     0     0
        sdau             ONLINE       0     0     0
        sdab             ONLINE       0     0     0
        sdo              ONLINE       0     0     0
        sdw              ONLINE       0     0     0
        sdak             ONLINE       0     0     0
        sdd              ONLINE       0     0     0
        sdas             ONLINE       0     0     0
        sdm              ONLINE       0     0     0
        sdu              ONLINE       0     0     0
        sdai             ONLINE       0     0     0
        sdaq             ONLINE       0     0     0
        sdk              ONLINE       0     0     0
        sds              ONLINE       0     0     0
        sdag             ONLINE       0     0     0
        sdi              ONLINE       0     0     0
        sdq              ONLINE       0     0     0
        sdae             ONLINE       0     0     0
        sdz              ONLINE       0     0     0
        sdan             ONLINE       0     0     0
        sdg              ONLINE       0     0     0
        sdac             ONLINE       0     0     0
        sdx              ONLINE       0     0     0
        sdal             ONLINE       0     0     0
        sde              ONLINE       0     0     0
        sdat             ONLINE       0     0     0
        sdaa             ONLINE       0     0     0
        sdn              ONLINE       0     0     0
        sdv              ONLINE       0     0     0
        sdaj             ONLINE       0     0     0
        sdc              ONLINE       0     0     0
        sdar             ONLINE       0     0     0
        sdl              ONLINE       0     0     0
        sdt              ONLINE       0     0     0
        sdah             ONLINE       0     0     0
        sdap             ONLINE       0     0     0
        sdj              ONLINE       0     0     0
        sdr              ONLINE       0     0     0
        sdaf             ONLINE       0     0     0
        sdao             ONLINE       0     0     0
        sdh              ONLINE       0     0     0
        sdp              ONLINE       0     0     0
        sdad             ONLINE       0     0     0
    spares
      s0-draid2:3g:2s-0  AVAIL
      s1-draid2:3g:2s-0  AVAIL

errors: No known data errors
Bom, resolvemos a questão do armazenamento, agora sobre o que usaremos para fazer backup. Aqui, gostaria de falar sobre três soluções que consegui experimentar, que são:
— um fork , uma solução especializada para backup de dispositivos em bloco, tem uma integração estreita com o Ceph. É capaz de capturar diffs entre snapshots e formar backups incrementais a partir deles. Suporta uma grande quantidade de backends de armazenamento, incluindo tanto local quanto S3. Exige um banco de dados separado para armazenar a tabela hash de deduplicação. Entre os pontos negativos: é escrito em Python e possui um CLI um pouco não responsivo.
— um fork , uma ferramenta já conhecida e testada para backup, que consegue fazer backup de dados e realiza boa deduplicação. É capaz de armazenar backups tanto localmente quanto em um servidor remoto via SCP. Pode fazer backup de dispositivos em bloco se for executado com a flag --special, entre os negativos: ao criar um backup, o repositório é completamente bloqueado, portanto é recomendável criar um repositório separado para cada máquina virtual; isso não é um problema, pois eles são criados com bastante facilidade.
— um projeto em ativo desenvolvimento, escrito em Go, bastante rápido e suporta uma ampla gama de backends para armazenamento, incluindo armazenamento local, SCP, S3 e muito mais. Vale ressaltar que existe um especificamente para o restic, que permite exportar o armazenamento de forma mais rápida para uso remoto. Dos mencionados, gostei mais deste. Ele é capaz de fazer backup de stdin. Quase não possui desvantagens notáveis, mas há algumas particularidades:
Primeiro, eu tentei usá-lo no modo de repositório compartilhado para todas as máquinas virtuais (como o Benji) e funcionou razoavelmente bem, mas as operações de restauração demoravam bastante, uma vez que toda vez que o restic tenta ler os metadados de todos os backups antes da restauração. Esse problema foi facilmente resolvido, assim como com o Borg, criando um repositório separado para cada máquina virtual. Essa abordagem também se mostrou bastante eficaz na gestão de backups. Repositórios isolados podem ter uma senha separada para acessar os dados, e também podemos ficar tranquilos que um repositório global não pode falhar de alguma forma. Criar novos repositórios também é tão simples quanto no Borg Backup.
De qualquer forma, a deduplicação é feita apenas em relação à versão anterior do backup, que é definida pelo caminho para o backup indicado. Portanto, se você estiver fazendo backup de diferentes objetos do stdin em um repositório comum, não se esqueça de especificar a opção
--stdin-filename, ou então mencionar explicitamente a opção--parent.
Em segundo lugar, a recuperação para stdout leva significativamente mais tempo do que a recuperação no sistema de arquivos devido à sua paralelidade. No futuro, está planejado adicionar um suporte mais próximo para backups de dispositivos de bloco.
Em terceiro lugar, neste momento, é recomendável usar a , pois a versão 0.9.6 tem um bug com a recuperação lenta de grandes arquivos.
Para testar a eficácia do backup e a velocidade de gravação / recuperação do backup, criei um repositório separado e tentei fazer backup de uma pequena imagem de máquina virtual (21 GB). Foram realizados dois backups sem modificar o original, usando cada uma das soluções listadas, para verificar como os dados deduplicados são copiados mais rápido / mais devagar.
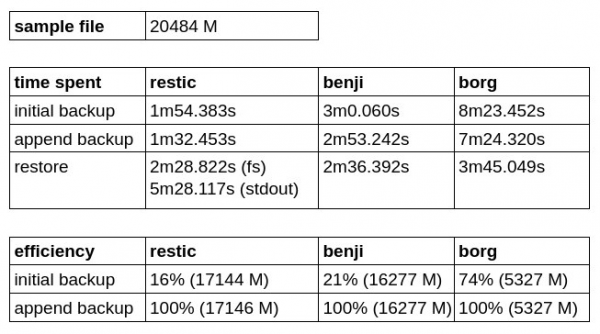
Como podemos notar, o Borg Backup tem o melhor coeficiente de eficiência para o backup inicial, mas perde em velocidade tanto na gravação quanto na recuperação.
O Restic se mostrou mais rápido que o Benji Backup, mas leva mais tempo para recuperar no stdout, e escrever diretamente em um dispositivo de bloco, infelizmente, ainda não é possível.
Pesando todos os prós e contras, decidi ficar com restic com rest-server como a solução mais conveniente e promissora para backup.
Neste screencast, você pode ver como um canal de 10 gigabits é totalmente utilizado durante várias operações de backup executadas simultaneamente. Vale notar que a utilização dos discos não ultrapassa 30% nesse caso.
Fiquei mais do que satisfeito com a solução obtida!
Fonte: habr.com
