

Olá, Habr! Nos últimos dois meses, vivemos uma situação muito interessante e gostaria de compartilhar nossa história sobre a escalabilidade da infraestrutura. Durante esse tempo, o SberMarket cresceu quatro vezes em pedidos e lançou o serviço em 17 novas cidades. O crescimento explosivo na demanda por entrega de produtos exigiu que escalássemos nossa infraestrutura. Leia mais sobre as conclusões mais interessantes e úteis abaixo.
Meu nome é Dima Bobylev, sou o diretor técnico do SberMarket. Como este é o primeiro post em nosso blog, vou dizer algumas palavras sobre mim e sobre a empresa. No outono passado, participei do concurso de jovens líderes da Runet. Para a competição, eu sobre como vemos a cultura interna e a abordagem ao desenvolvimento do serviço no SberMarket. E embora não tenha conseguido ganhar o concurso, pude formular os princípios fundamentais para o desenvolvimento do ecossistema de TI.
Ao gerenciar uma equipe, é importante entender e encontrar um equilíbrio entre o que o negócio precisa e as necessidades de cada desenvolvedor específico. Neste momento, o SberMarket está crescendo 13 vezes ano a ano, e isso impacta o produto, exigindo um aumento constante nos volumes e ritmos de desenvolvimento. Apesar disso, dedicamos tempo suficiente aos desenvolvedores para análise prévia e escrita de código de qualidade. A abordagem estabelecida ajuda não apenas na criação de um produto funcional, mas também em sua escalabilidade e desenvolvimento futuros. Como resultado desse crescimento, o SberMarket já se tornou líder entre os serviços de entrega de produtos: entregamos cerca de 18 mil pedidos por dia, embora no início de fevereiro estivéssemos na casa de 3.500.
Certa vez, um cliente pediu ao entregador do SberMarket que entregasse os produtos de forma sem contato — diretamente na varanda.
Mas vamos aos detalhes. Nos últimos meses, temos trabalhado ativamente na escalabilidade da infraestrutura da nossa empresa. Essa necessidade foi explicada por fatores internos e externos. Ao mesmo tempo em que a base de clientes cresceu, o número de lojas conectadas aumentou de 90 no início do ano para mais de 200 em meados de maio. Claro, estávamos preparados, reservamos a infraestrutura principal e planejamos a possibilidade de escalabilidade vertical e horizontal de todas as máquinas virtuais hospedadas na nuvem do Yandex. No entanto, a prática mostrou: "Tudo o que pode dar errado, dará errado". E hoje quero compartilhar as situações mais curiosas que ocorreram nessas semanas. Espero que nossa experiência seja útil para você.
Slave em plena prontidão de combate
Já antes do início da pandemia, enfrentamos um aumento no número de solicitações para nossos servidores de backend. A tendência de solicitar produtos com entrega em casa começou a ganhar força, e com a implementação das primeiras medidas de isolamento social devido ao COVID-19, a carga aumentava dramaticamente ao longo do dia. Surgiu a necessidade de descarregar rapidamente os servidores master do banco de dados principal e mover parte das solicitações de leitura para servidores-replica (slave).
Nos preparamos para essa etapa, e para essa manobra já tinhamos 2 servidores slave em funcionamento. Neles, principalmente, eram executadas tarefas em lotes para a geração de feeds de informação para troca de dados com os parceiros. Esses processos criavam uma carga extra e, de maneira justa, foram excluídos "da conta" alguns meses antes.
Como a replicação ocorria no Slave, seguimos a ideia de que os aplicativos poderiam operar com eles apenas em modo somente leitura. O plano de recuperação de desastres previa que, em caso de catástrofe, poderíamos simplesmente montar o Slave no lugar do Master e redirecionar todas as solicitações de gravação e leitura para o Slave. No entanto, também queríamos usar as réplicas para as necessidades do departamento de análise, então os servidores não foram totalmente transformados em status somente leitura, e cada host teve seu próprio conjunto de usuários, alguns com permissões de gravação para salvar resultados intermediários dos cálculos.
Até um certo nível de carga, conseguíamos usar o mestre tanto para gravação quanto para leitura ao processar solicitações http. Em meados de março, exatamente quando o Sbermarket decidiu passar completamente para o remoto, começamos a ter um crescimento exponencial de RPS. Cada vez mais clientes estavam se isolando ou trabalhando de casa, o que afetou os índices de carga.
A performance do ‘mestre’ não foi mais suficiente, então começamos a transferir parte das consultas de leitura mais pesadas para a réplica. Para direcionar as solicitações de gravação para o mestre e as de leitura para o slave, usamos a gem ruby “”. Criamos um usuário especial com o sufixo _readonly, sem permissões de gravação. Porém, devido a um erro na configuração de um dos hosts, parte das solicitações de gravação foi para o slave sob o nome de um usuário que tinha as permissões adequadas.
O problema não se manifestou imediatamente, pois a carga aumentada fez com que os slaves ficassem atrasados. A inconsistência de dados foi descoberta pela manhã, quando, após as importações noturnas, os slaves não “alcancaram” o mestre. Atribuímos isso à alta carga no próprio serviço e às importações associadas ao início de novas lojas. No entanto, entregar dados com horas de atraso era inaceitável, então mudamos os processos para o segundo slave analítico, pois ele tinha mais recursos e não estava sobrecarregado com solicitações de leitura (o que explicamos a nós mesmos como a ausência de latência na replicação).maiorQuando entendemos as razões do “desvio” do slave principal, o analítico já estava fora de serviço pela mesma razão. Apesar de termos dois servidores adicionais, para os quais planejamos transferir a carga em caso de falha do mestre, devido a um erro lamentável, no momento crítico não havia nenhum deles.
Mas, como estávamos fazendo não apenas o dump do banco de dados (o restauro naquele momento levava cerca de 5 horas), mas também o snapshot do servidor mestre, conseguimos iniciar a réplica em um prazo de 2 horas. No entanto, após isso, teríamos que lidar com a aplicação do log de replicação por um longo período (porque o processo ocorre em modo de thread única, mas isso já é outra história).
Mas, como não fizemos apenas o dump do banco de dados (a restauração na época levava cerca de 5 horas), mas também um snapshot do servidor master, conseguimos iniciar a réplica em 2 horas. Contudo, depois disso, enfrentamos o processo de aplicação do log de replicação durante um longo período (porque o processo ocorre em modo de thread única, mas isso já é uma história completamente diferente).
Conclusão: Após esse incidente, ficou claro que precisaríamos abandonar a prática de restringir a gravação para os usuários e declarar todo o servidor como somente leitura. Com essa abordagem, não há dúvida de que as réplicas estarão disponíveis no momento crítico.
A otimização até mesmo de uma única consulta pesada pode "reviver" o banco de dados.
Embora atualizemos constantemente o catálogo do site, as consultas que realizávamos nos servidores Slave apresentavam um pequeno atraso em relação ao Master. O tempo que levamos para identificar e resolver o problema dos "slaves" que "deixaram a corrida" foi maior do que o "barreira psicológica" (durante esse tempo, a atualização de preços poderia ter ocorrido, deixando os clientes vendo dados desatualizados), e fomos forçados a redirecionar todas as consultas para o servidor principal do banco de dados. Como resultado, o site funcionou lentamente... mas pelo menos estava funcionando. E enquanto os Slaves se recuperavam, não tivemos escolha a não ser otimizar.
Enquanto os servidores Slave se recuperavam, os minutos se arrastavam lentamente, o Master permanecia sobrecarregado, e dedicamos todos os esforços para otimizar as tarefas ativas de acordo com a "Regra de Pareto": escolhemos as principais consultas que geravam a maior parte da carga e começamos o ajuste. Isso foi feito em tempo real.
Um efeito interessante foi que o MySQL, completamente carregado, respondia a mesmo a uma leve melhoria nos processos. A otimização de algumas consultas que representavam apenas 5% da carga total já mostrava uma redução significativa na CPU. Como resultado, conseguimos garantir uma margem de recursos aceitável para o funcionamento do Master com o banco de dados e obter o tempo necessário para a recuperação das réplicas.
Conclusão: Mesmo uma pequena otimização permite que "sobrevivamos" à sobrecarga por várias horas. Isso foi exatamente o que precisamos durante o tempo de recuperação dos servidores com réplicas. A propósito, discutiremos o aspecto técnico da otimização das consultas em um dos próximos posts. Portanto, assine nosso blog se isso lhe for útil.
Organize a monitorização da operabilidade dos serviços parceiros.
Nós tratamos de pedidos de clientes e, por isso, nossos serviços interagem constantemente com APIs de terceiros — que são gateways para envio de SMS, plataformas de pagamento, sistemas de roteamento, geocodificadores, serviços da Receita Federal e muitas outras sistemas. E quando a carga começou a aumentar rapidamente, começamos a enfrentar as limitações das APIs dos nossos serviços parceiros, sobre as quais antes nem pensávamos.
Um excesso inesperado das quotas dos serviços parceiros pode levar à inatividade do seu próprio. Muitas APIs bloqueiam clientes que excedem os limites, e em alguns casos, o excesso de requisições pode sobrecarregar a produção do parceiro.
Por exemplo, em um momento de aumento no número de entregas, os serviços de apoio não conseguiam lidar com as tarefas de distribuição e definição de rotas. Como resultado, tínhamos pedidos feitos, mas o serviço que cria a rota não estava funcionando. É preciso dizer que nossos logistas fizeram praticamente o impossível nessas condições, e a interação clara da equipe ajudou a compensar as falhas temporárias dos serviços. Porém, tal volume de pedidos não pode ser tratado manualmente de forma constante, e em algum momento estaríamos enfrentando uma ruptura inaceitável entre os pedidos e sua execução.
Uma série de medidas organizacionais foi adotada, e o trabalho em equipe ajudou a ganhar tempo enquanto negociávamos novas condições e aguardávamos a modernização dos serviços de alguns parceiros. Existem outras APIs que oferecem alta resistência e tarifas exorbitantes em caso de alto tráfego. Por exemplo, inicialmente usávamos uma API de mapeamento conhecida para determinar o endereço do ponto de entrega. Mas no final do mês, recebemos uma conta bastante elevada, quase 2 milhões de rublos. Depois disso, decidimos rapidamente substituí-la. Não vou fazer propaganda, mas posso dizer que nossas despesas diminuíram significativamente.
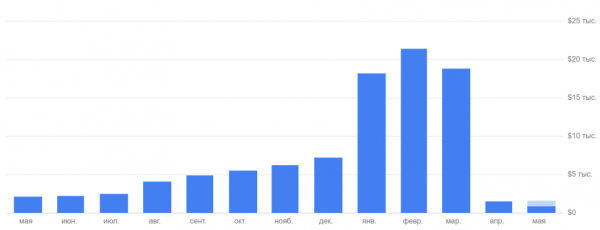
Conclusão: É absolutamente necessário monitorar as condições de operação de todos os serviços parceiros e tê-las em mente. Mesmo que hoje pareça que eles têm 'um grande espaço', isso não significa que amanhã não se tornem um obstáculo para o crescimento. E, claro, é melhor negociar as condições financeiras para aumento das demandas ao serviço com antecedência.
Às vezes, acaba sendo que "" (c) não ajuda
Estamos acostumados a "gargalos" no banco de dados principal ou nos servidores de aplicativos, mas ao escalar, problemas podem surgir onde menos se espera. Para a busca de texto completo no site, usamos o motor Apache Solr. Com o aumento da carga, notamos uma diminuição no tempo de resposta, e a carga do processador do servidor chegou a 100%. O que pode ser mais simples — vamos fornecer mais recursos ao contêiner com Solr.
Em vez do ganho de desempenho esperado, o servidor simplesmente "morreu". Ele imediatamente carregou a 100% e respondeu ainda mais lentamente. Inicialmente, tínhamos 2 núcleos e 2 GB de RAM. Decidimos fazer o que geralmente ajuda — proporcionamos ao servidor 8 núcleos e 32 GB. Tudo ficou muito pior (como exatamente e por que — contaremos em um post separado).
Em poucos dias, descobrimos as sutilezas dessa questão e conseguimos um desempenho otimizado com 8 núcleos e 32 GB de RAM. Essa configuração permite, até hoje, continuar aumentando a carga, o que é muito importante, pois o crescimento não vem apenas pelo número de clientes, mas também pela quantidade de lojas conectadas — em 2 meses, seu número dobrou.
Conclusão: Métodos padrão como "adicionar mais hardware" nem sempre funcionam. Portanto, ao escalar qualquer serviço, é necessário entender bem como ele utiliza recursos e testar seu funcionamento antecipadamente em novas condições.
Stateless — a chave para escalabilidade horizontal simples.
No geral, nossa equipe adota a abordagem conhecida: os serviços não devem ter estado interno (stateless) e devem ser independentes do ambiente de execução. Isso nos permitiu suportar o aumento da carga com uma simples escalabilidade horizontal. Mas tínhamos um serviço exceção – um processador de longas tarefas em segundo plano. Ele lidava com envio de email e sms, processamento de eventos, geração de feeds, importação de preços e estoques, processamento de imagens. Ocorreu que ele dependia do armazenamento de arquivos local e estava em uma única instância.
Quando o número de tarefas na fila do processador cresceu (o que aconteceu naturalmente com o aumento do volume de pedidos), a performance do host que hospedava o processador e o armazenamento de arquivos se tornou um fator limitante. Como resultado, a atualização do sortimento e dos preços, o envio de notificações para os usuários e muitas outras funções críticas ficaram paradas na fila. A equipe de operações migrou rapidamente o armazenamento de arquivos para um armazenamento em rede semelhante ao S3, o que nos permitiu implantar várias máquinas poderosas para escalar o processador de tarefas em segundo plano.
Conclusão: A regra Stateless deve ser seguida por todos os componentes sem exceção, mesmo que pareça "que aqui não teremos problemas". É melhor gastar um pouco de tempo organizando corretamente o funcionamento de todos os sistemas do que depois, na pressa, reescrever o código e consertar o serviço que está enfrentando sobrecarga.
7 princípios para crescimento intenso
Apesar da disponibilidade de recursos adicionais, durante o crescimento encontramos vários obstáculos. Nesse período, o número de pedidos aumentou mais de 4 vezes. Atualmente, já estamos entregando mais de 17.000 pedidos por dia em 62 cidades e planejamos expandir ainda mais a geografia — no primeiro semestre de 2020, esperamos lançar o serviço em toda a Rússia. Para lidar com a crescente carga, levando em conta os erros que já cometemos, estabelecemos 7 princípios fundamentais de funcionamento em condições de crescimento constante:
- Gerenciamento de Incidentes. Criamos um quadro no Jira, onde cada incidente é refletido na forma de um ticket. Isso ajudará a priorizar efetivamente e a realizar tarefas relacionadas ao incidente. Afinal, a essência do problema não é errar — é errar duas vezes pela mesma razão. Para os casos em que os incidentes se repetem antes que a causa possa ser corrigida, deve haver um guia de ações preparado, pois durante uma alta carga é importante reagir rapidamente.
- Monitoramento é necessário para todos os elementos da infraestrutura, sem exceção. Graças a ele, conseguimos prever o aumento da carga e escolher corretamente os "gargalos" para priorizar a resolução. É muito provável que, em alta carga, tudo o que você nem pensou que poderia falhar ou começar a apresentar lentidão. Portanto, é melhor criar novos alertas logo após os primeiros incidentes, para monitorá-los e antecipá-los.
- Alertas corretos são simplesmente necessários em caso de aumento repentino da carga. Em primeiro lugar, eles devem informar exatamente o que quebrou. Em segundo lugar, não deve haver muitos alertas, pois a abundância de alertas não críticos leva à ignorância de todas as notificações.
- As aplicações devem ser stateless. Nós confirmamos que essa regra não deve ter exceções. É necessária total independência do ambiente de execução. Para isso, você pode armazenar dados compartilhados em um banco de dados ou, por exemplo, diretamente no S3. E ainda melhor é seguir as regras. Durante um aumento repentino, não há tempo para otimizar o código, e você terá que lidar com a carga aumentando diretamente os recursos de computação e escalonamento horizontal.
- Cotas e desempenho de serviços externos. Com o crescimento rápido, o problema pode surgir não apenas na sua infraestrutura, mas também no serviço externo. O mais frustrante é quando isso ocorre não por falha, mas devido ao alcance de cotas ou limites. Portanto, os serviços externos devem escalar tão bem quanto você.
- Separe os processos e filas. Isso ajuda muito quando ocorre um congestionamento em um dos gateways. Não teríamos atrasos na transmissão de dados se as filas de envio de SMS cheias não interferissem na troca de notificações entre os sistemas de informação. E o número de trabalhadores seria mais fácil de aumentar se eles trabalhassem separadamente.
- Realidades financeiras. Quando há um crescimento explosivo dos fluxos de dados, não há tempo para pensar em tarifas e assinaturas. Mas é preciso lembrar deles, especialmente se você for uma pequena empresa. Uma grande conta pode ser cobrada por qualquer proprietário de API, assim como pelo seu provedor de hospedagem. Portanto, é importante ler os contratos com atenção.
Conclusão
Sem grandes perdas, superamos essa fase e hoje nos esforçamos para seguir todos os princípios encontrados, com cada máquina tendo a capacidade de aumentar seu desempenho em até 4 vezes, para lidar com algumas surpresas inesperadas.
Nos próximos posts, compartilharemos nossa experiência em investigar a queda de desempenho no Apache Solr, além de falarmos sobre a otimização de consultas e como a interação com a FNS ajuda a empresa a economizar dinheiro. Siga nosso blog para não perder nada e nos conte nos comentários se você já enfrentou problemas semelhantes durante o aumento de tráfego.
Apenas usuários registrados podem participar da pesquisa. , por favor.
Você já experimentou lentidão/queda de serviço devido a um aumento repentino de carga por causa de:
55,6%Incapacidade de adicionar rapidamente recursos computacionais10
16,7%Limitações da infraestrutura do provedor de hospedagem3
33,3%Limitações de APIs de terceiros6
27,8%Violação dos princípios stateless de suas aplicações5
88,9%Não otimização do código de seus próprios serviços16
18 usuários votaram. 6 usuários se abstiveram.
Fonte: habr.com
