

Olá a todos! Temos ótimas notícias, em junho, a OTUS novamente irá lançar um curso , e por isso, tradicionalmente, compartilhamos com vocês materiais úteis.
Se você se deparou com toda essa história de microsserviços sem qualquer contexto, é compreensível que a considere um pouco estranha. Dividir um aplicativo em fragmentos conectados por uma rede inevitavelmente implica a adição de modos complexos de resiliência à falha no sistema distribuído resultante.
Embora essa abordagem envolva a divisão em muitos serviços independentes, o objetivo final é muito maior do que apenas a operação desses serviços em máquinas diferentes. Estamos falando sobre a interação com o mundo ao nosso redor, que em essência também é distribuído. Não no sentido técnico, mas mais em termos de um ecossistema composto por várias pessoas, equipes, programas, e cada uma dessas partes deve, de alguma forma, realizar seu trabalho.
As empresas, por exemplo, representam um conjunto de sistemas distribuídos que, em conjunto, ajudam a alcançar um determinado objetivo. Ignoramos esse fato por décadas, buscando a unificação, transferindo arquivos via FTP ou utilizando ferramentas de integração corporativa, enquanto nos concentrávamos em nossos próprios objetivos isolados. Mas, com a chegada dos serviços, tudo mudou. Os serviços nos ajudaram a olhar além do horizonte e ver um mundo de programas interdependentes que trabalham em conjunto. No entanto, para ter sucesso, é necessário compreender e projetar dois mundos fundamentalmente diferentes: o mundo externo, onde vivemos em um ecossistema de muitos outros serviços, e nosso próprio mundo interno, onde governamos sozinhos.
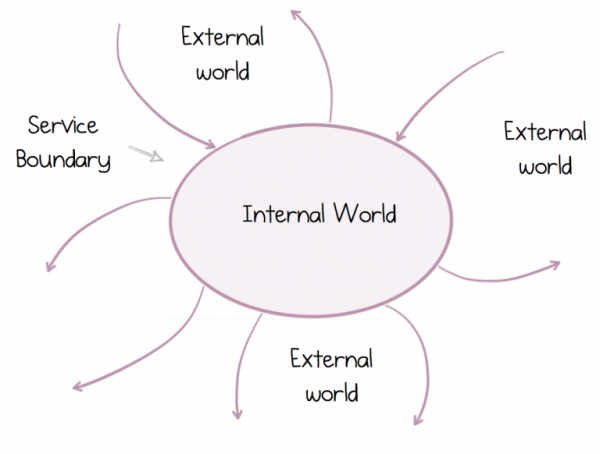
Esse mundo distribuído é diferente daquele em que crescemos e ao qual estamos acostumados. Os princípios de construção da arquitetura monolítica tradicional não resistem a qualquer crítica. Portanto, uma compreensão correta de tais sistemas é algo mais do que criar um ótimo diagrama em um quadro branco ou uma prova de conceito impressionante. Trata-se de garantir que tal sistema funcione com sucesso por um longo tempo. Felizmente, os serviços existem há bastante tempo, embora apresentem aparências diferentes. ainda são relevantes, mesmo temperadas com Docker, Kubernetes e levemente desgastadas por barbas de hipster.
Então, hoje vamos analisar como as regras mudaram, por que precisamos repensar nossa abordagem em relação aos serviços e os dados que eles trocam entre si, e por que precisaremos de um conjunto de ferramentas completamente diferente para isso.
A encapsulação nem sempre será sua amiga
Os microsserviços podem operar independentemente uns dos outros. É essa característica que lhes confere o maior valor. Essa mesma propriedade permite que os serviços escalem e cresçam. Não tanto em termos de escalar para quadrilhões de usuários ou petabytes de dados (embora possam ajudar aqui também), mas em termos de escalar em relação às pessoas, à medida que equipes e organizações crescem continuamente.
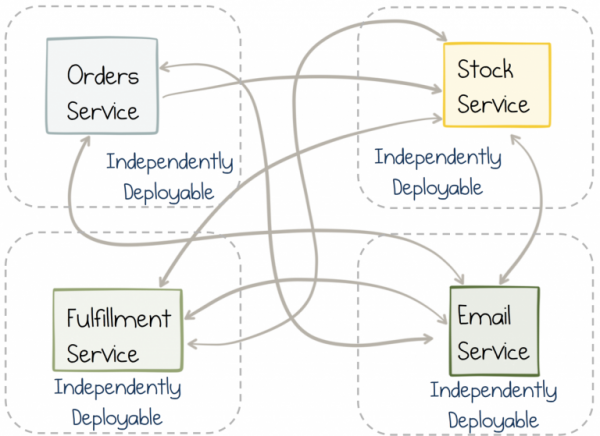
No entanto, a independência é uma faca de dois gumes. Ou seja, um serviço pode rodar de forma fácil e despreocupada por si só. Mas se dentro do serviço for implementada uma função que requer a utilização de outro serviço, acabamos tendo que fazer alterações em ambos os serviços quase simultaneamente. Em um monolito, isso é fácil; você simplesmente faz a alteração e envia para o release, enquanto na sincronização de serviços independentes há mais problemas. A coordenação entre equipes e ciclos de releases destrói a flexibilidade.
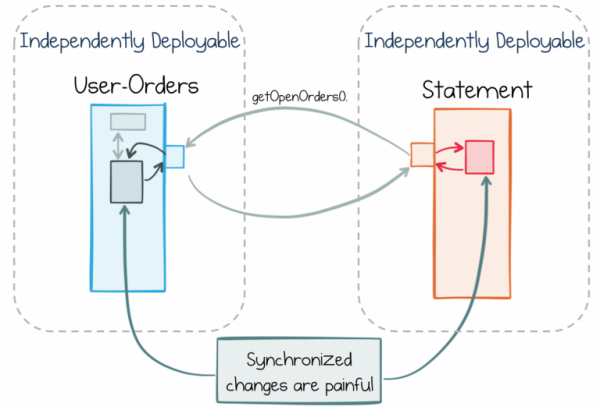
Dentro da abordagem padrão, mudanças indesejadas são geralmente evitadas, separando claramente as funcionalidades entre os serviços. Um serviço de entrada única no sistema pode ser um bom exemplo disso. Ele desempenha um papel bem definido que o distingue de outros serviços. Essa clara separação significa que, em um mundo de requisitos em rápida mudança em relação aos serviços ao seu redor, o serviço de entrada única no sistema dificilmente mudará. Ele existe dentro de um contexto rigorosamente limitado.
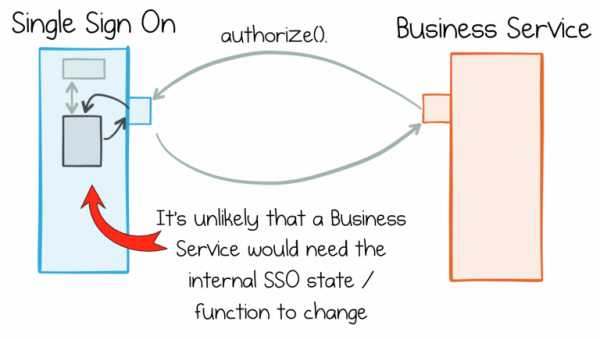
O problema é que, no mundo real, os serviços de negócios não conseguem manter uma separação de funções consistentemente clara. Por exemplo, os próprios serviços de negócios, em grande parte, trabalham com dados recebidos de outros serviços semelhantes. Se você está no varejo online, o processamento de pedidos, o catálogo de produtos ou as informações dos usuários se tornam requisitos para muitos de seus serviços. Cada um dos serviços necessitará de acesso a esses dados para operar.
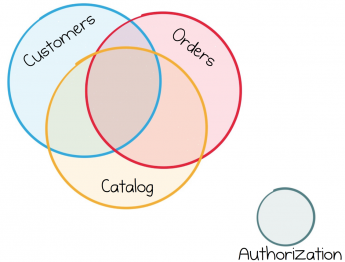
A maioria dos serviços de negócios utiliza o mesmo fluxo de dados, por isso seu funcionamento se entrelaça inevitavelmente.
Assim, chegamos a um ponto importante que merece ser discutido. Enquanto os serviços funcionam bem para componentes da infraestrutura que operam em grande parte de forma isolada, a maioria dos serviços de negócios está mais entrelaçada do que se imagina.
Dicotomia de dados
Embora já existam abordagens orientadas a serviços, ainda há pouca informação sobre como trocar grandes volumes de dados entre os serviços.
O principal problema reside no fato de que dados e serviços são inseparáveis. Por um lado, a encapsulação nos incentiva a esconder dados, para que os serviços possam ser separados uns dos outros, facilitando seu crescimento e futuras modificações. Por outro lado, precisamos ser capazes de compartilhar e controlar dados comuns livremente, assim como temos em qualquer outro sistema de informação. Trata-se de poder começar a trabalhar imediatamente, assim como em qualquer outro sistema de informação.
No entanto, sistemas de informação têm pouco em comum com a encapsulação. Na verdade, é quase o oposto. Os bancos de dados fazem de tudo para fornecer acesso aos dados que armazenam. Eles vêm com uma interface declarativa poderosa que permite modificar os dados como você precisar. Essa funcionalidade é importante na fase de pesquisa inicial, mas não para gerenciar a crescente complexidade de um serviço em constante evolução.
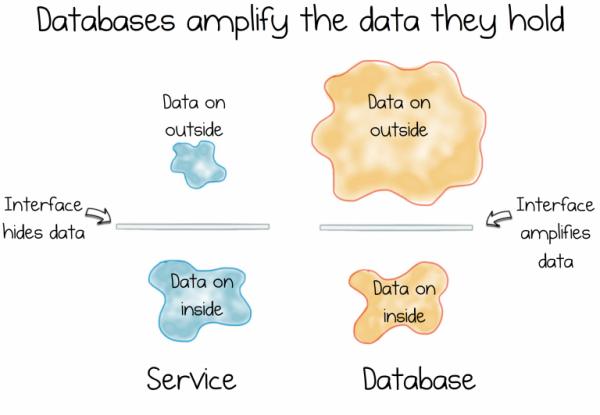
E aqui surge a dilema. A contradição. A dicotomia. Afinal, sistemas de informação são sobre fornecer dados, enquanto serviços são sobre ocultação.
Estas duas forças são fundamentais. Elas estão na base da maior parte de nosso trabalho, lutando constantemente pela supremacia nos sistemas que criamos.
À medida que os sistemas de serviço crescem e evoluem, vemos diferentes manifestações das consequências da dicotomia de dados. Ou a interface do serviço cresce, oferecendo um conjunto cada vez mais amplo de funções e começa a parecer uma base de dados caseira muito peculiar, ou nos deparamos com frustrações e encontramos alguma maneira de extrair ou mover conjuntos inteiros de dados de um serviço para outro.
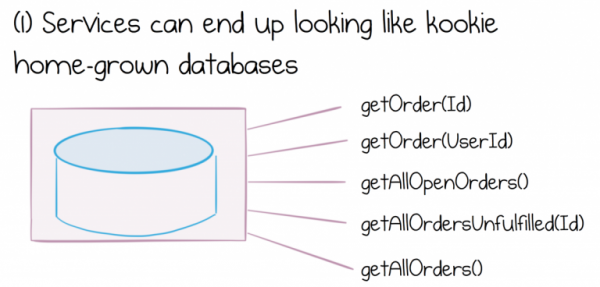
Por sua vez, criar algo que pareça uma base de dados caseira peculiar levará a uma série de problemas. Não vamos entrar em detalhes sobre os riscos da shared database, apenas diremos que ela representa consideráveis dificuldades de engenharia e operacionais Pior ainda, os volumes de dados exacerbam os problemas nas fronteiras dos serviços. Quanto mais dados compartilhados existem dentro de um serviço, mais complicada a interface se tornará e mais difícil será combinar conjuntos de dados provenientes de diferentes serviços.
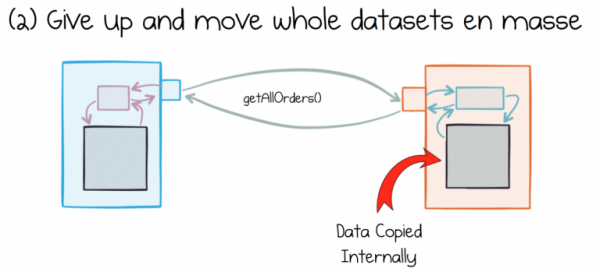
Uma abordagem alternativa de extração e movimentação de conjuntos inteiros de dados também apresenta seus próprios problemas. A abordagem comum para essa questão se parece com a simples extração e armazenamento de um conjunto de dados inteiro, seguido de seu armazenamento local em cada serviço consumidor.
O problema é que diferentes serviços interpretam os dados que consomem de maneiras distintas. Esses dados estão sempre ao alcance. Eles mudam e são processados localmente. Rapidamente, eles perdem qualquer semelhança com os dados da fonte.
Quanto mais mutáveis as cópias, mais os dados divergirão ao longo do tempo.
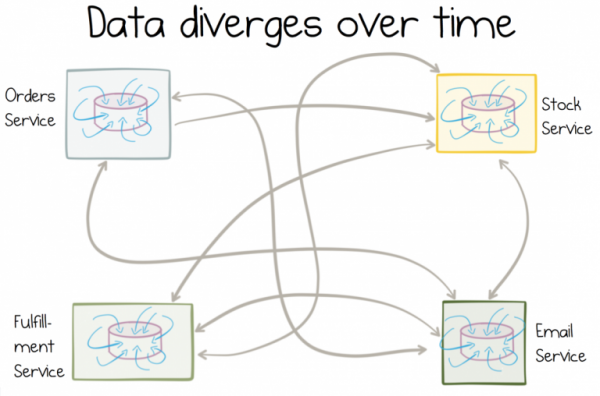
O que é ainda pior, esses dados são difíceis de corrigir retrospectivamente (
MDM Para encontrar uma solução para o problema dos dados compartilhados, é necessário pensar de forma diferente. Eles devem se tornar objetos de primeira classe nas arquiteturas que construímos.
Pat Helland classifica esses dados como 'externos', e essa é uma característica muito importante. Precisamos de encapsulamento para não revelar a estrutura interna do serviço, mas devemos facilitar o acesso a dados compartilhados para que os serviços possam realizar seu trabalho adequadamente.
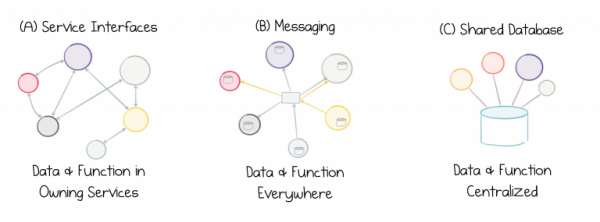
O problema é que nenhuma das abordagens atuais é relevante, pois nem as interfaces de serviço, nem a troca de mensagens, nem o Banco de Dados Compartilhado oferecem uma boa solução para trabalhar com dados externos. As interfaces de serviço são mal adaptadas para a troca de dados em qualquer escala. A troca de mensagens move dados, mas não mantém seu histórico, portanto, com o tempo, os dados se corrompem. Os Bancos de Dados Compartilhados se concentram demais em um único ponto, o que impede o progresso. Inevitavelmente, ficamos presos em um ciclo de falência de dados:
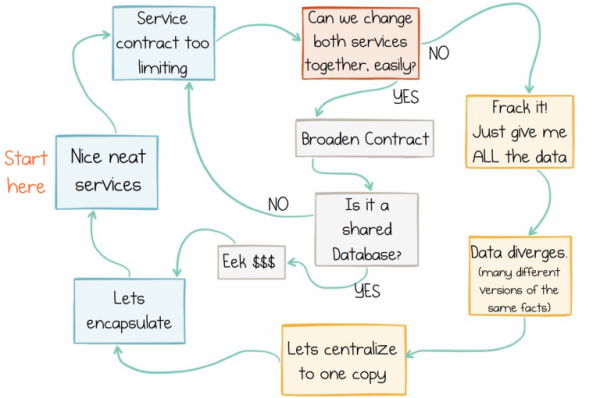
Ciclo de falência de dados
Fluxos: abordagem descentralizada para dados e serviços
Idealmente, precisamos mudar a abordagem de como os serviços trabalham com dados comuns. No momento, qualquer abordagem enfrenta a dicotomia mencionada acima, pois não existe nenhuma 'poção mágica' que possa ser generosamente aplicada para fazer isso desaparecer. No entanto, podemos repensar o problema e chegar a um compromisso.
Esse compromisso implica um certo grau de centralização. Podemos aproveitar o mecanismo de logs distribuídos, pois ele fornece fluxos escaláveis e confiáveis. Agora, precisamos garantir que os serviços possam se conectar e operar esses fluxos compartilhados, mas queremos evitar serviços centralizados complexos que realizem tal processamento. Portanto, a melhor opção é integrar o processamento de fluxos em cada serviço consumidor. Assim, os serviços poderão combinar conjuntos de dados de diferentes fontes e trabalhar com eles conforme necessário.
Uma das maneiras de alcançar tal abordagem é o uso de uma plataforma de streaming. Existem muitas opções, mas hoje vamos considerar o Kafka, pois seu uso de Processamento de Fluxo Stateful permite resolver eficientemente o problema apresentado.
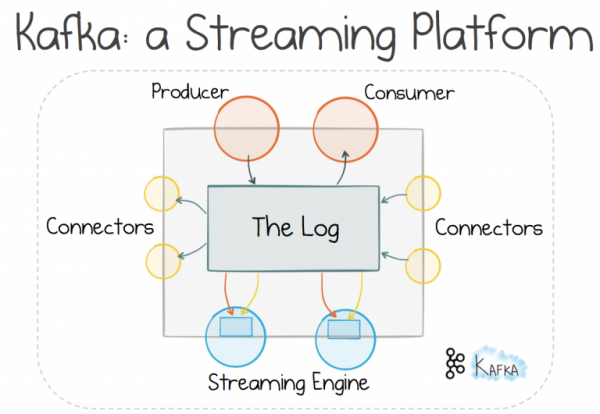
O uso do mecanismo de logging distribuído nos permite seguir um caminho comprovado e usar a troca de mensagens para trabalhar com . Acredita-se que essa abordagem oferece melhor escalabilidade e separação do que o mecanismo de "request-response", uma vez que dá controle do fluxo ao destinatário, não ao remetente. No entanto, tudo na vida tem seu preço, e aqui você precisará de um broker. Mas, para sistemas grandes, esse compromisso vale a pena (o que não se pode dizer sobre suas aplicações web médias).
Se o broker é responsável pela logação distribuída, e não um sistema tradicional de troca de mensagens, é possível aproveitar funcionalidades adicionais. O transporte pode ser escalado linearmente tão bem quanto um sistema de arquivos distribuído. Os dados podem ser armazenados nos logs por um tempo considerável, portanto, obtemos não apenas troca de mensagens, mas também armazenamento de informações. Armazenamento escalável sem temor de afetar um estado compartilhado mutável.
Em seguida, pode-se utilizar um mecanismo de processamento de fluxo stateful (processamento de fluxo com estado) para adicionar ferramentas de banco de dados declarativas aos serviços consumidores. Este é um pensamento muito importante. Enquanto os dados estiverem armazenados em fluxos comuns, que todos os serviços podem acessar, a agregação e o processamento realizados pelo serviço são privados. Eles ficam isolados dentro de um contexto estritamente limitado.
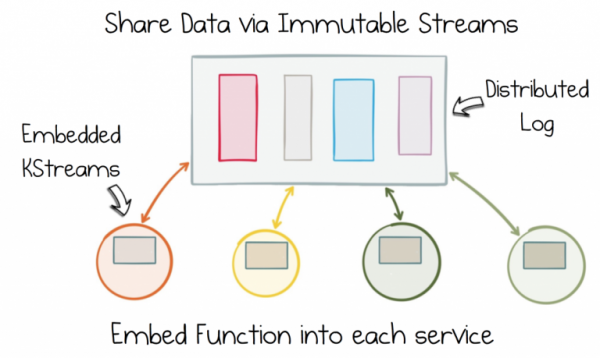
Elimine a dicotomia dos dados, separando o fluxo de estados imutáveis. Em seguida, adicione essa função a cada serviço por meio do Stateful Stream Processing.
Assim, se seu serviço precisa trabalhar com pedidos, catálogo de produtos, estoque, ele terá acesso total: você será o único a decidir quais dados agregar, onde processá-los e como eles devem mudar ao longo do tempo. Embora os dados sejam comuns, o trabalho com eles é totalmente descentralizado. Ele é realizado dentro de cada serviço, em um mundo onde tudo opera sob suas regras.
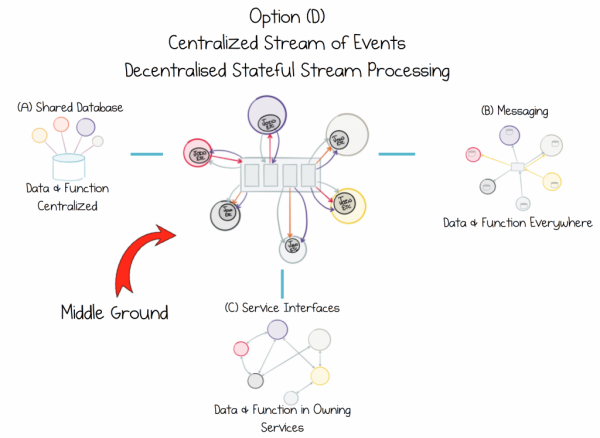
Compartilhe dados de forma que sua integridade não seja comprometida. Incorpore a função, não a fonte, em cada serviço que precisar dela.
Às vezes, é necessário mover dados em massa. Às vezes, o serviço requer um conjunto histórico local de dados no banco de dados selecionado. O foco é que é possível garantir que, quando necessário, uma cópia possa ser restaurada da fonte por meio da chamada ao mecanismo de registro distribuído. Os conectores no Kafka fazem isso muito bem.
Assim, a abordagem discutida hoje tem várias vantagens:
- Os dados são utilizados como fluxos comuns, que podem ser armazenados por longos períodos nos logs, e o próprio mecanismo de trabalho com dados compartilhados é incorporado em cada contexto específico, permitindo que os serviços operem de forma ágil e rápida. Dessa maneira, a dicotomia dos dados pode ser equilibrada.
- Os dados de diferentes serviços podem ser facilmente combinados em conjuntos. Isso simplifica a interação com dados compartilhados e elimina a necessidade de manter conjuntos de dados locais no banco de dados.
- O Processamento de Fluxo com Estado apenas armazena dados em cache, enquanto os logs comuns permanecem como fonte da verdade, portanto, o problema da corrupção de dados ao longo do tempo não é tão crítico.
- Essencialmente, os serviços são geridos por dados, ou seja, apesar do constante aumento dos volumes de dados, os serviços ainda conseguem responder rapidamente a eventos de negócios.
- Os problemas de escalabilidade são atribuições do broker, não dos serviços. Assim, reduz-se significativamente a complexidade na escrita de serviços, já que não é necessário se preocupar com a escalabilidade.
- A adição de novos serviços não requer alterações nos antigos, tornando a integração de novos serviços mais fácil.
Como você pode ver, isso é mais do que apenas REST. Obtivemos um conjunto de ferramentas que permite trabalhar com dados compartilhados de forma descentralizada.
No artigo de hoje, longe de todos os aspectos terem sido abordados. Precisamos ainda decidir como balancear entre a paradigma de ‘pedido-resposta’ e a paradigma orientada a eventos. Mas isso discutiremos na próxima vez. Existem tópicos que precisamos explorar melhor, como as vantagens do Processamento de Fluxo com Estado. Vamos falar sobre isso no terceiro artigo. E há outras estruturas poderosas que podemos aproveitar se as utilizarmos, como . Com isso, as regras do jogo para sistemas de negócios distribuídos são alteradas, uma vez que essa estrutura garante garantias transacionais para de forma escalável. Este será o tema do quarto artigo. E, finalmente, precisamos passar pelos detalhes da implementação desses princípios.
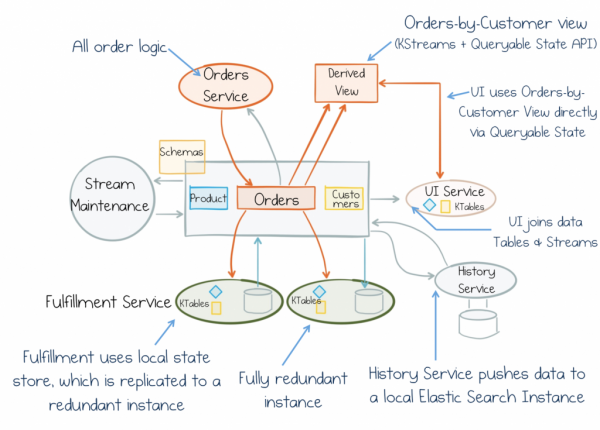
Mas, por enquanto, apenas lembre-se do seguinte: a dicotomia de dados é a força com a qual lidamos ao criar serviços de negócios. E devemos ter isso em mente. O foco é inverter tudo de cabeça para baixo e começar a tratar os dados comuns como objetos de primeira classe. O Stateful Stream Processing oferece um compromisso único para isso. Ele evita 'Componentes Deus' centralizados que restringem o progresso. Além disso, proporciona agilidade, escalabilidade e resiliência aos pipelines de streaming de dados e os integra a cada serviço. Assim, podemos nos concentrar no fluxo comum de consciência ao qual qualquer serviço pode se conectar e trabalhar com seus dados. Isso torna os serviços mais escaláveis, intercambiáveis e autônomos. Portanto, eles não apenas parecerão bons em quadros de marcação e na verificação de hipóteses, mas também funcionarão e se desenvolverão por décadas.
Fonte: habr.com
