

Tínhamos 2 sacos de erva, 75 comprimidos de mescalina, um ambiente unix, um repositório docker e uma tarefa de implementar os comandos docker pull e docker push sem o cliente docker.
UPD:
Pergunta: Para que tudo isso?
Resposta: Teste de carga do produto (NÃO usando bash, os scripts são fornecidos para fins educacionais). Decidiu-se não usar o cliente docker para reduzir camadas adicionais (dentro de limites razoáveis) e, consequentemente, emular uma carga mais alta. Assim, eliminamos todas as latências do cliente docker. Obtivemos uma carga relativamente limpa diretamente no produto.
Na artigos foram utilizados as ferramentas GNU versions.
Para começar, vamos entender o que esses comandos fazem.
Então, para que serve o docker pull? Segundo :
"Puxe uma imagem ou um repositório de um registro".
Lá encontramos um link para .
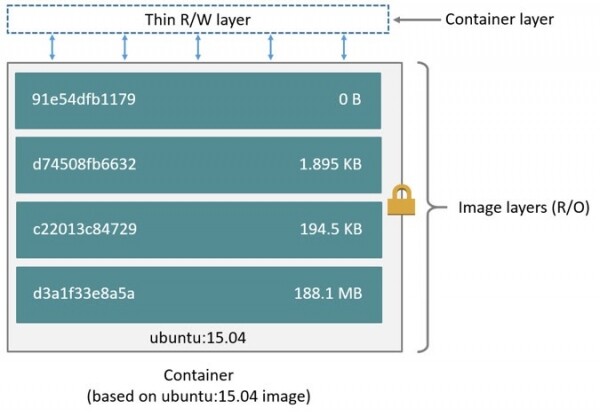
Daqui, podemos entender que a imagem docker é um conjunto de certas camadas, que contêm informações sobre as últimas modificações na imagem, que são obviamente o que precisamos. Depois, olhamos no .
Aqui diz o seguinte:
"Uma 'imagem' é uma combinação de um manifesto JSON e arquivos de camada individuais. O processo de puxar uma > imagem gira em torno da recuperação desses dois componentes."
Então, o primeiro passo segundo a documentação é "Puxando um Manifesto de Imagem”.
Nós não vamos realmente puxá-lo, mas precisamos dos dados dele. Abaixo está um exemplo de requisição: GET /v2/{name}/manifests/{reference}
"Os parâmetros nome e referência identificam a imagem e são obrigatórios. A referência pode incluir uma tag ou digest."
Nosso repositório docker está instalado localmente, vamos tentar fazer a requisição:
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/manifests/1.1.1" -H "header_if_needed"
Na resposta, recebemos um json do qual, por enquanto, estamos interessados apenas nas camadas, mais especificamente seus hashes. Obtendo-os, podemos passar por cada um e fazer a próxima requisição: "GET /v2/{name}/blobs/{digest}"
"O acesso a uma camada será controlado pelo nome do repositório, mas é identificado de forma única no registro pelo digest."
digest, neste caso, é o hash que obtivemos.
Vamos tentar
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/blobs/sha256:f972d139738dfcd1519fd2461815651336ee25a8b54c358834c50af094bb262f" -H "header_if_needed" --output firstLayer
vamos ver que arquivo obtivemos como a primeira camada.
file firstLayer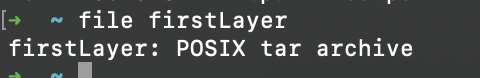
ou seja, as camadas são arquivos tar, extraindo-os na ordem correspondente, obteremos o conteúdo da imagem.
Escreveremos um pequeno script de bash para que tudo isso possa ser automatizado.
#!/bin/bash -eu

downloadDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
imageName=$3
tag=$4

# array of layers
layers=($(curl -s -X GET "$url/v2/$imageName/manifests/$tag" | grep -oP '(?<=blobSum" : ").+(?=")'))

# download each layer from array
for layer in "${layers[@]}"; do
    echo "Downloading ${layer}"
    curl -v -X GET "$url/v2/$imageName/blobs/$layer" --output "$downloadDir/$layer.tar"
done

# find all layers, untar them and remove source .tar files
cd "$downloadDir" && find . -name "sha256:*" -exec tar xvf {} ;
rm sha256:*.tar
exit 0
Agora podemos executá-lo com os parâmetros desejados e obter o conteúdo da imagem necessária
.\/script.sh dirName “http:\/\/localhost:8081\/link\/to\/docker\/registry” myAwesomeImage 1.0Parte 2 — docker push
Aqui será um pouco mais complicado.
Vamos começar novamente com . Portanto, precisamos carregar cada camada, reunir o manifesto correspondente e carregá-lo também. Parece simples.
Estudando a documentação, podemos dividir o processo de upload em várias etapas:
- Inicialização do processo — "POST \/v2\/{repoName}\/blobs\/uploads\/"
- Carregamento da camada (vamos usar upload monolítico, ou seja, cada camada será enviada inteira) — "PUT \/v2\/{repoName}\/blobs\/uploads\/{uuid}?digest={digest}
Content-Length: {tamanho da camada}
Content-Type: application\/octet-stream
Dados Binários da Camada". - Carregamento do manifesto — "PUT \/v2\/{repoName}\/manifests\/{reference}".
Mas a documentação omitiu uma etapa sem a qual nada funcionará. Para o upload monolítico, assim como para o parcial (chunked), antes de carregar a camada, é necessário realizar uma requisição PATCH:
"PATCH \/v2\/{repoName}\/blobs\/uploads\/{uuid}
Content-Length: {tamanho do chunk}
Content-Type: application\/octet-stream
{Dados Binários do Chunk da Camada}".
Caso contrário, você não conseguirá avançar além do primeiro ponto, pois em vez do código de resposta 202 esperado, você receberá 4xx.
Agora, o algoritmo se parece com:
- Inicialização
- Patch da camada
- Upload da camada
- Upload do manifesto
Os pontos 2 e 3, respectivamente, serão repetidos tantas vezes quantas camadas forem necessárias para carregar.
Para começar, precisaremos de qualquer imagem. Eu vou usar archlinux:latest
docker pull archlinux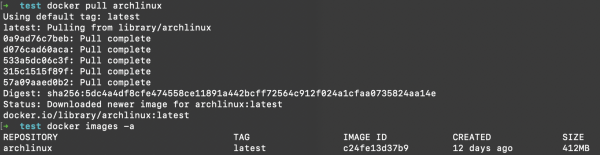
Agora o salvaremos localmente para análise posterior.
docker save c24fe13d37b9 -o savedArch
Vamos descompactar o arquivo obtido no diretório atual.
tar xvf savedArch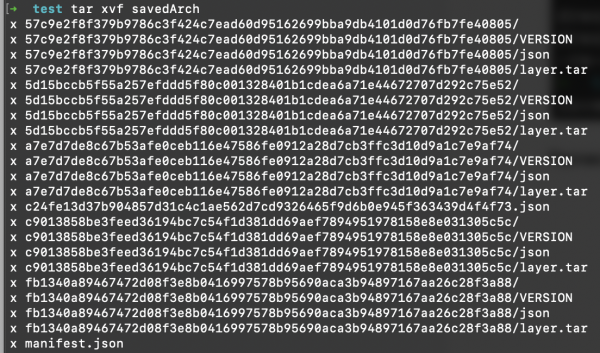
Como podemos ver, cada camada está em uma pasta separada. Agora vamos olhar a estrutura do manifesto que obtivemos.
cat manifest.json | json_pp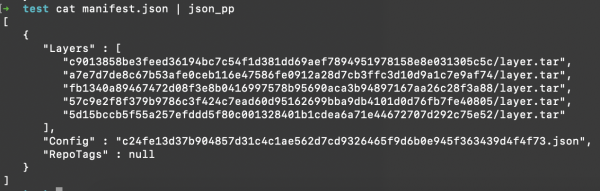
Não é muito. Vamos ver qual manifesto é necessário para o upload, de acordo com .
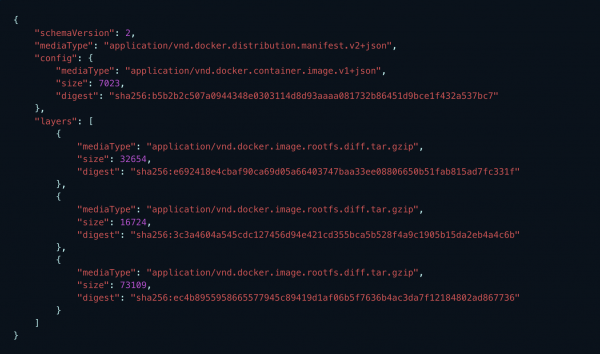
Obviamente, o manifesto existente não nos serve, então vamos fazer o nosso, com camadas e configurações de blackjack e cortesan.
Sempre teremos ao menos um arquivo de configuração e um array de camadas. A versão do esquema é 2 (válida no momento da redação deste artigo), o mediaType permanecerá inalterado:
echo ‘{
   "schemaVersion": 2,
   "mediaType": "application/vnd.docker.distribution.manifest.v2+json",
   "config": {
      "mediaType": "application/vnd.docker.container.image.v1+json",
      "size": config_size,
      "digest": "config_hash"
   },
   "layers": [
      ’ > manifest.json
Após a criação do manifesto básico, é necessário preenchê-lo com dados válidos. Para isso, utilizamos o modelo do objeto JSON da camada:
{
         "mediaType": "application\/vnd.docker.image.rootfs.diff.tar.gzip",
         "size": ${layersSizes[$i]},
         "digest": "sha256:${layersNames[$i]}"
      },
este iremos adicionar ao manifesto para cada camada.
Em seguida, precisamos descobrir o tamanho do arquivo de configuração e substituir os placeholders no manifesto por dados reais.
sed -i "s/config_size/
$configSize/g; s/config_hash/
$configName/g" $manifestFile
Agora podemos iniciar o processo de upload e salvar o uuid, que deve acompanhar todas as solicitações subsequentes.
O script completo é mais ou menos assim:
#!/bin/bash -eux

imageDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
repoName=$3
tag=$4
manifestFile=$(readlink -f ${imageDir}/manifestCopy)
configFile=$(readlink -f $(find $imageDir -name "*.json" ! -name "manifest.json"))

# calc layers sha 256 sum, rename them accordingly, and add info about each to manifest file
function prepareLayersForUpload() {
  info_file=$imageDir/info
  # lets calculate layers sha256 and use it as layers names further
  layersNames=($(find $imageDir -name "layer.tar" -exec shasum -a 256 {} ; | cut -d" " -f1))

  # rename layers according to shasums. !!!Set required amount of fields for cut command!!!
  # this part definitely can be done easier but i didn't found another way, sry
  find $imageDir -name "layer.tar" -exec bash -c 'mv {} "$(echo {} | cut -d"/" -f1,2)/$(shasum -a 256 {} | cut -d" " -f1)"' ;

  layersSizes=($(find $imageDir -name "*.tar" -exec ls -l {} ; | awk '{print $5}'))

  for i in "${!layersNames[@]}"; do
    echo "{
         "mediaType": "application/vnd.docker.image.rootfs.diff.tar.gzip",
         "size": ${layersSizes[$i]},
         "digest": "sha256:${layersNames[$i]}"
      }," >> $manifestFile
  done
  # remove last ','
  truncate -s-2 $manifestFile
  # add closing brakets to keep json consistent
  printf "nt]n}" >> $manifestFile
}

# calc config sha 256 sum and add info about it to manifest
function setConfigProps() {
  configSize=$(ls -l $configFile | awk '{print $5}')
  configName=$(basename $configFile | cut -d"." -f1)

  sed -i "s/config_size/$configSize/g; s/config_hash/$configName/g" $manifestFile
}

#prepare manifest file
prepareLayersForUpload
setConfigProps
cat $manifestFile

# initiate upload and get uuid
uuid=$(curl -s -X POST -I "$url/v2/$repoName/blobs/uploads/" | grep -oP "(?<=Docker-Upload-Uuid: ).+")

# patch layers
# in data-binary we're getting absolute path to layer file
for l in "${!layersNames[@]}"; do
  pathToLayer=$(find $imageDir -name ${layersNames[$l]} -exec readlink -f {} ;)
    curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: ${layersSizes[$i]}"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$pathToLayer"

# put layer
  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:${layersNames[$i]}"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: ${layersSizes[$i]}"
  --data-binary "@$pathToLayer"
done

# patch and put config after all layers
curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: $configSize"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$configFile"

  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:$configName"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: $configSize"
  --data-binary "@$configFile"

# put manifest
curl -v -X PUT "$url/v2/$repoName/manifests/$tag"
  -H 'Content-Type: application/vnd.docker.distribution.manifest.v2+json'
  --data-binary "@$manifestFile"

exit 0
podemos usar um script pronto:
./uploadImage.sh "~\/path\/to\/saved\/image" "http:\/\/localhost:8081\/link\/to\/docker\/registry" myRepoName 1.0UPD:
O que conseguimos como resultado?
Primeiro, dados reais para análise, uma vez que os testes são executados no blazemeter e os dados de solicitações do cliente docker são bastante informativos, ao contrário das solicitações HTTP limpas.
Em segundo lugar, a transição nos permitiu aumentar o número de usuários virtuais para upload do docker em cerca de 150% e, ao mesmo tempo, obter um tempo médio de resposta 20-25% mais rápido. Para o download do docker, foi possível aumentar o número de usuários em 500%, enquanto o tempo médio de resposta caiu cerca de 60%.
Obrigado pela atenção.
Fonte: habr.com
