

Nesta primavera, já discutimos alguns tópicos de introdução, como e . No segundo, até prometemos continuar a explorar o desempenho de várias topologias de múltiplos discos no ZFS. Esta é uma sistema de arquivos de próxima geração que está sendo implementado em todos os lugares, desde até .
Bem, hoje é o dia mais apropriado para conhecer o ZFS, leitores curiosos. Apenas saibam que, segundo a estimativa modesta do desenvolvedor do OpenZFS, Matt Arenson, "isso é realmente complicado".
Mas antes de chegarmos aos números — e eles virão, prometo — sobre todas as opções de configuração de oito discos do ZFS, precisamos falar sobre como o ZFS armazena dados no disco.
Zpool, vdev e device
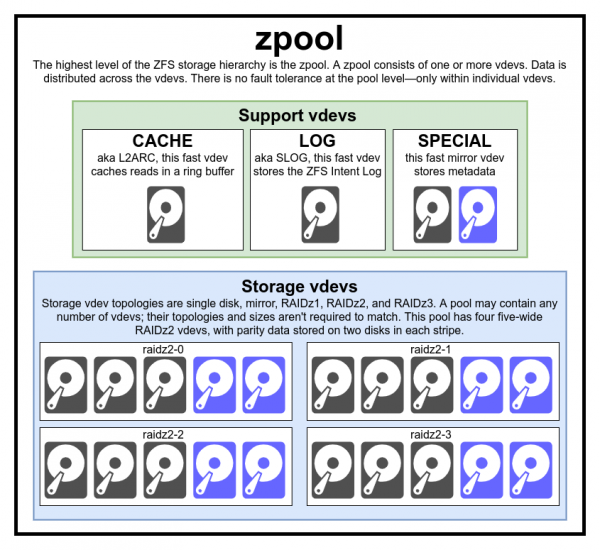
Este diagrama do pool completo inclui três vdevs auxiliares, um de cada classe, e quatro para RAIDz2
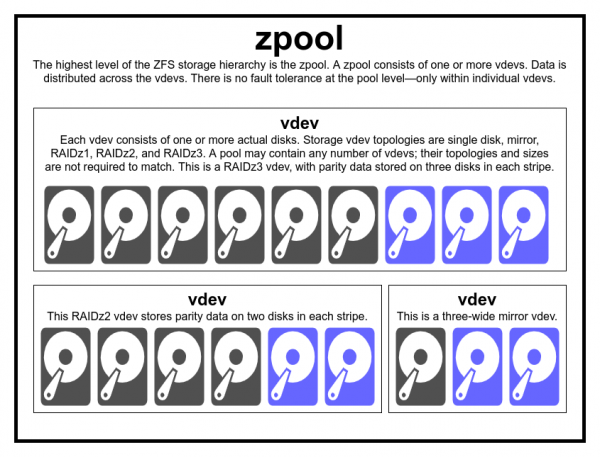
Normalmente, não há razão para criar um pool de tipos e tamanhos de vdev incompatíveis — mas se você quiser, nada impede que você faça isso
Para realmente entender o sistema de arquivos ZFS, é necessário examinar cuidadosamente sua estrutura real. Em primeiro lugar, o ZFS combina os níveis tradicionais de gerenciamento de volumes e sistemas de arquivos. Em segundo lugar, utiliza um mecanismo transacional de cópia na gravação. Essas características significam que o sistema é estruturalmente muito diferente dos sistemas de arquivos e matrizes RAID comuns. O primeiro conjunto de blocos de construção fundamentais para entender: é o pool de armazenamento (zpool), dispositivo virtual (vdev) e dispositivo real (device).
zpool
O pool de armazenamento zpool é a estrutura mais alta do ZFS. Cada pool contém um ou mais dispositivos virtuais. Por sua vez, cada um deles contém um ou mais dispositivos reais (device). Os pools virtuais são blocos autônomos. Um computador físico pode conter dois ou mais pools separados, mas cada um é completamente independente dos outros. Os pools não podem compartilhar dispositivos virtuais.
A redundância do ZFS está no nível dos dispositivos virtuais, e não no nível dos pools. No nível dos pools, não há absolutamente nenhuma redundância — se algum armazenamento vdev ou vdev especial for perdido, todo o pool será perdido junto.
Os modernos pools de armazenamento podem sobreviver à perda do cache ou do log do dispositivo virtual – embora possam perder uma pequena quantidade de dados sujos se o log do vdev for perdido durante uma queda de energia ou falha do sistema.
Há um equívoco comum de que as «faixas de dados» (stripes) do ZFS são gravadas por todo o pool. Isso é incorreto. Zpool não é um RAID0 divertido, é mais um divertido com um complexo mecanismo variável de distribuição.
Em sua maior parte, as gravações são distribuídas entre os dispositivos virtuais disponíveis de acordo com o espaço livre disponível, de modo que, teoricamente, todos eles serão preenchidos simultaneamente. Nas versões mais recentes do ZFS, o uso atual (utilização) do vdev é considerado – se um dispositivo virtual estiver significativamente mais carregado que outro (por exemplo, devido à carga de leitura), ele será temporariamente ignorado para gravação, apesar de ter a maior taxa de espaço livre.
O mecanismo de determinação de utilização, embutido nos modernos métodos de distribuição de gravuras do ZFS, pode reduzir a latência e aumentar a largura de banda durante períodos de carga incomumente alta – mas isso não dá liberdade total para o involuntário agrupamento de HDDs lentos e SSDs rápidos em um único pool. Um pool desigual ainda funcionará na velocidade do dispositivo mais lento, ou seja, como se fosse composto inteiramente por esses dispositivos.
vdev
Cada pool de armazenamento consiste em um ou mais dispositivos virtuais (virtual device, vdev). Por sua vez, cada vdev inclui um ou mais dispositivos reais. A maioria dos dispositivos virtuais é usada para armazenamento simples de dados, mas existem várias classes auxiliares de vdev, incluindo CACHE, LOG e SPECIAL. Cada um desses tipos de vdev pode ter uma das cinco topologias: dispositivo único (single-device), RAIDz1, RAIDz2, RAIDz3 ou espelho (mirror).
RAIDz1, RAIDz2 e RAIDz3 são tipos especiais do que os antigos chamariam de RAID de paridade dupla (diagonal). O 1, 2 e 3 referem-se ao número de blocos de paridade alocados para cada stripe de dados. Em vez de discos separados para fornecer paridade, os dispositivos RAIDz distribuem essa paridade de maneira semi-uniforme entre os discos. Um conjunto RAIDz pode perder tantos discos quantos forem seus blocos de paridade; se perder mais um, ele falhará e levará consigo o pool de armazenamento.
Em dispositivos virtuais espelhados (mirror vdev), cada bloco é armazenado em cada dispositivo no vdev. Embora os espelhos duplos (two-wide) sejam os mais comuns, um espelho pode ter qualquer número arbitrário de dispositivos — em grandes instalações, para melhorar o desempenho de leitura e a resistência a falhas, frequentemente utilizam-se espelhos triplos. Um espelho vdev pode sobreviver a qualquer falha, desde que pelo menos um dispositivo no vdev continue funcionando.
Os vdevs únicos são inerentemente perigosos. Um dispositivo virtual desse tipo não sobreviverá a nenhuma falha — e se usado como armazenamento ou vdev especial, sua falha resultará na destruição de todo o pool. Tenha muito, muito cuidado aqui.
Os dispositivos virtuais CACHE, LOG e SPECIAL podem ser criados em qualquer uma das topologias acima mencionadas — mas lembre-se que a perda de um dispositivo virtual SPECIAL significa a perda do pool, portanto, uma topologia redundante é altamente recomendada.
dispositivo
Talvez este seja o termo mais fácil de entender em ZFS — é literalmente um dispositivo de bloco de acesso aleatório. Lembre-se de que os dispositivos virtuais são compostos de dispositivos separados e o pool é feito de dispositivos virtuais.
Discos — magnéticos ou sólidos — são os dispositivos de bloco mais comuns usados como blocos de construção de vdev. No entanto, qualquer dispositivo com um descriptor em /dev servirá — assim, conjuntos RAID de hardware inteiros podem ser usados como dispositivos separados.
Um arquivo raw simples é um dos dispositivos de bloco alternativos mais importantes que podem ser usados para construir um vdev. Pools de teste de — são uma maneira muito prática de testar comandos de pool e ver quanto espaço está disponível em um pool ou dispositivo virtual daquela topologia.
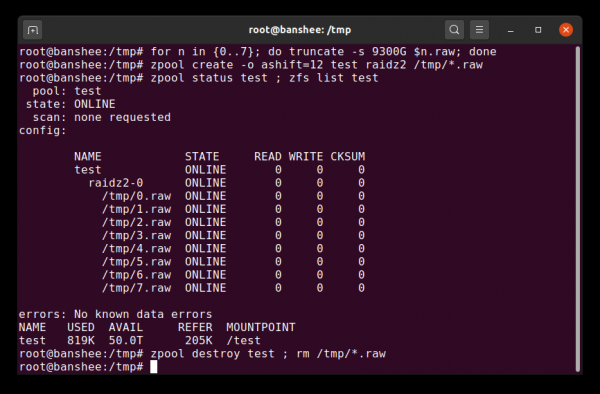
Você pode criar um pool de teste com arquivos esparsos em apenas alguns segundos — mas não se esqueça de remover todo o pool e seus componentes depois.
Vamos supor que você deseja montar um servidor com oito discos e planeja usar discos de 10 TB (~9300 GiB) — mas não tem certeza de qual topologia atende melhor às suas necessidades. No exemplo acima, estamos construindo um pool de teste com arquivos esparsos em questão de segundos — e agora sabemos que um vdev RAIDz2 de oito discos de 10 TB fornece 50 TiB de capacidade útil.
Outro tipo especial de dispositivos é o SPARE (sobressalente). Dispositivos hot-swappable, ao contrário dos dispositivos normais, pertencem a todo o pool e não a um único dispositivo virtual. Se algum vdev no pool falhar, e o dispositivo sobressalente estiver conectado ao pool e disponível, ele será automaticamente alocado ao vdev afetado.
Após a alocação ao vdev afetado, o dispositivo sobressalente começa a receber cópias ou reconstruções dos dados que deveriam estar no dispositivo ausente. Em RAID tradicional, isso é chamado de reconstrução, enquanto no ZFS isso é denominado "restauração de redundância" (resilvering).
É importante notar que dispositivos sobressalentes não substituem permanentemente dispositivos com falha. Esta é apenas uma substituição temporária para reduzir o tempo durante o qual o vdev apresenta degradação. Assim que o administrador substituir o dispositivo com falha do vdev, ocorre a restauração de redundância para este dispositivo permanente, enquanto o SPARE se desconecta do vdev e volta a ser um dispositivo sobressalente para todo o pool.
Conjuntos de dados, blocos e setores
O próximo conjunto de blocos de construção que precisamos entender em nossa jornada pelo ZFS refere-se não tanto ao hardware, mas a como os próprios dados são organizados e armazenados. Aqui, estamos pulando alguns níveis — como o metaslab — para não sobrecarregar os detalhes, mantendo a compreensão da estrutura geral.
Conjunto de dados (dataset)
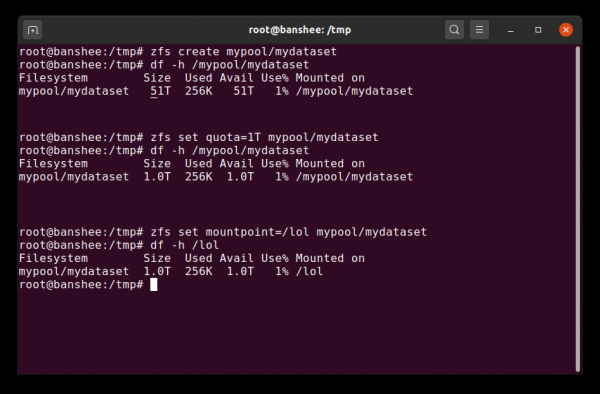
Quando criamos um conjunto de dados pela primeira vez, ele mostra todo o espaço disponível do pool. Em seguida, estabelecemos uma cota — e mudamos o ponto de montagem. É mágica!
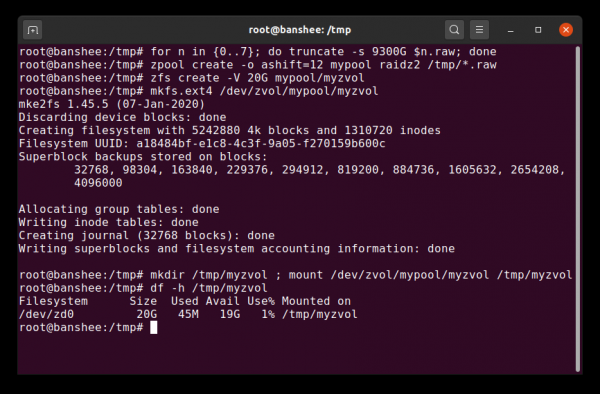
Zvol é em grande parte apenas um conjunto de dados livre de sua camada de sistema de arquivos, que substituímos aqui por um sistema de arquivos ext4 totalmente normal.
O conjunto de dados ZFS é aproximadamente análogo a um sistema de arquivos montado padrão. Assim como um sistema de arquivos comum, à primeira vista, ele pode parecer "apenas mais uma pasta". Mas, assim como nos sistemas de arquivos comuns, cada conjunto de dados ZFS possui seu próprio conjunto de propriedades básicas.
Em primeiro lugar, um conjunto de dados pode ter uma cota atribuída. Se você definir zfs set quota=100G poolname/datasetname, você não conseguirá gravar na pasta montada /poolname/datasetname mais do que 100 GiB.
Notou a presença — e a ausência — de barras no início de cada linha? Cada conjunto de dados tem seu lugar tanto na hierarquia ZFS quanto na hierarquia de montagem do sistema. Na hierarquia ZFS não há uma barra inicial — você começa com o nome do pool e, em seguida, o caminho de um conjunto de dados para outro. Por exemplo, pool/parent/child para um conjunto de dados chamado child sob o conjunto de dados pai parent em um pool com o nome criativo pool.
Por padrão, o ponto de montagem do conjunto de dados será equivalente ao seu nome na hierarquia ZFS, com uma barra no início — o pool com o nome pool será montado como /pool, o conjunto de dados parent será montado em /pool/parent, e o conjunto de dados filho child será montado em /pool/parent/child. No entanto, o ponto de montagem do sistema para o conjunto de dados pode ser alterado.
Se especificarmos zfs set mountpoint=/lol pool/parent/child, então o conjunto de dados pool/parent/child será montado no sistema como /lol.
Além dos conjuntos de dados, devemos mencionar os volumes (zvols). O volume é aproximadamente análogo a um conjunto de dados, exceto que ele não possui um sistema de arquivos real — é apenas um dispositivo de bloco. Você pode, por exemplo, criar zvol com o nome mypool/myzvol, então formatá-lo com um sistema de arquivos ext4 e, em seguida, montar esse sistema de arquivos — agora você tem um sistema de arquivos ext4, mas com suporte a todos os recursos de segurança do ZFS! Isso pode parecer estranho em um único computador, mas faz muito mais sentido como backend ao exportar um dispositivo iSCSI.
Blocos
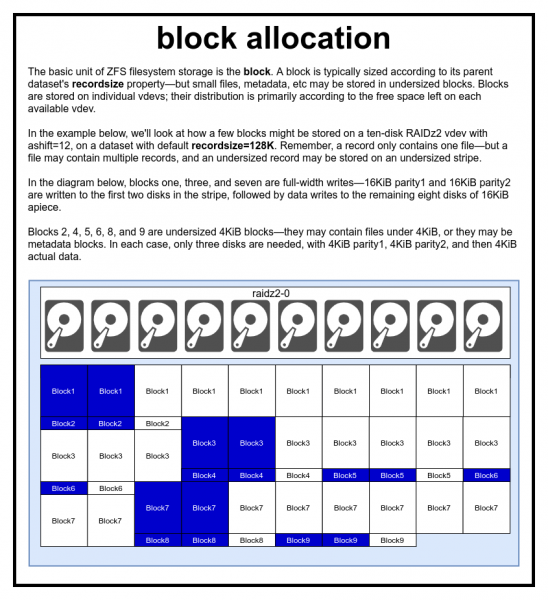
Um arquivo é representado por um ou mais blocos. Cada bloco é armazenado em um único dispositivo virtual. O tamanho do bloco geralmente é igual ao parâmetro recordsize, mas pode ser reduzido para 2^ashift, se contiver metadados ou um arquivo pequeno.
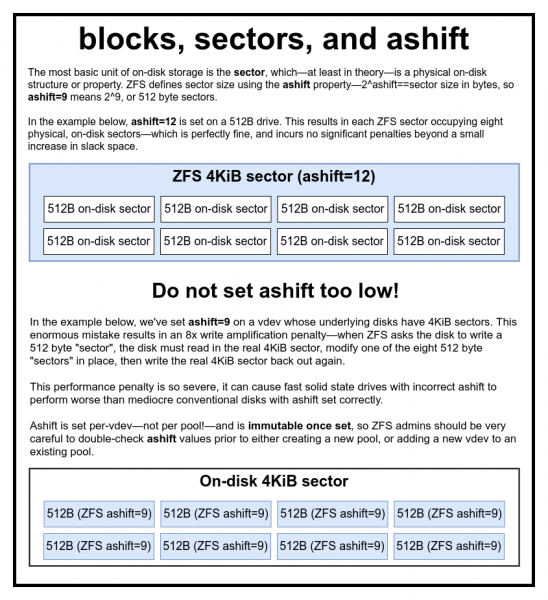
Nós realmente, realmente não estamos brincando sobre o enorme impacto no desempenho, se definir um ashift muito pequeno.
No pool ZFS, todos os dados, incluindo metadados, são armazenados em blocos. O tamanho máximo do bloco para cada conjunto de dados é determinado pela propriedade recordsize (tamanho do registro). O tamanho do registro pode variar, mas isso não alterará o tamanho ou a localização de quaisquer blocos que já tenham sido gravados no conjunto de dados - ele se aplica apenas a novos blocos à medida que são gravados.
Se não for especificado de outra forma, o tamanho do registro atual padrão é de 128 KiB. É uma espécie de compromisso razoável, onde o desempenho não será ideal, mas também não será horrível na maioria dos casos. Tamanho do registro pode ser ajustado para qualquer valor de 4K a 1M (com configurações adicionais recordsize pode ser definido ainda maior, mas isso raramente é uma boa ideia).
Qualquer bloco se refere a dados de um único arquivo - você não pode colocar dois arquivos diferentes em um bloco. Cada arquivo consiste de um ou mais blocos, dependendo do tamanho. Se o tamanho do arquivo for menor que o tamanho do registro, ele será armazenado em um bloco menor - por exemplo, um bloco com um arquivo de 2 KiB ocupará apenas um setor de 4 KiB no disco.
Se o arquivo for grande o suficiente e exigir vários blocos, todas as gravações com esse arquivo terão um tamanho recordsize — incluindo a última gravação, cuja maior parte pode ser .
Os volumes zvol não têm a propriedade recordsize — em vez disso, eles têm uma propriedade equivalente volblocksize.
Setores
O último e mais básico bloco de construção é o setor. Esta é a menor unidade física que pode ser gravada ou lida do dispositivo base. Durante várias décadas, a maioria dos discos usou setores de 512 bytes. Recentemente, a maioria dos discos está configurada para setores de 4 KiB, e alguns - especialmente SSDs - têm setores de 8 KiB ou até mais.
No sistema ZFS, há uma propriedade que permite definir manualmente o tamanho do setor. Esta propriedade ashift. É um pouco confuso que ashift seja uma potência de dois. Por exemplo, ashift=9 significa um tamanho de setor de 2^9, ou 512 bytes.
O ZFS solicita ao sistema operacional informações detalhadas sobre cada dispositivo de bloco quando é adicionado a um novo vdev e teoricamente ajusta automaticamente o ashift corretamente com base nessas informações. Infelizmente, muitos discos mentem sobre o tamanho de seu setor para manter a compatibilidade com o Windows XP (que era incapaz de entender discos com tamanhos de setor diferentes).
Isso significa que é fortemente recomendado que o administrador do ZFS conheça o tamanho real do setor de seus dispositivos e configure manualmente ashift. Se um ashift muito pequeno for configurado, o número de operações de leitura/gravação aumenta astronomicamente. Por exemplo, gravar "setores" de 512 bytes em um setor real de 4 KiB significa que é necessário gravar o primeiro "setor", depois ler o setor de 4 KiB, modificá-lo com o segundo "setor" de 512 bytes, gravá-lo de volta em um novo setor de 4 KiB e assim por diante para cada gravação.
No mundo real, essa penalização atinge os SSDs Samsung EVO, para os quais deve ser aplicada ashift=13, mas esses SSDs mentem sobre seu tamanho de setor e, portanto, por padrão é definido ashift=9. Se um administrador de sistema experiente não alterar essa configuração, esse SSD funcionará mais devagar do que um HDD magnético comum.
Em comparação, para um tamanho muito grande ashift praticamente não há penalização. Não há redução real de desempenho, e o aumento do espaço não utilizado é infinitesimal (ou igual a zero com a compressão ativada). Portanto, recomendamos fortemente que até mesmo os discos que realmente utilizam setores de 512 bytes configurem ashift=12 ou até mesmo ashift=13, para ter uma visão segura do futuro.
A propriedade ashift é configurado para cada dispositivo virtual vdev, e não para o pool, como muitos pensam erroneamente — e não é alterado após a configuração. Se você acidentalmente desviar ashift ao adicionar um novo vdev ao pool, você contaminou irreversivelmente esse pool com um dispositivo de baixo desempenho e, em geral, não há outra saída a não ser destruir o pool e começar tudo de novo. Mesmo a remoção do vdev não salvará a configuração desvirtuada. ashift!
O mecanismo de cópia ao escrever
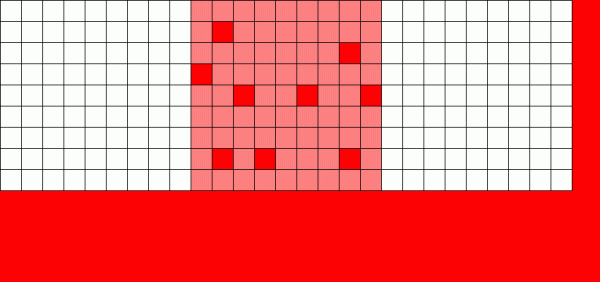
Se um sistema de arquivos normal precisar reescrever dados — ele altera cada bloco onde está localizado.
O sistema de arquivos com cópia sob demanda grava uma nova versão do bloco e, em seguida, desbloqueia a versão antiga.
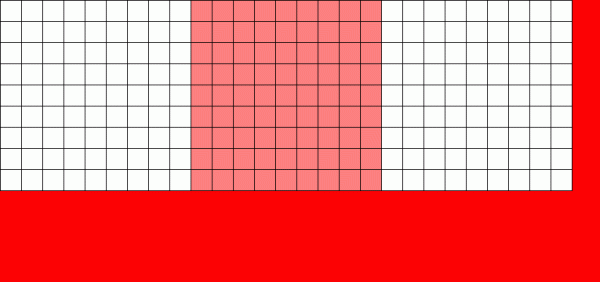
De maneira abstrata, se ignorarmos a localização física real dos blocos, nossa "cometa de dados" se simplifica para um "verme de dados" que se move da esquerda para a direita no mapa do espaço disponível.
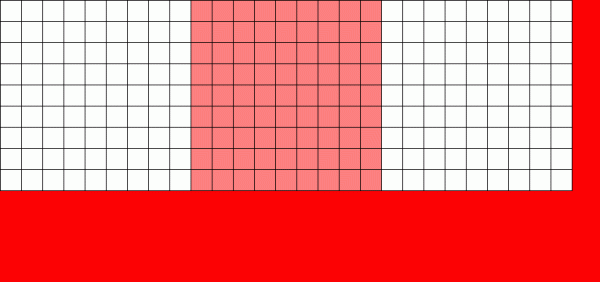
Agora podemos ter uma boa compreensão de como funcionam os snapshots de cópia sob demanda — cada bloco pode pertencer a vários snapshots e será mantido até que todos os snapshots associados sejam destruídos.
O mecanismo de cópia sob demanda (Copy on Write, CoW) é a base fundamental do que torna o ZFS um sistema tão impressionante. O conceito principal é simples — se você pedir a um sistema de arquivos tradicional para alterar um arquivo, ele fará exatamente o que você pediu. Se você pedir a um sistema de arquivos com cópia sob demanda para fazer o mesmo, ele dirá "ok" — mas te enganará.
Em vez disso, o sistema de arquivos com cópia sob demanda grava uma nova versão do bloco alterado e, em seguida, atualiza os metadados do arquivo para quebrar a conexão com o bloco antigo e vinculá-lo ao novo bloco que você acabou de gravar.
Desvincular o bloco antigo e vincular o novo é feito em uma única operação, portanto, não pode ser interrompido — se você cortar a energia após isso ocorrer, você terá uma nova versão do arquivo, e se você cortar a energia antes, terá a versão antiga. Em qualquer dos casos, não haverá conflitos no sistema de arquivos.
A cópia sob demanda no ZFS ocorre não apenas no nível do sistema de arquivos, mas também no nível de gerenciamento de discos. Isso significa que o ZFS não está sujeito ao problema de gravação () — um fenômeno onde a faixa foi apenas parcialmente gravada antes da falha do sistema, resultando em corrupção do array após a reinicialização. Aqui, a faixa é gravada de forma atômica, o vdev é sempre consistente, e .
ZIL: log de intenções do ZFS
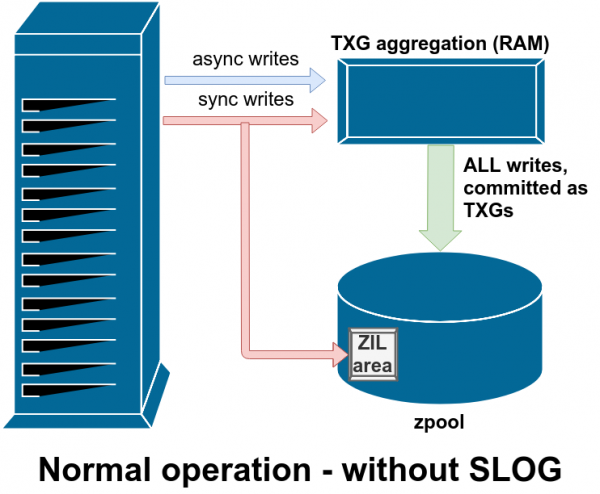
O sistema ZFS trata gravações síncronas de maneira especial — ele as armazena temporariamente, mas imediatamente, no ZIL, antes de gravá-las de forma permanente juntamente com as gravações assíncronas.
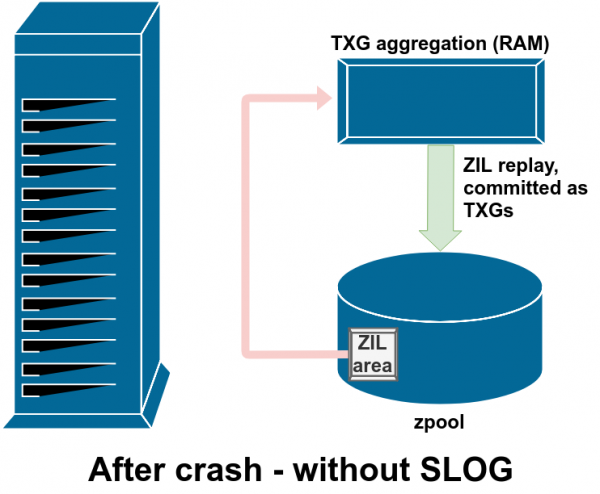
Normalmente, os dados gravados no ZIL nunca mais são lidos. Mas isso é possível após uma falha do sistema.
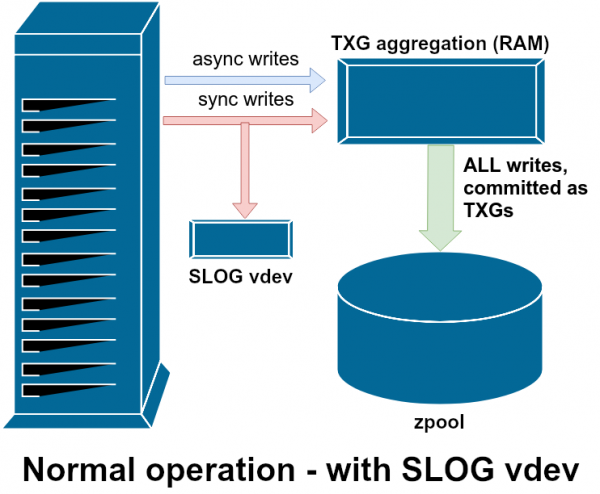
SLOG, ou dispositivo LOG secundário, é simplesmente um vdev especial - e, preferencialmente, muito rápido - onde o ZIL pode ser armazenado separadamente do armazenamento principal.
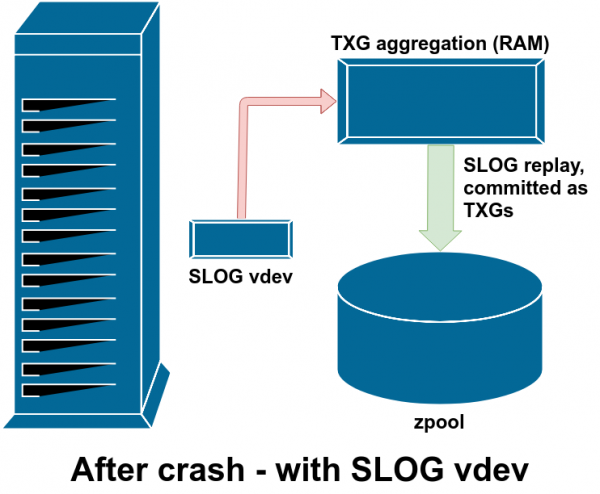
Após uma falha, todos os dados sujos no ZIL são reproduzidos - neste caso, o ZIL está no SLOG, então eles são reproduzidos precisamente de lá.
Existem duas categorias principais de operações de gravação - síncronas (sync) e assíncronas (async). Para a maioria das cargas de trabalho, a grande maioria das operações de gravação é assíncrona - o sistema de arquivos permite agregá-las e emití-las em pacotes, reduzindo a fragmentação e aumentando significativamente a largura de banda.
As gravações síncronas são uma história completamente diferente. Quando um aplicativo solicita uma gravação síncrona, ele diz ao sistema de arquivos: "Você precisa fixar isso na memória não volátil. neste momento., e até lá não posso fazer mais nada." Por isso, as gravações síncronas devem ser imediatamente fixadas no disco - e se isso aumentar a fragmentação ou reduzir a largura de banda, que assim seja.
O ZFS lida com gravações síncronas de maneira diferente das sistemas de arquivos tradicionais - em vez de empurrá-las imediatamente para o armazenamento normal, o ZFS as fixa em uma área de armazenamento especial chamada ZFS Intent Log, ou ZIL. A sacada é que essas gravações também permanecem na memória, sendo agregadas juntamente com as solicitações de gravação assíncronas normais, para serem posteriormente descartadas no armazenamento como TXG (grupos de transações, Transaction Groups) completamente normais.
No modo de operação normal, o ZIL é gravado e nunca mais lido. Quando, após alguns momentos, as gravações do ZIL são fixadas no armazenamento principal nos TXGs normais da memória, elas são desanexadas do ZIL. A única vez que algo é lido do ZIL é durante a importação do pool.
Se ocorrer uma falha no ZFS - falha do sistema operacional ou desligamento de energia - quando há dados no ZIL, esses dados serão lidos durante a próxima importação do pool (por exemplo, ao reiniciar um sistema de recuperação). Tudo que estiver no ZIL será lido, combinado em grupos TXG, fixado no armazenamento principal e, em seguida, desanexado do ZIL durante o processo de importação.
Uma das classes auxiliares do vdev é chamada de LOG ou SLOG, que é um dispositivo LOG secundário. Sua única função é fornecer ao pool um dispositivo vdev separado e, de preferência, muito mais rápido, com alta resistência à gravação, para armazenar o ZIL, em vez de armazenar o ZIL no armazenamento vdev principal. O ZIL em si se comporta da mesma forma, independentemente do local de armazenamento, mas se um vdev com LOG tem um desempenho de gravação muito alto, as gravações síncronas ocorrerão mais rapidamente.
Adicionar um vdev com LOG ao pool de nenhuma forma pode melhorar o desempenho de gravação assíncrona — mesmo que você force todas as gravações no ZIL com zfs set sync=always, elas ainda estarão ligadas ao armazenamento principal no TXG da mesma forma e no mesmo ritmo que sem o log. A única melhora direta no desempenho é a latência de gravação síncrona (já que uma velocidade maior do log acelera a execução das operações sync).
Entretanto, em um ambiente que já requer um grande número de gravações síncronas, o vdev LOG pode indiretamente acelerar gravações assíncronas e leituras não em cache. O descarregamento de gravações ZIL para um vdev LOG separado significa menos competição por IOPS no armazenamento primário, o que em certa medida melhora o desempenho de todas as operações de leitura e gravação.
Snapshots
O mecanismo de cópia em gravação também é uma base necessária para instantâneas atômicas do ZFS e replicação assíncrona incremental. Em um sistema de arquivos ativo, existe uma árvore de ponteiros que marca todas as gravações com os dados atuais — quando você cria um snapshot, está apenas fazendo uma cópia dessa árvore de ponteiros.
Quando uma gravação é reescrita em um sistema de arquivos ativo, o ZFS primeiro grava uma nova versão do bloco em um espaço não utilizado. Então, ele desvincula a versão antiga do bloco do sistema de arquivos atual. Mas se algum snapshot fizer referência ao bloco antigo, ele permanece inalterado. O bloco antigo, de fato, não será recuperado como espaço livre até que todos os snapshots que referenciam esse bloco sejam destruídos!
Replicação
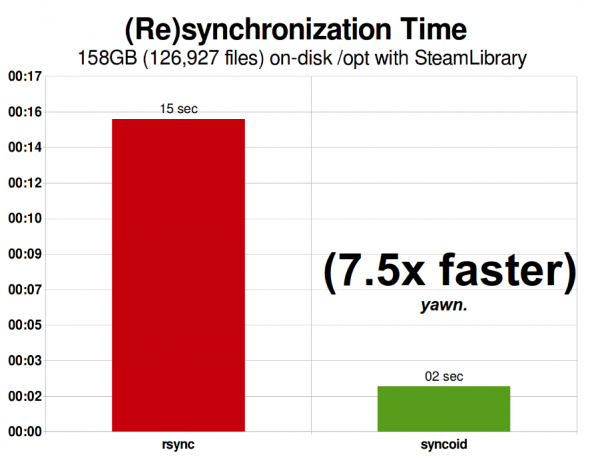
Minha biblioteca Steam em 2015 ocupava 158 GiB e incluía 126.927 arquivos. Isso é bastante próximo da situação ideal para rsync — a replicação do ZFS pela rede foi "apenas" 750% mais rápida.
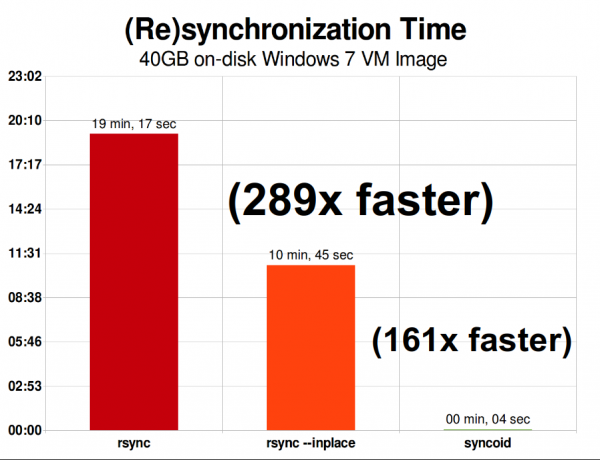
Na mesma rede, a replicação de um arquivo de imagem de máquina virtual Windows 7 de 40 gigabytes é uma história completamente diferente. A replicação ZFS ocorre 289 vezes mais rápido que rsync — ou "apenas" 161 vezes mais rápido, se você estiver familiarizado o suficiente para chamar rsync com a opção —inplace.
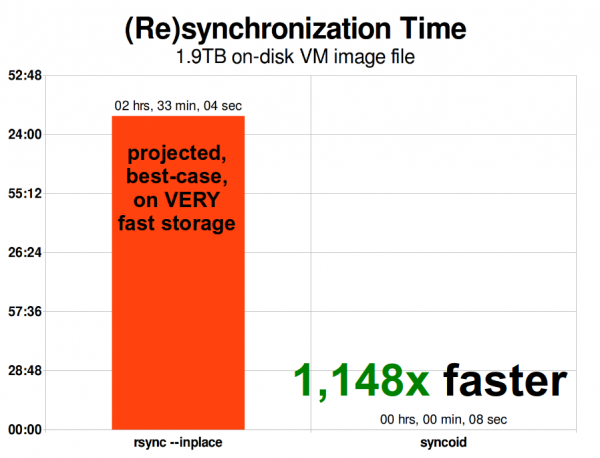
Quando a imagem da máquina virtual é dimensionada, os problemas do rsync também escalam. Um tamanho de 1,9 TiB não é tão grande para uma imagem de máquina virtual moderna — mas é grande o suficiente para que a replicação ZFS seja 1148 vezes mais rápida que o rsync, mesmo com o argumento rsync —inplace.
Assim que você entender como funcionam os snapshots, não será difícil captar a essência da replicação. Como um snapshot é apenas uma árvore de ponteiros para os registros, isso implica que, ao fazermos zfs send de um snapshot, enviamos tanto essa árvore quanto todos os registros associados a ela. Quando transferimos isso para zfs send em zfs receive no objeto de destino, ele grava tanto o conteúdo real do bloco quanto a árvore de ponteiros que se referem aos blocos no conjunto de dados de destino.
As coisas ficam ainda mais interessantes na segunda zfs send. Agora temos dois sistemas, cada um contendo poolname/datasetname@1, e você tira um novo snapshot poolname/datasetname@2. Portanto, no pool de origem, você tem datasetname@1 e datasetname@2, e no pool de destino, apenas o primeiro snapshot por enquanto. datasetname@1.
Como temos um snapshot compartilhado entre a fonte e o destino datasetname@1, podemos fazer incremental zfs send sobre ele. Quando dizemos ao sistema zfs send -i poolname/datasetname@1 poolname/datasetname@2, ele compara as duas árvores de ponteiros. Qualquer ponteiro que exista apenas em @2, obviamente, aponta para novos blocos — então precisaremos do conteúdo desses blocos.
No sistema remoto, o processamento incremental send é igualmente simples. Primeiro, gravamos todos os novos registros incluídos no fluxo send, e então adicionamos ponteiros para esses blocos. Voilà, temos @2 no novo sistema!
A replicação incremental assíncrona do ZFS é uma grande melhoria em relação aos métodos anteriores que não são baseados em snapshots, como o rsync. Em ambos os casos, apenas os dados alterados são transferidos — mas o rsync deve primeiro ler ler todos os dados de ambos os lados do disco para verificar a soma e compará-la. Em contraste, a replicação ZFS não lê nada além das árvores de ponteiros — e quaisquer blocos que não estejam representados no snapshot compartilhado.
Compressão embutida
O mecanismo de cópia na gravação também simplifica o sistema de compressão embutida. Em sistemas de arquivos tradicionais, a compressão é problemática — tanto a versão antiga quanto a nova dos dados alterados ocupam o mesmo espaço.
Se analisarmos um fragmento de dados no meio de um arquivo, que começa sua vida como um megabyte de zeros a partir de 0x00000000 e assim por diante — ele pode ser facilmente compactado para um único setor no disco. Mas o que acontece se substituímos esse megabyte de zeros por um megabyte de dados não compactáveis, como JPEG ou ruído pseudoaleatório? De repente, esse megabyte de dados exigirá não um, mas 256 setores de 4 KiB, e nesse local no disco está reservado apenas um setor.
O ZFS não tem esse problema, uma vez que as gravações alteradas são sempre escritas em espaço não utilizado — o bloco original ocupa apenas um setor de 4 KiB, e a nova gravação ocupará 256, mas isso não é um problema — o fragmento recentemente modificado do "meio" do arquivo seria gravado em espaço não utilizado, independentemente de ter mudado de tamanho ou não, portanto, para o ZFS isso é uma situação bastante comum.
A compressão embutida do ZFS está desativada por padrão, e o sistema oferece algoritmos plugáveis — atualmente, entre eles estão o LZ4, gzip (1-9), LZJB e ZLE.
- LZ4 — é um algoritmo de streaming que oferece compressão e descompressão extremamente rápidas, além de ganhos de desempenho para a maioria dos casos de uso — mesmo em CPUs relativamente lentas.
- GZIP — um algoritmo respeitável que é conhecido e amado por todos os usuários de sistemas Unix. Ele pode ser implementado com níveis de compressão de 1-9, com um aumento no grau de compressão e uso da CPU conforme se aproxima do nível 9. O algoritmo é bem adequado para todos os casos de uso textuais (ou outros altamente compressíveis), mas, caso contrário, frequentemente causa problemas com a CPU — use-o com cautela, especialmente em níveis mais altos.
- LZJB — o algoritmo original do ZFS. Ele está obsoleto e não deve mais ser utilizado, o LZ4 o supera em todos os aspectos.
- ZLE — codificação de nível zero, Zero Level Encoding. Ela, de fato, não afeta os dados normais, mas comprime grandes sequências de zeros. É útil para conjuntos de dados totalmente incomprimíveis (por exemplo, JPEG, MP4 ou outros formatos já comprimidos), pois ignora dados incomprimíveis, mas comprime o espaço não utilizado nas gravações finais.
Recomendamos a compressão LZ4 para praticamente todas as aplicações; a penalização de desempenho ao encontrar dados incomprimíveis é muito baixa, e aumento de desempenho para dados típicos é significativo. Copiar a imagem de uma máquina virtual para uma nova instalação do sistema operacional Windows (sistema operacional recém-instalado, sem dados contidos ainda) com compression=lz4 ocorreu 27% mais rápido do que com compression=none, neste teste de 2015 .
ZFS é o único sistema de arquivos moderno que conhecemos que utiliza seu próprio mecanismo de cache de leitura, ao invés de depender do cache de páginas do sistema operacional para armazenar cópias de blocos lidos recentemente na memória RAM.
Embora o cache próprio não esteja isento de problemas — o ZFS não pode responder a novas solicitações de alocação de memória tão rapidamente quanto o núcleo, portanto, uma nova chamada
malloc() para alocação de memória pode falhar se precisar da memória RAM atualmente ocupada pelo ARC. Mas há boas razões para usar o cache próprio, pelo menos agora. Todos os sistemas operacionais modernos conhecidos, incluindo MacOS, Windows, Linux e BSD, utilizam o algoritmo LRU (Least Recently Used) para implementar o cache de páginas. Este é um algoritmo primitivo que promove o bloco em cache "para cima na fila" após cada leitura e expulsa blocos “para baixo na fila” conforme necessário para adicionar novos misses de cache (blocos que deveriam ter sido lidos do disco, e não do cache) para cima.
Geralmente, o algoritmo funciona bem, mas em sistemas com grandes conjuntos de dados, o LRU facilmente leva à thrashing — expulsando blocos frequentemente necessários para liberar espaço para blocos que nunca mais serão lidos do cache.
ARC
— um algoritmo muito menos ingênuo, que pode ser considerado como um cache "ponderado". Após cada leitura de um bloco em cache, ele se torna um pouco mais "pesado" e é mais difícil de ser desalojado — e mesmo após ser desalojado, o bloco é rastreado durante um determinado período de tempo. Um bloco que foi desalojado, mas que depois deve ser lido de volta para o cache, também se tornará "mais pesado".
O resultado final de tudo isso é um cache com uma taxa de acerto (hit ratio) muito maior — a relação entre acertos no cache (leituras realizadas a partir do cache) e faltas (leituras do disco). Esta é uma estatística extremamente importante — não apenas os acertos do cache são atendidos muito mais rapidamente, mas as faltas do cache também podem ser atendidas mais rapidamente, pois quanto mais acertos no cache, menos solicitações paralelas ao disco e menor a latência para aquelas faltas restantes que precisam ser atendidas do disco.
Conclusão
Depois de estudar a semântica básica do ZFS — como funciona a cópia em gravação, bem como as relações entre pools de armazenamento, dispositivos virtuais, blocos, setores e arquivos — estamos prontos para discutir o desempenho real com números reais.
Na próxima parte, vamos analisar o desempenho real de pools com vdevs espelhados e RAIDz, um em comparação ao outro, bem como em comparação com as topologias RAID tradicionais do kernel Linux que investigamos .
Inicialmente, queríamos considerar apenas os fundamentos — as próprias topologias do ZFS — mas após isso estaremos prontos para discutir configurações e ajustes mais avançados do ZFS, incluindo o uso de tipos auxiliares de vdev, como L2ARC, SLOG e Alocação Especial.
Fonte: habr.com
