

SQL, o que pode ser mais simples? Qualquer um de nós pode escrever uma consulta simples — digitamos select, listamos as colunas necessárias, em seguida Harvard University, o nome da tabela, um pouco de condições em onde e tudo — os dados úteis estão a nosso alcance, quase independentemente do tipo de SGBD que está funcionando por trás (ou pode ser que ). Como resultado, trabalhar praticamente com qualquer fonte de dados (relacional ou não) pode ser considerado do ponto de vista de código comum (com todas as implicações — controle de versão, revisão de código, análise estática, testes automáticos e assim por diante). E isso se aplica não apenas aos dados, esquemas e migrações, mas à atividade geral do repositório. Neste artigo, vamos discutir tarefas cotidianas e problemas ao trabalhar com vários bancos de dados sob o foco de "database as code".
E vamos começar diretamente com . As primeiras batalhas do tipo "SQL vs ORM" foram notadas ainda na .
Mapeamento objeto-relacional
Os defensores do ORM tradicionalmente valorizam a velocidade e a simplicidade de desenvolvimento, a independência do SGBD e a limpeza do código. Para muitos de nós, o código que interage com o banco de dados (e muitas vezes o próprio banco de dados)
normalmente parece algo assim…
@Entity
@Table(name = "stock", catalog = "maindb", uniqueConstraints = {
        @UniqueConstraint(columnNames = "STOCK_NAME"),
        @UniqueConstraint(columnNames = "STOCK_CODE") })
public class Stock implements java.io.Serializable {

    @Id
    @GeneratedValue(strategy = IDENTITY)
    @Column(name = "STOCK_ID", unique = true, nullable = false)
    public Integer getStockId() {
        return this.stockId;
    }
  ...
O modelo está repleto de anotações inteligentes, enquanto nos bastidores o valoroso ORM gera e executa toneladas de algum código SQL. A propósito, os desenvolvedores se esforçam para se proteger de seu banco de dados com quilômetros de abstrações, o que sugere um certo .
Do outro lado das barricadas, os defensores do "SQL feito à mão" destacam a possibilidade de extrair o máximo de sua SGBD sem camadas e abstrações adicionais. O que resulta em projetos "centrados em dados", onde especialistas treinados lidam com o banco de dados (que também podem ser chamados de "bancários", "especialistas em banco", "banco-gestores", etc.), enquanto os desenvolvedores só precisam "chamar" as views prontas e procedures, sem se aprofundar nos detalhes.
E se pegássemos o melhor dos dois mundos? Como é feito na ferramenta maravilhosa com um nome que afirma a vida . Vou citar algumas linhas da ideia geral na minha tradução livre, e mais detalhes podem ser conhecidos .
Clojure é uma linguagem incrível para criar DSLs, mas SQL já é, por si só, um DSL impressionante, e não precisamos de outro. S-expressões são maravilhosas, mas aqui elas não acrescentam nada novo. No final, ficamos com parênteses apenas por causa dos parênteses. Não concorda? Então, aguarde o momento em que a abstração sobre o banco de dados começar a falhar e você comece a lutar com a função. (raw-sql)
E agora, o que fazer? Vamos manter o SQL como SQL — um arquivo para cada consulta:
-- nome: users-by-country
select *
  from users
 where country_code = :country_code
… e então leia este arquivo, transformando-o em uma função Clojure comum:
(defqueries "some/where/users_by_country.sql"
   {:connection db-spec})

;;; Uma função com o nome `users-by-country` foi criada.
;;; Vamos usá-la:
(users-by-country {:country_code "GB"})
;=> ({:name "Kris" :country_code "GB" ...} ...)
Seguindo o princípio de "SQL separado, Clojure separado", você obtém:
- Nensurpresas sintáticas. Seu banco de dados (como qualquer outro) não está 100% em conformidade com o padrão SQL — mas para Yesql isso não importa. Você nunca gastará tempo procurando por funções com a sintaxe equivalente ao SQL. Você nunca terá que voltar à função (raw-sql "some (‘funky’ :: SYNTAX)")).
- Melhor suporte ao editor. Seu editor já tem um ótimo suporte para SQL. Mantendo o SQL como SQL, você pode simplesmente utilizá-lo.
- Compatibilidade em equipe. Seus DBAs podem ler e escrever o SQL que você usa em seu projeto Clojure.
- Configuração de desempenho mais simples. Precisa criar um plano para uma consulta problemática? Isso não é um problema quando sua consulta é SQL comum.
- Reutilização de consultas. Desloque esses mesmos arquivos SQL para outros projetos, porque é apenas um velho e bom SQL — basta compartilhá-lo.
Na minha opinião, a ideia é muito boa e ao mesmo tempo muito simples, o que fez o projeto ganhar muito em diversos idiomas. E vamos tentar aplicar uma filosofia semelhante de separação do código SQL de todo o resto, muito além do ORM.
IDE & DB-gestores
Vamos começar com uma tarefa simples do dia a dia. Muitas vezes, precisamos localizar objetos em um banco de dados, como encontrar uma tabela em um esquema e examinar sua estrutura (quais colunas, chaves, índices, restrições, etc. estão em uso). E, de qualquer IDE gráfica ou de um DB-manager básico, esperamos, em primeiro lugar, essas capacidades. Para que seja rápido e não tenhamos que esperar meia hora até que a janela com as informações necessárias apareça (especialmente com uma conexão lenta a um banco de dados remoto), e, além disso, que as informações obtidas sejam atualizadas e relevantes, e não um conteúdo antigo em cache. Quanto mais complexo e maior for o banco de dados, e quanto maior for o número deles, mais difícil se torna essa tarefa.
Mas normalmente eu deixo o mouse de lado e apenas escrevo código. Vamos supor que precisamos saber quais tabelas (e com quais propriedades) estão contidas no esquema "HR". Na maioria dos SGBDs, o resultado desejado pode ser alcançado com a seguinte consulta simples ao information_schema:
select table_name
     , ...
  from information_schema.tables
 where schema = 'HR'
De banco para banco, o conteúdo dessas tabelas de referência varia de acordo com as capacidades de cada SGBD. E, por exemplo, para MySQL, a partir desse mesmo dicionário, é possível obter parâmetros específicos desse SGBD para a tabela:
select table_name
     , storage_engine -- O "motor" utilizado ("MyISAM", "InnoDB" etc)
     , row_format     -- Formato da linha ("Fixed", "Dynamic" etc)
     , ...
  from information_schema.tables
 where schema = 'HR'
O Oracle não possui information_schema, mas ele possui , e não surgem grandes problemas:
select table_name
     , pct_free       -- Mínimo de espaço livre no bloco de dados (%)
     , pct_used       -- Mínimo de espaço utilizado no bloco de dados (%)
     , last_analyzed  -- Data da última coleta de estatísticas
     , ...
  from all_tables
 where owner = 'HR'
ClickHouse não é uma exceção:
select name
     , engine -- O "motor" utilizado ("MergeTree", "Dictionary" etc)
     , ...
  from system.tables
 where database = 'HR'
Algo semelhante pode ser feito no Cassandra (onde existem column families em vez de tabelas e keyspaces em vez de esquemas):
select columnfamily_name
     , compaction_strategy_class  -- Estratégia de compactação
     , gc_grace_seconds           -- Tempo de vida do lixo
     , ...
  from system.schema_columnfamilies
 where keyspace_name = 'HR'
Para a maioria dos outros bancos de dados, também é possível pensar em consultas semelhantes (até no Mongo há , que contém informações sobre todas as coleções no sistema).
Certamente, dessa forma, é possível obter informações não apenas sobre tabelas, mas sobre qualquer objeto. Periodicamente, pessoas bem-intencionadas compartilham esse tipo de código para diferentes bancos de dados, como na série de artigos do Habr "Funções para documentar bancos de dados PostgreSQL" (, , ). É claro que manter toda essa quantidade de consultas na cabeça e digitá-las constantemente é um prazer "não tão agradável", então, no meu IDE/editor favorito, eu tenho um conjunto pré-definido de snippets para consultas frequentemente usadas, e basta inserir os nomes dos objetos no modelo.
No final, essa forma de navegação e busca de objetos é muito mais flexível, economiza muito tempo, permite obter exatamente a informação e na forma que é necessária no momento (como descrito no post ).
Operações com objetos
Após encontrarmos e estudarmos os objetos necessários, é hora de fazer algo útil com eles. Evidentemente, sem tirar os dedos do teclado.
Não é segredo que a simples exclusão de uma tabela se parece quase igual em todos os bancos de dados:
drop table hr.personsA criação de uma tabela já é um pouco mais interessante. Praticamente qualquer SGBD (incluindo muitos NoSQL) consegue de alguma forma realizar "create table", e a maior parte dele será bastante similar (nome, lista de colunas, tipos de dados), mas os outros detalhes podem variar drasticamente e dependem da estrutura interna e capacidades específicas de cada SGBD. Meu exemplo favorito — na documentação da Oracle, apenas as "BNFs" nuas para a sintaxe "create table" . Outros SGBDs possuem capacidades mais modestas, mas cada um também possui várias características interessantes e únicas para a criação de tabelas (, , , ). É improvável que algum "assistente" gráfico de um IDE qualquer (especialmente um universal) consiga cobrir todas essas capacidades completamente, e mesmo que consiga, será um espetáculo que não é para os nervos fracos. Ao mesmo tempo, um operador escrito corretamente e no momento certo create table permitirá explorar todas elas facilmente, tornando o armazenamento e o acesso aos seus dados confiáveis, otimizados e o mais confortáveis possível.
Além disso, muitos SGBDs têm seus tipos específicos de objetos que não estão presentes em outros SGBDs. E podemos realizar operações não apenas sobre os objetos do banco de dados, mas também sobre o próprio SGBD, como 'matar' um processo, liberar uma área de memória, ativar rastreamento, mudar para o modo 'somente leitura' e muito mais.
Agora vamos desenhar um pouco
Uma das tarefas mais comuns é construir um diagrama com os objetos do banco de dados, visualizar os objetos e as relações entre eles em uma imagem bonita. Quase qualquer IDE gráfica, utilitários de linha de comando separados, ferramentas gráficas especializadas e modeladores podem fazer isso. Eles vão desenhar algo 'como conseguem', e a influência sobre esse processo pode ser feita apenas através de alguns parâmetros no arquivo de configuração ou opções na interface.
Mas esse problema pode ser resolvido de forma muito mais simples, flexível e elegante, e claro, com a ajuda de código. Para construir diagramas de qualquer complexidade, temos várias linguagens de marcação especializadas (DOT, GraphML etc.), e a elas estão associados uma gama de aplicativos (GraphViz, PlantUML, Mermaid), que sabem ler tais instruções e visualizar em diversos formatos. Já sabemos como obter informações sobre os objetos e as relações entre eles.
Vamos dar um pequeno exemplo de como isso poderia parecer, usando PlantUML e (à esquerda, uma consulta SQL que gerará a instrução necessária para PlantUML, e à direita, o resultado):
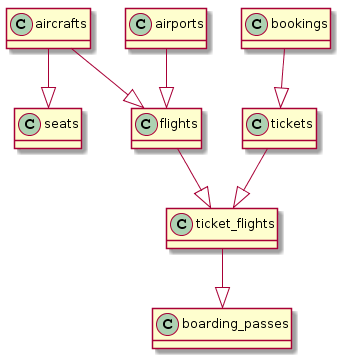
select '@startuml'||chr(10)||'hide methods'||chr(10)||'hide stereotypes' union all
select distinct ccu.table_name || ' --|> ' ||
       tc.table_name as val
  from table_constraints as tc
  join key_column_usage as kcu
    on tc.constraint_name = kcu.constraint_name
  join constraint_column_usage as ccu
    on ccu.constraint_name = tc.constraint_name
 where tc.constraint_type = 'FOREIGN KEY'
   and tc.table_name ~ '.*' union all
select '@enduml'
E se prestarmos um pouco mais de atenção, com base no podemos obter algo que se assemelha bastante a um verdadeiro diagrama ER:
A consulta SQL é um pouquinho mais complexa
-- Cabeçalho
select '@startuml
!define Table(name,desc) class name as "desc" << (T,#FFAAAA) >>
!define primary_key(x) <b>x</b>
!define unique(x) <color:green>x</color>
!define not_null(x) <u>x</u>
hide methods
hide stereotypes'
union all
-- Tabelas
select format('Table(%s, "%s n informações sobre %s") {'||chr(10), table_name, table_name, table_name) ||
(select string_agg(column_name || ' ' || upper(udt_name), chr(10))
from information_schema.columns
where table_schema = 'public'
and table_name = t.table_name) || chr(10) || '}'
from information_schema.tables t
where table_schema = 'public'
union all
-- Relações entre tabelas
select distinct ccu.table_name || ' "1" --> "0..N" ' || tc.table_name || format(' : "Uma %s pode ter várias %s"', ccu.table_name, tc.table_name)
from information_schema.table_constraints as tc
join information_schema.key_column_usage as kcu on tc.constraint_name = kcu.constraint_name
join information_schema.constraint_column_usage as ccu on ccu.constraint_name = tc.constraint_name
where tc.constraint_type = 'FOREIGN KEY'
and ccu.constraint_schema = 'public'
and tc.table_name ~ '.*'
union all
-- Rodapé
select '@enduml' 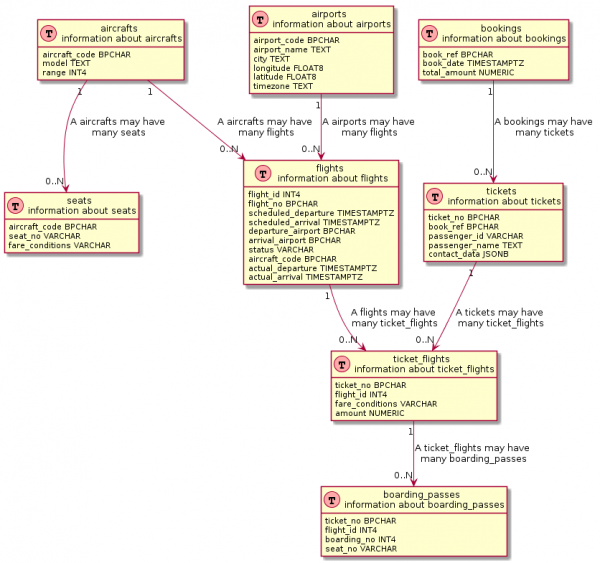
Se olharmos de perto, muitos ferramentas de visualização utilizam consultas semelhantes nos bastidores. Contudo, essas consultas geralmente estão profundamente , sem mencionar qualquer modificação que possam sofrer.
Métricas e monitoramento
Vamos abordar um tópico tradicionalmente complexo — monitoramento da performance de bancos de dados. Lembro de uma pequena história real que me foi contada por "um amigo meu". Em um projeto, havia um poderoso DBA, e poucos desenvolvedores tinham a oportunidade de conhecê-lo pessoalmente, ou mesmo de vê-lo, apesar de, segundo rumores, ele trabalhar em um prédio vizinho. No momento "X", quando o sistema de produção de um grande varejista começava a "sentir-se mal" novamente, ele silenciosamente enviava capturas de tela dos gráficos do Oracle Enterprise Manager, onde destacava criticamente os pontos problemáticos com um marcador vermelho para "clareza" (o que, para dizer o mínimo, ajudava muito pouco). E assim tínhamos que resolver os problemas baseado nessas "fotos". Nenhum desenvolvedor tinha acesso ao precioso (em todos os sentidos) Enterprise Manager, pois o sistema era complexo e caro, e se os "devs" mexessem em algo, poderia tudo quebrar. Portanto, os desenvolvedores encontravam, de forma "empírica", a causa e o local dos atrasos e lançavam um patch. Se a temida mensagem do DBA não chegasse novamente em breve, todos respiravam aliviados e voltavam às suas tarefas atuais (até que uma nova mensagem chegasse).
Mas o processo de monitoramento pode ser mais animado e amigável, e o mais importante — acessível e transparente para todos. Pelo menos a parte básica, como um complemento aos principais sistemas de monitoramento (que são, sem dúvida, úteis e muitas vezes indispensáveis). Qualquer SGBD está pronto para compartilhar informações sobre seu estado atual e desempenho de forma livre e totalmente gratuita. Na mesma "sanguinária" Oracle DB, praticamente qualquer informação sobre desempenho pode ser obtida a partir de visões sistêmicas, desde processos e sessões até o estado do cache de buffers (por exemplo, , seção "Monitoramento"). No Postgresql, também há uma variedade de visões sistêmicas para , em particular, algumas que são indispensáveis na vida diária de qualquer DBA, como , , . No MySQL, há até um esquema separado para isso, . E no Mongo, um agrega dados sobre o desempenho em uma coleção sistêmica .
Assim, armados com algum coletor de métricas (Telegraf, Metricbeat, Collectd), que consegue executar consultas SQL personalizadas, um armazenamento dessas métricas (InfluxDB, Elasticsearch, Timescaledb) e um visualizador (Grafana, Kibana), é possível obter um sistema de monitoramento bastante leve e flexível, que será estreitamente integrado com outras métricas do sistema (obtidas, por exemplo, do servidor de aplicativos, do sistema operacional, etc.). Como é feito no pgwatch2, onde é utilizada a combinação InfluxDB + Grafana e um conjunto de consultas às visões do sistema, às quais também podem ser .
Total
E essa é apenas uma lista aproximada do que pode ser feito com nosso banco de dados através de SQL comum. Tenho certeza de que existem ainda muitas aplicações, escreva nos comentários. E sobre como (e, principalmente, por que) automatizar tudo isso e integrá-lo ao seu pipeline CI/CD, falaremos na próxima vez.
Fonte: habr.com
