

A interpretação da apresentação de 2015 de Ilya Kosmodemyansky "Ajustes no Linux para melhorar o desempenho do PostgreSQL"
Aviso: Vale lembrar que essa apresentação é datada de novembro de 2015 — já se passaram mais de 4 anos e muito tempo. A versão discutida na apresentação, 9.4, já não é mais suportada. Nos últimos 4 anos, 5 novos lançamentos do PostgreSQL e 15 versões do núcleo do Linux foram lançados. Se formos reescrever esses trechos, acabaremos com outra apresentação. Mas aqui é abordado o ajuste fundamental do Linux para o PostgreSQL, que ainda é relevante hoje.
Meu nome é Ilya Kosmodemyansky. Eu trabalho na empresa PostgreSQL-Consulting. E agora vou falar um pouco sobre o que fazer com o Linux em relação a bancos de dados em geral e ao PostgreSQL em particular, porque os princípios são bastante similares.
Do que falaremos? Se você está interagindo com o PostgreSQL, em certa medida, é necessário ser um admin de UNIX. O que isso significa? Se compararmos o Oracle com o PostgreSQL, no Oracle você precisa ser 80% um DBA do banco de dados e 20% um admin de Linux.
Com o PostgreSQL é um pouco mais complicado. Com o PostgreSQL, você precisa ter uma compreensão muito melhor de como o Linux funciona. E, além disso, é necessário acompanhar as atualizações, porque nos últimos tempos muitas coisas têm sido atualizadas. Novos núcleos são lançados, novas funcionalidades aparecem, o desempenho melhora, etc.
Por que falamos sobre Linux? Não é apenas porque estamos na conferência Linux em São Petersburgo, mas porque, nas condições atuais, um dos sistemas operacionais mais adequados para uso com bancos de dados em geral e com o PostgreSQL em particular é o Linux. Porque o FreeBSD, infelizmente, está se desenvolvendo em uma direção bastante estranha. E haverá problemas tanto com o desempenho quanto com muitas outras questões. O desempenho do PostgreSQL no Windows é um tema à parte, que enfrenta o fato de que o Windows não possui a memória compartilhada como o UNIX, e tudo no PostgreSQL está ligado a isso, pois é um sistema multiprocessado.
E exóticos como o Solaris, eu penso, interessam menos a todos, então vamos em frente.
Em uma distribuição moderna do Linux, existem mais de 1.000 parâmetros syctl, dependendo de como o núcleo é compilado. Além disso, se olharmos para diferentes opções, podemos ajustar de muitas maneiras. Existem parâmetros de sistemas de arquivos, como montá-los. Se houver dúvidas sobre como iniciar: o que ativar na BIOS, como configurar o hardware, etc.
Este é um volume muito grande, sobre o qual se pode falar por vários dias, e não em uma curta apresentação, mas agora vou me concentrar nas coisas importantes, como evitar as armadilhas que, com certeza, não permitirão que você use bem o banco de dados no Linux, se não forem corrigidas. E um ponto importante é que muitos parâmetros por padrão não estão configurados corretamente para o banco de dados. Ou seja, por padrão, o funcionamento será ruim ou pode não funcionar de forma alguma.
Quais são os alvos tradicionais de tuning no Linux? Eu acho que, uma vez que todos vocês lidam com a administração do Linux, não é preciso explicar muito o que são os targets.
Você pode ajustar:
- CPU.
- Memória.
- Armazenamento.
- Outros. Sobre isso falaremos no final como uma sobremesa. Mesmo, por exemplo, parâmetros como a política de economia de energia podem afetar a performance de forma muito imprevisível e nem sempre agradável.
Qual é a especificidade do PostgreSQL e dos bancos de dados em geral? O problema é que não se pode ajustar apenas uma pecinha e ver que a performance melhorou significantemente.
Sim, existem essas pecinhas, mas o banco de dados é algo complexo. Ele interage com todos os recursos disponíveis no servidor e prefere interagir plenamente. Se você olhar as recomendações modernas da Oracle sobre como usar o sistema operacional do host, será como a piada do cosmonauta mongol - dar comida ao cachorro e não tocar em mais nada. Dê todos os recursos ao banco, ele mesmo se encarregará de tudo.
Em princípio, até certo ponto, a situação é exatamente a mesma com o PostgreSQL. A diferença é que o banco de dados não consegue aproveitar todos os recursos por conta própria, ou seja, em alguns casos é necessário gerenciar isso no nível do Linux.
A ideia principal é não escolher um único target e começar a ajustá-lo, como memória, CPU ou algo semelhante, mas analisar a carga de trabalho e tentar melhorar ao máximo a capacidade de transferência, para que a carga que os bons programadores e os nossos usuários criaram passe de forma mais eficiente pelo nosso banco de dados.
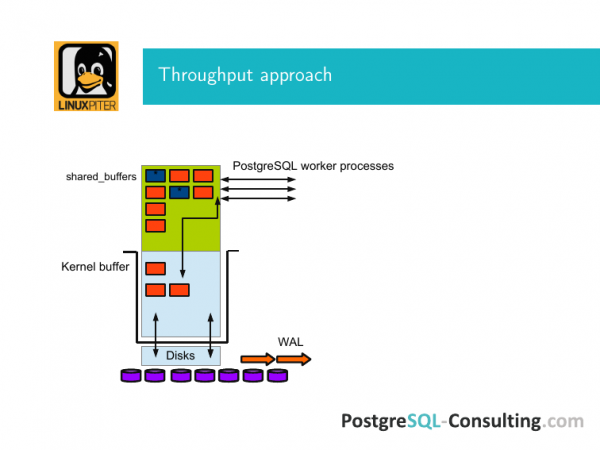
Esta é uma imagem para explicar o que isso significa. Existe um buffer do sistema operacional Linux e há memória compartilhada e buffers compartilhados do PostgreSQL. Ao contrário do Oracle, o PostgreSQL opera diretamente apenas através do buffer do kernel, ou seja, para que uma página do disco entre na sua memória compartilhada, ela deve passar pelo kernel buffer e o mesmo se aplica na volta.
Sob este sistema vivem os discos. Eu desenhei isso como discos. Na verdade, pode haver um controlador RAID, etc.
E essa entrada e saída acontece de uma forma ou de outra através disso.
PostgreSQL é um banco de dados clássico. As páginas ficam dentro dele. E toda a entrada e saída acontecem através das páginas. Nós carregamos blocos na memória usando páginas. E se nada acontecer, e apenas as lemos, elas gradualmente saem desse cache, dos buffers compartilhados, e voltam para o disco.
Se fizermos alguma modificação, a página inteira é marcada como suja. Eu a destaquei aqui em azul. Isso significa que essa página deve ser sincronizada com o armazenamento em bloco. Ou seja, quando a tornamos suja, registramos uma entrada no WAL. E, em um determinado momento, ocorreu um fenômeno chamado checkpoint. E esse log registrou a informação de que ele aconteceu. Isso significa que todas as páginas sujas que estavam aqui nesse momento nos buffers compartilhados foram sincronizadas com o disco de armazenamento através de fsync pelo kernel buffer.
Por que isso é feito? Se houver uma perda de energia, não teremos a situação de que todos os dados foram perdidos. A memória persistente, que nos contaram, está ainda na teoria dos bancos de dados – é um futuro brilhante que, definitivamente, almejamos e nos agrada, mas ainda está 20 anos atrasado. E, claro, isso tudo precisa ser monitorado.
E o objetivo de maximizar a largura de banda é ajustar em todas essas etapas para que tudo funcione rapidamente. A memória compartilhada é principalmente um cache de páginas. No PostgreSQL, enviamos uma consulta select para obter algo, ele recuperou esses dados do disco. Eles foram para os buffers compartilhados. Portanto, para que isso funcione melhor, deve haver muita memória.
Para que tudo isso funcione bem e rapidamente, você precisa configurar corretamente o sistema operacional em todas as etapas. E escolher um hardware equilibrado, pois se houver um desequilíbrio em algum lugar, você pode ter muita memória, mas ela funcionará com velocidade insuficiente.
E vamos abordar cada um desses pontos.
Para que essas páginas se movimentem de forma mais rápida, é preciso alcançar o seguinte:
- Primeiro, é necessário trabalhar de maneira mais eficiente com a memória.
- Em segundo lugar, essa transição, quando as páginas da memória vão para o disco, deve ser mais eficiente.
- E, em terceiro lugar, deve haver bons discos.
Se você tiver 512 GB de memória RAM em servidor e tudo isso acabar em um disco rígido SATA sem cache algum, o servidor de banco de dados se transforma não apenas em uma abóbora, mas em uma abóbora com interface SATA. Você vai esbarrar nisso diretamente. E nada vai salvá-lo.
Quanto ao primeiro ponto sobre a memória, existem três coisas que podem complicar muito a vida.
A primeira delas é o NUMA. NUMA é uma abordagem criada para melhorar a performance. Dependendo da carga de trabalho, é possível otimizar diferentes aspectos. E em sua forma atual, não é muito boa para aplicativos como banco de dados que usam intensivamente o cache de páginas e buffers compartilhados.
Em poucas palavras. Como perceber que algo está errado com o NUMA? Você tem algum tipo de barulho desagradável, de repente algum CPU acaba sobrecarregado. Enquanto isso, você analisa as consultas no PostgreSQL e percebe que nada indica esse comportamento. Essas consultas não deveriam consumir CPU de forma tão intensa. Pode demorar para se detectar isso. É mais fácil seguir desde o início a recomendação correta sobre como configurar o NUMA para PostgreSQL.
O que realmente acontece? NUMA é a sigla para Non-Uniform Memory Access. Qual é a ideia? Você tem um CPU, e ao lado dele está sua memória local. E essa memória interconectada pode acessar a memória de outros CPUs.
Se você executar numactl --hardware, você vai encontrar uma grande lista. Entre outras coisas, haverá um campo de distâncias. Haverá números – 10-20, algo assim. Esses números nada mais são do que a quantidade de saltos necessários para acessar essa memória remota e usá-la localmente. Em princípio, é uma boa ideia. Isso acelera bastante a performance em algumas cargas de trabalho.
Agora imagine que você tem um CPU que primeiro tenta usar sua memória local, depois tenta acessar outra memória através do interconnect para alguma coisa. E todo o seu cache de página do PostgreSQL vai parar nesse CPU – tudo, quantos gigabytes forem. Você sempre enfrenta o pior caso, porque geralmente esse módulo de memória tem muito pouco disponível para o CPU. E toda a memória que é utilizada passa por esses interconnects. Isso se torna lento e decepcionante. E o seu processador, que gerencia esse nó, está constantemente sobrecarregado. E o tempo de acesso a essa memória é ruim, lento. Essa é a situação que você não deseja se estiver usando isso para um banco de dados.
Portanto, uma abordagem mais adequada para um banco de dados é que o sistema operacional Linux não saiba absolutamente nada sobre o que está acontecendo. Para que ele acesse a memória da forma que deveria.
Por que isso acontece? À primeira vista, deveria ser o contrário. Isso ocorre por uma razão simples: precisamos de muita memória para o cache de página – dezenas, centenas de gigabytes.
E se alocarmos tudo isso e armazenarmos nossos dados lá, o ganho de usar o cache será significativamente maior do que o ganho de uma manipulação astuta da memória. E, assim, ganharemos incomparavelmente mais do que se fôssemos mais eficientes na utilização da memória com NUMA.
Portanto, existem duas abordagens até o momento, até que um futuro mais claro chegue e o banco de dados aprenda a identificar quais CPUs ele está utilizando e de onde precisa puxar algo.
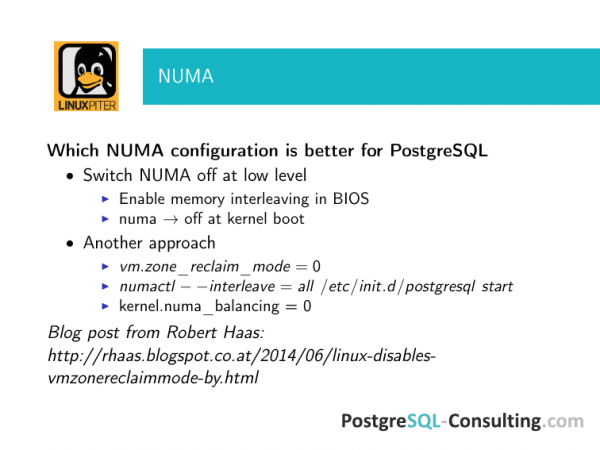
Assim, a abordagem correta é desativar completamente o NUMA., por exemplo, durante a reinicialização. Na maioria dos casos, os ganhos são tão evidentes que não há dúvida sobre qual é a melhor opção.
Há outra opção. Usamos essa com mais frequência do que a primeira, porque, quando um cliente nos procura para suporte, reiniciar o servidor é um grande problema. O negócio deles depende disso. E eles enfrentam problemas devido ao NUMA. Portanto, tentamos desativá-lo de maneiras menos invasivas do que uma reinicialização, mas é preciso ter cuidado para verificar se realmente foi desativado. Porque, como a experiência mostra, desativar o NUMA no processo pai do PostgreSQL é bom, mas não é garantido que funcione. É necessário verificar e assegurar que foi realmente desativado.
Há um bom post de Robert Haas. Ele é um dos colaboradores do PostgreSQL. Um dos principais desenvolvedores de todos os meandros de baixo nível. E se você seguir os links deste post, encontrará várias histórias interessantes sobre como o NUMA complicou a vida das pessoas. Veja, estude a lista de verificação para administradores que precisa ser configurada no servidor para que nossa base de dados funcione bem. Essas configurações devem ser anotadas e verificadas, pois, do contrário, a situação pode não ser boa.
Ressalto que isso se aplica a todas as configurações das quais falarei. Mas normalmente, as bases de dados são configuradas em modo master-slave para garantir a tolerância a falhas. Não se esqueça de aplicar essas configurações no slave, porque em um determinado momento, você terá uma falha e irá mudar para o slave, que se tornará o master.
Em uma situação de emergência, quando tudo está muito mal, com seu telefone tocando incessantemente e o chefe vindo até você com um grande bastão, você não terá tempo para pensar em verificar. E os resultados podem ser bastante desastrosos.
O próximo ponto são as huge pages. As huge pages são difíceis de testar separadamente, e não faz muito sentido, embora existam benchmarks que conseguem fazer isso. Eles são facilmente encontrados na internet.
Qual é o problema? Você tem um servidor que não é muito caro e possui muita memória RAM, por exemplo, mais de 30 GB. Você não utiliza huge pages. Isso significa que você tem um overhead claro no uso da memória. E esse overhead não é nem um pouco agradável.
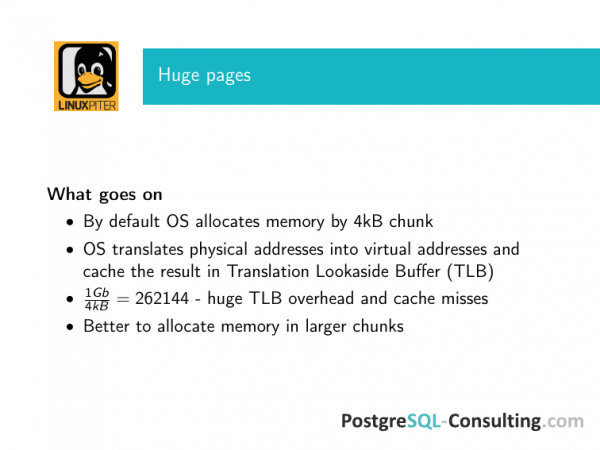
Por que isso acontece? O que está ocorrendo? O sistema operacional aloca memória em pequenos pedaços. É conveniente assim, é como as coisas se desenvolveram historicamente. E se aprofundando nos detalhes, o SO precisa traduzir endereços virtuais para endereços físicos. E esse processo não é o mais simples, por isso o SO armazena o resultado dessa operação em um Translation Lookaside Buffer (TLB).
E como o TLB é um cache, nessa situação surgem todos os problemas típicos de cache. Primeiro, se você tem uma grande quantidade de memória RAM e ela é toda alocada em pequenos pedaços, o buffer se torna muito grande. E se o cache é grande, a busca nele se torna mais lenta. O overhead é significativo e consome espaço, ou seja, algo errado está utilizando a memória. Isso é um problema.
Dois – quanto maior o cache se expande nessa situação, maior a probabilidade de você ter faltas de cache. E a eficiência desse cache cai rapidamente à medida que seu tamanho aumenta. Portanto, os sistemas operacionais idearam uma abordagem simples. No Linux, isso já é utilizado há muito tempo. No FreeBSD, surgiu não faz muito. Mas estamos falando do Linux. Isso são huge pages.
E aqui vale a pena destacar que huge pages, como ideia, foi inicialmente promovida por comunidades que incluíam Oracle e IBM, ou seja, os fabricantes de bancos de dados pensaram fortemente que isso seria útil, especialmente para bancos de dados.
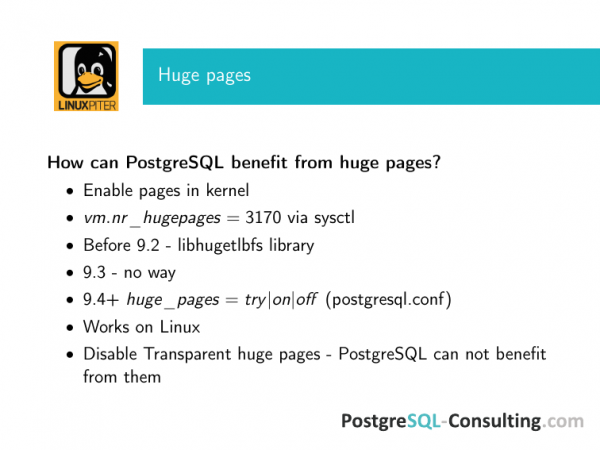
E como integrar isso ao PostgreSQL? Primeiro, as huge pages devem estar habilitadas no núcleo do Linux.
Em segundo lugar, elas devem ser especificadas explicitamente no parâmetro sysctl – quantas delas. Os números aqui vêm de algum servidor antigo. Você pode calcular aproximadamente quantos shared buffers você tem, para que as huge pages possam ser alocadas adequadamente.
E se todo o seu servidor estiver dedicado ao PostgreSQL, um bom ponto de partida é dedicar 25% da memória RAM para os buffers compartilhados, ou 75% se você tem certeza de que sua base de dados caberá nesses 75%. Esse é o primeiro ponto de partida. E calcule, se você tiver 256 GB de memória RAM, então, respectivamente, terá 64 GB de buffers compartilhados. Calcule aproximadamente com uma margem de segurança – qual deve ser esse valor.
Até a versão 9.2 (se não me engano, a partir da versão 8.2) era possível integrar o PostgreSQL com huge pages usando uma biblioteca de terceiros. E isso sempre precisa ser feito. Primeiro, você precisa que o núcleo saiba alocar huge pages corretamente. E, em segundo lugar, que o aplicativo que trabalha com elas possa utilizá-las. Apenas assim não funcionará. Como o PostgreSQL alocava memória no estilo do sistema 5, isso poderia ser feito com a libhugetlbfs – esse é o nome completo da biblioteca.
Na versão 9.3, melhoramos o desempenho do PostgreSQL ao trabalhar com memória e abandonamos o método de alocação de memória do sistema 5. Todos ficaram muito felizes, pois caso contrário, ao tentar iniciar duas instâncias do PostgreSQL em uma única máquina, ele diz que não há memória compartilhada suficiente. E afirma que é necessário ajustar o sysctl. E nesse caso, o sysctl é tão complicado que é preciso reiniciar, etc. Enfim, todos ficaram aliviados. Mas a alocação de memória mmap quebrou o uso de huge pages. A maioria dos nossos clientes utiliza grandes buffers compartilhados. E recomendamos fortemente não atualizar para a versão 9.3, pois a sobrecarga começava a ser significativa.
No entanto, a comunidade prestou atenção a esse problema e na versão 9.4 fez grandes melhorias nesse aspecto. E na versão 9.4, surgiu um parâmetro no postgresql.conf, onde é possível ativar o try, on ou off.
Try é o parâmetro mais seguro. Ao iniciar o PostgreSQL, quando ele aloca memória compartilhada, tenta capturar essa memória a partir de huge pages. Se não conseguir, volta para a alocação normal. E se você estiver usando FreeBSD ou Solaris, pode optar pelo try, pois isso é sempre seguro.
Se on, ele simplesmente não inicia se não conseguir alocar a partir de huge pages. Aqui já é uma questão de preferência. Mas se você optar por try, verifique se realmente foi alocada a memória necessária, pois há muito espaço para erro. Atualmente, essa funcionalidade funciona apenas no Linux.
Mais uma pequena observação antes de avançarmos. Transparent huge pages ainda não se aplica ao PostgreSQL. Ele não consegue usá-las de maneira adequada. E ao usar Transparent huge pages para essa carga de trabalho que requer um grande bloco de memória compartilhada, os benefícios aparecem apenas em volumes muito grandes. Se você tem terabytes de memória, isso pode fazer diferença. Se falarmos de aplicações mais cotidianas, onde você tem 32, 64, 128, 256 GB de memória na máquina, então huge pages normais são suficientes, e simplesmente desativamos o Transparent.
E a última coisa relacionada à memória, que não está diretamente ligada ao throughput, pode complicar muito a vida. Toda a largura de banda pode ser severamente afetada pela constante troca de memória do servidor.
E isso será muito desagradável em vários momentos. E o principal problema é que o comportamento dos núcleos modernos difere um pouco do dos núcleos mais antigos do Linux. E essa é uma questão difícil de lidar, porque, quando falamos sobre alguma operação com o swap, isso resulta na chegada não oportuna do OOM-killer. E o OOM-killer que não chegou a tempo e derrubou o PostgreSQL é algo indesejável. Todos ficarão sabendo disso, ou seja, até o último usuário.
O que está acontecendo? Você tem uma grande quantidade de memória RAM, tudo funciona bem. Mas, por algum motivo, o servidor está travado no swap e isso o está desacelerando. À primeira vista, parece que há muita memória, mas isso acontece.
Antes, aconselhávamos a configurar vm.swappiness para zero, ou seja, desativar o swap. Anteriormente, parecia que 32 GB de memória RAM e os buffers adequados compartilhados eram uma quantidade enorme. A principal função do swap é ter um espaço para jogar a carga se algo falhar. E isso já não estava sendo muito utilizado. E o que você fará com essa carga depois? É um problema em que não está muito claro por que o swap é necessário, especialmente de tal tamanho.
Mas em núcleos mais modernos, ou seja, nas versões três, o comportamento mudou. E se você definir o swap como zero, ou seja, desativá-lo, mais cedo ou mais tarde, mesmo com alguma memória RAM ainda disponível, o OOM-killer virá para eliminar os consumidores mais intensivos. Porque ele entenderá que, com essa carga de trabalho, ainda nos resta um pouco e vamos exceder, ou seja, não matar um processo do sistema, mas eliminar algo menos importante. E esse algo menos importante será o consumidor intensivo de memória compartilhada, especificamente o postmaster. E depois disso, será bom se você não precisar restaurar o banco de dados.
Portanto, agora, por padrão, pelo que me lembro, a maioria das distribuições está em torno de 6, ou seja, em que momento começar a usar o swap dependendo da quantidade de memória restante. Atualmente, recomendamos configurar vm.swappiness = 1, porque isso praticamente o desativa, mas não causa os efeitos que ocorrem com a chegada inesperada do OOM-killer, que acaba eliminando tudo.
E agora? Quando falamos sobre o desempenho de bancos de dados e começamos a nos aprofundar nos discos, todos ficam preocupados. Pois a verdade de que o disco é lento e a memória é rápida é um conhecimento de longa data para todos. E todos sabem que haverá problemas de desempenho em disco nos bancos de dados.
O principal problema de desempenho do PostgreSQL, relacionado aos picos de checkpoints, não é causado pela lentidão do disco. Na verdade, isso acontece porque a taxa de transferência da memória e do disco não está balanceada. Além disso, esse desequilíbrio pode ocorrer em diferentes áreas. O PostgreSQL não está configurado corretamente, o sistema operacional não está otimizado, o hardware não está ajustado e o hardware é inadequado. Esse problema não ocorre apenas quando tudo está funcionando como deveria, ou seja, ou não há carga ou as configurações e o hardware estão bem ajustados.
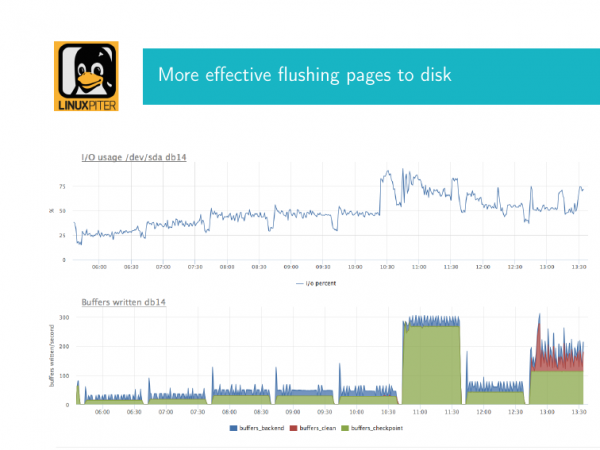
O que é isso e como se parece? Geralmente, as pessoas que trabalham com o PostgreSQL já passaram por isso várias vezes. Deixe-me esclarecer. Como eu mencionei, o PostgreSQL periodicamente faz checkpoints para despejar as páginas sujas na memória compartilhada no disco. Se temos um grande volume de memória compartilhada, o checkpoint começa a impactar intensamente o disco, porque despeja essas páginas usando fsync. Ele vai para o buffer do kernel e é gravado nos discos com fsync. E se o volume desse processo for grande, podemos observar um efeito indesejado, ou seja, uma utilização muito alta dos discos.
Aqui eu tenho duas imagens. Vou explicar o que são. Estas são duas gráficas correlacionadas no tempo. O primeiro gráfico mostra a utilização do disco. Neste momento, ela chega a quase 90%. Se você está vendo uma utilização de quase 90% nos discos físicos de um banco de dados com um controlador RAID, é uma má notícia. Isso significa que se atingir 100%, a leitura e gravação irão parar.
Se você tem um array de discos, a situação é um pouco diferente. Isso depende de como ele está configurado, que tipo de array é, etc.
E paralelamente, aqui é configurado um gráfico a partir de uma view interna do PostgreSQL, que mostra como o checkpoint ocorre. E em verde, é mostrado quantos buffers, essas páginas sujas, chegaram neste checkpoint para sincronização. E isso é o principal que você precisa saber. Vemos que recebemos muitas páginas e, em algum momento, esbarramos no limite, ou seja, continuamos escrevendo aqui e claramente o sistema de disco está muito ocupado. E nosso checkpoint tem um impacto significativo no disco. Idealmente, a situação deveria ser mais assim, ou seja, teríamos menos gravação. E podemos corrigir isso com as configurações, para que continue sendo assim. Ou seja, a utilização é baixa, mas ainda estamos escrevendo alguma coisa.
O que precisa ser feito para resolver esse problema? Se a IO do seu banco de dados parou, significa que todos os usuários que chegaram para executar suas consultas ficarão esperando.
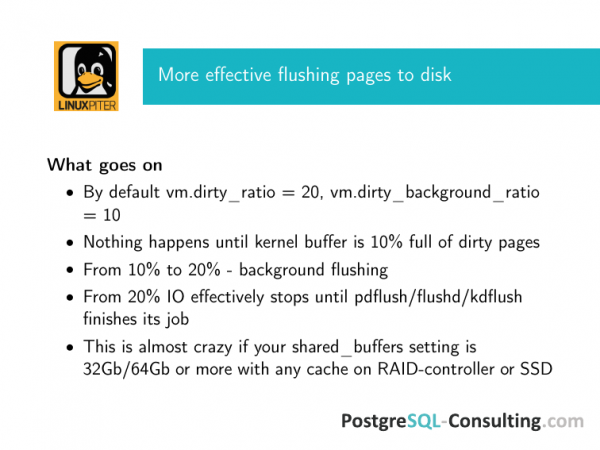
Se observarmos do ponto de vista do Linux, se você pegou um bom hardware, o configurou corretamente e ajustou o PostgreSQL para que ele fizesse checkpoints com menos frequência, espaçando-os ao longo do tempo, você acaba utilizando os parâmetros padrão do Debian. Para a maioria das distribuições Linux, a situação é: vm.dirty_ratio=20, vm.dirty_background_ratio=10.
O que isso significa? Desde o núcleo 2.6, surgiu um daemon de flushing. O pdglush, dependendo de quem o utiliza, é responsável pelo descarte em segundo plano de páginas sujas do buffer do kernel e pelo descarte, quando necessário, das páginas sujas, quando o descarte em segundo plano já não é suficiente.
Quando ocorre o background? Quando 10% de toda a memória RAM do servidor está ocupada por páginas sujas no buffer do kernel, uma função especial de descarte em background é chamada. Por que é em background? Ela recebe como parâmetro quantas páginas descartar. E, digamos, descarta N páginas. E por um tempo, essa operação dorme. Depois, ela volta e descarta mais uma certa quantidade de páginas.
É uma história extremamente simples. A situação é como em uma piscina, quando algo é despejado em um tubo e recebido em outro. Nosso checkpoint chegou e, se ele enviou poucas páginas sujas para descarte, isso será gradualmente processado do buffer do kernel pelo pgflush.
Se essas páginas sujas continuam se acumulando, elas podem chegar a 20%, após o que o sistema operacional prioriza registrar isso no disco, pois a energia pode falhar e tudo ficará comprometido. Podemos perder esses dados, por exemplo.
Qual é o truque? O truque consiste no fato de que esses parâmetros, que são 20% e 10% de toda a memória RAM disponível na máquina, são absolutamente insustentáveis do ponto de vista da capacidade de qualquer sistema de disco que você possui.
Imagine que você tem 128 GB de memória RAM. 12,8 GB são processados pelo seu sistema de disco. E, independentemente do cache que você tenha ou do array que você possui, eles não conseguirão suportar isso.
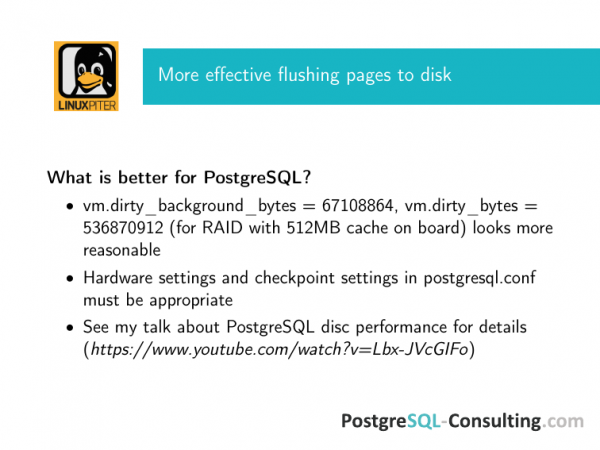
Portanto, recomendamos que esses números sejam ajustados de acordo com a capacidade do seu controlador RAID. Aqui, eu forneço uma recomendação para um controlador que possui 512 MB de cache.
Para isso, basta definir vm.dirty_background em bytes. Essas configurações anulam as duas anteriores. Ou o ratio padrão é usado, ou aqueles ativados em bytes, então funcionam os que estão em bytes. Mas, como sou um consultor DBA e trabalho com diferentes clientes, procuro ser cauteloso, portanto, se em bytes, então em bytes mesmo. Ninguém deu garantias de que um bom administrador não aumentará a memória do servidor, não o reiniciará, enquanto o número permanece o mesmo. Apenas calcule esses números para garantir que tudo se encaixa.
O que acontece se você não se encaixar? Está registrado que qualquer flushing é efetivamente interrompido, mas na verdade isso é uma expressão figurativa. O sistema operacional enfrenta um grande problema – há muitas páginas sujas, portanto, efetivamente se interrompe todo IO gerado por seus clientes, ou seja, se o aplicativo SQL enviar uma consulta ao banco de dados, ele ficará aguardando. Qualquer input-output nela tem a mais baixa prioridade, pois o banco está ocupado com o checkpoint. E quando isso terminar, é totalmente incerto. E quando você alcançar o flushing não em segundo plano, isso significa que todo IO está ocupado com isso. E enquanto não terminar, você não poderá fazer nada.
Existem também dois pontos importantes que estão além do escopo deste relatório. Essas configurações devem corresponder às configurações em postgresql.conf, ou seja, as configurações de checkpoints. E seu sistema de disco deve ser adequadamente configurado. Se você tem cache em RAID, deve haver uma bateria nele. As pessoas compram RAID com bom cache sem bateria. Se você tem SSD em RAID, eles devem ser de servidor, deve haver capacitores. Aqui está uma lista detalhada. Neste link está meu relatório sobre como configurar o desempenho do disco no PostgreSQL. Todos esses checklists estão lá.
O que mais pode complicar muito a vida? São dois parâmetros. Eles são relativamente novos. Por padrão, podem estar ativados em diferentes aplicativos. E podem complicar a vida tanto quanto se forem ativados incorretamente.
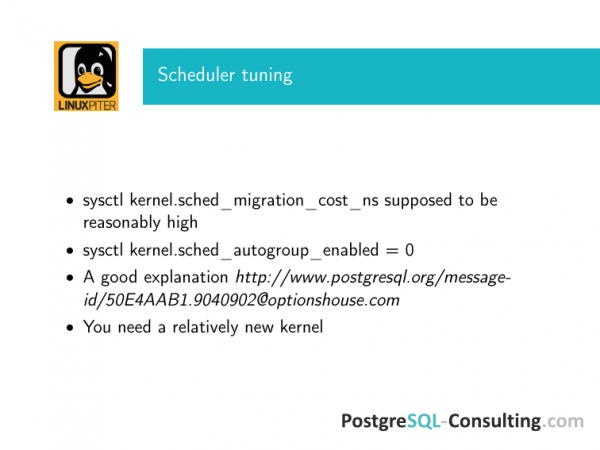
Existem duas coisas relativamente novas. Elas já apareceram nos núcleos três. São sched_migration_cost em nanosegundos e sched_autogroup_enabled, que por padrão é um.
E como eles complicam a vida? O que é sched_migration_cost? O scheduler do Linux pode migrar um processo de uma CPU para outra. E para o PostgreSQL, que executa consultas, a migração para outra CPU não faz sentido. Do ponto de vista do sistema operacional, quando você alterna janelas entre o openoffice e o terminal, isso pode ser bom, mas para o banco de dados – isso é muito ruim. Portanto, uma política razoável é definir migration_cost como um valor alto, pelo menos alguns milhares de nanosegundos.
O que isso significará para o scheduler? Ele vai considerar que, durante esse tempo, esse processo ainda está quente. Ou seja, se você tiver uma transação longa que está ocupada, o scheduler vai entender isso. Ele considerará que enquanto não passar esse timeout, não há necessidade de migrar esse processo. Se, nesse ínterim, o processo estiver fazendo algo, ele não será migrado, e continuará trabalhando na CPU que lhe foi designada. E o resultado será excelente.
O segundo ponto é o autogroup. Há uma boa ideia para cargas de trabalho específicas, que não têm relação com bancos de dados modernos – agrupar processos pelo terminal virtual de onde foram iniciados. Isso é conveniente para algumas tarefas. Na prática, o PostgreSQL é um sistema multiprocessado com prefork que é iniciado a partir de um único terminal. Você terá um bloqueio para escrita, ponto de verificação e todas as suas solicitações de cliente serão agrupadas em um único scheduler, em uma única CPU. E lá, elas vão aguardar pacientemente até que ela fique livre, causando interferência entre si e ocupando-a por mais tempo. Essa é uma situação que não é necessária diante de essa carga e, portanto, precisa ser desativada.
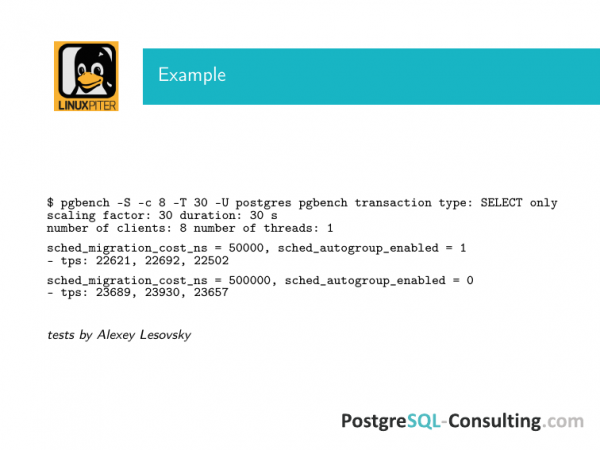
Meu colega Alexey Lesovsky fez testes com o pgbench padrão, onde aumentou a ordem de migration_cost e desativou o autogroup. A diferença em uma máquina fraca foi de quase 10%.. Há uma discussão na lista de discussão do PostgreSQL, onde as pessoas apresentam resultados sobre como essas alterações afetaram a velocidade das consultas. impactaram em 50%.. Há muitas dessas histórias.
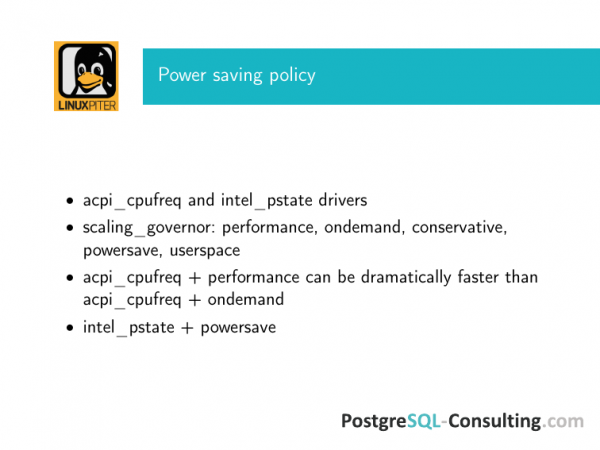
E por último, sobre a política de economia de energia. É bom que agora o Linux possa ser utilizado em laptops. E supostamente ele irá consumir a bateria de forma eficiente. Mas de repente, descobre-se que em servidores isso também pode acontecer.
Além disso, se você alugar servidores de algum provedor, os 'gentis' hospedagem não se preocupam em garantir que você tenha um desempenho melhor. O objetivo deles é maximizar a eficiência da utilização do hardware. Assim, por padrão, podem ativar o modo de economia de energia da versão para laptop no sistema operacional.
Se você estiver usando isso em um servidor com banco de dados sobre alta carga, sua escolha deve ser acpi_cpufreq + performance. Mesmo com ondemand, já haverá problemas.
Intel_pstate é um driver um pouco diferente. E agora a preferência é dada a este, pois é mais recente e funciona melhor.
E, consequentemente, o governor deve ser apenas performance. Ondemand, powersave e outras opções não são para você.
Os resultados do explain analyze no PostgreSQL podem variar em vários ordens de magnitude se você ativar o powersave, porque o CPU sob seu banco de dados será agendado de forma totalmente imprevisível.
Essas configurações podem ser ativadas por padrão. Verifique atentamente se elas foram ativadas por padrão. Isso pode ser realmente um grande problema.
E no final, eu gostaria de agradecer aos membros da nossa equipe de DBA da PosgreSQL-Consulting, especificamente ao Max Boguk e ao Alexey Lesovsky, que aprendem com as dificuldades todos os dias. E para nossos clientes, tentamos fazer o melhor para que tudo funcione perfeitamente. É como com as instruções de segurança de aviação. Tudo está escrito com sangue. Cada um desses problemas foi descoberto durante alguma dificuldade. Fico feliz em compartilhá-los com vocês.
Perguntas:
Obrigado! Se, por exemplo, uma empresa deseja economizar e hospedar tanto o banco de dados quanto a lógica de aplicação em um único servidor, ou se a empresa segue a tendência da arquitetura de microserviços, onde o PostgreSQL é executado em um contêiner. Qual é o ponto? O sysctl afeta globalmente todo o núcleo. Nunca ouvi dizer que sysctl possa ser virtualizado para funcionar separadamente em contêineres. Existem apenas cgroups e lá só há controle parcial. Como podemos conviver com isso? Ou se você deseja desempenho, deve executar o PostgreSQL em um servidor físico separado e otimizá-lo?
Respondemos à sua pergunta de aproximadamente três maneiras. Se não estamos falando de um servidor físico que pode ser ajustado, então relaxe, tudo funcionará bem sem essas configurações. Se você estiver enfrentando uma carga que exija tais ajustes, então você chegará a um servidor físico antes mesmo de precisar dessas configurações.
Qual é o problema? Se for uma máquina virtual, você provavelmente terá muitos problemas, por exemplo, a latência dos discos em muitas máquinas virtuais é bastante inconsistente. Mesmo que a largura de banda dos discos seja boa, uma transação falhada durante operações de entrada e saída, que não afeta muito a média da largura de banda, pode causar sérios problemas durante o checkpoint ou ao gravar no WAL, e você notará isso antes de se deparar com esses problemas.
Se você tiver o NGINX no mesmo servidor, também terá o mesmo problema. Ele competirá pela memória compartilhada. E você não chegará aos problemas descritos aqui.
Mas por outro lado, alguns desses parâmetros ainda serão relevantes para você. Por exemplo, configurar o dirty_ratio com sysctl para que não fique tão alto – de qualquer forma, isso ajudará. De qualquer jeito, você terá interação com o disco. E essa interação seguirá um padrão inadequado. Esses parâmetros que mostrei são, na verdade, os padrões. E, de qualquer forma, é melhor alterá-los.
Com NUMA podem surgir problemas. O VmWare, por exemplo, funciona bem com NUMA com configurações exatamente opostas. E aqui é preciso escolher – servidor físico ou não físico.
Tenho uma pergunta relacionada ao Amazon AWS. Eles têm imagens pré-configuradas. Uma delas se chama Amazon RDS. Existem configurações personalizadas para o sistema operacional deles?
Existem configurações lá, mas são configurações diferentes. Aqui estamos configurando o sistema operacional do ponto de vista de como o banco de dados vai usar isso. E lá há parâmetros que determinam para onde devemos ir agora, como um shaping. Ou seja, precisamos de tantos recursos, e agora vamos consumi-los. Depois disso, o Amazon RDS ajusta esses recursos, e a performance cai. Há histórias separadas de como as pessoas começam a manipular isso. Às vezes, até de forma bastante bem-sucedida. Mas isso não tem relação com as configurações do SO. É como se fosse uma hackeação na nuvem. É outra história.
Por que as Transparent Huge Pages não têm efeito em comparação com as Huge TLB?
Não têm. Isso pode ser explicado de várias maneiras. Mas, na prática, elas simplesmente não produzem efeito. Qual é a história do PostgreSQL? Ao iniciar, ele aloca um grande bloco de memória compartilhada. Se são Transparent ou não Transparent – isso não importa. O fato de serem alocadas na inicialização explica tudo. E se houver muita memória e for necessário reconstruir o segmento de shared_memory, então as Transparent Huge Pages se tornarão relevantes. No PostgreSQL, elas simplesmente são alocadas como um bloco grande no início e é isso, depois nada de muito especial acontece. Claro, pode-se usar, mas há a chance de ocorrer corrupção de shared_memory quando ele tentar realocar algo. O PostgreSQL não sabe disso.
Fonte: habr.com
