

Seis meses atrás — um serviço para PostgreSQL.
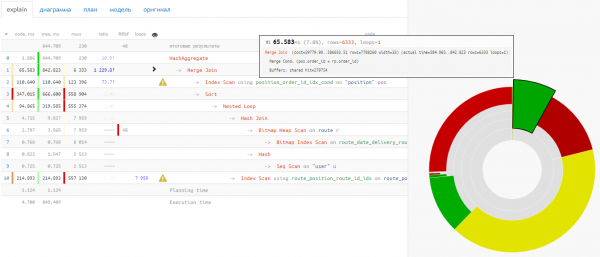
Nos meses que se passaram, fizemos uma apresentação sobre ele , preparamos um artigo abrangente com base nas recomendações que ele fornece… mas o mais importante é que coletamos seus feedbacks e observamos casos reais de uso.
E agora estamos prontos para falar sobre as novas funcionalidades que você pode aproveitar.
Suporte a diferentes formatos de planos
Plano do log, junto com a consulta
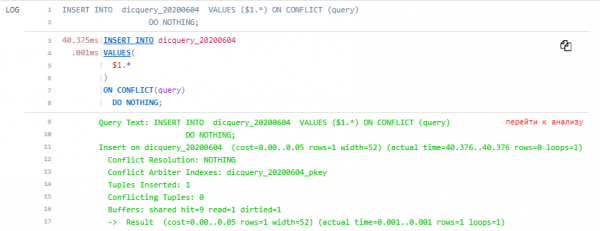
Diretamente do console, destacamos todo o bloco, começando a partir da linha com Query Text, com todos os espaços em branco à frente:
        Query Text: INSERT INTO  dicquery_20200604  VALUES ($1.*) ON CONFLICT (query)
                           DO NOTHING;
        Insert on dicquery_20200604  (cost=0.00..0.05 rows=1 width=52) (actual time=40.376..40.376 rows=0 loops=1)
          Conflict Resolution: NOTHING
          Conflict Arbiter Indexes: dicquery_20200604_pkey
          Tuples Inserted: 1
          Conflicting Tuples: 0
          Buffers: shared hit=9 read=1 dirtied=1
          ->  Result  (cost=0.00..0.05 rows=1 width=52) (actual time=0.001..0.001 rows=1 loops=1)
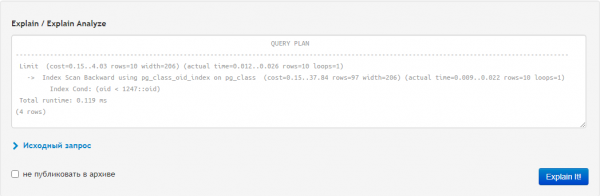
… e colocamos tudo o que foi copiado diretamente no campo do plano, sem separar nada:
No final, recebemos como bônus ao plano analisado também a guia 'contexto', onde nossa consulta é apresentada em todo seu esplendor:
JSON e YAML
EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT * FROM pg_class;
"[
{
"Plan": {
"Node Type": "Seq Scan",
"Parallel Aware": false,
"Relation Name": "pg_class",
"Alias": "pg_class",
"Startup Cost": 0.00,
"Total Cost": 1336.20,
"Plan Rows": 13804,
"Plan Width": 539,
"Actual Startup Time": 0.006,
"Actual Total Time": 1.838,
"Actual Rows": 10266,
"Actual Loops": 1,
"Shared Hit Blocks": 646,
"Shared Read Blocks": 0,
"Shared Dirtied Blocks": 0,
"Shared Written Blocks": 0,
"Local Hit Blocks": 0,
"Local Read Blocks": 0,
"Local Dirtied Blocks": 0,
"Local Written Blocks": 0,
"Temp Read Blocks": 0,
"Temp Written Blocks": 0
},
"Planning Time": 5.135,
"Triggers": [
],
"Execution Time": 2.389
}
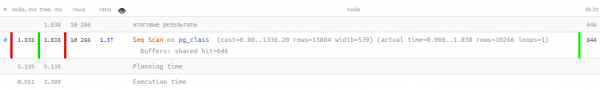
]"Tanto com aspas externas, como copia o pgAdmin, quanto sem — colocamos no mesmo campo, no final — beleza:
Visualização aprimorada
Planning Time / Execution Time
Agora é mais fácil ver para onde foi o tempo adicional durante a execução da consulta:
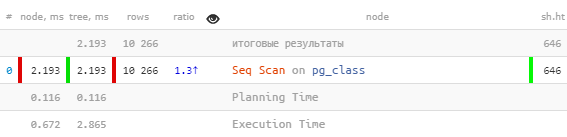
I/O Timing
Às vezes, enfrentamos situações em que no plano aparentemente não havia muitos recursos lidos ou escritos, mas o tempo de execução parece desproporcionalmente longo.
Aqui temos que dizer: "Oh, provavelmente naquele momento o disco no servidor estava muito sobrecarregado, por isso estava lendo tão devagar!" Mas isso não é muito preciso…
Mas podemos determinar isso de forma totalmente confiável. O fato é que entre as opções de configuração do servidor PG existem :
Inclui a medição do tempo de operações de entrada/saída. Este parâmetro está desativado por padrão, pois requer consultas constantes ao tempo atual do sistema operacional, o que pode ralentizar significativamente o desempenho em algumas plataformas. Para avaliar o custo da medição de tempo na sua plataforma, você pode usar a ferramenta pg_test_timing. As estatísticas de entrada/saída podem ser obtidas através da visualização pg_stat_database, na saída do EXPLAIN (quando o parâmetro BUFFERS é utilizado) e através da visualização pg_stat_statements.
Este parâmetro também pode ser ativado em uma sessão local:
SET track_io_timing = TRUE;Agora, a melhor parte: aprendemos a entender e exibir esses dados levando em conta todas as transformações da árvore de execução:
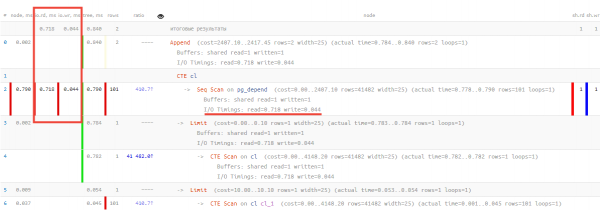
Aqui, podemos notar que dos 0.790ms do tempo total de execução, 0.718ms foram gastos na leitura de uma página de dados, 0.044ms — na gravação da mesma, e apenas 0.028ms na toda a atividade útil restante!
O futuro com PostgreSQL 13
Você pode conferir uma visão completa das novidades , enquanto nós falamos especificamente sobre as mudanças nos planos.
Planning buffers
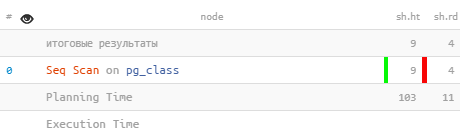
A consideração dos recursos alocados ao planejador se refletiu em mais um patch, que não está relacionado ao pg_stat_statements. O EXPLAIN com a opção BUFFERS reportará a quantidade de buffers utilizados na fase de planejamento:
 Seq Scan on pg_class (actual rows=386 loops=1)
   Buffers: shared hit=9 read=4
 Planning Time: 0.782 ms
   Buffers: shared hit=103 read=11
 Execution Time: 0.219 ms
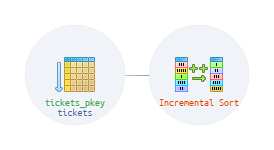
Classificação incremental
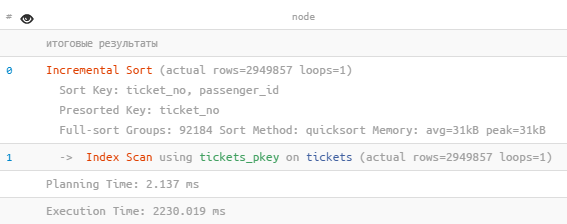
Nos casos em que é necessária uma ordenação por várias chaves (k1, k2, k3…), o planejador agora pode utilizar o conhecimento de que os dados já estão ordenados por algumas das primeiras chaves (por exemplo, k1 e k2). Nesse caso, pode-se evitar a reordenar todos os dados novamente, em vez disso, dividir os dados em grupos sequenciais com valores iguais de k1 e k2, e “classificá-los” pela chave k3.
Dessa forma, toda a ordenação se divide em várias ordenações sequenciais de menor dimensão. Isso reduz a quantidade de memória necessária e ainda permite que os primeiros dados sejam exibidos mais cedo, antes que toda a ordenação esteja concluída.
 Incremental Sort (actual rows=2949857 loops=1)
   Sort Key: ticket_no, passenger_id
   Presorted Key: ticket_no
   Full-sort Groups: 92184 Sort Method: quicksort Memory: avg=31kB peak=31kB
   ->  Index Scan using tickets_pkey on tickets (actual rows=2949857 loops=1)
 Planning Time: 2.137 ms
 Execution Time: 2230.019 ms
Melhorias na interface do usuário/experiência do usuário.
Capturas de tela, elas estão em toda parte!
Agora cada aba tem a opção de rapidamente capturar uma captura de tela da aba para a área de transferência em toda a largura e profundidade da aba — o "mira" no canto superior direito:
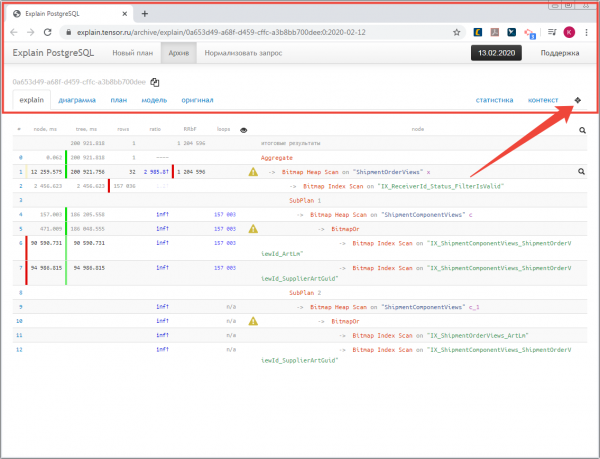
Na verdade, a maioria das imagens para esta publicação foi obtida exatamente assim.
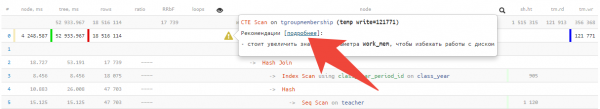
Recomendações nos nós
Não apenas aumentou a quantidade, mas também é possível , acessando o link:
Remoção do arquivo
Alguns pediram muito para adicionar a possibilidade de deletar "completamente" até mesmo os planos não publicados no arquivo — por favor, é suficiente clicar no ícone correspondente:
E não esqueçamos que temos , onde você pode enviar suas observações e sugestões.
Fonte: habr.com
