

Decodificação do relatório de 2015 de Alexey Lesovskiy "Aprofundamento nas estatísticas internas do PostgreSQL"
Isenção de responsabilidade do autor do relatório: Vale lembrar que este relatório é datado de novembro de 2015 — já se passaram mais de 4 anos e muito tempo. A versão discutida no relatório 9.4 já não é mais suportada. Nos últimos 4 anos, cinco novas versões foram lançadas, trazendo uma infinidade de inovações, melhorias e mudanças em relação às estatísticas, e parte do material se tornou desatualizada e irrelevante. Durante a revisão, procurei destacar esses pontos para não confundir você, leitor. Não reescrevi essas partes, pois existem muitas e isso resultaria em um relatório totalmente diferente.
O SGBD PostgreSQL é um mecanismo vasto, composto por muitas subsistemas, cujo funcionamento harmonioso depende diretamente da performance do SGBD. Durante a operação, é realizada a coleta de estatísticas e informações sobre o funcionamento dos componentes, o que permite avaliar a eficiência do PostgreSQL e tomar medidas para aumentar a performance. No entanto, essa informação é abundante e apresentada de forma bastante simplificada. Processar e interpretar essas informações pode ser uma tarefa não trivial, e o "zoológico" de ferramentas e utilitários pode facilmente confundir até mesmo um DBA experiente.
Bom dia! Meu nome é Alexey. Como disse Ilya, eu vou falar sobre as estatísticas do PostgreSQL.
Estatísticas de atividade do PostgreSQL. O PostgreSQL possui duas estatísticas. A estatística de atividade, sobre a qual falaremos. E a estatística do planejador sobre a distribuição de dados. Vou me concentrar na estatística de atividade do PostgreSQL, que nos permite avaliar a performance e como melhorá-la.
Vou explicar como usar as estatísticas de forma eficaz para resolver os mais diversos problemas que você pode estar enfrentando ou poderá enfrentar.
O que não estará no relatório? No relatório não abordarei a estatística do planejador, pois esse é um tema separado para um relatório distinto sobre como os dados são armazenados no banco e como o planejador de consultas obtém uma visão das características qualitativas e quantitativas desses dados.
E não haverá revisões de ferramentas, não compararei um produto com outro. Não haverá nenhuma publicidade. Vamos deixar isso de lado.
Quero mostrar a vocês que usar estatísticas é útil. É necessário. Usá-las não é assustador. Precisaremos apenas de SQL básico e um entendimento simples sobre SQL.
E vamos discutir qual estatística escolher para resolver problemas.
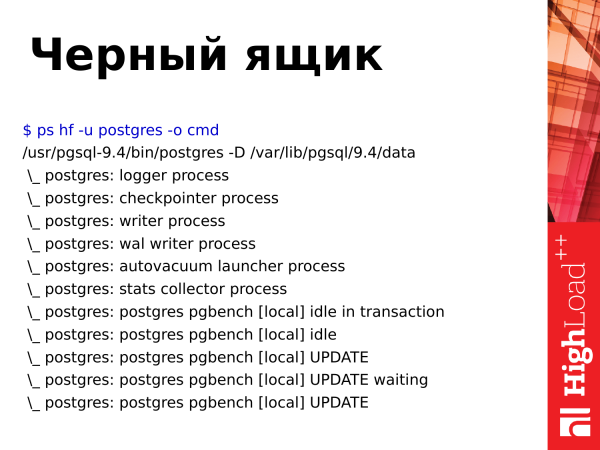
Se olharmos para o PostgreSQL e executarmos um comando no sistema operacional para ver os processos, veremos uma 'caixa preta'. Vemos alguns processos que estão fazendo algo e, pelo nome, podemos imaginar o que eles estão fazendo. Mas, na verdade, é uma caixa preta, não podemos olhar dentro.
Podemos observar a carga do processador em top, podemos verificar a utilização de memória com algumas utilidades do sistema, mas não conseguiremos ver o interior do PostgreSQL. Para isso, precisamos de outras ferramentas.
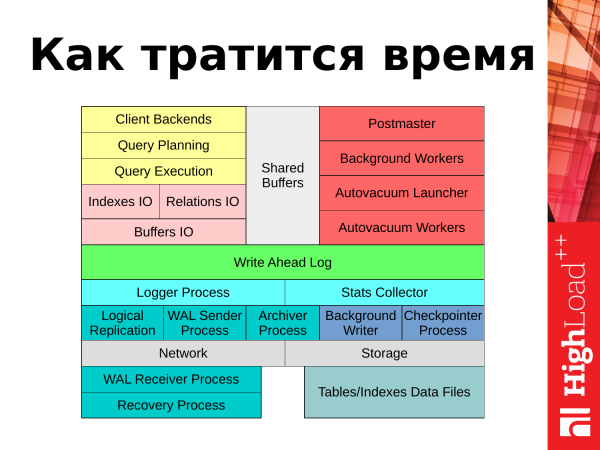
E continuando, falarei sobre onde o tempo é gasto. Se imaginarmos o PostgreSQL como um diagrama, poderemos responder aonde o tempo está sendo utilizado. São duas coisas: o processamento de solicitações de clientes por parte das aplicações e as tarefas em segundo plano que o PostgreSQL executa para manter sua operabilidade.
Se começarmos a considerar a partir do canto superior esquerdo, podemos rastrear como as solicitações de clientes são processadas. A solicitação vem do aplicativo e, para continuar, uma sessão de cliente é aberta. A solicitação é enviada para o planejador. O planejador constrói o plano da solicitação. Ele é enviado para execução. Ocorre alguma entrada/saída em bloco relacionada a tabelas e índices. Os dados necessários são lidos dos discos para a memória em uma área especial chamada 'shared buffers'. Os resultados da solicitação, se forem atualizações ou exclusões, são registrados no log de transações no WAL. Algumas informações estatísticas vão para o log ou para o coletor de estatísticas. E o resultado da solicitação é devolvido ao cliente. Após isso, o cliente pode repetir tudo com uma nova solicitação.
O que temos sobre as tarefas em segundo plano e os processos em segundo plano? Temos vários processos que garantem a operação e mantêm o banco de dados em um estado operante normal. Esses processos também serão mencionados na palestra: são o autovacuum, checkpointer, processos relacionados à replicação e background writer. Cada um deles será abordado ao longo da apresentação.
Quais problemas existem com as estatísticas?
- Há muita informação. O PostgreSQL 9.4 fornece 109 métricas para visualização dos dados estatísticos. No entanto, se houver muitas tabelas, esquemas e bancos de dados armazenados, todas essas métricas terão que ser multiplicadas pelo respectivo número de tabelas e bancos. Ou seja, a informação se torna ainda maior. E é muito fácil se afogar nela.
- O próximo problema é que a estatística é apresentada por contadores. Se olharmos para essa estatística, veremos contadores que aumentam constantemente. E se muito tempo passou desde o último reset dos contadores, podemos ver valores na casa dos bilhões. E isso não nos diz nada.
- Falta histórico. Se ocorreu alguma falha, algo que caiu 15-30 minutos atrás, não será possível usar a estatística para ver o que aconteceu 15-30 minutos atrás. Isso é um problema.
- A ausência de uma ferramenta integrada no PostgreSQL é um problema. Os desenvolvedores do núcleo não fornecem nenhuma utilidade. Eles não têm nada desse tipo. Eles simplesmente fornecem a estatística no banco. Utilize-a, faça consultas, faça o que quiser.
- Como não há uma ferramenta integrada no PostgreSQL, isso causa outro problema. Muitos instrumentos de terceiros. Cada empresa com habilidades mais ou menos adequadas tenta criar seu próprio programa. E, no final, há muitos instrumentos na comunidade que podem ser usados para trabalhar com estatísticas. E alguns instrumentos oferecem certas funcionalidades, outros não, ou têm novas funcionalidades. Surge assim a situação de que é preciso usar dois, três ou quatro instrumentos que se sobrepõem e têm diferentes funções. Isso é muito desagradável.
O que se conclui disso? É importante saber como obter estatísticas diretamente, para não depender de programas ou, de alguma forma, melhorar esses programas: adicionar certas funções para obter seu benefício.
E são necessários conhecimentos básicos de SQL. Para obter certos dados da estatística, é necessário elaborar consultas SQL, ou seja, você precisa saber como fazer selects e joins.
A estatística nos oferece algumas coisas. Elas podem ser divididas em categorias.
- A primeira categoria refere-se a eventos que ocorrem no banco de dados. Isso acontece quando ocorre algum evento no banco: uma consulta, uma chamada à tabela, o autovacuum, commits, e todos esses são eventos. Os contadores correspondentes a esses eventos são incrementados. E podemos rastrear esses eventos.
- A segunda categoria são as propriedades dos objetos, como tabelas e bancos. Eles têm propriedades, como o tamanho das tabelas. Podemos rastrear o crescimento das tabelas e índices. Podemos verificar as mudanças na dinâmica.
- E a terceira categoria é o tempo gasto em um evento. Uma consulta é um evento. Ele tem uma medida específica de duração. Aqui começou, aqui terminou. Podemos rastrear isso. Ou o tempo de leitura de um bloco do disco ou gravação. Esses aspectos também são monitorados.
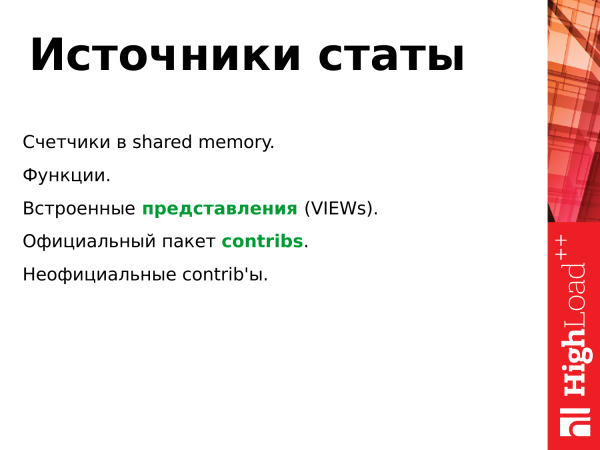
As fontes de estatísticas são apresentadas da seguinte forma:
- Na memória compartilhada (shared buffers), há um segmento para alocar dados estatísticos. Existem também aqueles contadores que são constantemente incrementados quando ocorrem certos eventos ou surgem algumas questões no funcionamento do banco.
- Todos esses contadores não estão disponíveis para o usuário e nem mesmo para o administrador. São aspectos de baixo nível. Para acessá-los, o PostgreSQL fornece uma interface na forma de funções SQL. Podemos fazer seleções usando essas funções e obter alguma métrica (ou conjunto de métricas).
- No entanto, usar essas funções nem sempre é conveniente, portanto, as funções servem como base para visões (VIEWs). Estas são tabelas virtuais que fornecem estatísticas de um subsistema específico ou de um conjunto de eventos no banco de dados.
- Essas visões embutidas (VIEWs) são a principal interface do usuário para trabalhar com estatísticas. Elas estão disponíveis por padrão sem configuração adicional; você pode usá-las imediatamente, visualizar e retirar informações delas. E também há contribuições. As contribuições são oficiais. Você pode instalar o pacote postgresql-contrib (por exemplo, postgresql94-contrib), carregar o módulo necessário na configuração, especificar os parâmetros para ele, reiniciar o PostgreSQL e começar a usar. (Nota. Dependendo da distribuição, nas versões mais recentes, o pacote contrib é parte do pacote principal.).
- Existem contribuições não oficiais que não vêm na instalação padrão do PostgreSQL. Elas precisam ser compiladas ou instaladas como bibliotecas. As opções podem variar bastante, dependendo do que o desenvolvedor dessa contribuição não oficial criou.
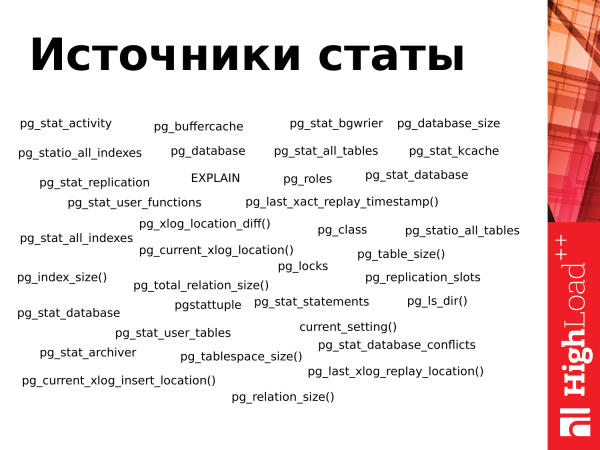
Neste slide estão apresentadas todas as views e algumas das funções que estão disponíveis no PostgreSQL 9.4. Como podemos ver, são muitas. E é bastante fácil se confundir se você se deparar com isso pela primeira vez.
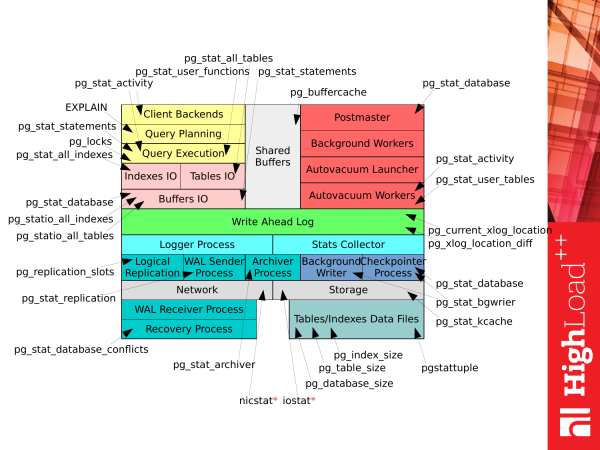
No entanto, se pegarmos a imagem anterior Como o tempo é gasto no PostgreSQL e combinarmos com esta lista, teremos a seguinte imagem. Cada view ou função pode ser utilizada para obter as estatísticas correspondentes enquanto estamos usando o PostgreSQL. E podemos já obter algumas informações sobre o funcionamento do subsistema.
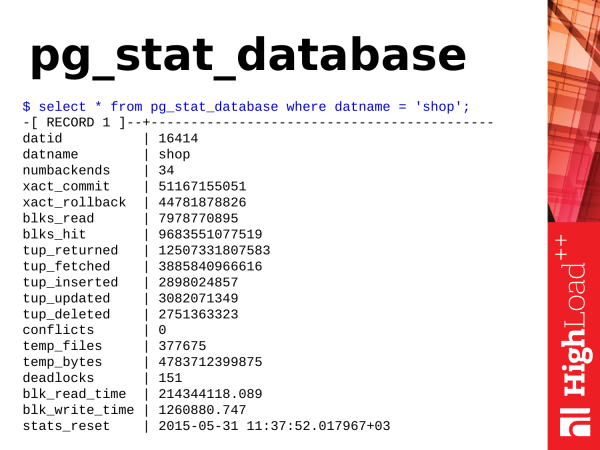
Primeiro, vamos examinar pg_stat_database. Como podemos ver, esta é uma view. Ela contém uma grande quantidade de informações. Informações muito variadas. E proporciona um conhecimento muito útil sobre o que está acontecendo no banco de dados.
O que podemos tirar de útil daí? Vamos começar pelas coisas mais simples.
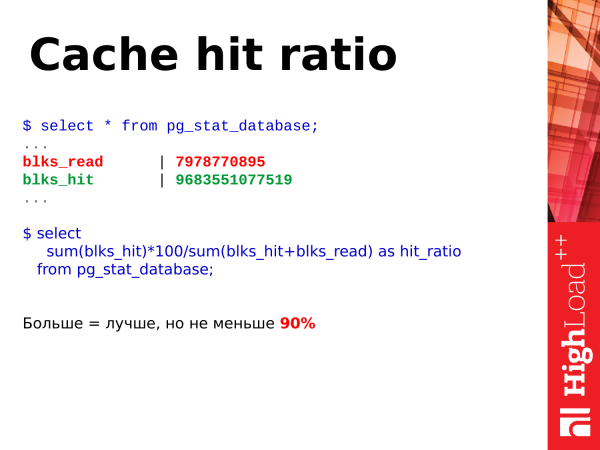
select
sum(blks_hit)*100/sum(blks_hit+blks_read) as hit_ratio
from pg_stat_database;
A primeira coisa que podemos observar é a taxa de acerto no cache. A taxa de acerto no cache é uma métrica útil. Ela permite avaliar qual volume de dados é obtido do cache de buffers compartilhados e qual volume é lido do disco.
É evidente que quanto maior a nossa taxa de acerto no cache, melhor. Avaliamos essa métrica como uma porcentagem. E, por exemplo, se nossa taxa de acerto no cache for superior a 90%, isso é bom. Se cair abaixo de 90%, significa que não temos memória suficiente para manter a 'cabeça' quente dos dados na memória. E para utilizar esses dados, o PostgreSQL precisa acessar o disco, o que é mais lento do que se os dados fossem lidos da memória. Já devemos começar a pensar em aumentar a memória: seja aumentando os buffers compartilhados ou aumentando a memória física (RAM).
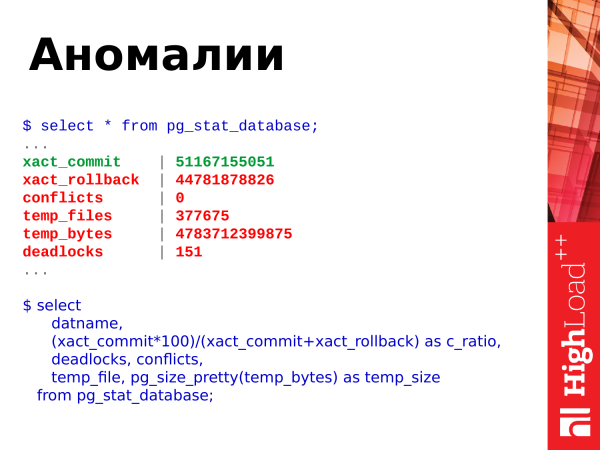
select
datname,
(xact_commit*100)/(xact_commit+xact_rollback) as c_ratio,
deadlocks, conflicts,
temp_file, pg_size_pretty(temp_bytes) as temp_size
from pg_stat_database;
O que mais podemos extrair dessa view? Podemos observar as anomalias que ocorrem na base. O que está mostrado aqui? Existem commits, rollbacks, criação de arquivos temporários, seu volume, deadlocks e conflitos.
Podemos usar esta consulta. Este SQL é bastante simples. E podemos ver esses dados por conta própria.
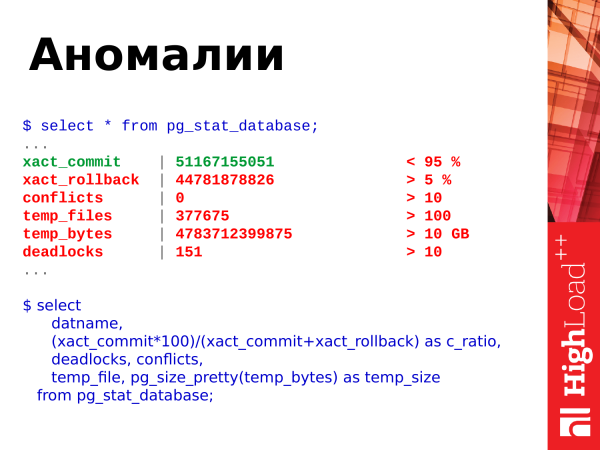
E aqui já estão os valores limites. Estamos observando a relação entre commits e rollbacks. Commits são a confirmação bem-sucedida de uma transação. Rollbacks são o retorno, ou seja, a transação fez algum trabalho, utilizou o banco de dados, fez alguns cálculos, e então ocorreu uma falha, e os resultados da transação são descartados. Ou seja, um número crescente de rollbacks é prejudicial. E devemos de algum modo evitá-los e corrigir o código para que isso não aconteça.
Os conflitos (conflicts) estão relacionados à replicação. E também devem ser evitados. Se você tiver alguma consulta que está sendo executada na réplica e surgirem conflitos, você precisa analisá-los, ver o que está acontecendo. Os detalhes podem ser encontrados nos logs. E solucionar situações conflitantes para que as consultas do aplicativo funcionem sem erros.
Deadlocks também são uma situação ruim. Quando as consultas competem por recursos, uma consulta acessa um recurso e obtém um bloqueio, a segunda consulta acessa um segundo recurso e também obtém um bloqueio, e então ambas as consultas tentam acessar os recursos uma da outra e ficam bloqueadas aguardando que a outra libere o bloqueio. Esta também é uma situação problemática. Elas precisam ser resolvidas a nível de reescrita de aplicações e serialização de acesso aos recursos. E se você perceber que seus deadlocks estão aumentando constantemente, precisa verificar os detalhes nos logs, analisar as situações que surgem e ver qual é o problema.
Arquivos temporários (temp_files) também são ruins. Quando uma consulta do usuário não tem memória suficiente para armazenar dados temporários em RAM, ela cria um arquivo no disco. E todas as operações que poderiam ser realizadas em um buffer temporário na memória, começam a ser feitas no disco. Isso é lento. Isso aumenta o tempo de execução da consulta. E o cliente que enviou a consulta ao PostgreSQL receberá uma resposta um pouco mais tarde. Se todas essas operações forem realizadas na memória, o Postgres responderá muito mais rápido e o cliente aguardará menos.
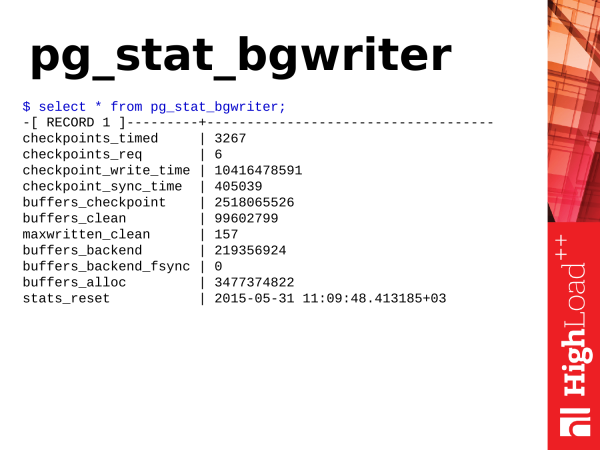
Pg_stat_bgwriter é uma exibição que descreve o funcionamento de dois subsistemas em segundo plano do PostgreSQL: são checkpointer e background writer.
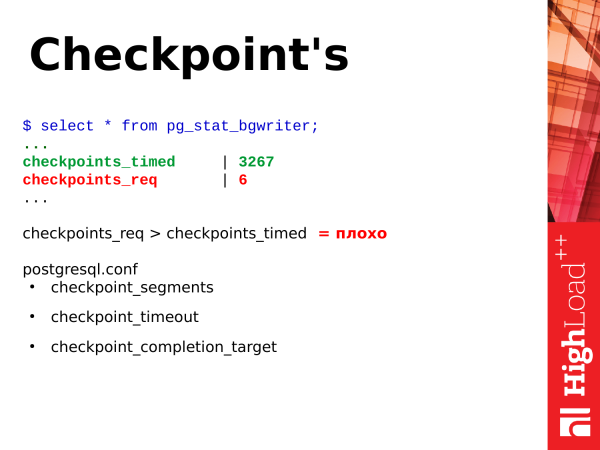
Para começar, vamos analisar os pontos de verificação, os chamados. checkpoints. O que são pontos de verificação? Um ponto de verificação é uma posição no log de transações que informa que todas as alterações de dados registradas no log foram sincronizadas com sucesso com os dados no disco. O processo pode ser prolongado, dependendo da carga de trabalho e das configurações, e envolve principalmente a sincronização de páginas
sujas nos buffers compartilhados com os arquivos de dados no disco. Para que isso serve? Se o PostgreSQL acessasse o disco o tempo todo para obter dados e gravar dados a cada acesso, isso seria lento. Portanto, o PostgreSQL tem um segmento de memória cujo tamanho depende das configurações na configuração. O Postgres coloca nessa memória dados operacionais para processamento ou entrega subsequente em resposta a consultas. Em caso de consultas para alteração de dados, essas alterações são realizadas. E obtemos duas versões de dados. Uma está na memória, a outra no disco. E periodicamente precisamos sincronizar esses dados. Precisamos sincronizar o que foi alterado na memória no disco. Para isso existem pontos de verificação.
Existem dois tipos de pontos de verificação. Um ponto de verificação é executado com base em um intervalo de tempo. Este ponto de verificação é útil e bom - checkpoint_timed. E há pontos de verificação sob demanda - checkpoint required. Esse tipo de ponto de verificação ocorre quando estamos realizando uma gravação muito grande de dados. Gravamos muitos logs de transações. E o PostgreSQL considera que precisa sincronizar tudo isso o mais rápido possível, fazer um ponto de verificação e continuar.
E se você verificou a estatística pg_stat_bgwriter e viu que você tem checkpoint_req muito maior que checkpoint_timed, isso é ruim. Por que isso é ruim? Isso significa que o PostgreSQL está em uma situação de estresse constante, onde precisa gravar dados no disco. Um ponto de verificação baseado em intervalo de tempo é menos estressante e é executado de acordo com uma programação interna, sendo estendido ao longo do tempo. O PostgreSQL tem a capacidade de fazer pausas no trabalho e não sobrecarregar o subsistema de disco. Isso é benéfico para o PostgreSQL. E as requisições que são realizadas durante o ponto de verificação não sofrerão estresse por conta do subsistema de disco estar ocupado.
E para o ajuste do checkpoint há três parâmetros:
checkpoint_segments.checkpoint_timeout.checkpoint_competion_target.
Eles permitem regular o funcionamento dos checkpoints. Mas não vou me aprofundar neles. O seu impacto é um tema à parte.
Atenção: A versão analisada no relatório, 9.4, já não é mais atual. Nas versões modernas do PostgreSQL, o parâmetro checkpoint_segments foi substituído pelos parâmetros min_wal_size e max_wal_size.
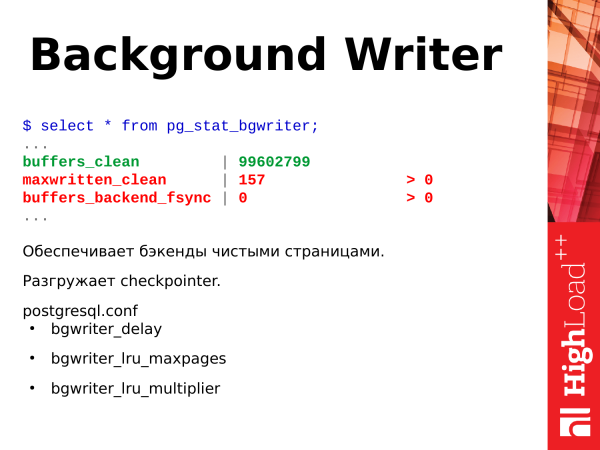
O próximo subsistema é o gravador em segundo plano — background writer. O que ele faz? Ele opera constantemente em um ciclo infinito. Ele verifica as páginas nos buffers compartilhados e grava as páginas sujas que encontra no disco. Assim, ele ajuda o checkpointer a realizar menos trabalho durante a execução dos checkpoints.
Para que mais ele é necessário? Ele atende à necessidade de páginas limpas nos buffers compartilhados, caso elas sejam necessárias (em grande quantidade e de uma vez) para armazenar dados. Suponha que surja uma situação em que páginas limpas sejam necessárias para concluir uma consulta e já estejam nos buffers compartilhados. O PostgreSQL backend simplesmente as pega e utiliza, não sendo necessário limpar nada por conta própria. Mas se não houver tais páginas, o backend pausa o trabalho e começa a procurar páginas para gravar no disco e usar para suas necessidades — o que impacta negativamente no tempo de execução da consulta em andamento. Se você notar que o seu parâmetro maxwritten_clean é alto, isso significa que o gravador em segundo plano não está conseguindo cumprir a sua função e é necessário aumentar os parâmetros bgwriter_lru_maxpages, para que ele possa realizar mais trabalho em um único ciclo, limpando mais páginas.
E outro indicador muito útil é o buffers_backend_fsync. Os backends não realizam fsync porque isso é lento. Eles encaminham o fsync para cima na pilha de IO para o checkpointer. O checkpointer tem sua própria fila, ele periodicamente processa o fsync e sincroniza as páginas na memória com os arquivos no disco. Se a fila do checkpointer estiver grande e cheia, o backend é forçado a realizar o fsync por conta própria, o que desacelera o desempenho do backend,, ou seja, o cliente receberá uma resposta mais tarde do que poderia. Se você notar que esse valor é maior que zero, é um sinal de problema e é necessário prestar atenção nas configurações do gravador em segundo plano e também avaliar o desempenho do sistema de armazenamento.
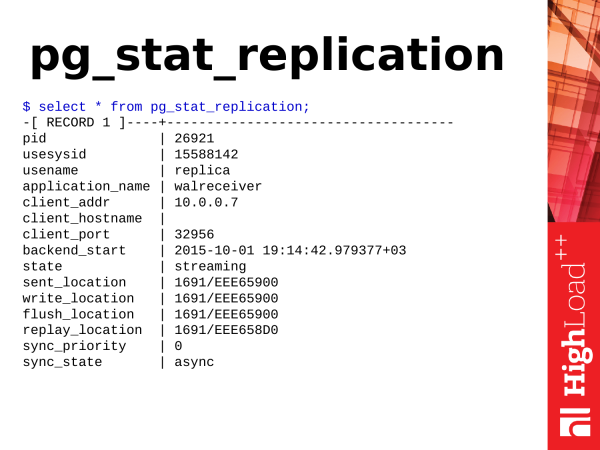
Atenção: _O texto a seguir descreve representações estatísticas relacionadas à replicação. A maior parte dos nomes de representações e funções foi renomeada no Postgres 10. A essência das renomeações consistiu na substituição xlog para wal e localização para nos nomes das funções/representações e afins. Um exemplo específico, a função pg_xlog_location_diff() foi renomeada para pg_wal_lsn_diff() Aqui também temos muitas informações. Mas precisamos apenas dos itens relacionados à localização.._
Se vemos que todos os valores são iguais, esse é o cenário ideal e a réplica não está atrasada em relação ao mestre.
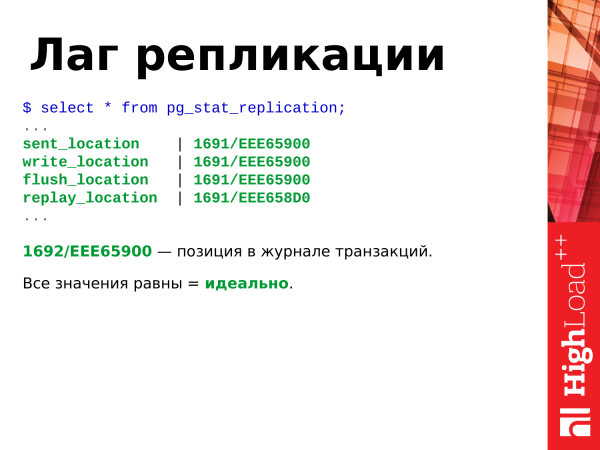
Esta posição hexadecimal – é a posição no log de transações. Ela aumenta constantemente se houver alguma atividade no banco de dados: inserções, deleções, etc.
quanto foi gravado no xlog em bytes $ select pg_xlog_location_diff(pg_current_xlog_location(),'0/00000000'); lag de replicação em bytes $ select client_addr, pg_xlog_location_diff(pg_current_xlog_location(), replay_location) from pg_stat_replication; lag de replicação em segundos $ select extract(epoch from now() - pg_last_xact_replay_timestamp());
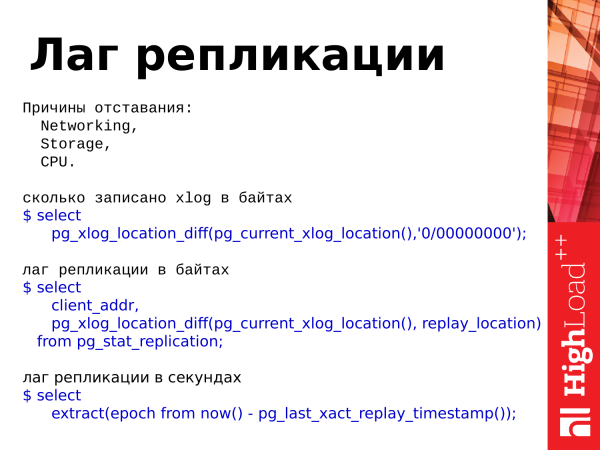
Se essas coisas forem diferentes, significa que há algum lag. Lag é o atraso da réplica em relação ao mestre, ou seja, os dados são diferentes entre os servidores.Existem três razões para o atraso:
É a subsistema de disco que não está conseguindo gravar a sincronização dos arquivos.
- Podem haver erros de rede ou sobrecarga da rede, quando os dados não conseguem chegar à réplica e ela não pode reproduzi-los.
- E o processador. O processador – este é um caso muito raro. Eu vi isso duas ou três vezes, mas isso também pode acontecer.
- E aqui estão três consultas que nos permitem usar a estatística. Podemos avaliar quanto foi gravado no nosso log de transações. Existe uma função
pg_xlog_location_diff e podemos avaliar o lag de replicação em bytes e segundos. Para isso, também usamos o valor desta representação (VIEWs). _Em vez da função pg_xlog_location
Nota: diff(), podemos usar o operador de subtração e subtrair uma localização da outra. É conveniente.Com o lag em segundos, há um ponto. Se no mestre não ocorrer nenhuma atividade, a transação foi realizada há cerca de 15 minutos e não há atividade, e se olharmos esse lag na réplica, veremos um lag de 15 minutos. É importante lembrar disso. E isso pode causar confusão ao observar esse lag.
Com o lag, que é medido em segundos, há um ponto importante. Se não há nenhuma atividade no master, e a transação ocorreu há cerca de 15 minutos sem qualquer atividade, quando olhamos para esse lag na réplica, veremos um lag de 15 minutos. É importante ter isso em mente. Isso pode causar confusão quando você analisa esse lag.
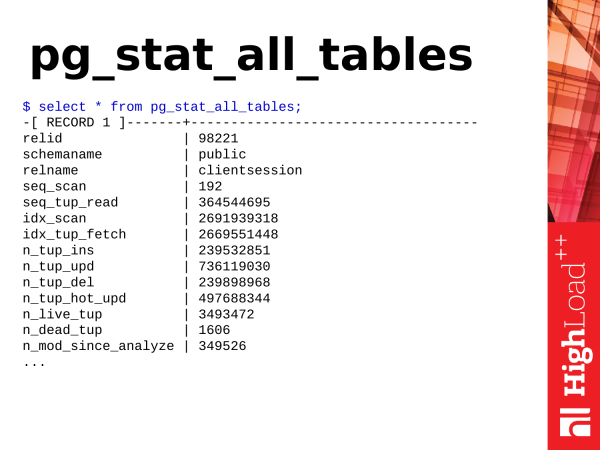
Pg_stat_all_tables – mais uma visão útil. Ele mostra estatísticas das tabelas. Quando há alguma atividade ou ações em nossas tabelas no banco de dados, podemos obter essas informações a partir desta visão.
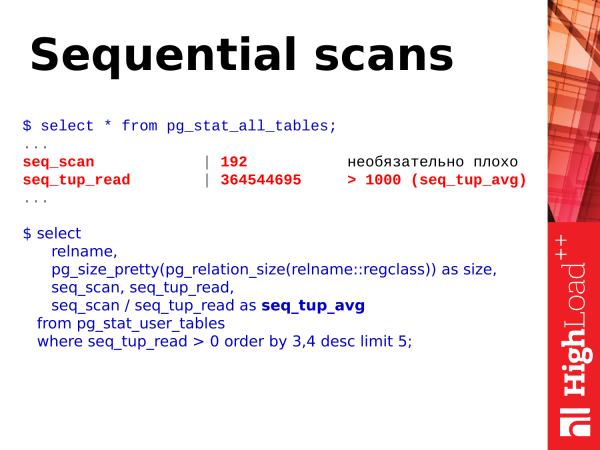
select
relname,
pg_size_pretty(pg_relation_size(relname::regclass)) as size,
seq_scan, seq_tup_read,
seq_scan / seq_tup_read as seq_tup_avg
from pg_stat_user_tables
where seq_tup_read > 0 order by 3, 4 desc limit 5;
A primeira coisa que podemos verificar são as varreduras sequenciais da tabela. O número em si após essas passagens não é necessariamente ruim e não indica que precisamos tomar alguma ação imediatamente.
No entanto, existe uma segunda métrica – seq_tup_read. Este é o número de linhas retornadas como resultado da varredura sequencial. Se a média ultrapassar 1.000, 10.000, 50.000, 100.000, isso já indica que talvez você precise criar um índice para que os acessos sejam feitos por índice, ou possivelmente otimizar as consultas que usam tais varreduras sequenciais para evitar essa situação.
Um exemplo simples – suponha que uma consulta com um grande OFFSET e LIMIT seja executada. Por exemplo, 100.000 linhas são varridas na tabela e, a seguir, 50.000 linhas necessárias são obtidas, enquanto as linhas anteriormente varridas são descartadas. Isso também é um caso desfavorável. E tais consultas precisam ser otimizadas. Aqui está uma consulta SQL simples que pode ser utilizada para verificar e avaliar os números obtidos.
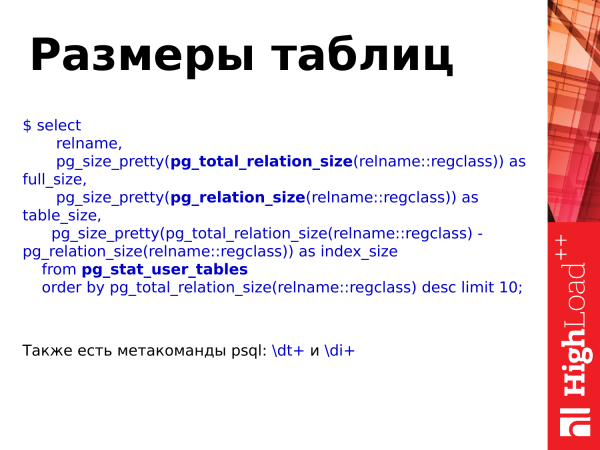
select
relname,
pg_size_pretty(pg_total_relation_size(relname::regclass)) as
full_size,
pg_size_pretty(pg_relation_size(relname::regclass)) as
table_size,
pg_size_pretty(pg_total_relation_size(relname::regclass) -
pg_relation_size(relname::regclass)) as index_size
from pg_stat_user_tables
order by pg_total_relation_size(relname::regclass) desc limit 10;
Os tamanhos das tabelas também podem ser obtidos através desta tabela e com funções adicionais. pg_total_relation_size(), pg_relation_size().
Existem, de fato, metacomandos dt e di, que podem ser utilizados no PSQL para visualizar os tamanhos das tabelas e índices.
No entanto, o uso de funções nos ajuda a examinar os tamanhos das tabelas, levando em consideração índices, ou sem levar em conta os índices, e já fazer algumas avaliações com base no crescimento do banco de dados, ou seja, como ele está crescendo, com que intensidade e já tirar algumas conclusões sobre a otimização dos tamanhos.
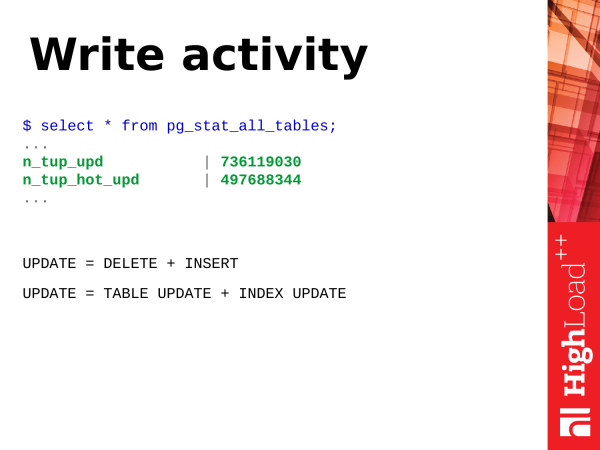
Atividade de gravação. O que é gravação? Vamos considerar a operação ATUALIZAÇÃO – operação de atualização de linhas na tabela. Na verdade, o update é composto por duas operações (ou até mais). É a inserção de uma nova versão da linha e a marcação da versão antiga como obsoleta. Posteriormente, o autovacuum virá e limpará essas versões obsoletas de linhas, marcando esse espaço como disponível para reutilização.
Além disso, update não é apenas a atualização da tabela. É também a atualização dos índices. Se você tiver muitos índices na tabela, então ao atualizar, todos os índices que envolvem os campos atualizados na consulta também precisarão ser atualizados. Esses índices também terão versões obsoletas de linhas que precisarão ser limpas.
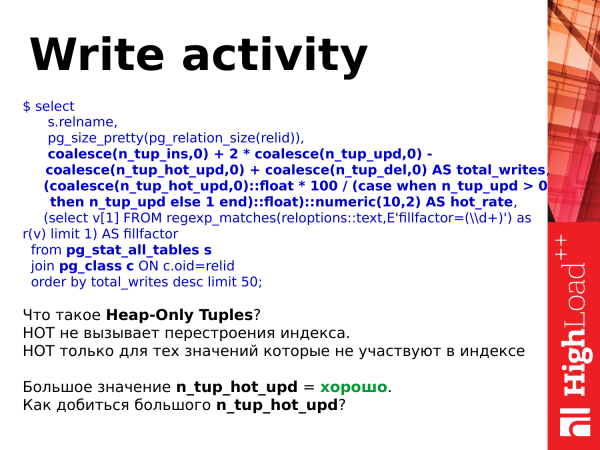
select
s.relname,
pg_size_pretty(pg_relation_size(relid)),
coalesce(n_tup_ins,0) + 2 * coalesce(n_tup_upd,0) -
coalesce(n_tup_hot_upd,0) + coalesce(n_tup_del,0) AS total_writes,
(coalesce(n_tup_hot_upd,0)::float * 100 / (case when n_tup_upd > 0
then n_tup_upd else 1 end)::float)::numeric(10,2) AS hot_rate,
(select v[1] FROM regexp_matches(reloptions::text,E'fillfactor=(\d+)') as
r(v) limit 1) AS fillfactor
from pg_stat_all_tables s
join pg_class c ON c.oid=relid
order by total_writes desc limit 50;
E devido ao seu design, UPDATE – essas são operações pesadas. Mas elas podem ser facilitadas. Há hot updates. Eles surgiram na versão 8.3 do PostgreSQL. E o que são? Trata-se de um update leve, que não provoca a reconstrução dos índices. Ou seja, atualizamos um registro, mas apenas o registro na página (que pertence à tabela) é atualizado, enquanto os índices continuam apontando para o mesmo registro na página. Há uma lógica interessante de como isso funciona: quando o vacuum vem, ele reestrutura essas cadeias hot e tudo continua funcionando sem a atualização dos índices, resultando em um menor consumo de recursos.
E quando você tem n_tup_hot_upd alto, isso é muito bom. Isso significa que os updates leves predominam e isso sai mais barato em recursos.
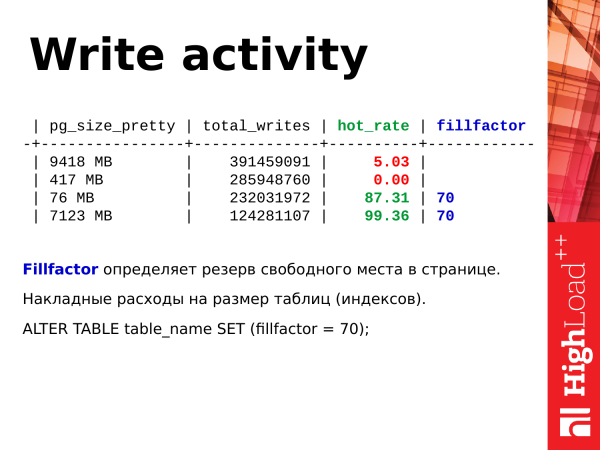
ALTER TABLE table_name SET (fillfactor = 70);Como aumentar a quantidade de hot updates? Podemos usar fillfactor. Ele define o tamanho do espaço livre reservado ao preencher uma página na tabela com INSERTs. Quando os inserts são feitos na tabela, eles preenchem completamente a página, não deixando espaço vazio nela. Depois, uma nova página é alocada. Novamente, os dados são preenchidos. E esse comportamento, por padrão, é fillfactor = 100%.
Podemos configurar o fillfactor em 70%. Ou seja, ao inserir novos dados, uma nova página é alocada, mas apenas 70% dessa página é preenchida. E 30% fica reservado. Quando precisar fazer uma atualização, é muito provável que ocorra na mesma página, e a nova versão da linha ocupará essa mesma página. Assim, será realizado um hot_update. Isso facilita a gravação nas tabelas.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
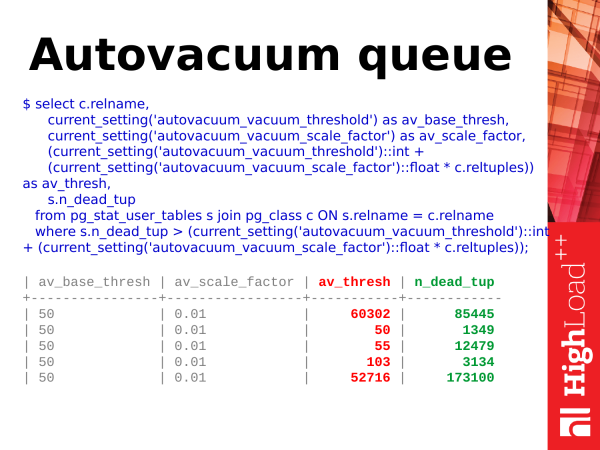
Fila do autovacuum. O autovacuum é uma subsistema que, segundo a estatística do PostgreSQL, possui muito pouca informação. Podemos apenas ver nas tabelas pg_stat_activity quantos vacuums estão ocorrendo no momento. Porém, é muito difícil entender quantas tabelas estão na fila.
Nota: _A partir da versão Postgres 10, a situação de monitoramento do autovacuum melhorou significativamente — surgiu a visão pg_stat_progressvacuum, que simplifica consideravelmente a questão do monitoramento do autovacuum.
Podemos usar esta consulta simplificada. E podemos ver quando o vacuum deve ser realizado. Mas, como e quando o vacuum deve ser iniciado? Aqui estão as versões obsoletas das linhas mencionadas anteriormente. Uma atualização ocorreu, uma nova versão da linha foi inserida. A versão obsoleta da linha apareceu. Na tabela pg_stat_user_tables existe um parâmetro n_dead_tup. Ele mostra a quantidade de linhas "mortas". E assim que o número de linhas mortas ultrapassa um determinado limiar, o autovacuum será acionado na tabela.
E como é calculado esse limiar? É uma relação percentual específica em relação ao total de linhas na tabela. Existe um parâmetro autovacuum_vacuum_scale_factor. Ele determina essa relação percentual. Digamos, 10% + um limiar base adicional de 50 linhas. E o que acontece? Quando temos mais linhas mortas do que "10% + 50" do total de linhas na tabela, colocamos a tabela no autovacuum.
select c.relname,
current_setting('autovacuum_vacuum_threshold') as av_base_thresh,
current_setting('autovacuum_vacuum_scale_factor') as av_scale_factor,
(current_setting('autovacuum_vacuum_threshold')::int +
(current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples))
as av_thresh,
s.n_dead_tup
from pg_stat_user_tables s join pg_class c ON s.relname = c.relname
where s.n_dead_tup > (current_setting('autovacuum_vacuum_threshold')::int
+ (current_setting('autovacuum_vacuum_scale_factor')::float * c.reltuples));
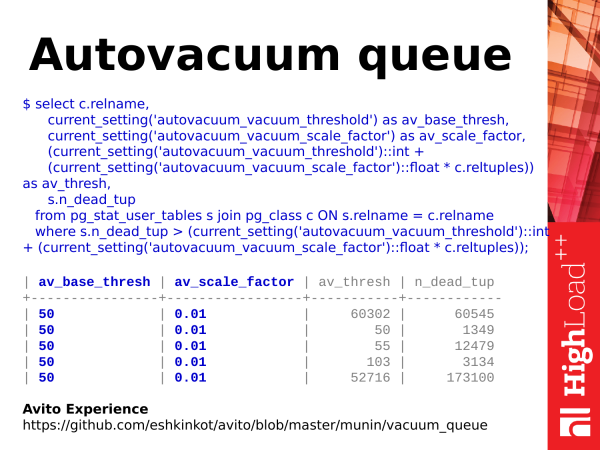
No entanto, há um ponto a ser considerado. Os limiares básicos dos parâmetros av_base_thresh e av_scale_factor podem ser designados individualmente. Assim, o limiar não será global, mas sim individual para a tabela. Portanto, para calcular isso, é necessário usar artifícios e truques. E se você estiver interessado, pode conferir a experiência de nossos colegas do Avito (o link no slide é inválido e foi atualizado no texto).
Eles escreveram para , que considera essas questões. É um documento de duas páginas. Mas ele calcula corretamente e permite avaliar de forma bastante eficaz onde temos uma grande demanda de vacuum para as tabelas, e onde temos pouca.
O que podemos fazer com isso? Se temos uma fila grande e o autovacuum não está dando conta, podemos aumentar o número de trabalhadores de vacuum, ou simplesmente tornar o vacuum mais agressivo, para que ele seja acionado mais cedo, processando a tabela em pedaços pequenos. Dessa forma, a fila será reduzida. — O principal aqui é monitorar a carga nos discos, pois o vacuum não é algo gratuito, embora, com o surgimento de dispositivos SSD/NVMe, o problema se tornasse menos perceptível.
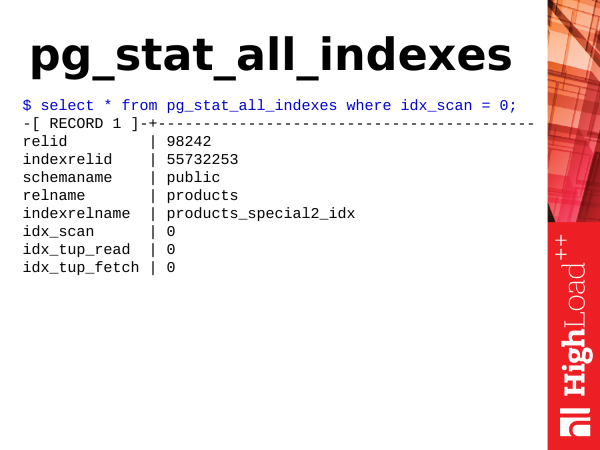
Pg_stat_all_indexes – esta é a estatística dos índices. É pequena. E podemos obter informações sobre o uso dos índices a partir dela. Por exemplo, podemos determinar quais índices são desnecessários.
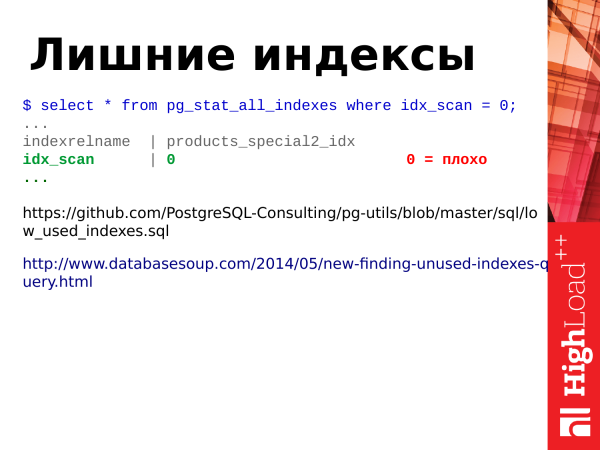
Como já mencionei, a atualização – não é apenas a atualização das tabelas, mas também a atualização dos índices. Portanto, se temos muitos índices na tabela, ao atualizar as linhas da tabela, os índices dos campos indexados também precisam ser atualizados, e se temos índices não utilizados, para os quais não há varreduras indexadas, eles ficam como peso morto. Precisamos nos livrar deles. Para isso, precisamos do campo idx_scan. Basta observar o número de varreduras de índices. Se os índices tiverem zero varreduras por um período relativamente longo de armazenamento de estatísticas (não menor do que 2-3 semanas), é muito provável que sejam índices ruins, e precisamos nos livrar deles.
Nota: Ao procurar índices não utilizados em clusters de replicação em streaming, é necessário verificar todos os nós do cluster, pois a estatística não é global, e se um índice não é utilizado no mestre, ele pode ser utilizado nas réplicas (se houver carga lá).
Dois links:
Estes são exemplos mais avançados de consultas para detectar índices não utilizados.
O segundo link é uma solicitação bastante interessante. Ele contém uma lógica muito não trivial. Recomendo para análise.
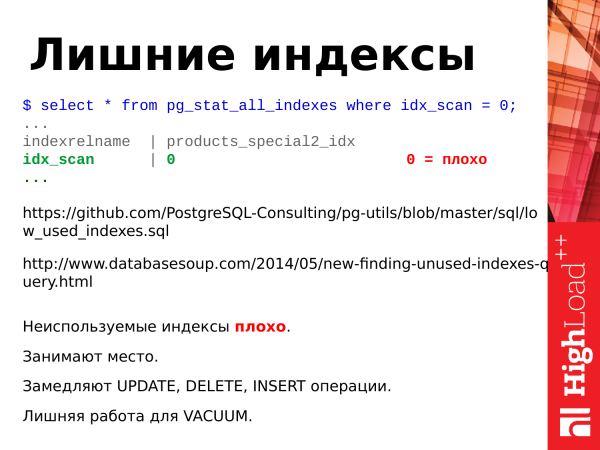
O que mais vale a pena resumir sobre os índices?
Índices não utilizados são problemáticos.
Eles ocupam espaço.
Eles desaceleram as operações de atualização.
Trabalho extra para o vácuo.
Se removermos os índices não utilizados, melhoraremos o banco de dados.
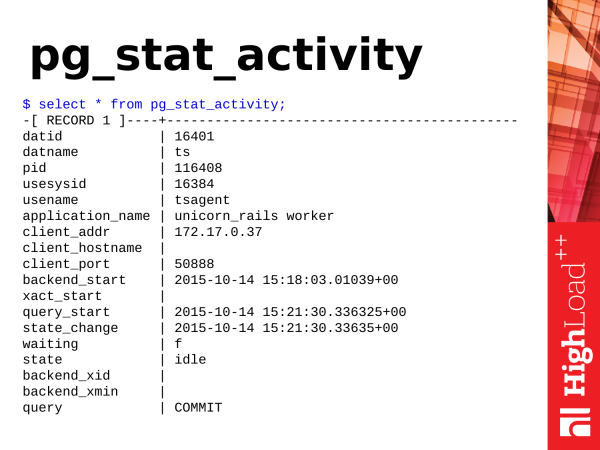
A próxima apresentação é pg_stat_activity. É análogo à ferramenta ps, apenas no PostgreSQL. Se psvocê observar os processos no sistema operacional, será mostrado pg_stat_activity a atividade dentro do PostgreSQL.
O que podemos extrair de útil daí?
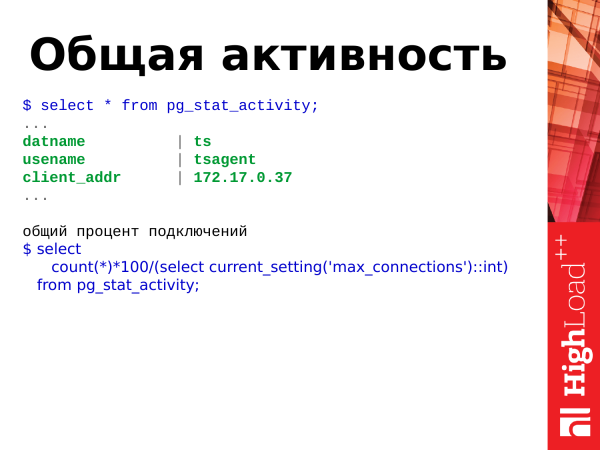
select
count(*)*100/(select current_setting('max_connections')::int)
from pg_stat_activity;
Podemos ver a atividade geral, o que está acontecendo no banco. Podemos fazer um novo deploy. Tudo pode ter quebrado, novas conexões não estão sendo aceitas, erros estão aparecendo no aplicativo.
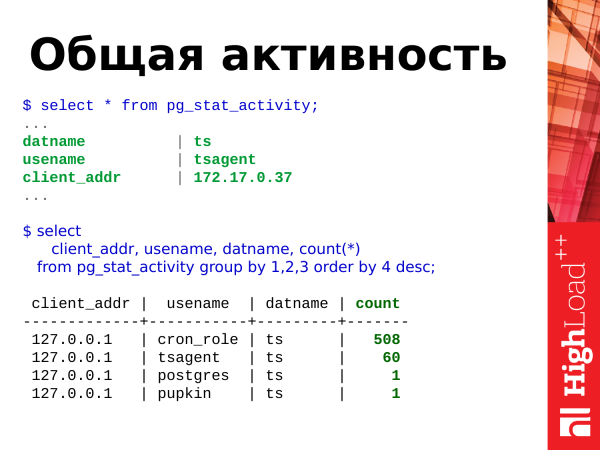
select
client_addr, usename, datname, count(*)
from pg_stat_activity group by 1,2,3 order by 4 desc;
Podemos executar essa consulta e ver a porcentagem total de conexões em relação ao limite máximo de conexões e ver quem está ocupando mais conexões. Neste caso apresentado, vemos que o usuário cron_role abriu 508 conexões. Algo aconteceu com ele. Precisamos investigar e ver. É bem possível que seja um número anômalo de conexões.
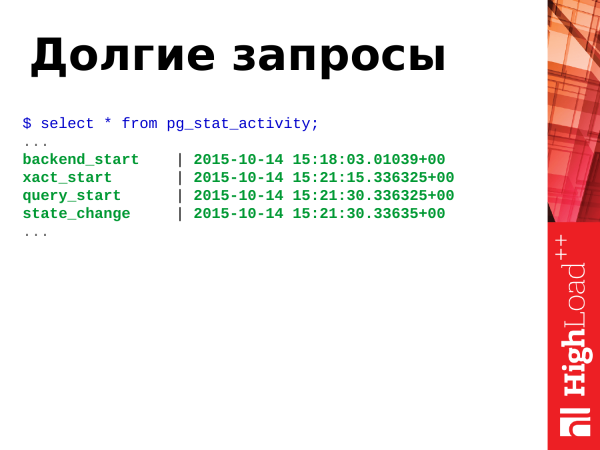
Se tivermos carga OLTP, as consultas devem ser executadas rapidamente, muito rapidamente e não devem haver longas consultas. No entanto, se surgirem longas consultas, a curto prazo não há problema, mas a longo prazo, longas consultas prejudicam o banco, aumentam o efeito de bloat nas tabelas, quando ocorre fragmentação das tabelas. Tanto o bloat quanto as longas consultas devem ser eliminados.
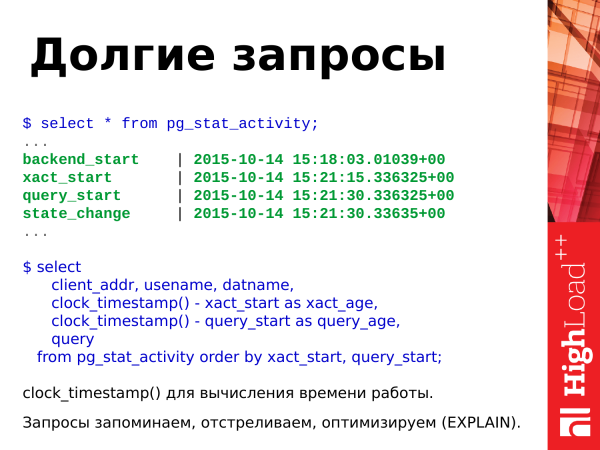
select
client_addr, usename, datname,
clock_timestamp() - xact_start as xact_age,
clock_timestamp() - query_start as query_age,
query
from pg_stat_activity order by xact_start, query_start;
Preste atenção: com essa consulta, podemos identificar longas consultas e transações. Usamos a função clock_timestamp() para determinar o tempo de execução. As longas consultas que encontramos podemos memorizá-las, executar explain, ver os planos e de alguma forma otimizar. Atiramos nas longas consultas atuais e seguimos em frente.
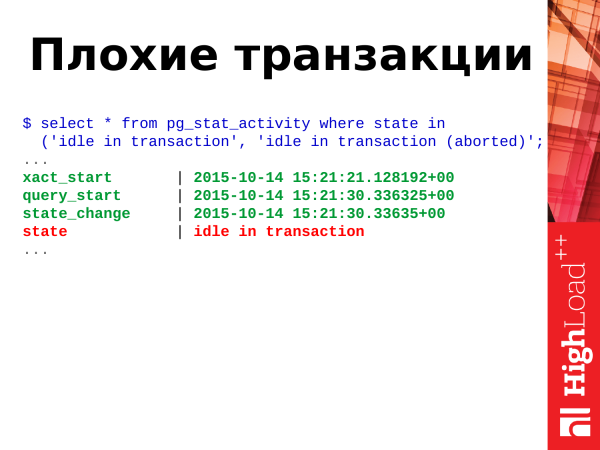
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
Transações ruins são aquelas em estado idle in transaction e idle in transaction (aborted).
O que isso significa? As transações podem ter vários estados. E um desses estados pode ser atingido a qualquer momento. Para determinar os estados, existe um campo state nesta visualização. E nós o usamos para determinar o estado.
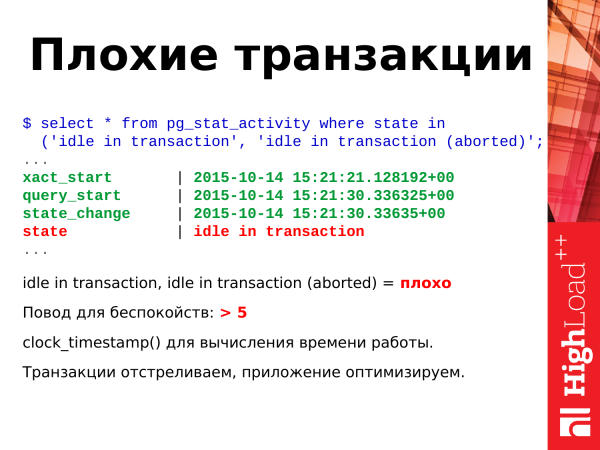
select * from pg_stat_activity where state in
('idle in transaction', 'idle in transaction (aborted)';
E, como mencionei anteriormente, esses dois estados idle in transaction e idle in transaction (aborted) – são problemáticos. O que isso significa? Isso acontece quando um aplicativo abriu uma transação, fez algumas ações e foi embora. A transação ficou em aberto. Ela permanece suspensa, nada acontece, ocupa uma conexão, bloqueia as linhas alteradas e potencialmente ainda aumenta o bloat de outras tabelas, por causa da arquitetura do motor transacional do Postgres. E essas transações também devem ser encerradas, porque são prejudiciais em qualquer situação.
Se você vê que há mais de 5-10-20 delas no seu banco de dados, já é hora de se preocupar e começar a fazer algo a respeito.
Aqui também usamos clock_timestamp()para medir o tempo. Encerramos transações e otimizamos o aplicativo.
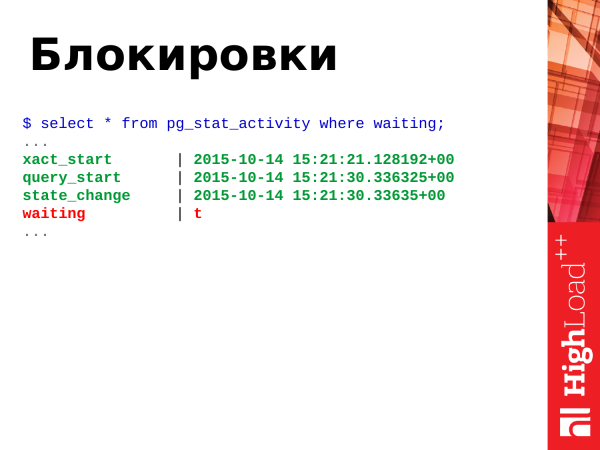
Como mencionei anteriormente, bloqueios – é quando duas ou mais transações competem por um ou grupos de recursos. Para isso, temos o campo waiting com um valor booleano verdadeiro ou falso.
True – isso significa que o processo está aguardando, algo precisa ser feito. Quando o processo está aguardando, isso significa que o cliente que iniciou esse processo também está esperando. O cliente no navegador está sentado e também aguardando.
Atenção: _A partir da versão Postgres 9.6, o campo waiting foi removido e dois campos mais informativos foram adicionados wait_event_type e wait_event._
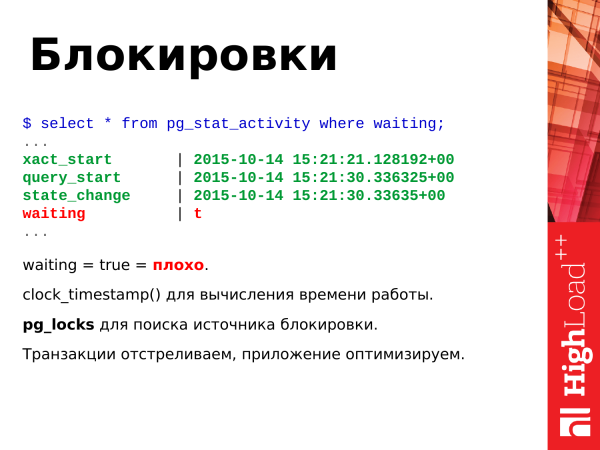
O que fazer? Se você vê true por um longo período de tempo, isso significa que deve-se livrar dessas consultas. Nós simplesmente encerramos essas transações. Escrevemos para os desenvolvedores que precisam otimizar de alguma forma, para não haver competição por recursos. E então os desenvolvedores otimizam o aplicativo para que isso não ocorra.
E por fim, mas ainda potencialmente não fatal, está o surgimento de deadlocks. Duas transações atualizaram dois recursos, depois tentam acessá-los novamente, já em recursos opostos. O PostgreSQL, nesse caso, encerra a transação por conta própria, para que a outra possa continuar funcionando. Essa é uma situação de impasse e não se resolve sozinha. Portanto, o PostgreSQL é forçado a tomar medidas extremas.
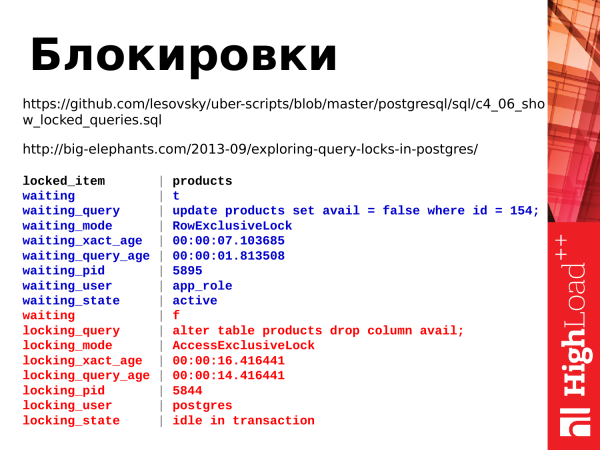
E aqui estão duas consultas que permitem rastrear bloqueios. Nós usamos a visualização pg_locks, que permite monitorar bloqueios pesados.
E o primeiro link é o próprio texto da consulta. É bem longo.
E o segundo link é um artigo sobre locks. Vale a pena ler, é muito interessante.
Então, o que vemos? Vemos duas consultas. A transação com ALTER TABLE é uma transação bloqueadora. Ela foi iniciada, mas não concluída e o aplicativo que iniciou essa transação está fazendo outras coisas. E a segunda consulta é a atualização. Ela está aguardando a conclusão da alteração da tabela para continuar seu trabalho.
Assim podemos descobrir quem bloqueou quem, e podemos lidar com isso.
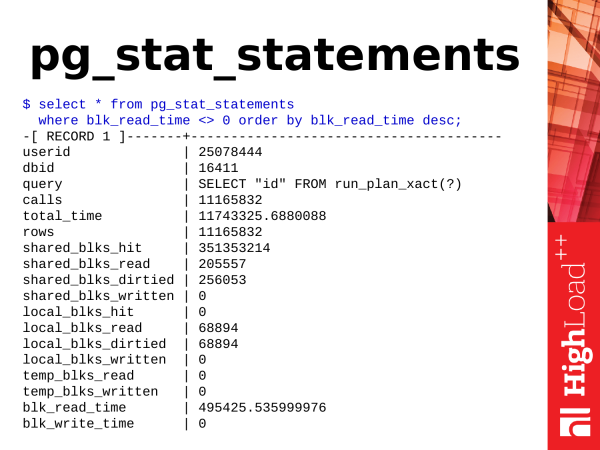
O próximo módulo é pg_stat_statements. Como já mencionei, é um módulo. Para utilizá-lo, é necessário carregar sua biblioteca na configuração, reiniciar o PostgreSQL, instalar o módulo (com um único comando) e então teremos uma nova visão.
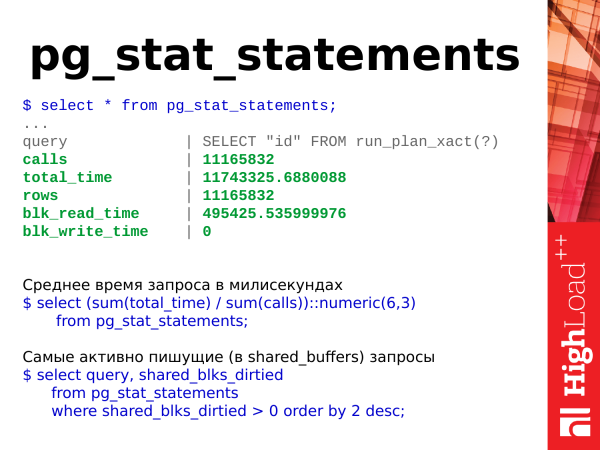
Tempo médio de consulta em milissegundos
$ select (sum(total_time) / sum(calls))::numeric(6,3)
from pg_stat_statements;

Consultas mais ativas escrevendo (em shared_buffers)
$ select query, shared_blks_dirtied
from pg_stat_statements
where shared_blks_dirtied > 0 order by 2 desc;
O que podemos extrair daí? Se falarmos sobre coisas simples, podemos pegar o tempo médio de execução da consulta. Se o tempo aumenta, significa que o PostgreSQL está respondendo lentamente e precisamos tomar alguma providência.
Podemos olhar as transações de escrita mais ativas no banco de dados que estão alterando dados nos buffers compartilhados. Ver quem está atualizando ou excluindo dados.
E podemos simplesmente ver várias estatísticas dessas consultas.
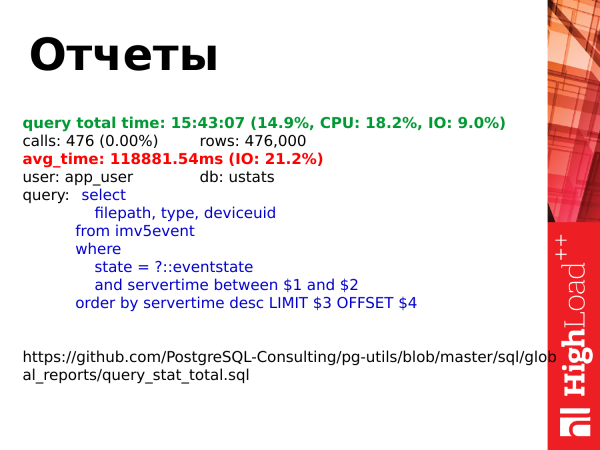
Nós pg_stat_statements usamos para criar relatórios. Redefinimos as estatísticas uma vez por dia. Acumulamos elas. Antes de redefinir as estatísticas na próxima vez, construímos o relatório. Aqui está o link para o relatório. Você pode visualizá-lo.
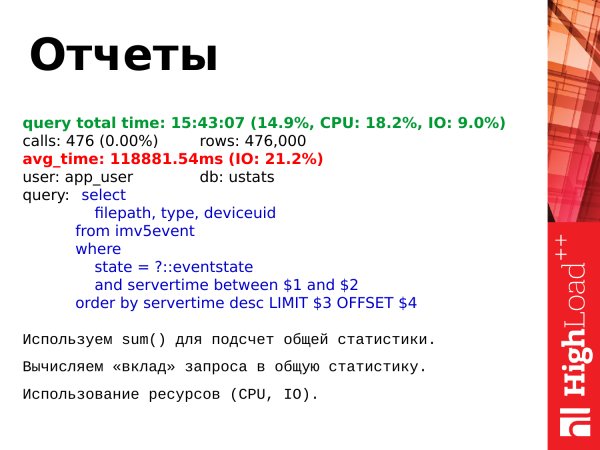
O que fazemos? Contamos a estatística total de todas as consultas. Depois, para cada consulta, calculamos sua contribuição individual para essa estatística total.
E o que podemos observar? Podemos ver o tempo total de execução de todas as consultas de um tipo específico em relação a todas as outras consultas. Podemos ver o uso de recursos do processador e de entrada/saída em relação ao quadro geral. E então otimizar essas consultas. Construímos um ranking de consultas com base nesse relatório e já obtemos insumos para reflexão sobre o que otimizar.
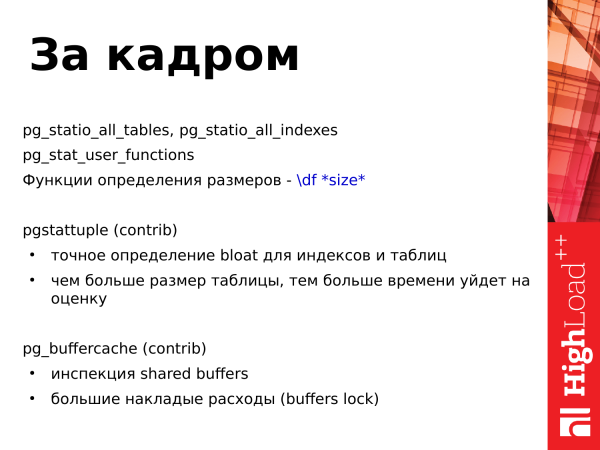
O que nos ficou de fora? Restam ainda algumas apresentações que não abordei, pois o tempo é limitado.
Há pgstattuple é um módulo adicional do pacote padrão contribs. Ele permite avaliar bloat tabelas, ou seja, a fragmentação da tabela. E se a fragmentação for grande, é necessário resolvê-la, utilizando diferentes ferramentas. E a função pgstattuple demora a funcionar. E quanto mais tabelas houver, mais tempo ela levará.
O próximo contrib é pg_buffercache. Ele permite inspecionar os buffers compartilhados: quão intensamente e para quais tabelas as páginas do buffer são utilizadas. E simplesmente permite olhar nos buffers compartilhados e avaliar o que está acontecendo lá.
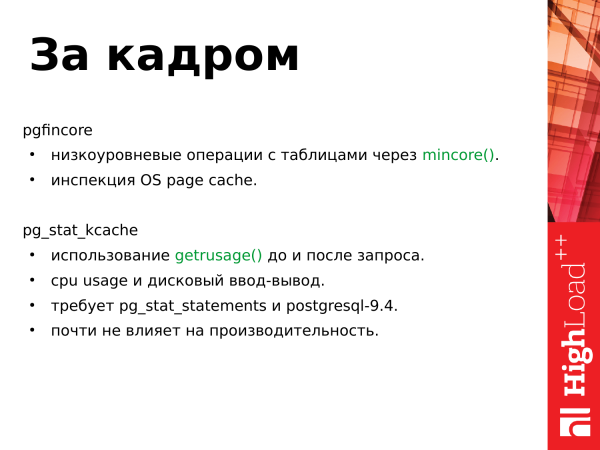
O próximo módulo é pgfincore. Ele permite realizar operações de baixo nível com tabelas através da chamada de sistema mincore(), ou seja, ele permite carregar uma tabela nos buffers compartilhados ou descarregá-la. E permite, além de outras coisas, inspecionar o cache de páginas do sistema operacional, ou seja, em que medida nossa tabela ocupa o cache de páginas, nos buffers compartilhados e simplesmente permite avaliar a carga da tabela.
O próximo módulo é pg_stat_kcache. Ele também utiliza a chamada de sistema getrusage(). E a executa antes e depois da execução da consulta. E na estatística obtida, permite avaliar quanto tempo nossa consulta gastou na execução de entrada/saída em disco, ou seja, operações com o sistema de arquivos e observa o uso do processador. No entanto, o módulo é novo (ahem-ahem) e para seu funcionamento ele requer PostgreSQL 9.4 e pg_stat_statements, sobre os quais falei anteriormente.
Saber utilizar estatísticas é útil. Você não precisa de programas de terceiros. Você pode olhar, ver, fazer algo, executar.
Utilizar estatísticas não é difícil, é SQL comum. Você monta a consulta, elabora, envia, olha.
As estatísticas ajudam a responder perguntas. Se você tiver dúvidas, você se volta para as estatísticas - olha, tira conclusões, analisa os resultados.
E experimente. Há muitas consultas, muitos dados. Sempre é possível otimizar alguma consulta existente. Você pode fazer sua própria versão de uma consulta que se adeque mais a você do que o original e usá-la.
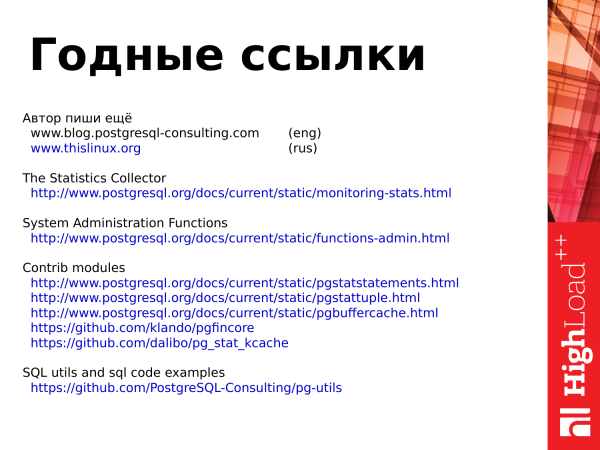
Links
Links úteis que apareceram no artigo, cujos materiais foram utilizados na apresentação.
O autor escreve mais
(eng)
O Coletor de Estatísticas
Funções de Administração do Sistema
Módulos Contrib
Utilitários SQL e exemplos de código SQL
Agradecemos a todos pela atenção!
Fonte: habr.com
