

Dois anos atrás, eu já havia feito um post sobre . Agora houve algum desenvolvimento do projeto, e eu também publiquei sob , por isso decidi escrever este pequeno resumo no Habr.
[ ]
Quem pode se interessar por isso
Isso pode ser interessante para você se trabalha em uma equipe pequena ou mesmo sozinho. Você não tem monitoramento e não tem certeza se realmente precisa dele. Ou então você tentou algum monitoramento popular e sério "para grandes meninos", mas não funcionou para você, ou está operando quase na configuração padrão e não mudou muito sua vida. E também — se você não está planejando dedicar um funcionário (ou até mesmo um departamento) apenas para monitorar por algumas horas por dia no dashboard de monitoramento ou configurá-lo.
O que torna o okerr incomum
A seguir, mostrarei características interessantes do okerr que o diferenciam de alguns outros monitoramentos.
Okerr é um monitoramento híbrido
No monitoramento interno, um "agente" é executado nas máquinas observadas, que transmite dados para o servidor de monitoramento (por exemplo, espaço livre em disco). No monitoramento externo, o servidor executa verificações pela rede (como ping ou acessibilidade do website). Cada abordagem tem suas limitações. O okerr utiliza ambas as opções. As verificações dentro dos servidores são realizadas com um agente muito leve (30Kb) ou seus próprios scripts e aplicações, enquanto as verificações de rede são feitas através de sensores okerr em diferentes países.
okerr não é apenas um software, mas também um serviço
A parte servidor de qualquer monitoramento é uma coisa grande e complexa, difícil de instalar e configurar, e requer recursos. Com o okerr, você pode instalar seu próprio servidor de monitoramento (ele é gratuito e open-source), ou apenas usar a parte cliente e aproveitar o serviço do nosso servidor. Também gratuitamente.
Se o monitoramento permite compensar a falta de confiabilidade dos servidores e aplicativos, surge a questão filosófica — quem vigia o vigilante? Como o monitoramento nos informará sobre um problema se ele mesmo "morreu" por algum motivo, separado ou juntamente com outros recursos seus (por exemplo, uma queda na conexão ao data center)? Ao usar o serviço externo okerr, esse problema é resolvido — você receberá um alerta mesmo se todo o data center com seus servidores ficar sem energia ou for atacado por zumbis.
Claro, há o risco de que o servidor okerr não esteja disponível, isso é verdade (como se sabe, 90% de confiabilidade são sempre obtidos de forma simples e "gratuita", 99% com o mínimo de esforço, e cada nove a mais se torna exponencialmente mais difícil). Mas, primeiro, as chances disso são menores, e segundo, o problema pode passar despercebido apenas se coincidir temporalmente com problemas em nossos servidores. Se temos uma confiabilidade de 99,9%, e você também 99,9% (números não tão altos), a chance de uma falha passar despercebida é de 0,1% de 0,1% = 0,0001%. Adicionar três noves à sua confiabilidade quase sem esforço e sem custo — não é nada mal!
Mais uma vantagem do monitoramento como serviço — o provedor de hospedagem ou a agência web pode instalar o servidor okerr ao seu alcance e fornecer acesso aos clientes como um serviço adicional pago ou gratuito. Enquanto seus concorrentes oferecem apenas hospedagem e sites — você tem uma hospedagem confiável com monitoramento.
Okerr — é sobre indicadores
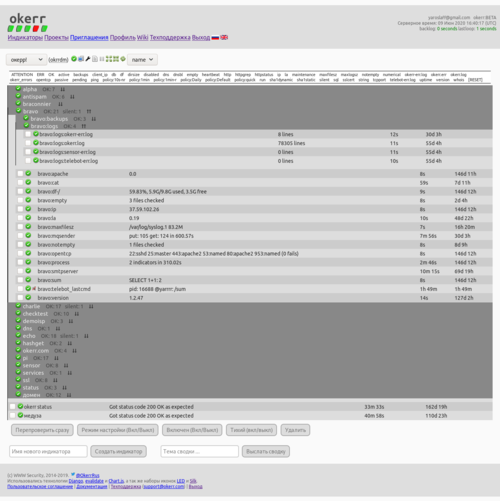
Um indicador é uma "luz". Ele tem dois estados principais — verde (OK) ou vermelho (ERR). No projeto — há muitos indicadores agrupados (por exemplo, por servidores). Na página inicial do projeto, você verá imediatamente se tudo está verde (e pode ser encerrado) ou se algo está piscando em vermelho e precisa ser corrigido. Ao mudar entre esses estados — um alerta é enviado. Uma vez por dia, durante o período de configurações — um resumo do projeto é enviado.
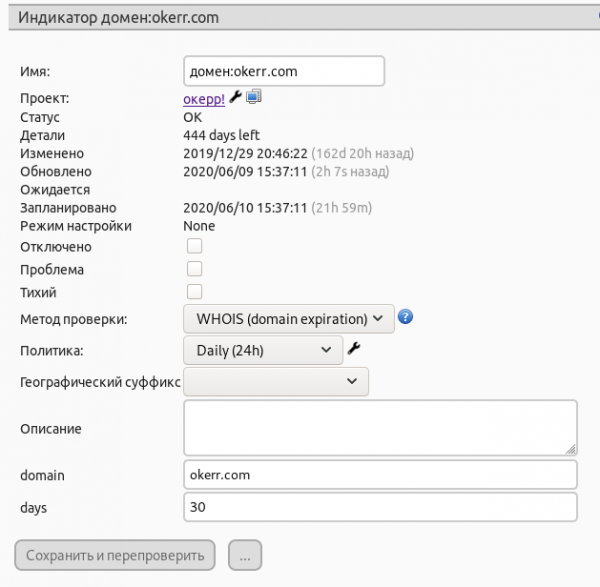
Cada indicador do okerr possui condições internas que determinam quando ele muda de estado (no Zabbix isso é chamado de trigger). Por exemplo, a carga média não deve ser superior a 2 (é claro, isso pode ser configurado). E para cada verificação interna (carga média, espaço em disco livre, ...) — existe um watchdog. Se por algum motivo não obtivermos a confirmação bem-sucedida no horário designado — um erro é registrado e um alerta é enviado.
Nosso esquema de trabalho padrão inclui a verificação matinal de e-mails, onde, entre outras mensagens, analisamos o resumo (marcamos seu horário para o início do dia). Se tudo estiver em ordem, seguimos com outras tarefas importantes (mas podemos, para maior segurança, verificar rapidamente o dashboard do okerr e confirmar que tudo está verde naquele momento). Se um alerta chega, respondemos.
Claro, é possível simplesmente manter indicadores 'informativos' (para ver a situação da rede a partir da monitoria), mas tudo foi feito para que seja simples, fácil e rápido criar indicadores especificamente para observação automática e envio de alertas.
O objetivo pelo qual você configura o okerr é os alertas, para que você possa criar um indicador em um minuto; ele pode ter 'dormido' por um ano, apenas recebendo atualizações, e quando algo quebra após um ano, ele acende e envia um alerta. O minuto que você gastou uma vez para criar o indicador se pagou, você soube do problema imediatamente, antes de qualquer um. É possível que você até tenha consertado antes que alguém notasse. O que é levantado rapidamente não é considerado como caído!
Segurança
Seria uma pena se você implementasse a monitoria para aumentar a confiabilidade, e no final — acabasse sendo atacado através dela, e há muitas vulnerabilidades de rede em diferentes ferramentas de monitoramento (, ).
O agente (okerrmod do pacote ), que opera no sistema — não é um servidor de rede, mas um cliente. Portanto, no servidor monitorado não há portas adicionais abertas; o cliente opera facilmente atrás de um firewall ou NAT e é muito difícil (eu diria 'impossível') de ser invadido pela rede, pois ele basicamente não escuta a socket de rede.
Cobertura total de monitoramento
Atualmente, temos a regra de que tomamos conhecimento de todos os problemas técnicos através do okerr. Se de repente essa regra for violada (se o okerr não nos alertar sobre a iminência desse problema (se possível) ou que ele já ocorreu) — adicionamos verificações no okerr.
Verificações externas
Conjunto bastante típico:
- ping
- status http
- verificação de validade e atualidade do certificado SSL (alerta se a validade estiver prestes a expirar)
- porta TCP aberta e o banner nela
- grep http (a página [não] deve conter um texto específico)
- hash sha1 para capturar alterações na página.
- DNS (o registro DNS deve ter um valor específico)
- WHOIS (alerta se o domínio estiver prestes a expirar)
- Antispam DNSBL (verificação do host em mais de 50 listas negras anti-spam)
Verificações internas
Também, um conjunto bastante típico (mas facilmente expansível).
- df (espaço livre em discos)
- média de carga
- opentcp (sockets TCP abertos em escuta — notificará se algo for iniciado ou cair)
- uptime — apenas o tempo ativo do servidor. Notificará se houver uma redução (ou seja, se o servidor reiniciar)
- client_ip
- dirsize — usamos para monitorar quando nossos rootfs virtuais ultrapassam o tamanho permitido, sem impor limites rígidos, e monitoramos o tamanho dos diretórios home dos usuários.
- empty e nonempty — monitoram arquivos que devem estar vazios (ou não vazios). Por exemplo, o log de erro do servidor okerr — deve estar vazio, e se houver qualquer linha — receberei uma notificação e verificarei. Já o mail.log no servidor de e-mail deve ESTAR NÃO VAZIO (após N minutos da rotação). E às vezes, ele ficou vazio após uma atualização de sistema, quando o logrotate não conseguiu reiniciar corretamente o rsyslog.
- linecount — número de linhas no arquivo (como wc -l). Usamos como uma alternativa mais suave para empty, quando o log de erro pode crescer, mas apenas lentamente (por exemplo, o googlebot está acessando algumas páginas fechadas). Há um limite de 2 linhas a cada 20 minutos. Se exceder — haverá um alerta.
Verificações internas interessantes
Se você leu até aqui "diagonalmente", agora será mais interessante ler com atenção.
backups
Monitora backups no diretório. Nossos arquivos de backup têm nomes como "ServerName-20200530.tar.gz". Para cada servidor, é criado um indicador em okerr chamado ServerName-DATE.tar.gz (a data real é substituída pela string "DATE"). Monitora tanto a presença de um backup recente quanto seu tamanho (por exemplo, não pode ser menor que 90% do backup anterior).
O que precisa ser feito para que um novo backup comece a ser monitorado após começarmos a criá-lo e colocá-lo neste diretório? Nada! Esta é uma abordagem muito conveniente, quando não é necessário fazer "nada", porque:
- Fazer "nada" é bastante rápido, economiza tempo.
- É difícil esquecer de fazer "nada".
- É difícil fazer "nada" errado, com erro. Nada — é o método mais confiável.
Se, por acaso, pararem de aparecer novos arquivos de backup — haverá um alerta. Se você, por exemplo, desligou um dos servidores, e não deveria haver mais backups dele — você precisará remover o indicador (via interface web ou shell através da API).
maxfilesz
Monitora o tamanho dos maiores arquivos (geralmente: /var/log/*). Isso permite identificar problemas imprevisíveis, como tentativas de força bruta de senhas ou envio de spam pelo servidor.
runstatus/runline
Estes são dois módulos proxy importantes para executar outros programas no servidor. O Runstatus informa o indicador de código de saída do programa. Por exemplo, no okerr não há (não é necessário) um módulo para verificar se os serviços systemd estão funcionando. Isso é feito através do runstatus (veja abaixo). O Runline — informa ao servidor a linha produzida pelo programa. Por exemplo, temp_RUN="cat /sys/class/thermal/thermal_zone0/temp" no config do Runline em nosso servidor, cria um indicador servername:temp com a temperatura do processador.
sql
Executa uma consulta numérica ao MySQL e reporta o resultado para o indicador. No caso simples, pode-se fazer, por exemplo, 'SELECT 1' — isso vai verificar se o SGBD está funcionando corretamente.
Mas uma aplicação muito mais interessante é, por exemplo, monitorar o número de pedidos em uma loja virtual. Se você sabe que tem em média 100 pedidos por hora, pode definir um limite mínimo de 100 ou 80. Assim, se suas vendas caírem subitamente — você receberá um alerta e poderá investigar.
Note — não importa por que razão imprevisível isso aconteceu:
- O servidor simplesmente não está acessível (sem energia ou sem rede), e o alerta veio porque o indicador 'expirou'.
- O servidor está sobrecarregado, funcionando lentamente ou perdendo pacotes, os usuários têm dificuldades e saem sem compras.
- O servidor foi listado como spam e os e-mails enviados não são aceitos, os usuários não conseguem se registrar.
- O orçamento da campanha publicitária terminou, os banners não estão sendo exibidos.
Pode haver inúmeras razões, e não se pode prever todas elas com antecedência, e tecnicamente é difícil monitorá-las. Mas é conveniente acompanhar o parâmetro final (pedidos) e, com base nele, determinar que a situação é suspeita e merece investigação.
Indicadores lógicos
Permite usar expressões lógicas (sintaxe Python) através do módulo (). Para a expressão, estão disponíveis os dados do projeto e seus indicadores. Por exemplo, no capítulo sobre verificação SQL acima, você pode ter notado um ponto fraco — durante o dia, podemos ter até 100 vendas por hora, mas à noite — 20, e isso é normal, não é um problema. O que fazer? O indicador estará sempre fazendo alarde à noite.
É possível criar dois indicadores, um diurno e um noturno. Ambos podem ser 'silenciosos' (não enviarão notificações). E criar um indicador lógico que exija que o indicador diurno esteja OK até às 20:00, e após as 20:00, basta que o indicador noturno esteja OK.
Outro exemplo de uso de um indicador lógico é escalonamento. Por exemplo, o gerente de projeto desativa os alertas (não precisa disso, os administradores devem reagir a problemas comuns), mas assina um indicador lógico, que fica vermelho se qualquer indicador do projeto não for corrigido no tempo estipulado.
Além disso, há a possibilidade de definir um tempo permitido para os trabalhos, por exemplo, das 3 às 5 da manhã. Não nos preocupa se os servidores e sites 'caírem' nesse tempo. Mas às 5:00 eles devem estar funcionando. Se não estiverem funcionando a qualquer outro momento — alerta. O indicador lógico também permite considerar o backup de servidores. Se você tiver 5 servidores web, os administradores podem desligar 1-2 servidores a qualquer momento. Mas se houver menos de 3 dos 5 servidores em funcionamento — haverá alerta.
Os exemplos acima não são funcionalidades do okerr, não são recursos que precisam ser ativados e configurados. Todas essas funcionalidades não estão no okerr, mas há um módulo lógico que permite implementar essa funcionalidade (mais ou menos como na linguagem de programação — se temos operadores aritméticos, não precisamos de uma função específica da linguagem para calcular 20% de IVA, isso sempre pode ser feito conforme nossas necessidades).
O indicador lógico é, talvez, um dos poucos tópicos relativamente complexos no okerr, mas a boa notícia é que você não precisa dominá-los até que surja a necessidade. Contudo, eles ampliam muito as capacidades, mantendo o próprio sistema bastante simples.
Adicionando suas próprias verificações
Eu realmente gostaria de transmitir a ideia de que o okerr não é um conjunto de mil verificações prontas para todas as situações, mas, pelo contrário — antes de tudo — um motor simples com a possibilidade de criar suas próprias verificações. Criar suas próprias verificações no okerr não é uma tarefa para hackers, co-desenvolvedores do sistema ou pelo menos usuários avançados do okerr, mas uma tarefa viável para qualquer administrador que há um mês instalou Linux pela primeira vez.
Verificações básicas são feitas através do módulo :
Esta linha no arquivo de configuração avisará se, por acaso, /bin/true não for executado ou retornar um valor diferente de 0.
true_OK=\/bin\/trueUma única linha — e aqui estamos nós, já um pouco expandimos a funcionalidade do okerr.
Até mesmo uma verificação como essa — já possui seu valor: se, por acaso, seu servidor falhar — o indicador correspondente no servidor okerr não será atualizado a tempo, e após um período de tempo, um alerta será gerado.
Esta verificação avisará que o servidor apache2 caiu (nunca se sabe…):
apache_OK="systemctl is-active --quiet apache2"Portanto, se você tem conhecimento em qualquer linguagem de programação, pelo menos pode escrever scripts shell — então você já pode adicionar suas próprias verificações.
Mais complexo — você pode escrever (em qualquer linguagem) seu módulo para o okerrmod. No caso mais simples, ele se parece com isto:
#!/usr/bin/python3

print("STATUS: OK")
Verdade, não é muito difícil? O módulo deve realizar a própria verificação e enviar os resultados para STDOUT. Um módulo mais complexo fornece, por exemplo, isto:
$ okerrmod --dump df
NAME: pi:df-\/
TAGS: df
METHOD: numerical|maxlim=90
DETAILS: 49.52%, 13.9G\/28.2G usados, 13.0G livres
STATUS: 49.52

NAME: pi:df-\/boot
TAGS: df
METHOD: numerical|maxlim=90
DETAILS: 84.32%, 53.1M\/62.9M usados, 9.9M livres
STATUS: 84.32
Ele atualiza vários indicadores de uma vez (separados por uma linha em branco), cria-os, se necessário, e indica os detalhes da verificação e a tag, para que no painel seja fácil encontrar os indicadores desejados.
Telegram
Há um bot no Telegram . Você não precisa sobrecarregar seu telefone com aplicativos separados (também não gosto de ter que usar um aplicativo para o Pão de Açúcar, outro para o Carrefour, um terceiro para a MTS, e assim por diante). Um único Telegram — é suficiente. Através do Telegram, você pode receber alertas imediatamente, verificar o status do projeto e emitir um comando para reavaliar todos os indicadores problemáticos. Você saiu do teatro\/avião, não acompanhou por duas horas, ligou o telefone, pressionou um botão no chatbot, e se certificou de que tudo está em ordem.
Páginas de status
Nos dias de hoje, páginas de status — já são quase essenciais para qualquer negócio que tenha TI, um compromisso com a confiabilidade e que respeita seus clientes\/usuários.
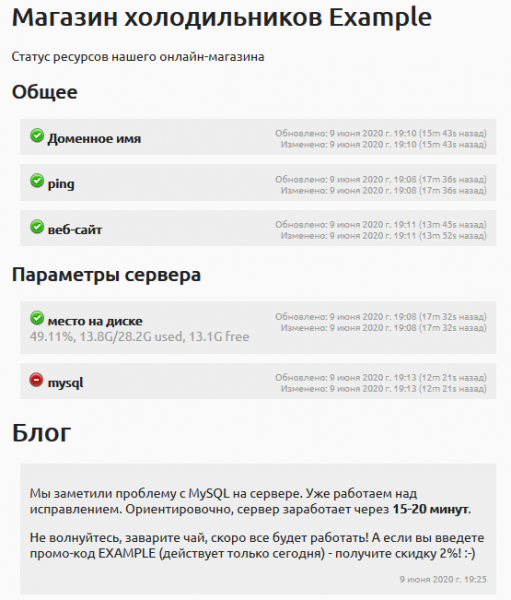
Imagine a situation where a user wants to do something, look up information, or place an order, and something isn't working. They don't know what the problem is, whose side it's on, or when it will be resolved. Could your company's website simply be down? Or did it break six months ago and won't be fixed for another two years? But the refrigerator needs to be bought right now; it's already in the cart... It's a completely different story when a person sees that something is not right on your end (at least it's clear that the problem isn't on their side), that the issue has been detected, that you are already working on it, and that you've even provided a rough estimate of the fix time. The user can subscribe and receive an email notification when the issue is resolved and they can do what they wanted (buy the refrigerator).
Problems and downtime happen to everyone. But users and partners trust those who are more transparent and responsible about it.
Aqui . Here are examples of how these pages look for the projects e . .
Failover
To avoid making this article any longer, I will refer back to my previous article — . If you can create a redundant server with failover, you essentially won't have long downtimes — as soon as a problem is detected, users will automatically be redirected to the working backup server. I think this is a very interesting and standout feature that is rare in the industry.
Low system requirements
For okerr servers — we use machines with RAM starting from 2GB. For network sensors — even 512MB is enough. The client side uses almost no resources at all. (The package weighs 26 Kb, but requires Python3 and standard libraries). The client runs from a cron script, so it has zero constant memory consumption. Among the machines we monitor, we have sensors (super cheap VPS with 512MB RAM) and Raspberry Pi. It is even possible to send updates via curl without the client side (see below)
Considering this — okerr is probably the most free Um sistema de monitoramento a partir dos disponíveis, afinal, mesmo para usar outro sistema open source gratuito como Zabbix ou Nagios, é necessário alocar recursos (servidor) para isso, e isso já envolve custos. Além disso, ainda é necessário algum trabalho de manutenção do servidor. Com okerr, essa parte pode ser eliminada. Ou você também pode optar por não eliminá-la e usar seu próprio servidor – depende do que você preferir.
API e integração em software próprio
Arquitetura simples e aberta. O okerr tem uma arquitetura bastante acessível , com a qual é fácil trabalhar. Precisa criar 1000 indicadores? Um script shell de 3-4 linhas faz isso. Precisa reconfigurar 1000 indicadores? Também é muito simples. Por exemplo, queremos relembrar todos os nossos certificados HTTPS exatamente com o sensor russo:
#!/bin/sh

for indicator in `okerrclient --api-filter sslcert`
do
    echo set location for $indicator
    okerrclient --api-set location=ru retest=1 --name $indicator
done
Você pode atualizar um indicador tanto usando nosso módulo cliente quanto até mesmo sem ele, simplesmente através do curl.
# short and nice (using okerrupdate and config file)
$ okerrupdate MyIndicator OK

# only curl is enough!
$ curl -d 'textid=MyProject&name=MyIndicator&secret=MySecret&status=OK' https://bravo.okerr.com/
Os indicadores podem ser atualizados diretamente do seu programa. Por exemplo, enviando sinais de heartbeat, para que o okerr saiba que ele está em execução e acione um alerta se cair ou travar. Aliás, os componentes do okerr fazem exatamente isso – o okerr se monitora, e problemas em quase qualquer módulo serão detectados e gerarão um aviso sobre o problema. (E para o caso desse "quase" – eles são verificados cruzadamente a partir de outro servidor)
Aqui está um código (simplificado) em nosso bot do Telegram:
from okerrupdate import OkerrProject, OkerrExc

op = OkerrProject()
uptimei = op.indicator("{}:telebot_uptime".format(hostname))
...
uptimei.update('OK', 'pid: {} Uptime: {} cmds: {}'.format(
        os.getpid(), dhms(uptime), commands_cnt))
Para atualizar indicadores de programas Python – existe uma biblioteca , para quaisquer outras linguagens – não há biblioteca, mas você pode ou chamar o script okerrupdate, ou realizar uma solicitação HTTP ao servidor okerr.
Como o okerr nos ajuda
O okerr mudou nossas vidas. De verdade. É possível que outro sistema de monitoramento pudesse fazer isso também, mas com o okerr é fácil e simples trabalhar, e ele possui todas as funcionalidades que precisávamos (o que não estava disponível – nós complementamos). Aliás, se alguma funcionalidade estiver faltando – pergunte, e eu adicionarei (não prometo, mas gostaria que o okerr fosse o melhor sistema de monitoramento para projetos pequenos e médios). Ou, melhor ainda, adicione você mesmo – é simples.
Conseguimos viver pelo princípio de "saber sobre todos os problemas através do okerr". Se, por acaso, surgisse um problema do qual não soubéssemos pelo okerr, nós o adicionamos ao okerr. (Neste caso, ao usar "nós", me refiro a nós como usuários do sistema, e não como co-desenvolvedores). No início, isso ocorria com frequência, mas agora é muito raro.
Monitoramento
Através do okerr, monitoramos o tamanho dos logs em todos os servidores. Ler atentamente cada linha do log é, claro, impossível, mas simplesmente monitorar a velocidade de crescimento já traz muitos benefícios. Por meio disso, descobrimos tanto o envio de spam quanto tentativas de força bruta para adivinhação de senhas, e quando alguns aplicativos 'ficam loucos', falhando e repetindo suas ações (cada vez adicionando algumas linhas ao log).
Certificados SSL. Quase imediatamente após o lançamento nossos clientes começaram a fornecer certificados SSL gratuitos a seus clientes (cerca de mil deles). E isso se tornou um verdadeiro pesadelo para a administração! O fato é que os sites estão 'vivos', os clientes periodicamente pedem algo, os programadores fazem. Eles podem, por exemplo, mover livremente o site para outro DocumentRoot. Ou adicionar uma reescrita incondicional na configuração do virtual host. Naturalmente, após tais alterações, a atualização automática dos certificados falha. Agora, todos os nossos hosts SSL são adicionados ao okerr automaticamente através de mais uma de nossas ferramentas úteis deste pacote . Simplesmente executamos a2okerr.py — e se o servidor tiver vários novos sites, eles aparecerão automaticamente no okerr. Se, por algum motivo, o certificado não for atualizado, com três semanas de antecedência antes do vencimento do certificado, estaremos cientes e investigaremos por que ele não está sendo atualizado, que coisa. a2certbot.py do mesmo pacote — ajuda muito nisso (verifica imediatamente os problemas mais prováveis — e informa o que foi verificado corretamente e onde provavelmente está o problema).
Monitoramos a data de expiração de todos os nossos domínios. Além disso, todos os nossos servidores de e-mail que enviam mensagens são verificados em mais de 50 listas negras diferentes. (E às vezes aparecem nelas). A propósito, você sabia que os servidores de e-mail do Google também estão em listas negras? Para auto-teste, adicionamos mail-wr1-f54.google.com aos servidores monitorados, e ele realmente está na lista negra SORBS! (Isso levanta a questão sobre o valor dos 'anti-spamers')
Os backups — já mencionei acima como é simples monitorá-los com o okerr. Mas monitoramos também os backups recentes em nosso servidor e (com a ajuda de uma utilidade separada que usa o okerr) — os backups que carregamos no Amazon Glacier. E sim — problemas ocorrem periodicamente. Não é à toa que estamos monitorando.
Usamos um indicador de escalonamento. Com ele, é possível ver se algum problema não foi resolvido por um longo tempo. E eu mesmo, ao resolver algumas tarefas, às vezes posso esquecer deles. O escalonamento é um bom lembrete, mesmo que você esteja se monitorando.
No geral, acredito que a qualidade do nosso trabalho melhorou consideravelmente. O tempo de inatividade quase não existe (bem, ou o cliente não tem tempo de notá-lo. Apenas, shhh!), enquanto o volume de trabalho diminuiu e as condições de trabalho se tornaram mais tranquilas. Passamos de um trabalho emergencial, consertando buracos com fita adesiva, para um trabalho calmo e metódico, onde muitos problemas são previstos com antecedência e há tempo para preveni-los. Mesmo as questões que ocorreram — ficou mais fácil consertá-las: primeiro, ficamos sabendo antes que os clientes entrem em pânico, segundo, muitas vezes ocorre que o problema está relacionado a um trabalho recente (enquanto fazia uma coisa, quebrei outra) — portanto, fica mais fácil resolver questões comprometedoras de imediato.
E houve mais um caso…
Você sabia que no popular Debian 9 (Stretch) um pacote tão popular quanto o phpmyadmin ainda está (já há muitos meses!) status vulnerável? (). Quando a vulnerabilidade surgiu — nós rapidamente a contornamos de várias maneiras. Mas eu configurei no okerr o monitoramento da página do security-tracker para saber quando sairia uma solução "bonita" (através do hash SHA1 do conteúdo). Várias vezes o indicador me avisou, a página mudou, mas como você pode ver — até agora (desde janeiro de 2019!) não está indicado que o problema foi resolvido. Talvez, a propósito, alguém saiba qual é o problema que faz com que um pacote tão importante permaneça vulnerável por mais de um ano?
Outra vez em uma situação semelhante: após a vulnerabilidade no SSH, foi necessário atualizar todos os servidores. E quando você define uma tarefa, é preciso monitorar a execução. (Os subordinados tendem a não entender, esquecer, confundir e cometer erros). Por isso, primeiro adicionamos uma verificação da versão do SSH em todos os servidores no okerr, e através do okerr acompanhamos para garantir que as atualizações fossem aplicadas em todos os servidores. (Prático! Escolhi esse tipo de indicador, e logo se vê em qual servidor está qual versão). Quando tivermos certeza de que a tarefa foi concluída em todos os servidores, removeremos os indicadores.
Algumas vezes houve situações em que um certo problema surgia, mas depois se resolvia sozinho. (provavelmente, todos já passaram por isso?). Enquanto você percebe, enquanto verifica — já não há nada a ser verificado — tudo já está funcionando bem. Mas então volta a dar problema. Tivemos isso, por exemplo, com os produtos que carregamos no Amazon Marketplace (MWS). Em algum momento, o inventário carregado estava incorreto (quantidades erradas de produtos e preços errados). Investigamos. Mas para entender — era importante ficar sabendo do problema imediatamente. Infelizmente, o MWS, assim como todos os serviços da Amazon, é um pouco lento, então sempre havia um atraso, mas, de qualquer forma, conseguimos pelo menos captar a relação entre o problema e os scripts que o causavam (fizemos uma verificação, adicionamos ao okerr e monitoramos assim que recebíamos o alerta).
Recentemente, um caso interessante foi adicionado à nossa coleção por um grande e caro provedor europeu de hospedagem, que é utilizado por nosso cliente. De repente, todos os nossos servidores desapareceram dos radares! Primeiro, o cliente percebeu manualmente (mais rápido que qualquer ferramenta!) que o site com o qual ele trabalhava não estava acessível e fez um ticket a respeito. No entanto, não era apenas um site, mas sim todos! (Natasha, derrubamos tudo!). Então, a Okerr começou a enviar longas mensagens com todos os indicadores que foram acionados. Pânico, pânico, estamos correndo em círculos (o que mais podemos fazer?). Depois, tudo voltou ao normal. Acontece que havia trabalhos programados no data center (uma vez a cada muitos anos) e, é claro, deveríamos ter sido avisados. Mas alguma confusão ocorreu e eles não nos informaram. Bem, um infarto a mais, um a menos. Mas depois de restaurar tudo, precisamos verificar se está tudo certo! Eu nem consigo imaginar como eu faria isso manualmente. A Okerr testou tudo em poucos minutos. Constatou-se que a maior parte dos servidores estava temporariamente indisponível, mas funcionando. Alguns reiniciaram, mas também voltaram ao normal. Das perdas, perdemos dois backups que deveriam ter sido criados e enviados naquela época, enquanto todo esse caos acontecia. Eu não cheguei a criá-los, simplesmente, após um dia, alertas chegaram informando que tudo estava OK, os backups apareceram. Eu gosto muito desse exemplo porque a Okerr foi extremamente útil em uma situação que nem pensamos com antecedência, mas essa é a tarefa do monitoramento — enfrentar o imprevisto.
Para os sensores da Okerr, utilizamos hospedagens o mais baratas possível (a qualidade e a confiabilidade não são importantes, pois se compensam mutuamente). Recentemente, encontramos um serviço de hospedagem muito bom a um preço super acessível, e os benchmarks eram incríveis. Mas... às vezes, parece que as conexões de saída da máquina virtual estão sendo realizadas a partir de outro IP (adjacente). Maravilhas. O módulo client_ip de não está recebendo o IP correto. E pelos logs do servidor do indicador, também pode-se ver que a atualização veio desse IP vizinho. Estamos agora resolvendo isso com o suporte. Felizmente, percebemos isso em um momento tranquilo. Mas, por exemplo, muitas vezes acontece que o acesso é configurado por uma lista branca de IPs — e se o servidor piscar assim por um curto período de tempo — pode levar muito tempo para identificar esse problema.
E além disso — já que estamos falando sobre VPS, sempre optamos por opções econômicas (hetzner, ovh, scaleway). Em termos de benchmarks e estabilidade — estamos muito satisfeitos. Também utilizamos o Amazon EC2, que é bem mais caro, para outros projetos. Assim, graças ao okerr, temos uma opinião embasada. Tanto os baratos quanto os caros caem. E eu não diria que, ao longo do nosso tempo de observação, os provedores baratos como o hetzner se mostraram significativamente menos estáveis do que o EC2. Portanto, se você não está preso a outros recursos da Amazon — por que pagar mais? 🙂
E agora?
Se nesta etapa eu ainda não o afastei muito do Okerr — então experimente! Você pode acessar a partir deste link (Clique agora mesmo!). Mas lembre-se — a conta demo é única para todos, então, se você estiver fazendo algo — outra pessoa pode atrapalhar você ao mesmo tempo. Ou (preferencialmente) registre-se através do link no — é simples, sem SMS. Se você não gosta de usar seu e-mail verdadeiro — pode usar um temporário, como o mailinator (eu recomendo ). Essas contas podem ser excluídas com o tempo — mas servem para teste.
Após o registro, será sugerido que você passe por um treinamento (realize algumas tarefas de aprendizado relativamente simples). Os limites iniciais são bem baixos, mas suficientes para treinamento ou um servidor. Após completar o treinamento — os limites (como, por exemplo, o número máximo de indicadores) serão aumentados.
A partir da documentação — antes de tudo para a parte do servidor e para o cliente (). Mas se algo não estiver claro — escreva para support (at) okerr.com ou deixe um ticket — faremos o possível para resolver tudo rapidamente.
Se você for usar de forma séria e esses limites aumentados não forem suficientes — também, entre em contato com o suporte, aumentaremos (gratuitamente).
Quer instalar o servidor okerr em seu servidor? Aqui está . Recomendamos a instalação em uma máquina virtual limpa, assim será fácil fazer isso com o script de instalação. Na sua própria VM — sem restrições :-). E de novo — se precisar de ajuda — estaremos sempre à disposição.
Queremos que este projeto decole, tornando o mundo mais seguro graças a nós. Com software e serviços gratuitos, o mundo se tornou mais amigável e se desenvolve de forma mais dinâmica. O código-fonte pode ser armazenado no GitHub gratuito, e o Gmail pode ser usado para e-mail. Utilizamos gratuito para suporte. Para isso, não é necessário pagar por servidores, não é preciso baixar, configurar ou resolver vários problemas de operação. Cada novo projeto, cada equipe — imediatamente tem e-mail, repositórios e CRM. E tudo isso é de alta qualidade, gratuito e imediato. Queremos que para monitoramento seja assim também — pequenas empresas e projetos poderiam usar o okerr gratuitamente e até na fase de nascimento e crescimento ter a mesma confiabilidade que grandes projetos sérios.
Fonte: habr.com
