

A busca por dependências funcionais em dados é aplicada em várias áreas da análise de dados: gestão de bancos de dados, limpeza de dados, engenharia reversa de bancos de dados e exploração de dados. Sobre essas dependências, já publicamos Anastásia Birillo e Nikita Bobrov. Desta vez, Anastásia — graduada do Computer Science Center deste ano — compartilha o desenvolvimento deste trabalho no âmbito da pesquisa científica que ela defendeu no centro.
Escolha da tarefa
Durante meu tempo de estudos no centro CS, comecei a explorar em profundidade os bancos de dados, especialmente a busca por dependências funcionais e diferenciais. Este tema estava relacionado ao meu trabalho de curso na universidade, então, enquanto trabalhava no meu projeto, comecei a ler artigos sobre diversas dependências em bancos de dados. Escrevi uma revisão dessa área — um dos meus primeiros em inglês e a apresentei na conferência SEIM-2017. Fiquei muito feliz ao saber que foi aceita e decidi me aprofundar no assunto. A própria concepção não é nova — começou a ser aplicada ainda na década de 90, mas ainda é relevante em muitas áreas.
No segundo semestre do meu curso no centro, iniciei um projeto de pesquisa sobre a melhoria dos algoritmos de busca por dependências funcionais. Trabalhei nele junto com o pós-graduando da SPbGU, Nikita Bobrov, na JetBrains Research.
Dificuldade computacional na busca por dependências funcionais
O principal problema é a dificuldade computacional. O número de dependências mínimas e não triviais possíveis é limitado superiormente pelo valor  , onde
 — o número de atributos da tabela. O tempo de execução dos algoritmos depende não apenas do número de atributos, mas também do número de linhas. Nos anos 90, algoritmos de busca por dependências funcionais em PCs comuns conseguiam processar conjuntos de dados com até 20 atributos e dezenas de milhares de linhas em até algumas horas. Algoritmos modernos, que operam em processadores multi-core, detectam dependências em conjuntos de dados consistindo de centenas de atributos (até 200) e centenas de milhares de linhas, aproximadamente no mesmo tempo. No entanto, isso não é suficiente: esse tempo é inaceitável para a maioria das aplicações reais. Portanto, desenvolvemos abordagens para acelerar os algoritmos existentes.
Esquemas de cache para interseção de partições
Na primeira parte do trabalho, desenvolvemos esquemas de cache para uma classe de algoritmos que utilizam o método de interseção de partições. Uma partição para um atributo representa um conjunto de listas, onde cada lista contém os números das linhas com valores iguais para esse atributo. Cada uma dessas listas é chamada de cluster. Muitos algoritmos modernos usam partições para determinar se uma dependência é mantida ou não, precisamente seguindo a lemma: A dependência  é mantida se
 . Aqui
 é indicada a partição e utiliza-se o conceito de tamanho da partição – a quantidade de clusters nela. Algoritmos que utilizam partições, ao quebrar uma dependência, adicionam atributos adicionais ao lado esquerdo da dependência, após o que recalculam-na, realizando a operação de interseção de partições. Essa operação em artigos é chamada de especialização. Mas notamos que as partições para dependências que serão mantidas apenas após várias rodadas de especialização podem ser reutilizadas ativamente, o que pode reduzir significativamente o tempo de execução dos algoritmos, uma vez que a operação de interseção é cara.
Portanto, propusemos uma heurística baseada na Entropia de Shannon e na incerteza de Gini, além da nossa métrica que chamamos de Entropia Inversa. Esta é uma modificação sutil da Entropia de Shannon e cresce à medida que aumenta a singularidade do conjunto de dados. A heurística proposta é a seguinte:

Aqui  — grau de singularidade da partição recentemente calculada
 , e
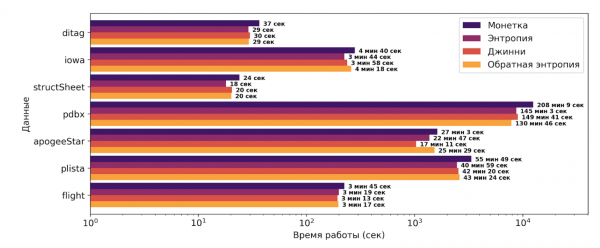
 é a mediana de graus de exclusividade para atributos individuais. Todas as três métricas mencionadas acima foram testadas como métricas de exclusividade. Também é possível notar que há dois modificadores na heurística. O primeiro indica o quão próxima a partição atual está da chave primária e permite um maior cache das partições que estão longe da chave potencial. O segundo modificador permite monitorar a ocupação do cache, incentivando assim a adição de mais partições ao cache quando há espaço livre. A solução bem-sucedida dessa tarefa permitiu acelerar o algoritmo PYRO em 10-40%, dependendo do conjunto de dados. Vale ressaltar que o algoritmo PYRO é o mais bem-sucedido nesta área.
Na figura abaixo, é possível ver os resultados da aplicação da heurística proposta em comparação com a abordagem básica de cache baseada em lançamentos de moeda. O eixo X é logarítmico.
Método alternativo de armazenamento de partições
Em seguida, propusemos um método alternativo para armazenar partições. As partições representam um conjunto de clusters, em cada um dos quais são armazenados os números das tuplas com valores iguais para determinados atributos. Esses clusters podem conter longas sequências de números de tuplas, por exemplo, se os dados na tabela estiverem ordenados. Portanto, propusemos um esquema de compressão para o armazenamento das partições, especificamente o armazenamento intervalar de valores nos clusters das partições:
$$display$$pi(X) = {{underbrace{1, 2, 3, 4, 5}_{Primeiro~intervalo}, underbrace{7, 8}_{Segundo~intervalo}, 10}}\ downarrow{Compressão}\ pi(X) = {{underbrace{$, 1, 5}_{Primeiro~intervalo}, underbrace{7, 8}_{Segundo~intervalo}, 10}}$$display$$
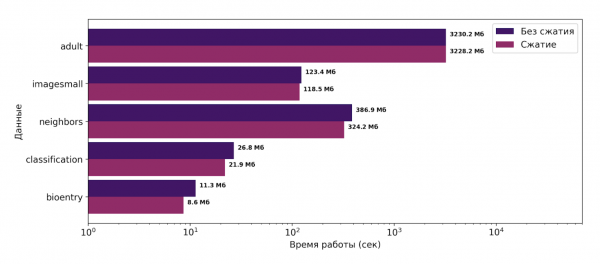
Este método conseguiu reduzir o consumo de memória durante a execução do algoritmo TANE em 1 a 25%. O algoritmo TANE é um algoritmo clássico para descoberta de dependências funcionais, que utiliza partições em seu funcionamento. Na prática, foi escolhido o algoritmo TANE, pois implementar o armazenamento intervalar nele foi significativamente mais fácil do que, por exemplo, no PYRO, para avaliar se a abordagem proposta funciona. Os resultados obtidos estão apresentados na figura abaixo. O eixo X é logarítmico.
Conferência ADBIS-2019
Com base nos resultados da pesquisa em setembro de 2019, apresentei um artigo na conferência 23rd European Conference on Advances in Databases and Information Systems (ADBIS-2019). Durante a apresentação, o trabalho foi destacado por Bernhard Thalheim, uma figura importante na área de bancos de dados. Os resultados das pesquisas serviram de base para a minha dissertação de mestrado no departamento de Matemática e Física da SPbGU, durante a qual ambas as abordagens propostas (caching e compressão) foram implementadas em ambos os algoritmos: TANE e PYRO. Os resultados mostraram que as abordagens propostas são universais, pois, em ambos os algoritmos e com ambas as abordagens, houve uma redução significativa da memória consumida, bem como uma diminuição considerável no tempo de execução dos algoritmos.
Fonte: habr.com
