

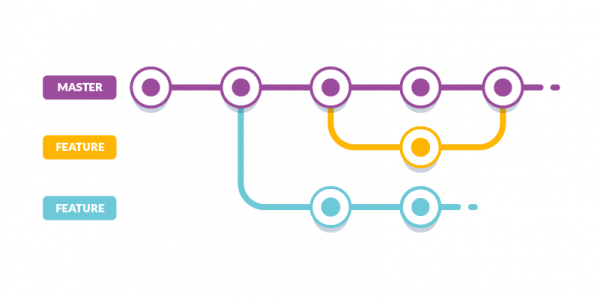
Olá! Ramo de recurso (ou prévia de deploy, aplicativo de revisão) — é quando não apenas o ramo master é implantado, mas cada pull request é enviado para uma URL única. Você pode verificar se o código está funcionando no ambiente de produção, e a funcionalidade pode ser mostrada a outros programadores ou gerentes de produto. Enquanto você trabalha no pull request, cada novo commit elimina o deploy atual para o código antigo, e um novo deploy para o código novo é publicado. Questões podem surgir após a fusão do pull request no ramo master. O ramo de recurso não é mais necessário para você, mas os recursos do Kubernetes ainda permanecem no cluster.
Mais sobre os ramos de recurso
Uma das abordagens para criar ramos de recurso no Kubernetes é usar namespaces. Resumidamente, a configuração de produção se parece com isto:
kind: Namespace
apiVersion: v1
metadata:
  name: habr-back-end
...

kind: Deployment
apiVersion: apps/v1
metadata:
  namespace: habr-back-end
spec:
  replicas: 3
...
Para o ramo de recurso, é criado um namespace com seu identificador (por exemplo, o número do pull request) e um prefixo/sufixo (por exemplo, -pr-):
kind: Namespace
apiVersion: v1
metadata:
  name: habr-back-end-pr-17
...

kind: Deployment
apiVersion: apps/v1
metadata:
  namespace: habr-back-end-pr-17
spec:
  replicas: 1
...
Basicamente, eu escrevi Operador Kubernetes (um aplicativo que tem acesso aos recursos do cluster), . Ele elimina os namespaces que pertencem a ramos de recurso antigos. No Kubernetes, quando um namespace é excluído, outros recursos nesse namespace também são deletados automaticamente.
$ kubectl get pods --all-namespaces | grep -e "-pr-"
NAMESPACE            ... IDADE
habr-back-end-pr-264 ... 4d8h
habr-back-end-pr-265 ... 5d7h
Sobre como implementar os ramos de recurso no cluster, você pode ler e .
Motivação
Vamos observar o ciclo de vida típico de um pull request com integração contínua (integração contínua):
- Empurre um novo commit para o ramo.
- No build, linters e/ou testes são executados.
- As configurações do Kubernetes do pull request são geradas em tempo real (por exemplo, o número é inserido em um modelo pronto).
- Com kubectl apply, as configurações são enviadas para o cluster (deploy).
- O pull request é mesclado no ramo master.
Enquanto você trabalha no pull request, cada novo commit elimina o deploy atual para o código antigo, e um novo deploy para o novo código é publicado. Mas quando o pull request é mesclado ao ramo master, apenas o ramo master será construído. No final, esquecemos do pull request, mas seus recursos do Kubernetes ainda estão no cluster.
Como usar
Instale o projeto com o comando abaixo:
$ kubectl apply -f https://raw.githubusercontent.com/dmytrostriletskyi/stale-feature-branch-operator/master/configs/production.ymlCrie um arquivo com o seguinte conteúdo e instale através de kubectl apply -f:
apiVersion: feature-branch.dmytrostriletskyi.com/v1
kind: StaleFeatureBranch
metadata:
  name: stale-feature-branch
spec:
  namespaceSubstring: -pr-
  afterDaysWithoutDeploy: 3
Parâmetro namespaceSubstring necessário para filtrar namespaces para pull requests de outros namespaces. Por exemplo, se o cluster tiver os seguintes namespaces: habr-back-end, habr-front-end, habr-back-end-pr-17, habr-back-end-pr-33, então os candidatos à remoção serão habr-back-end-pr-17, habr-back-end-pr-33.
Parâmetro afterDaysWithoutDeploy necessário para remover namespaces antigos. Por exemplo, se um namespace foi criado 3 dias 1 hora atrás, e o parâmetro é especificado como 3 dias, este namespace será removido. Funciona também ao contrário, se um namespace foi criado 2 dias 23 horas atrás, e o parâmetro é especificado como 3 dias, este namespace não será removido.
Há outro parâmetro, que é responsável pela frequência de escaneamento de todos os namespaces e verificação de dias sem deploy — checkEveryMinutes. Por padrão, este valor é 30 minutos.
Como funciona
Na prática, será necessário:
- para funcionar em um ambiente isolado.
- subir o cluster Kubernetes localmente.
- — interface de linha de comando para gerenciar o cluster.
Subindo o cluster Kubernetes localmente:
$ minikube start --vm-driver=docker
minikube v1.11.0 on Darwin 10.15.5
Usando o driver docker baseado no perfil existente.
Iniciando o nó do plano de controle minikube no cluster minikube.
Especifique kubectl usar o cluster local por padrão:
$ kubectl config use-context minikube
Mudado para o contexto "minikube".
Baixando configurações para o ambiente de produção:
$ curl https://raw.githubusercontent.com/dmytrostriletskyi/stale-feature-branch-operator/master/configs/production.yml > stale-feature-branch-production-configs.ymlComo as configurações de produção estão configuradas para verificar namespaces antigos, e no nosso novo cluster não há nenhum, vamos substituir a variável de ambiente IS_DEBUG para verdadeiro. Com este valor, o parâmetro afterDaysWithoutDeploy não é considerado e os namespaces não são verificados quanto a dias sem deploy, apenas pela inclusão da substring (-pr-).
Se você estiver em Linux:
$ sed -i 's|false|true|g' stale-feature-branch-production-configs.ymlSe você estiver em macOS:
$ sed -i "" 's|false|true|g' stale-feature-branch-production-configs.ymlInstalando o projeto:
$ kubectl apply -f stale-feature-branch-production-configs.ymlVerificando se o recurso apareceu no cluster StaleFeatureBranch:
$ kubectl api-resources | grep stalefeaturebranches
NOME                 ... APIGROUP                             ... TIPO
stalefeaturebranches ... feature-branch.dmytrostriletskyi.com ... StaleFeatureBranch
Verificando se o operador apareceu no cluster:
$ kubectl get pods --namespace stale-feature-branch-operator
NOME                                           ... STATUS  ... IDADE
stale-feature-branch-operator-6bfbfd4df8-m7sch ... Executando ... 38s
Se você olhar nos logs, ele está pronto para processar recursos StaleFeatureBranch:
$ kubectl logs stale-feature-branch-operator-6bfbfd4df8-m7sch -n stale-feature-branch-operator
... "msg":"Versão do Operador: 0.0.1"}
...
... "msg":"Iniciando EventSource", ... , "source":"kind source: /, Kind="}
... "msg":"Iniciando Controlador", ...}
... "msg":"Iniciando trabalhadores", ..., "contagem de trabalhadores":1}
Instalando fixtures prontos (configurações prontas para modelar os recursos do cluster) para o recurso StaleFeatureBranch:
$ kubectl apply -f https://raw.githubusercontent.com/dmytrostriletskyi/stale-feature-branch-operator/master/fixtures/stale-feature-branch.ymlAs configurações indicam procurar namespaces com a substring -pr- a cada 1 minuto.:
apiVersion: feature-branch.dmytrostriletskyi.com/v1
kind: StaleFeatureBranch
metadata:
  name: stale-feature-branch
spec:
  namespaceSubstring: -pr-
  afterDaysWithoutDeploy: 1
  checkEveryMinutes: 1
O operador reagiu e está pronto para verificar os namespaces:
$ kubectl logs stale-feature-branch-operator-6bfbfd4df8-m7sch -n stale-feature-branch-operator
... "msg":"Stale feature branch is being processing.","namespaceSubstring":"-pr-","afterDaysWithoutDeploy":1,"checkEveryMinutes":1,"isDebug":"true"}
Instalando prontos, contendo dois namespaces (project-pr-1, project-pr-2) e seus implantações, serviços, ingress, e assim por diante:
$ kubectl apply -f https://raw.githubusercontent.com/dmytrostriletskyi/stale-feature-branch-operator/master/fixtures/first-feature-branch.yml -f https://raw.githubusercontent.com/dmytrostriletskyi/stale-feature-branch-operator/master/fixtures/second-feature-branch.yml
...
namespace/project-pr-1 created
deployment.apps/project-pr-1 created
service/project-pr-1 created
horizontalpodautoscaler.autoscaling/project-pr-1 created
secret/project-pr-1 created
configmap/project-pr-1 created
ingress.extensions/project-pr-1 created
namespace/project-pr-2 created
deployment.apps/project-pr-2 created
service/project-pr-2 created
horizontalpodautoscaler.autoscaling/project-pr-2 created
secret/project-pr-2 created
configmap/project-pr-2 created
ingress.extensions/project-pr-2 created
Verificando se todos os recursos acima foram criados com sucesso:
$ kubectl get namespace,pods,deployment,service,horizontalpodautoscaler,configmap,ingress -n project-pr-1 && kubectl get namespace,pods,deployment,service,horizontalpodautoscaler,configmap,ingress -n project-pr-2
...
NAME                              ... READY ... STATUS  ... AGE
pod/project-pr-1-848d5fdff6-rpmzw ... 1/1   ... Running ... 67s

NAME                         ... READY ... AVAILABLE ... AGE
deployment.apps/project-pr-1 ... 1/1   ... 1         ... 67s
...
Como ativamos debug, os namespaces project-pr-1 e project-pr-2, consequentemente, todos os outros recursos devem ser excluídos imediatamente, desconsiderando o parâmetro afterDaysWithoutDeploy. Nos logs do operador, isso é visível:
$ kubectl logs stale-feature-branch-operator-6bfbfd4df8-m7sch -n stale-feature-branch-operator
... "msg":"Namespace should be deleted due to debug mode is enabled.","namespaceName":"project-pr-1"}
... "msg":"Namespace is being processing.","namespaceName":"project-pr-1","namespaceCreationTimestamp":"2020-06-16 18:43:58 +0300 EEST"}
... "msg":"Namespace has been deleted.","namespaceName":"project-pr-1"}
... "msg":"Namespace should be deleted due to debug mode is enabled.","namespaceName":"project-pr-2"}
... "msg":"Namespace is being processing.","namespaceName":"project-pr-2","namespaceCreationTimestamp":"2020-06-16 18:43:58 +0300 EEST"}
... "msg":"Namespace has been deleted.","namespaceName":"project-pr-2"}
Se você verificar a presença de recursos, eles estarão em estado Terminating (processo de exclusão) ou já foram excluídos (a saída do comando está vazia).
$ kubectl get namespace,pods,deployment,service,horizontalpodautoscaler,configmap,ingress -n project-pr-1 && kubectl get namespace,pods,deployment,service,horizontalpodautoscaler,configmap,ingress -n project-pr-2
...
Você pode repetir o processo de criação prontos verifique várias vezes se eles serão removidos dentro de um minuto.
Alternativas
O que pode ser feito em vez de usar um operador que funciona em um cluster? Existem várias abordagens, todas imperfeitas (e suas desvantagens são subjetivas), e cada um decide o que é melhor para o projeto específico:
Remover o branch de feature durante a construção da branch master de integração contínua.
- Para isso, é necessário saber qual pull request se refere ao commit que está sendo construído. Como o namespace do branch de feature contém o identificador do pull request — seu número ou nome da branch, você sempre terá que especificar o identificador no commit.
- As construções das branches master falham. Por exemplo, você tem as seguintes etapas: baixar o projeto, executar os testes, compilar o projeto, fazer o release, enviar notificações, limpar o branch de feature do último pull request. Se a construção falhar ao enviar a notificação, você terá que remover todos os recursos do cluster manualmente.
- Sem o contexto adequado, a remoção do branch de feature no build master não é óbvia.
Uso de webhooks ().
- Pode ser que essa não seja sua abordagem. Por exemplo, em , apenas um tipo de pipeline suporta a capacidade de manter suas configurações no código-fonte. Ao usar webhooks, é necessário escrever seu próprio script para processá-los. Este script terá que ser hospedado na interface do Jenkins, o que é difícil de manter.
Escrever e adicionar ao cluster Kubernetes.
- Tempo gasto para escrita e manutenção.
- O operador já funciona nesse estilo, é documentado e mantido.
Obrigado pela atenção ao artigo. .
Fonte: habr.com
