

Olá, Habr!
Hoje eu quero falar sobre nossa experiência na automação de backup de grandes volumes de dados em configurações diversas com Nextcloud. Eu sou o CTO da 'Molniya AK', onde lidamos com a gestão da configuração de sistemas de TI, utilizando Nextcloud para armazenamento de dados. Isso inclui, entre outras coisas, uma estrutura distribuída com redundância.
Os problemas resultantes das peculiaridades das instalações são que os dados são extensos. A versionagem fornecida pelo Nextcloud, o backup, razões subjetivas, entre outros, acabam gerando muitos duplicados.
Antecedentes
Na administração do Nextcloud, surge a questão da organização de um backup eficiente que deve ser necessariamente criptografado, pois os dados são valiosos.
Oferecemos opções de armazenamento de backup, seja conosco ou com o cliente em suas máquinas separadas do Nextcloud, o que demanda uma abordagem automatizada e flexível para a administração.
Temos muitos clientes, todos com configurações diferentes, e todos em suas próprias instalações e com suas particularidades. Aqui, o método padrão, onde toda a infraestrutura pertence a você e os backups são feitos a partir do cron, não se aplica bem.
Para começar, vamos olhar os dados introdutórios. Precisamos de:
- Escalabilidade em termos de uma ou várias nós. Para grandes instalações, usamos o minio como sistema de armazenamento.
- Identificar problemas com a execução do backup.
- É necessário armazenar o backup com os clientes e/ou conosco.
- Resolver problemas de forma rápida e fácil.
- Os clientes e as instalações diferem bastante entre si — não conseguimos alcançar uniformidade.
- A velocidade de recuperação deve ser mínima em dois cenários: recuperação completa (desastre), uma pasta — excluída por engano.
- A função de deduplicação é obrigatória.
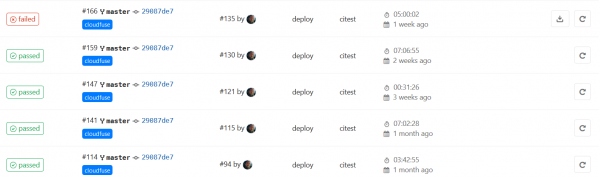
Para resolver a questão da gestão de backups, implementamos o GitLab. Mais detalhes a seguir.
Certamente, não somos os primeiros a resolver esse tipo de problema, mas acreditamos que nossa experiência prática e vivenciada pode ser interessante e estamos prontos para compartilhá-la.
Como na nossa empresa a política é de código aberto, procuramos uma solução com código aberto. Por sua vez, compartilhamos nossos desenvolvimentos e os disponibilizamos. Por exemplo, no GitHub temos , que instalamos nos clientes, aumentando a segurança dos dados em caso de exclusão acidental ou deliberada.
Ferramentas de backup
Iniciamos a busca por métodos de solução com a escolha de uma ferramenta para criar backups.
O uso padrão de tar + gzip é ineficaz – os dados são duplicados. O backup incremental geralmente contém muito poucas mudanças, e a maior parte dos dados dentro de um único arquivo se repete.
Há outro problema – a redundância do armazenamento de dados distribuído. Usamos o minio e seus dados são, em essência, redundantes. Ou teríamos que fazer o backup através do próprio minio – sobrecarregá-lo e utilizar todos os intermediários entre o sistema de arquivos, e o que é igualmente importante, há o risco de esquecer parte dos buckets e metainformações. Ou usar deduplicação.
Existem ferramentas de backup com deduplicação em código aberto (no Habr estavam ) e nossos finalistas foram e . A seguir, discutiremos nossa comparação entre os dois aplicativos, mas antes disso, contaremos como organizamos todo o esquema.
Gerenciamento da criação de backups
Borg e Restic são bons, mas nenhum dos dois produtos possui um mecanismo centralizado de gerenciamento. Para fins de gerenciamento e controle, escolhemos uma ferramenta que já está implantada em nosso ambiente, sem a qual não conseguimos pensar em nosso trabalho, inclusive na automação – o conhecido CI/CD – GitLab.
A ideia é a seguinte: em cada nó que armazena dados do Nextcloud, instala-se o gitlab-runner. O runner executa, em horários programados, um script que monitora o processo de backup, que por sua vez invoca o Borg ou Restic.
O que conseguimos? Feedback da execução, controle conveniente sobre as mudanças, detalhes em caso de erro.
Aqui publicamos exemplos de scripts para diferentes tarefas, e acabamos integrando-o ao backup não só do Nextcloud, mas de muitos outros serviços. Também está disponível um planejador, caso você não queira configurá-lo manualmente (e nós não queremos) e o arquivo .gitlab-ci.yml
Na API do GitLab, ainda não há como alterar o intervalo de tempo do CI/CD, que é curto. Precisamos aumentá-lo, digamos para 1d.
Felizmente, o GitLab consegue iniciar não apenas com um commit, mas também em horários programados, que é exatamente o que precisamos.
Agora sobre o script de wrapper.
Estabelecemos as seguintes condições para este script:
- Deve ser executado tanto pelo runner quanto manualmente via console, mantendo a mesma funcionalidade.
- Deve ter manipuladores de erros:
- código de retorno.
- busca de string no log. Por exemplo, para nós uma mensagem que o programa não considera crítica pode ser um erro.
- Tempo de execução de timeout. Deve ser um tempo razoável.
- Precisamos de um log detalhado. Mas somente em caso de erro.
- Uma série de testes também é realizada antes do início.
- Pequenas facilidades para conveniência que consideramos úteis durante o suporte:
- O início e o fim são registrados no log do sistema da máquina local. Isso ajuda a vincular erros do sistema ao funcionamento do backup.
- Parte do log de erros, quando existem, é emitida no stdout, e o log completo é gravado em um arquivo separado. É prático conferir no CI e avaliar o erro se for trivial.
- Modos para depuração.
O log completo é salvo como artefato no GitLab; se não houver erros, o log é excluído. O script é escrito em bash.
Ficaremos felizes em considerar quaisquer sugestões e comentários sobre código aberto — bem-vindos.
Como funciona
Um runner com executor bash é iniciado no nó de backup. Um job CI/CD é iniciado em um repositório especial pelo planejador. O runner executa um script que serve como uma camada universal para essas tarefas, realizando verificações de validade do repositório de backup, pontos de montagem e tudo o que desejarmos, depois é realizado o backup e a limpeza dos antigos. O backup pronto é enviado para o S3.
Trabalhamos com esse esquema — é um provedor externo AWS ou um análogo russo (é mais rápido e os dados não saem da Rússia). Ou instalamos um cluster minio separado no local do cliente para esses fins. Normalmente fazemos isso por motivos de segurança, quando o cliente não quer que os dados saiam do seu ambiente.
Não usamos o recurso de envio de backup via ssh. Isso não adiciona segurança, e as capacidades de rede do provedor S3 são muito superiores à de uma única máquina ssh nossa.
Para proteger contra hackers na máquina local — pois eles podem apagar dados no S3, a versionamento deve ser ativada.
O backup sempre é criptografado.
O Borg possui um modo sem criptografia none, mas não recomendamos que seja ativado. Nesse modo, não somente a criptografia não é realizada, como também a soma de verificação do que está sendo gravado não é calculada, portanto a integridade só pode ser verificada indiretamente, pelos índices.
Com um agendador separado, a integridade dos backups é verificada quanto a índices e conteúdo. A verificação ocorre lentamente e leva tempo, então a realizamos separadamente uma vez por mês. Pode demorar vários dias.
Readme em russo
Funções principais
preparepreparaçãoteste de verificaçãoverificação de prontidãocomando principalcomando principalforçar finalizaçãofunção que é executada no final ou em caso de erro. Usada para desmontar a partição.
Funções de serviço
cleanupregistramos erros ou apagamos o arquivo de log.verificar loganalisamos o log em busca da string de erro.retmanipulador de saída.verificar tempo limiteverificação de tempo limite.
Ambiente
VERBOSE=1exibimos erros na tela imediatamente (stdout).SAVELOGSONSUCCES=1salvamos o log em caso de sucesso.INIT_REPO_IF_NOT_EXIST=1Criamos o repositório, se não existir. Por padrão, desligado.TEMPO LIMITEtempo máximo para a operação principal. Você pode defini-lo como 'm', 'h' ou 'd' no final.
Modo de armazenamento de cópias antigas. Por padrão:
MANTER_DIARIAMENTE=7MANTER_SEMANALMENTE=4MANTER_MENSALMENTE=6
Variáveis dentro do script
STRING_DE_ERRO— string para verificação no log por erro.EXTRAIR_STRING_DE_ERRO— expressão para mostrar string em caso de erro.MORTESIGNAL_DE_TEMPO_LIMITE— sinal para matar se houver tempo limite.TAIL— quantas strings com erros na tela.COLORMSG— cor da mensagem (padrão amarelo).
O script, chamado de wordpress, é nomeado condicionalmente; seu recurso é que também faz backup do banco de dados mysql. Isso significa que pode ser usado para instalações efêmeras do Nexcloud, onde você pode também fazer backup do banco. A conveniência não está apenas no fato de tudo estar em um só lugar, mas também no que contém o banco de dados, pois a diferença de tempo é mínima.
Restic vs Borg
Comparações entre Borg e Restic também estão , e não tínhamos a tarefa de fazer apenas mais um, mas o nosso. Era importante para nós como isso ficaria em nossos dados, com nossa especificidade. Nós os apresentamos.
Nossos critérios de escolha, além dos já mencionados (deduplicação, recuperação rápida etc.):
- Resiliência para trabalho não concluído. Verificação de kill -9.
- Tamanho no disco.
- Exigência de recursos (CPU, memória).
- Tamanho dos blobs armazenados.
- Trabalho com S3.
- Verificação de integridade.
Para os testes, pegamos um cliente com dados reais e um tamanho total de 1,6TB.
Condições.
O Borg não consegue trabalhar diretamente com S3, e montamos como um disco fuse, através de . O Restic enviou para S3 diretamente.
Goofys funciona muito rápido e bem, e tem um , que acelera ainda mais o trabalho. Ele está em fase beta, e admito que teve falhas com perda de dados em testes (outros). Mas a conveniência é que o próprio procedimento de backup não requer muita leitura, mas principalmente gravação, portanto, usamos o cache apenas durante a verificação de integridade.
Para reduzir a influência da rede, utilizamos um provedor local - Yandex Cloud.
Resultados dos testes comparativos.
- Kill -9 seguido de reinicialização, ambos foram bem-sucedidos.
- Tamanho em disco. O Borg consegue comprimir, portanto, os resultados são esperados.
Backuper
Tamanho
Borg
562Gb
Restic
628Gb
- Por CPU
O borg em si consome pouco, com a compressão padrão, mas deve-se avaliar junto com o processo goofys. No total, eles são comparáveis e utilizam cerca de 1,2 núcleos na mesma máquina virtual de teste. - Memória. O Restic consome aproximadamente 0,5Gb, o Borg cerca de 200Mb. Mas isso tudo é insignificante em comparação com o cache de arquivo do sistema. Portanto, é recomendável alocar mais memória.
- A diferença no tamanho dos blobs foi surpreendente.
Backuper
Tamanho
Borg
cerca de 500Mb
Restic
cerca de 5Mb
- O trabalho com S3 pelo Restic é excelente. O funcionamento do Borg via goofys não apresenta problemas, mas foi observado que é desejável fazer um umount ao final do backup para limpar completamente o cache. Uma característica do funcionamento do S3 é que chunks não totalmente baixados nunca serão enviados para o bucket, e dados não completamente carregados levam a grandes danos.
- A verificação de integridade funciona bem em ambos os casos, mas a velocidade difere significativamente.
Restic – 3,5 horas.
Borg, com um cache de arquivo de 100Gb SSD – 5 horas. O resultado em termos de velocidade é aproximadamente o mesmo se os dados estão no disco local.
O Borg lê diretamente do S3 sem cache 33 horas. Extremamente demorado.
Em resumo, o Borg consegue comprimir e possui blobs maiores — o que torna o armazenamento e as operações GET/PUT no S3 mais baratas. Mas isso vem com um custo de verificação mais complexa e lenta. Em termos de velocidade de recuperação — não notamos diferença. Os backups subsequentes (após o primeiro) realizados pelo restic demoram um pouco mais, mas não significativamente.
O tamanho da comunidade também foi um fator importante na escolha.
E escolhemos o borg.
Algumas palavras sobre compressão
O Borg possui um excelente novo algoritmo de compressão — zstd. Em termos de qualidade de compressão, não é pior que o gzip, mas é significativamente mais rápido. E comparável em velocidade ao lz4 padrão.
Por exemplo, um dump de banco de dados MySQL é comprimido cerca de duas vezes melhor que o lz4 com a mesma velocidade. Contudo, a experiência em dados reais mostra que há uma diferença muito pequena na taxa de compressão em nodos do Nextcloud.
No Borg, há um modo de compressão bastante benéfico — se o arquivo tem alta entropia, a compressão não é aplicada, aumentando assim a velocidade de operação. É ativada com a opção ao criar
-C auto,zstd
para o algoritmo zstd
Com essa opção, em comparação à compressão padrão, obtivemos
560 Gb e 562 Gb, respectivamente. Os dados do exemplo acima, lembrando que sem compressão o resultado é 628 Gb. O resultado de 2 Gb de diferença nos surpreendeu um pouco, mas decidimos que ainda assim escolheremos auto,zstd.
Metodologia de verificação de backup
O script é executado em uma VM diretamente no provedor ou no cliente, o que reduz significativamente a carga na rede. Pelo menos, isso é mais barato do que levantar uma infraestrutura própria e trafegar os dados.
goofys --cache "--free:5%:\/mnt\/cache" -o allow_other --endpoint https:\/\/storage.yandexcloud.net --file-mode=0666 --dir-mode=0777 xxxxxxx.com \/mnt\/goofys
export BORG_PASSCOMMAND="cat \/home\/borg\/.borg-passphrase"
borg list \/mnt\/goofys\/borg1\/
borg check --debug -p --verify-data \/mnt\/goofys\/borg1\/
Usamos o mesmo esquema para verificar os arquivos com antivírus (post-fato). Afinal, os usuários carregam diversos conteúdos no Nextcloud e nem todos possuem antivírus. Realizar a verificação no momento do upload leva muito tempo e atrapalha os negócios.
A escalabilidade é alcançada ao executar runners em diferentes nós com diferentes etiquetas.
Em nossa monitoria, coletamos os status de backups através da API do GitLab em uma única janela; se necessário, problemas são facilmente notados e também facilmente localizados.
Conclusão
Como resultado, sabemos com certeza que fazemos backups, que nossos backups são válidos, e os problemas que surgem levam pouco tempo e são resolvidos no nível do administrador de plantão. Os backups ocupam realmente pouco espaço em comparação com tar.gz ou Bacula.
Fonte: habr.com
