

Olá a todos! Sou desenvolvedor de CV na KROK. Já faz 3 anos que realizamos projetos na área de CV. Durante esse tempo, fizemos muitas coisas, por exemplo: monitoramos motoristas para que não bebessem, fumassem, usassem o celular ou olhassem para o céu em vez da estrada; registramos aqueles que gostam de andar nas faixas exclusivas e ocupar vários lugares de estacionamento; supervisionamos para garantir que os trabalhadores usassem capacetes, luvas, etc.; identificamos funcionários que desejam entrar no local; contabilizamos tudo o que era possível.
A que eu quero chegar com tudo isso?
Durante a implementação dos projetos, cometemos muitos erros, e você pode já estar familiarizado com alguns problemas ou irá se deparar com eles no futuro.
Modelando uma situação
Vamos imaginar que começamos a trabalhar em uma empresa jovem "N", cuja atividade está relacionada a ML. Estamos trabalhando em um projeto de ML (DL, CV), mas por algum motivo, mudamos para outro trabalho, em resumo, fazemos uma pausa e voltamos para nossa ou outra rede neural.
- Chega o momento decisivo, precisamos lembrar onde paramos, quais hiperparâmetros testamos e, o mais importante, quais resultados eles trouxeram. Pode haver várias maneiras de como a informação foi armazenada durante todas as execuções: na cabeça, em arquivos de configuração, em um caderno, no ambiente de trabalho na nuvem. Já vi casos onde os hiperparâmetros foram armazenados como linhas comentadas no código, uma verdadeira viagem da imaginação. E agora, imagine que você não voltou para o seu projeto, mas para o projeto de alguém que deixou a empresa e que lhe deixou de herança um código e um modelo chamado model_1.pb. Para completar a imagem e transmitir toda a dor, vamos imaginar que você é também um especialista iniciante.
- Vamos em frente. Para executar o código, precisamos criar um ambiente para nós e todos que irão trabalhar com ele. Muitas vezes, este ambiente também não nos foi deixado por algum motivo. Isso também pode se tornar uma tarefa não trivial. Não queremos gastar tempo nessa etapa, certo?
- Treinamos um modelo (por exemplo, um detector de carros). Chegamos ao ponto em que ele está muito bem — é hora de salvar o resultado. Vamos chamá-lo de car_detection_v1.pb. Depois, treinamos outro — car_detection_v2.pb. Algum tempo depois, nossos colegas ou nós mesmos continuamos a treinar mais e mais, utilizando várias arquiteturas. No final, forma-se uma quantidade de artefatos, cujo gerenciamento precisa ser feito com cuidado (mas, faremos isso mais tarde, pois temos coisas mais prioritárias a tratar).
- E é isso! Temos um modelo! Podemos começar a treinar o próximo modelo, desenvolver a arquitetura para resolver uma nova tarefa ou podemos fazer uma pausa para tomar um chá? E quem vai fazer o deployment?
Identificando problemas
O trabalho em um projeto ou produto é o esforço de muitas pessoas. Com o tempo, pessoas entram e saem, os projetos aumentam em número e se tornam mais complexos. De uma forma ou de outra, as situações descritas no ciclo acima (e não só) em várias combinações irão ocorrer de iteração em iteração. Tudo isso resulta em perda de tempo, confusão, estresse, talvez em descontentamento do cliente, e, no final das contas, em dinheiro deixado nas mesas. Embora todos nós geralmente tropeçamos nas mesmas pedras antigas, acredito que ninguém queira passar por esses momentos repetidamente.
Assim, passamos por um ciclo de desenvolvimento e vemos que há problemas que precisam ser resolvidos. Para isso, precisamos:
- armazenar os resultados de forma conveniente;
- facilitar o processo de integração de novos colaboradores;
- simplificar o processo de implantação do ambiente de desenvolvimento;
- configurar o processo de versionamento dos modelos;
- ter um meio conveniente de validação dos modelos;
- encontrar uma ferramenta para gerenciar o estado dos modelos;
- encontrar uma forma de entregar os modelos em produção.
É evidente que é necessário pensar em um fluxo de trabalho que permita gerenciar facilmente e de forma conveniente esse ciclo de vida? Essa prática é conhecida como MLOps
MLOps, ou DevOps para aprendizado de máquina, permite que equipes de especialistas em processamento e análise de dados e de TI colaborem, além de acelerar o desenvolvimento e a implantação de modelos por meio de monitoramento, verificação e gerenciamento de modelos de aprendizado de máquina.
Você pode , o que os caras do Google pensam sobre tudo isso. Do artigo, fica claro que MLOps é uma coisa bastante abrangente.
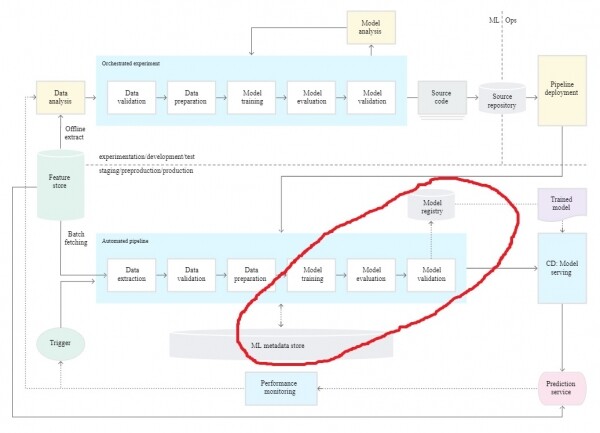
Na sequência do meu artigo, descreverei apenas uma parte do processo. Para realizar isso, usarei a ferramenta MLflow, pois é um projeto open-source, a integração requer uma quantidade mínima de código e possui integração com frameworks de ML populares. Você pode procurar na internet outras ferramentas, como Kubeflow, SageMaker, Trains, etc., e, possivelmente, escolher aquela que melhor atende às suas necessidades.
Construindo MLOps com o exemplo de uso da ferramenta MLFlow
MLFlow é uma plataforma open-source para gerenciar o ciclo de vida dos modelos de ML ().
O MLflow inclui quatro componentes:
- MLflow Tracking — aborda questões de registro de resultados e parâmetros que levaram a esse resultado;
- MLflow Project — permite empacotar o código e reproduzi-lo em qualquer plataforma;
- MLflow Models — é responsável pela implementação dos modelos em produção;
- MLflow Registry — permite armazenar modelos e gerenciar seu estado em um repositório centralizado.
O MLflow opera com duas entidades:
- run — é o ciclo completo de treinamento, parâmetros e métricas que queremos registrar;
- experiment — é o 'tema' que agrupa as execuções.
Todos os passos do exemplo são realizados no sistema operacional Ubuntu 18.04.
1. Implantamos o servidor
Para que possamos gerenciar facilmente nosso projeto e obter todas as informações necessárias, vamos implantar um servidor. O servidor de rastreamento do MLflow possui dois componentes principais:
- backend store — é responsável por armazenar informações sobre os modelos registrados (suporta 4 SGBDs: mysql, mssql, sqlite e postgresql);
- artifact store — é responsável por armazenar artefatos (suporta 7 opções de armazenamento: Amazon S3, Azure Blob Storage, Google Cloud Storage, servidor FTP, servidor SFTP, NFS, HDFS).
Como artifact store para simplificar, vamos usar um servidor SFTP.
- criamos o grupo
$ sudo groupadd sftpg - adicionamos um usuário e definimos uma senha para ele
$ sudo useradd -g sftpg mlflowsftp $ sudo passwd mlflowsftp - ajustamos algumas configurações de acesso
$ sudo mkdir -p /data/mlflowsftp/upload $ sudo chown -R root.sftpg /data/mlflowsftp $ sudo chown -R mlflowsftp.sftpg /data/mlflowsftp/upload - adicionamos algumas linhas em /etc/ssh/sshd_config
Match Group sftpg ChrootDirectory /data/%u ForceCommand internal-sftp - reiniciamos o serviço
$ sudo systemctl restart sshd
Como backend store vamos usar postgresql.
$ sudo apt update
$ sudo apt-get install -y postgresql postgresql-contrib postgresql-server-dev-all
$ sudo apt install gcc
$ pip install psycopg2
$ sudo -u postgres -i
# Criar novo usuário: mlflow_user
[postgres@user_name~]$ createuser --interactive -P
Digite o nome da função a ser adicionada: mlflow_user
Digite a senha para a nova função: mlflow
Digite novamente: mlflow
O novo papel deve ser um superusuário? (s/n) n
O novo papel pode criar bancos de dados? (s/n) n
O novo papel pode criar mais novos papéis? (s/n) n
# Criar banco de dados mlflow_bd de propriedade de mlflow_user
$ createdb -O mlflow_user mlflow_db
Para iniciar o servidor, você precisa instalar os seguintes pacotes python (recomendo criar um ambiente virtual separado):
pip install mlflow
pip install pysftp
Vamos iniciar nosso servidor
$ mlflow server
                 --backend-store-uri postgresql://mlflow_user:mlflow@localhost/mlflow_db
                 --default-artifact-root sftp://mlflowsftp:mlflow@sftp_host/upload
                --host server_host
                --port server_port
2. Adicionando rastreamento
Para que os resultados de nossos treinos não se percam, as futuras gerações de desenvolvedores compreendam o que realmente aconteceu, e vocês e os mais experientes possam analisar tranquilamente o processo de aprendizado, precisamos adicionar rastreamento. O rastreamento refere-se à preservação de parâmetros, métricas, artefatos e qualquer informação adicional sobre a execução do treinamento, neste caso, no servidor.
Como exemplo, criei um pequeno em Keras para segmentação de tudo que existe no . Para adicionar o rastreamento, criei o arquivo mlflow_training.py.
Aqui estão as linhas onde acontece a parte mais interessante:
def run(self, epochs, lr, experiment_name):
        # obtendo o id do experimento, criando um experimento na sua ausência
        remote_experiment_id = self.remote_server.get_experiment_id(name=experiment_name)
        # criando um "run" e obtendo seu id
        remote_run_id = self.remote_server.get_run_id(remote_experiment_id)

        # indicar que queremos salvar os resultados em um servidor remoto
        mlflow.set_tracking_uri(self.tracking_uri)
        mlflow.set_experiment(experiment_name)

        with mlflow.start_run(run_id=remote_run_id, nested=False):
            mlflow.keras.autolog()
            self.train_pipeline.train(lr=lr, epochs=epochs)

        try:
            self.log_tags_and_params(remote_run_id)
        except mlflow.exceptions.RestException as e:
            print(e)
Aqui, self.remote_server é uma pequena camada sobre os métodos mlflow.tracking. MlflowClient (fiz para conveniência), com os quais crio um experimento e execução no servidor. Em seguida, indico para onde os resultados da execução devem ser enviados (mlflow.set_tracking_uri(self.tracking_uri)). Conecto o registro automático mlflow.keras.autolog(). Até o momento, o MLflow Tracking suporta o registro automático para TensorFlow, Keras, Gluon XGBoost, LightGBM, Spark. Se você não encontrou seu framework ou biblioteca, sempre pode registrar explicitamente. Iniciamos o treinamento. Registramos tags e parâmetros de entrada no servidor remoto.
Com algumas linhas, você, assim como todos os interessados, terá acesso às informações sobre todas as execuções. Legal?
3. Estruturando o projeto
Agora vamos tornar a execução do projeto mais fácil. Para isso, adicionaremos um arquivo MLproject e conda.yaml na raiz do projeto.
MLproject
name: flow_segmentation
conda_env: conda.yaml

entry_points:
  main:
    parameters:
        categories: {help: 'lista de categorias do conjunto de dados coco'}
        epochs: {type: int, help: 'número de épocas no treinamento'}

        lr: {type: float, default: 0.001, help: 'taxa de aprendizado'}
        batch_size: {type: int, default: 8}
        model_name: {type: str, default: 'Unet', help: 'Unet, PSPNet, Linknet, FPN'}
        backbone_name: {type: str, default: 'resnet18', help: 'exemplo resnet18, resnet50, mobilenetv2 ...'}

        tracking_uri: {type: str, help: 'o endereço do servidor'}
        experiment_name: {type: str, default: 'My_experiment', help: 'nome do experimento remoto e local'}
    command: "python mlflow_training.py
            --epochs={epochs}
            --categories={categories}
            --lr={lr}
            --tracking_uri={tracking_uri}
            --model_name={model_name}
            --backbone_name={backbone_name}
            --batch_size={batch_size}
            --experiment_name={experiment_name}"
O projeto MLflow tem várias propriedades:
- Name — nome do seu projeto;
- Environment — no meu caso, conda_env indica que o Anaconda é usado para a execução, e a descrição das dependências está no arquivo conda.yaml;
- Entry Points — indica quais arquivos e com quais parâmetros podemos executar (todos os parâmetros durante o treinamento são registrados automaticamente)
conda.yaml
name: flow_segmentation
channels:
  - defaults
  - anaconda
dependencies:
  - python==3.7
  - pip:
    - mlflow==1.8.0
    - pysftp==0.2.9
    - Cython==0.29.19
    - numpy==1.18.4
    - pycocotools==2.0.0
    - requests==2.23.0
    - matplotlib==3.2.1
    - segmentation-models==1.0.1
    - Keras==2.3.1
    - imgaug==0.4.0
    - tqdm==4.46.0
    - tensorflow-gpu==1.14.0
Como ambiente de execução, você pode utilizar o docker; para mais informações, consulte .
4. Iniciando o treinamento
Clone o projeto e entre no diretório do projeto:
git clone https://github.com/simbakot/mlflow_example.git
cd mlflow_example/
Para a execução, você precisará instalar as bibliotecas
pip install mlflow
pip install pysftp
Como estou usando conda_env no exemplo, o Anaconda deve estar instalado no seu computador (mas isso pode ser contornado instalando todos os pacotes necessários manualmente e ajustando os parâmetros de inicialização).
Todos os passos preparatórios estão concluídos e podemos começar a executar o treinamento. A partir da raiz do projeto:
$ mlflow run -P epochs=10 -P categories=cat,dog -P tracking_uri=http://server_host:server_port .Após inserir o comando, um ambiente conda será criado automaticamente e o treinamento começará.
No exemplo acima, eu passei o número de épocas para o treinamento, as categorias nas quais queremos segmentar (a lista completa pode ser vista ) e o endereço do nosso servidor remoto.
A lista completa de parâmetros possíveis pode ser vista no arquivo MLproject.
5. Avaliamos os resultados do treinamento
Após a conclusão do treinamento, podemos acessar no navegador o endereço do nosso servidor
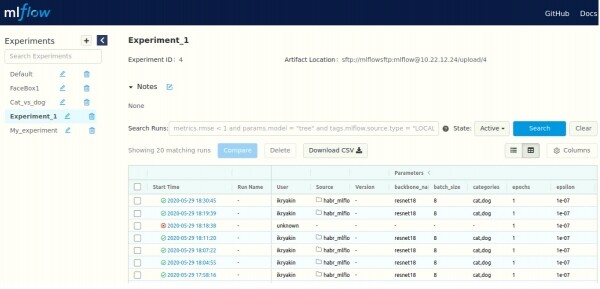
Aqui vemos a lista de todos os experimentos (no canto superior esquerdo), bem como informações sobre as execuções (no meio). Podemos ver informações mais detalhadas (parâmetros, métricas, artefatos e algumas informações adicionais) sobre cada execução.
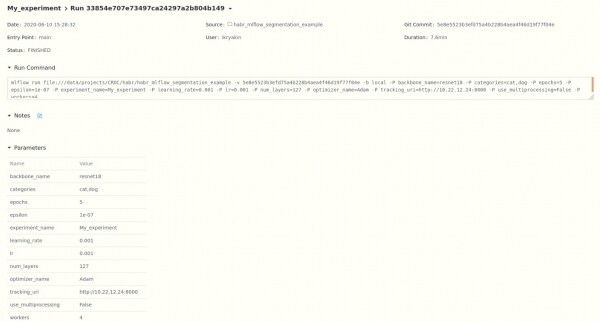
Para cada métrica, podemos observar o histórico de mudanças.
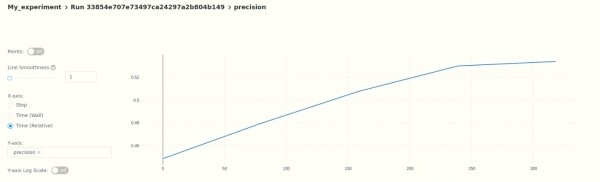
Ou seja, atualmente podemos analisar os resultados em modo "manual", além disso, você pode configurar validação automática usando a API do MLflow.
6. Registramos o modelo
Depois de analisar nosso modelo e decidir que está pronto para produção, começamos seu registro; para isso, escolhemos a execução desejada (como mostrado no ponto anterior) e descemos.
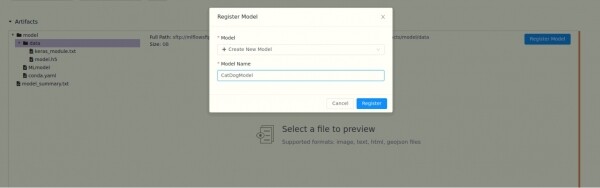
Depois de darmos um nome ao nosso modelo, ele ganha uma versão. Ao salvar outro modelo com o mesmo nome, a versão será automaticamente incrementada.
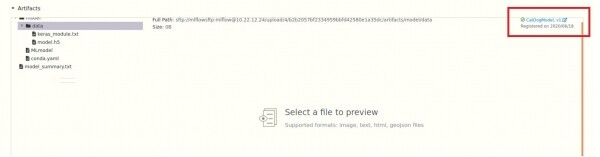
Para cada modelo, podemos adicionar uma descrição e escolher um dos três estados (Staging, Production, Archived); posteriormente, podemos acessar esses estados via API, o que, junto com o versionamento, oferece flexibilidade adicional.
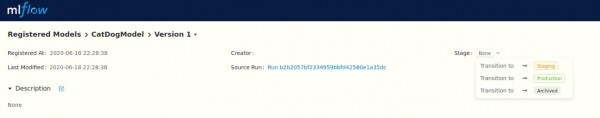
Temos também acesso conveniente a todos os modelos
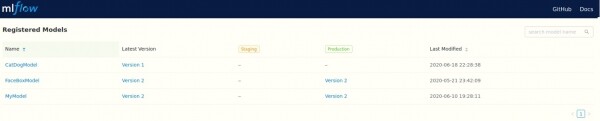
e suas versões.
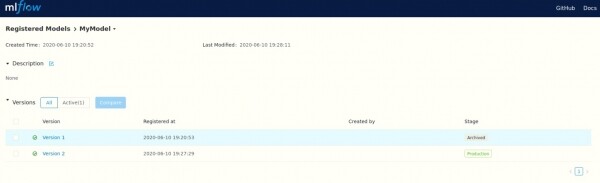
Assim como no ponto anterior, todas as operações podem ser feitas através da API.
7. Implantamos o modelo
Nesta etapa, já temos um modelo treinado (keras). Um exemplo de como usá-lo:
class SegmentationModel:
    def __init__(self, tracking_uri, model_name):

        self.registry = RemoteRegistry(tracking_uri=tracking_uri)
        self.model_name = model_name
        self.model = self.build_model(model_name)

    def get_latest_model(self, model_name):
        registered_models = self.registry.get_registered_model(model_name)
        last_model = self.registry.get_last_model(registered_models)
        local_path = self.registry.download_artifact(last_model.run_id, 'model', '.\/')
        return local_path

    def build_model(self, model_name):
        local_path = self.get_latest_model(model_name)

        return mlflow.keras.load_model(local_path)

    def predict(self, image):
        image = self.preprocess(image)
        result = self.model.predict(image)
        return self.postprocess(result)

    def preprocess(self, image):
        image = cv2.resize(image, (256, 256))
        image = image \/ 255.
        image = np.expand_dims(image, 0)
        return image

    def postprocess(self, result):
        return result
Aqui, self.registry é novamente uma pequena camada sobre mlflow.tracking.MlflowClient, para conveniência. A questão é que estou acessando um servidor remoto e procurando por um modelo com o nome especificado, sendo a versão de produção mais recente. Depois, baixo o artefato localmente para a pasta .\/model e construo o modelo a partir deste diretório mlflow.keras.load_model(local_path). Agora podemos usar nosso modelo. Os desenvolvedores de CV (ML) podem tranquilamente trabalhar na melhoria do modelo e publicar novas versões.
Para concluir
Apresentei um sistema que permite:
- armazenar informações sobre modelos de ML, andamento e resultados de treinamento de forma centralizada;
- implantar rapidamente um ambiente de desenvolvimento;
- monitorar e analisar o progresso do trabalho nos modelos;
- gerenciar versões e controlar o estado dos modelos com facilidade;
- fazer o deploy dos modelos obtidos com facilidade.
Este exemplo é apenas um protótipo e serve como ponto de partida para construir seu próprio sistema, que pode incluir a automação da avaliação de resultados e o registro de modelos (itens 5 e 6, respectivamente) ou você pode incluir versionamento de datasets, ou talvez algo mais? Tentei transmitir a ideia de que você precisa de MLOps em geral, o MLflow é apenas um meio para atingir esse objetivo.
Escreva sobre quais problemas você enfrentou que não mencionei?
O que você adicionaria ao sistema para atender suas necessidades?
Quais ferramentas e abordagens você utiliza para resolver total ou parcialmente esses problemas?
P.S. Deixarei alguns links:
projeto do github —
MLflow —
Meu e-mail de contato para perguntas — ikryakin@croc.ru
Na nossa empresa, ocasionalmente, realizamos diversos eventos para profissionais de TI. Por exemplo, no dia 8 de julho, às 19:00, horário de Moscovo, ocorrerá um meetup sobre CV em formato online. Se estiver interessado, pode participar, basta se registrar. .
Fonte: habr.com
