

Se a sua infraestrutura de TI está crescendo rapidamente, mais cedo ou mais tarde você terá que enfrentar a decisão de aumentar linearmente os recursos humanos para seu suporte ou começar a automação. Até certo ponto, vivemos na primeira paradigma, e depois começou um longo caminho em direção ao Infrastructure-as-Code.
É claro que a NSPK não é uma startup, mas essa atmosfera reinava na empresa nos primeiros anos de existência, e foram anos muito interessantes. Meu nome é , há mais de 10 anos eu suporte a infraestrutura Linux com altos requisitos de disponibilidade. Entrei para a equipe da NSPK em janeiro de 2016 e, infelizmente, não vivenciei o início da existência da empresa, mas cheguei em um momento de grandes mudanças.
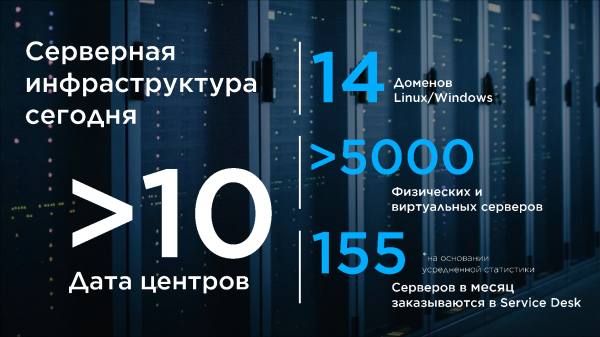
De maneira geral, pode-se dizer que nossa equipe oferece 2 produtos para a empresa. O primeiro – é a infraestrutura. O e-mail deve funcionar, o DNS deve operar, e os controladores de domínio – devem permitir acesso aos servidores, que não podem falhar. O cenário de TI da empresa é imenso! São sistemas críticos para os negócios e missões, com requisitos de disponibilidade de alguns – 99,999. O segundo produto – são os próprios servidores, físicos e virtuais. É necessário monitorar os existentes e fornecer novos regularmente aos clientes de várias divisões. Neste artigo, quero enfatizar como nós desenvolvemos a infraestrutura que é responsável pelo ciclo de vida servidores.
Início da jornada
No início, nosso stack de tecnologias parecia assim:
OS CentOS 7
Controladores de domínio FreeIPA
Automação – Ansible(+Tower), Cobbler
Tudo isso estava distribuído em 3 domínios, espalhados por vários data centers. Em um data center – sistemas de escritório e ambientes de teste, nos outros, produção.
A criação de servidores em algum momento parecia assim:
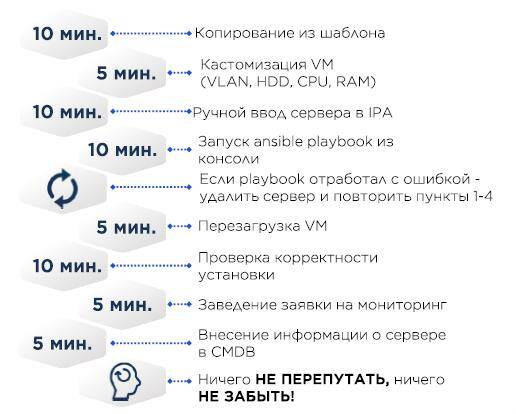
No template VM CentOS minimal e o mínimo necessário, como um correto /etc/resolv.conf, o restante é obtido através do Ansible.
CMDB – Excel.
Se o servidor é físico, em vez de copiar a máquina virtual, o sistema operacional é instalado usando o Cobbler – os endereços MAC do servidor de destino são adicionados à configuração do Cobbler, o servidor recebe um endereço IP via DHCP, e então o sistema operacional é instalado.
No início, tentávamos até fazer algum gerenciamento de configuração no Cobbler. Mas, com o tempo, isso começou a trazer problemas de portabilidade das configurações tanto para outros data centers quanto para o código do Ansible para preparar a VM.
Durante um tempo, muitos de nós viam o Ansible como uma extensão conveniente do Bash e não economizávamos nas construções usando shell, sed. Em resumo, Bashsible. Isso acabava resultando em um cenário onde, se um playbook não funcionasse por algum motivo no servidor, era mais fácil excluir o servidor, corrigir o playbook e reaplicá-lo. Não havia na prática versionamento de scripts nem portabilidade de configurações.
Por exemplo, decidimos alterar alguma configuração em todos os servidores:
- Alterando a configuração em servidores existentes no segmento lógico/datacenter. Às vezes isso não é feito em um só dia – os requisitos de disponibilidade e a lei dos grandes números não permitem aplicar todas as mudanças de uma vez. Algumas alterações são potencialmente destrutivas e requerem a reinicialização de algo – desde serviços até o próprio sistema operacional.
- Corrigindo no Ansible
- Corrigindo no Cobbler
- Repetimos N vezes para cada segmento lógico/datacenter
Para que todas as mudanças ocorressem sem problemas, era necessário considerar uma variedade de fatores, e as mudanças ocorrem constantemente.
- Refatoração do código Ansible e dos arquivos de configuração
- Mudanças nas melhores práticas internas
- Alterações com base na análise de incidentes/acidentes
- Mudança nos padrões de segurança, tanto internos quanto externos. Por exemplo, o PCI DSS é complementado a cada ano com novos requisitos
Crescimento da infraestrutura e início do caminho
O número de servidores/domínios lógicos/datacenters crescia, assim como o número de erros nas configurações. Em determinado momento, chegamos a três direções nas quais precisávamos desenvolver a gestão de configuração:
- Automatização. Sempre que possível, devemos evitar o fator humano em operações repetitivas.
- Repetibilidade. Gerenciar a infraestrutura é muito mais fácil quando ela é previsível. A configuração dos servidores e das ferramentas para sua preparação deve ser a mesma em todos os lugares. Isso também é importante para as equipes de produto – o aplicativo deve garantir que, após os testes, ele chegue ao ambiente produtivo configurado de forma semelhante ao ambiente de teste.
- Simplicidade e transparência na realização de mudanças na gestão de configuração.
Falta adicionar algumas ferramentas.
Como repositório de código, escolhemos o GitLab CE, não menos importante devido aos módulos CI/CD integrados.
Repositório de segredos – Hashicorp Vault, também pela excelente API.
Teste de configurações e funções do Ansible - Molecule + Testinfra. Os testes são muito mais rápidos se você conectar o mitogen ao Ansible. Paralelamente, começamos a escrever nosso próprio CMDB e orquestrador para implantação automática (na imagem acima do Cobbler), mas isso é uma história completamente diferente, que meu colega e principal desenvolvedor desses sistemas contará no futuro.
Nossa escolha:
Molecule + Testinfra
Ansible + Tower + AWX
Mundo dos Servidores + DITNET (Desenvolvimento próprio)
Cobbler
Gitlab + GitLab runner
Hashicorp Vault
Por falar em funções do Ansible. Inicialmente, havia uma única função, mas após várias refatorações, elas aumentaram para 17. Recomendo categoricamente dividir o monólito em funções idempotentes que podem ser executadas separadamente, e tags adicionais podem ser adicionadas. Nós dividimos as funções por funcionalidade – rede, registro, pacotes, hardware, molecule, etc. De fato, seguimos a estratégia abaixo. Não insisto que esta é a verdade única, mas funcionou para nós.
- Copiar servidores de uma "imagem de ouro" é um mal!Entre as principais desvantagens, você realmente não sabe em que estado estão as imagens atualmente, e que todas as mudanças afetarão todas as imagens em todas as fazendas de virtualização.
- Use arquivos de configuração padrão minimamente e combine com outras unidades que você é responsável pelos principais arquivos do sistema., por exemplo:
- Mantenha /etc/sysctl.conf vazio; as configurações devem estar apenas em /etc/sysctl.d/. Seu padrão em um arquivo, personalizado para o aplicativo em outro.
- Use arquivos de substituição para editar unidades systemd.
- Template todos os configs e sempre insira-os por inteiro, evitando o uso de sed e seus análogos em playbooks, sempre que possível.
- Refatorando o código do sistema de gerenciamento de configurações:
- Divida as tarefas em entidades lógicas e reescreva o monólito em funções.
- Use linters! Ansible-lint, yaml-lint, etc.
- Mude a abordagem! Nada de bashsible. É necessário descrever o estado do sistema.
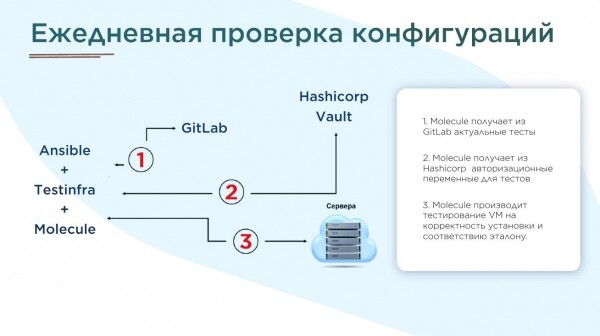
- Para todas as funções do Ansible, você deve escrever testes no molecule e gerar relatórios uma vez por dia.
- No nosso caso, após preparar os testes (que são mais de 100), cerca de 70.000 erros foram encontrados. Corrigimos por vários meses.

Nossa implementação
Então, as funções do Ansible estavam prontas, modeladas e verificadas por linters. E até mesmo os git estão configurados em todos os lugares. Mas a questão da entrega confiável do código em diferentes segmentos ainda estava em aberto. Decidimos sincronizar com scripts. Ficou assim:
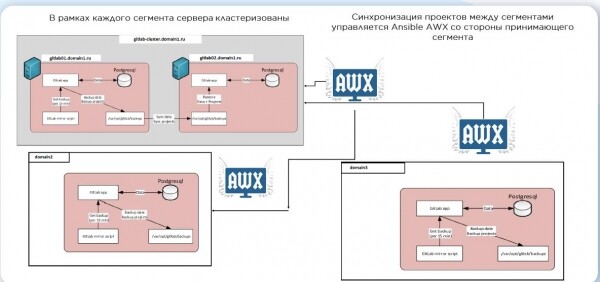
Após a chegada da mudança, CI é acionado, um servidor de teste é criado, os papéis são aplicados e testados com o Molecule. Se tudo estiver ok, o código vai para o ramo de produção. Mas não aplicamos o novo código em servidores existentes automaticamente. Essa é uma espécie de bloqueio que é necessário para a alta disponibilidade de nossos sistemas. E quando a infraestrutura se torna enorme, a lei dos grandes números entra em jogo — mesmo que você esteja certo de que a mudança é inofensiva, ela pode levar a consequências trágicas.
Existem muitas opções para a criação de servidores. No final, escolhemos scripts personalizados em Python. E para CI, Ansible:
- name: create1.yml - Criar uma VM a partir de um template
  vmware_guest:
    hostname: "{{datacenter}}".domain.ru
    username: "{{ username_vc }}"
    password: "{{ password_vc }}"
    validate_certs: no
    cluster: "{{cluster}}"
    datacenter: "{{datacenter}}"
    name: "{{ name }}"
    state: poweredon
    folder: "\/{{folder}}"
    template: "{{template}}"
    customization:
      hostname: "{{ name }}"
      domain: domain.ru
      dns_servers:
        - "{{ ipa1_dns }}"
        - "{{ ipa2_dns }}"
    networks:
      - name: "{{ network }}"
        type: static
        ip: "{{ip}}"
        netmask: "{{netmask}}"
        gateway: "{{gateway}}"
        wake_on_lan: True
        start_connected: True
        allow_guest_control: True
    wait_for_ip_address: yes
    disk:
      - size_gb: 1
        type: thin
        datastore: "{{datastore}}"
      - size_gb: 20
        type: thin
        datastore: "{{datastore}}"
Isso é onde chegamos, o sistema continua vivo e em desenvolvimento.
- 17 roles do Ansible para configuração de servidor. Cada uma das roles é destinada a resolver uma tarefa lógica específica (registro, auditoria, autorização de usuários, monitoramento, etc.).
- Testando roles. Molecule + TestInfra.
- Desenvolvimento próprio: CMDB + Orquestrador.
- Tempo de criação do servidor ~30 minutos, automatizado e praticamente independente da fila de tarefas.
- Estado/nome da infraestrutura igual em todos os segmentos – playbooks, repositórios, elementos de virtualização.
- Verificação diária do estado dos servidores com geração de relatórios sobre as discrepâncias em relação ao padrão.
Espero que minha história seja útil para aqueles que estão no início do caminho. E qual pilha de automação você está usando?
Fonte: habr.com
