

Há algum tempo, enfrentamos a questão de escolher uma ferramenta ETL para trabalhar com Big Data. A solução anteriormente utilizada, Informatica BDM, não nos atendia devido a sua funcionalidade limitada. Seu uso se resumia a um framework para o lançamento de comandos spark-submit. No mercado, havia poucas alternativas realmente capazes de lidar com o volume de dados com o qual lidamos diariamente. No final, escolhemos o Ab Initio. Durante as demonstrações piloto, o produto demonstrou uma velocidade de processamento de dados muito alta. Há quase nenhuma informação sobre o Ab Initio em português, então decidimos compartilhar nossa experiência no Habr.
O Ab Initio possui várias transformações clássicas e incomuns, cujo código pode ser expandido usando a própria linguagem PDL. Para pequenas empresas, tal ferramenta poderosa pode ser um exagero, e a maioria de suas funcionalidades pode se mostrar cara e desnecessária. Mas se suas operações se aproximam das do Sberbank, o Ab Initio pode ser interessante para você.
Ele ajuda as empresas a acumular conhecimento globalmente e desenvolver um ecossistema, enquanto permite que os desenvolvedores aprimorem suas habilidades em ETL, aprofundem seus conhecimentos em shell, oferece a oportunidade de aprender a linguagem PDL, fornece uma visão visual dos processos de carga e simplifica o desenvolvimento graças à abundância de componentes funcionais.
Neste post, falarei sobre as capacidades do Ab Initio e apresentarei características comparativas de seu desempenho com Hive e GreenPlum.
- Descrição do framework MDW e do trabalho de sua configuração para o GreenPlum
- Características comparativas de desempenho do Ab Initio em relação ao Hive e GreenPlum
- Funcionamento do Ab Initio com GreenPlum em modo Near Real Time
A funcionalidade deste produto é muito ampla e requer um bom tempo para ser estudada. No entanto, com as habilidades adequadas e configurações corretas de desempenho, os resultados do processamento de dados são bastante impressionantes. O uso do Ab Initio pode proporcionar ao desenvolvedor uma experiência interessante. É uma nova perspectiva sobre desenvolvimento ETL, um híbrido entre um ambiente visual e o desenvolvimento de cargas em uma linguagem semelhante a scripts.
Os negócios estão desenvolvendo seus ecossistemas e esta ferramenta se mostra mais relevante do que nunca. Com o Ab Initio, é possível acumular conhecimento sobre o negócio atual e utilizar essas informações para ampliar negócios existentes e abrir novos. Alternativas ao Ab Initio incluem as plataformas de desenvolvimento visual Informatica BDM e, em ambientes não visuais, o Apache Spark.
Descrição do Ab Initio
O Ab Initio, assim como outras ferramentas ETL, consiste em um conjunto de produtos.
O Ab Initio GDE (Graphical Development Environment) é um ambiente para desenvolvedores onde eles configuram transformações de dados e conectam essas transformações em fluxos de dados representados por setas. Esse conjunto de transformações é chamado de gráfico:
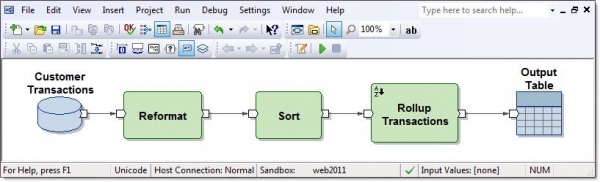
As conexões de entrada e saída dos componentes funcionais são chamadas de portas e contêm campos calculados dentro das transformações. Vários gráficos, conectados por fluxos de setas na ordem em que são executados, são chamados de plano.
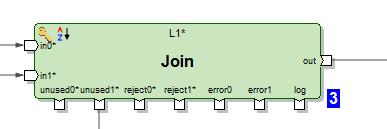
Existem várias centenas de componentes funcionais, o que é bastante. Muitos deles são altamente especializados. As capacidades das transformações clássicas no Ab Initio são mais amplas do que nas outras ferramentas ETL. Por exemplo, o Join possui várias saídas. Além do resultado da junção dos conjuntos de dados, é possível obter registros dos conjuntos de dados de entrada, cujas chaves não conseguiram se conectar. Também é possível obter rejeições, erros e um log do trabalho da transformação, que pode ser lido neste mesmo gráfico como um arquivo de texto e processado por outras transformações:
Ou, por exemplo, é possível materializar o receptor de dados na forma de uma tabela e ler dados dela neste mesmo gráfico.
Existem transformações originais. Por exemplo, a transformação Scan possui funcionalidades como nas funções analíticas. Há transformações com nomes descritivos: Create Data, Read Excel, Normalize, Sort within Groups, Run Program, Run SQL, Join with DB, entre outras. Os gráficos podem utilizar parâmetros de tempo de execução, incluindo a possibilidade de passar parâmetros do sistema operacional ou para o sistema operacional. Arquivos com um conjunto de parâmetros prontos para passar para o gráfico são chamados de conjuntos de parâmetros (psets).
Como esperado, o Ab Initio GDE possui seu repositório, chamado EME (Enterprise Meta Environment). Os desenvolvedores têm a capacidade de trabalhar com versões locais do código e realizar check-in de seus desenvolvimentos no repositório central.
É possível, durante ou após a execução do gráfico, clicar em qualquer transformação de fluxo e visualizar os dados que passaram entre essas transformações:
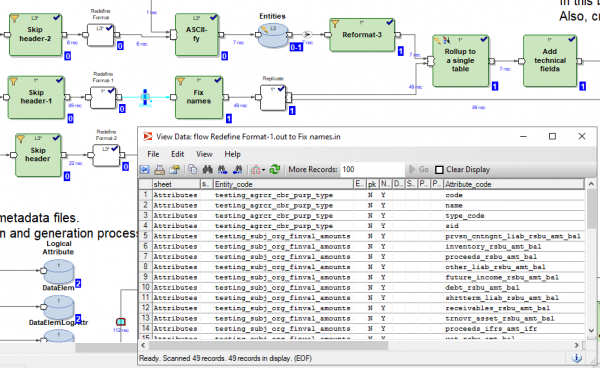
Também é possível clicar em qualquer fluxo e verificar os detalhes de rastreamento - em quantos paralelos a transformação funcionou, quantas linhas e bytes foram carregados em cada um dos paralelos:
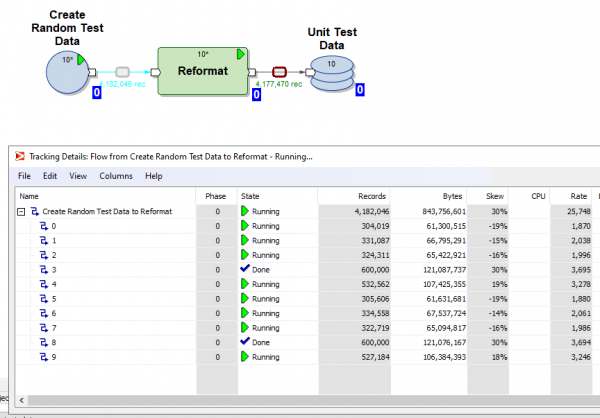
É possível dividir a execução do gráfico em fases e marcar quais transformações precisam ser executadas primeiro (na fase zero), as seguintes na primeira fase, as seguintes na segunda fase, e assim por diante.
Para cada transformação, é possível escolher um layout (onde será executada): sem paralelos ou em fluxos paralelos, cujo número pode ser definido. Os arquivos temporários que o Ab Initio cria ao trabalhar com as transformações podem ser armazenados tanto no sistema de arquivos servidor, quanto no HDFS.
Em cada transformação, com base em um modelo padrão, é possível criar seu próprio script na linguagem PDL, que é um pouco semelhante ao shell.
Com a linguagem PDL, você pode expandir a funcionalidade das transformações e, em particular, pode gerar dinamicamente (durante a execução) fragmentos arbitrários de código dependendo dos parâmetros de execução.
Além disso, o Ab Initio tem uma boa integração com o SO através do shell. Especificamente, o Sberbank usa o linux ksh. É possível trocar variáveis com o shell e usá-las como parâmetros dos gráficos. É possível chamar a execução dos gráficos Ab Initio a partir do shell e administrar o Ab Initio.
Além do Ab Initio GDE, o fornecedor oferece muitos outros produtos. Existe seu próprio Co>Operation System, que se propõe a ser um sistema operacional. Existe o Control>Center, onde é possível agendar e monitorar os fluxos de carga. Existem produtos para realizar desenvolvimento em um nível mais primitivo do que o que o Ab Initio GDE permite.
Descrição do framework MDW e do trabalho de sua configuração para o GreenPlum
Junto com seus produtos, o fornecedor entrega o produto MDW (Metadata Driven Warehouse), que é um configurador de gráficos, destinado a ajudar nas tarefas típicas de preenchimento de armazéns de dados ou data vaults.
Ele contém parseadores de metadados personalizados (específicos do projeto) e geradores de código prontos para uso.
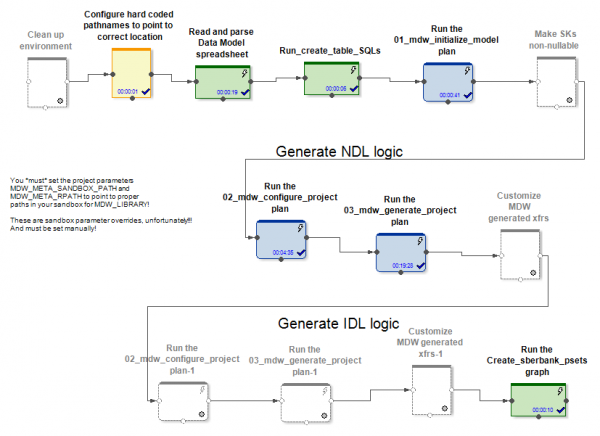
Na entrada, o MDW recebe um modelo de dados, um arquivo de configuração para o ajuste da conexão com o banco de dados (Oracle, Teradata ou Hive) e algumas outras configurações. A parte específica do projeto, por exemplo, implanta o modelo no banco de dados. A parte padrão do produto gera grafos e arquivos de configuração para eles com o carregamento de dados nas tabelas do modelo. Nesse processo, são criados grafos (e psets) para vários modos de trabalho inicial e incremental na atualização de entidades.
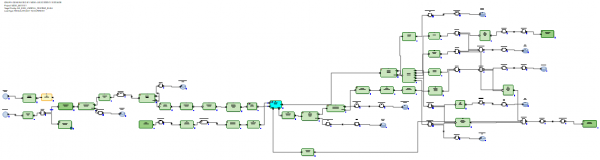
Nos casos do Hive e RDBMS, são gerados grafos distintos para a atualização inicial e incremental dos dados.
No caso do Hive, os dados recebidos do delta são unidos por meio do Ab Initio Join com os dados que estavam na tabela antes da atualização. Os carregadores de dados no MDW (tanto no Hive quanto no RDBMS) não apenas inserem novos dados do delta, mas também fecham os períodos de validade dos dados cujas chaves primárias receberam o delta. Além disso, é necessário reescrever a parte inalterada dos dados. Contudo, isso é necessário, pois o Hive não possui operações de delete ou update.
No caso do RDBMS, os grafos para atualização incremental dos dados são mais otimizados, uma vez que o RDBMS possui reais capacidades de atualização.
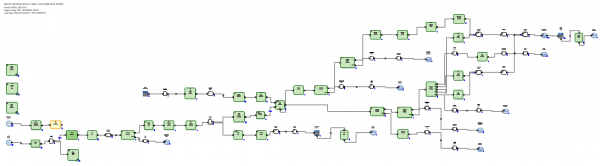
O delta recebido é carregado em uma tabela intermediária no banco de dados. Após isso, ocorre a junção do delta com os dados que estavam na tabela antes da atualização. Isso é feito por meio de SQL usando uma consulta SQL gerada. Em seguida, com comandos SQL de delete+insert, novos dados do delta são inseridos na tabela alvo e os períodos de validade dos dados, cujas chaves primárias receberam o delta, são fechados.
Não há necessidade de reescrever os dados inalterados.
Assim, chegamos à conclusão de que, no caso do Hive, o MDW deve optar por reescrever toda a tabela, pois o Hive não tem a função de atualização. E nada melhor que uma reescrita completa dos dados ao realizar uma atualização. No caso do RDBMS, ao contrário, os criadores do produto acharam necessário confiar à utilização do SQL a junção e atualização das tabelas.
Para o projeto no Sberbank, criamos uma nova implementação reutilizável do carregador de banco de dados para GreenPlum. Isso foi feito com base na versão que o MDW gera para Teradata. Foi a Teradata, e não a Oracle, que se mostrou mais adequada, pois também é um sistema MPP. As formas de operação, assim como a sintaxe da Teradata e do GreenPlum, acabaram sendo semelhantes.
Exemplos de diferenças críticas para o MDW entre diferentes RDBMS são os seguintes. No GreenPlum, ao contrário da Teradata, ao criar tabelas é necessário escrever a cláusula
distributed byNa Teradata escreve-se
delete <table> all, enquanto no GreenPlum escreve-se
deletar de <table>Na Oracle, para otimização, escreve-se
delete from t where rowid in (), enquanto na Teradata e no GreenPlum escreve-se
delete from t where exists (select * from delta where delta.pk=t.pk)Vale ressaltar que, para o funcionamento do Ab Initio com o GreenPlum, foi necessário instalar o cliente GreenPlum em todos os nós do cluster Ab Initio. Isso se deve ao fato de que nos conectamos ao GreenPlum simultaneamente de todos os nós do nosso cluster. E, para que a leitura do GreenPlum fosse paralela e cada fluxo paralelo do Ab Initio lesse sua parte dos dados do GreenPlum, foi necessário colocar na seção "where" das consultas SQL uma construção compreensível ao Ab Initio
where ABLOCAL()e definir o valor dessa construção, especificando para a transformação que lê do banco de dados o parâmetro
ablocal_expr="string_concat("mod(t.", string_filter_out("{$TABLE_KEY}","{}"), ",", (decimal(3))(number_of_partitions()),")=", (decimal(3))(this_partition()))", que é compilada em algo como
mod(sk,10)=3, ou seja, é preciso sugerir ao GreenPlum um filtro explícito para cada partição. Para outros bancos de dados (Teradata, Oracle), o Ab Initio pode realizar essa paralelização automaticamente.
Características comparativas de desempenho do Ab Initio em relação ao Hive e GreenPlum
No Sberbank, foi realizado um experimento comparando o desempenho dos gráficos gerados pelo MDW em relação ao Hive e ao GreenPlum. No âmbito do experimento, no caso do Hive havia 5 nós no mesmo cluster que o Ab Initio, enquanto no caso do GreenPlum havia 4 nós em um cluster separado. Ou seja, o Hive teve certa vantagem sobre o GreenPlum "em termos de hardware".
Foram consideradas duas pares de gráficos realizando a mesma tarefa de atualização de dados no Hive e no GreenPlum. A execução dos gráficos foi feita com os gerados pelo configurador MDW:
- carregamento inicial + carregamento incremental de dados aleatórios na tabela Hive
- carregamento inicial + carregamento incremental de dados aleatórios na mesma tabela do GreenPlum
Em ambos os casos (Hive e GreenPlum), foram realizados carregamentos em 10 fluxos paralelos no mesmo cluster Ab Initio. Os dados intermediários para os cálculos do Ab Initio foram armazenados no HDFS (nos termos do Ab Initio, foi utilizado MFS layout usando HDFS). Uma linha de dados gerados aleatoriamente ocupou 200 bytes em ambos os casos.
O resultado foi o seguinte:
Hive:
Carga inicial no Hive
Linhas inseridas
6 000 000
60 000 000
600 000 000
Duração da carga inicial
em segundos
41
203
1 601
Carga incremental no Hive
Número de linhas na
tabela alvo no início do experimento
6 000 000
60 000 000
600 000 000
Número de linhas de delta aplicadas à
tabela alvo durante o experimento
6 000 000
6 000 000
6 000 000
Duração da carga incremental
em segundos
88
299
2 541
GreenPlum:
Carga inicial no GreenPlum
Linhas inseridas
6 000 000
60 000 000
600 000 000
Duração da carga inicial
em segundos
72
360
3 631
Carga incremental no GreenPlum
Número de linhas na
tabela alvo no início do experimento
6 000 000
60 000 000
600 000 000
Número de linhas de delta aplicadas à
tabela alvo durante o experimento
6 000 000
6 000 000
6 000 000
Duração da carga incremental
em segundos
159
199
321
Observamos que a velocidade da carga inicial, tanto no Hive quanto no GreenPlum, depende linearmente do volume de dados e, devido ao melhor hardware, é um pouco mais rápida para o Hive do que para o GreenPlum.
A carga incremental no Hive também depende linearmente do volume de dados anteriormente carregados na tabela alvo e ocorre de forma bastante lenta com o aumento do volume. Isso se deve à necessidade de reescrever completamente a tabela alvo. Isso significa que a aplicação de pequenas alterações em enormes tabelas não é uma boa opção de uso para o Hive.
Por outro lado, a carga incremental no GreenPlum depende pouco do volume de dados anteriormente carregados na tabela alvo e ocorre de forma bastante rápida. Isso se deve às SQL Joins e à arquitetura do GreenPlum, que permite a operação de delete.
Assim, o GreenPlum injeta o delta usando delete+insert, enquanto no Hive não há operações de delete ou update, portanto, todo o conjunto de dados teve que ser reescrito completamente durante a atualização incremental. A comparação das células em negrito é bastante indicativa, pois corresponde à opção mais comum de utilização de carregamentos intensivos em recursos. Vemos que o GreenPlum venceu o Hive neste teste por 8 vezes.
Funcionamento do Ab Initio com GreenPlum em modo Near Real Time
Neste experimento, vamos verificar a capacidade do Ab Initio de atualizar a tabela GreenPlum com porções de dados geradas aleatoriamente em um modo próximo ao tempo real. Vamos considerar a tabela GreenPlum dev42_1_db_usl.TESTING_SUBJ_org_finval, com a qual iremos trabalhar.
Vamos usar três gráficos do Ab Initio para trabalhar com ela:
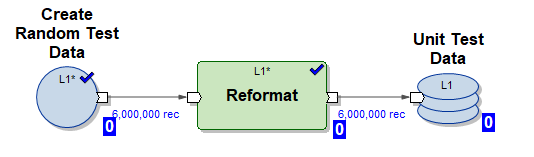
1) Gráfico Create_test_data.mp – cria arquivos de dados no HDFS com 6.000.000 linhas em 10 fluxos paralelos. Os dados são aleatórios e sua estrutura é organizada para inserção em nossa tabela.
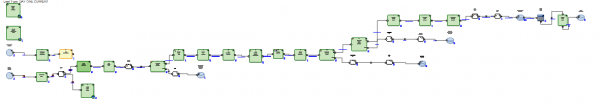
2) Gráfico mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset – gráfico MDW gerado para a inserção inicial de dados em nossa tabela em 10 fluxos paralelos (dados de teste gerados pelo gráfico (1)).
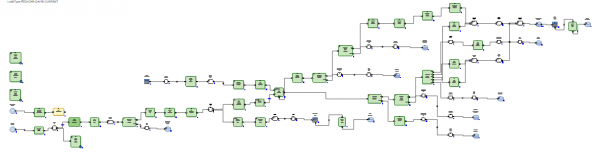
3) Gráfico mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset – gráfico MDW gerado para a atualização incremental de nossa tabela em 10 fluxos paralelos utilizando um lote de dados recém-chegados (deltas), gerados pelo gráfico (1).
Executaremos o seguinte cenário em modo NRT:
- gerar 6.000.000 linhas de teste.
- realizar a carga inicial, inserindo 6.000.000 linhas de teste em uma tabela vazia.
- repetir 5 vezes a carga incremental.
- gerar 6.000.000 linhas de teste.
- realizar a inserção incremental de 6.000.000 linhas de teste na tabela (nesse caso, os dados antigos recebem um timestamp de expiração valid_to_ts e dados mais novos são inseridos com a mesma chave primária).
Esse cenário emula o funcionamento real de um sistema de negócios – uma quantidade significativa de novos dados aparece em tempo real e é imediatamente incorporada ao GreenPlum.
Agora vamos verificar o log de execução do cenário:
Iniciar Create_test_data.input.pset em 2020-06-04 11:49:11
Finalizar Create_test_data.input.pset em 2020-06-04 11:49:37
Iniciar mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset em 2020-06-04 11:49:37
Finalizar mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset em 2020-06-04 11:50:42
Iniciar Create_test_data.input.pset em 2020-06-04 11:50:42
Finalizar Create_test_data.input.pset em 2020-06-04 11:51:06
Iniciar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset em 2020-06-04 11:51:06
Finalizar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset em 2020-06-04 11:53:41
Iniciar Create_test_data.input.pset em 2020-06-04 11:53:41
Finalizar Create_test_data.input.pset em 2020-06-04 11:54:04
Iniciar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset em 2020-06-04 11:54:04
Finalizar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset em 2020-06-04 11:56:51
Iniciar Create_test_data.input.pset em 2020-06-04 11:56:51
Finalizar Create_test_data.input.pset em 2020-06-04 11:57:14
Iniciar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset em 2020-06-04 11:57:14
Finalizar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset em 2020-06-04 11:59:55
Iniciar Create_test_data.input.pset em 2020-06-04 11:59:55
Finalizar Create_test_data.input.pset em 2020-06-04 12:00:23
Iniciar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset em 2020-06-04 12:00:23
Finalizar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset em 2020-06-04 12:03:23
Iniciar Create_test_data.input.pset em 2020-06-04 12:03:23
Finalizar Create_test_data.input.pset em 2020-06-04 12:03:49
Iniciar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset em 2020-06-04 12:03:49
Finalizar mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset em 2020-06-04 12:06:46
A imagem é a seguinte:
Gráfico
Hora de início
Hora de término
Duração
Create_test_data.input.pset
04.06.2020 11:49:11
04.06.2020 11:49:37
00:00:26
mdw_load.day_one.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:49:37
04.06.2020 11:50:42
00:01:05
Create_test_data.input.pset
04.06.2020 11:50:42
04.06.2020 11:51:06
00:00:24
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:51:06
04.06.2020 11:53:41
00:02:35
Create_test_data.input.pset
04.06.2020 11:53:41
04.06.2020 11:54:04
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:54:04
04.06.2020 11:56:51
00:02:47
Create_test_data.input.pset
04.06.2020 11:56:51
04.06.2020 11:57:14
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:57:14
04.06.2020 11:59:55
00:02:41
Create_test_data.input.pset
04.06.2020 11:59:55
04.06.2020 12:00:23
00:00:28
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:00:23
04.06.2020 12:03:23
00:03:00
Create_test_data.input.pset
04.06.2020 12:03:23
04.06.2020 12:03:49
00:00:26
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:03:49
04.06.2020 12:06:46
00:02:57
Observamos que 6.000.000 linhas de incremento são processadas em 3 minutos, o que é bastante rápido.
Os dados na tabela de destino foram distribuídos da seguinte forma:
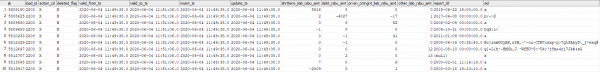
select valid_from_ts, valid_to_ts, count(1), min(sk), max(sk) from dev42_1_db_usl.TESTING_SUBJ_org_finval group by valid_from_ts, valid_to_ts order by 1,2; 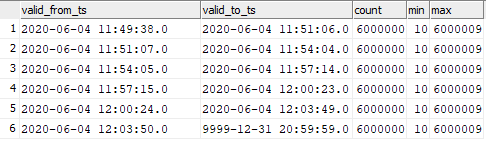
É possível ver a correspondência dos dados inseridos nos momentos de início dos gráficos.
Significa que podemos iniciar no Ab Initio a carga incremental de dados no GreenPlum com uma frequência muito alta e observar uma alta velocidade de inserção desses dados no GreenPlum. Claro, não será possível iniciar a cada segundo, pois o Ab Initio, como qualquer ferramenta ETL, requer tempo de "aquecimento" ao ser iniciado.
Conclusão
Atualmente, o Ab Initio é utilizado no Sberbank para construir uma Camada Semântica Única de Dados (ECA). Este projeto implica a construção de uma versão única do estado de várias entidades de negócios bancários. A informação vem de várias fontes, cujas réplicas são preparadas no Hadoop. De acordo com as necessidades do negócio, um modelo de dados é preparado e as transformações de dados são descritas. O Ab Initio carrega informações na ECA e os dados carregados não apenas são de interesse para o negócio em si, mas também servem de fonte para a construção de vitrines de dados. O funcionalidade do produto permite usar diferentes sistemas como receptores (Hive, Greenplum, Teradata, Oracle), o que possibilita preparar os dados para o negócio em vários formatos necessários sem grandes esforços.
As capacidades do Ab Initio são amplas; por exemplo, a estrutura MDW proporciona a possibilidade de construir a historicidade técnica e de negócios dos dados "pronta para uso". Para os desenvolvedores, o Ab Initio possibilita "não inventar a roda", mas sim utilizar uma infinidade de componentes funcionais disponíveis, que são essencialmente bibliotecas necessárias para trabalhar com dados.
Autor — especialista da comunidade profissional Sberbank SberProfi DWH/BigData. A comunidade profissional SberProfi DWH/BigData é responsável pelo desenvolvimento de competências em áreas como ecossistema Hadoop, Teradata, Oracle DB, GreenPlum, além de ferramentas BI como Qlik, SAP BO, Tableau e outras.
Fonte: habr.com
