

Esta é a aparência da redundância
Códigos de redundância* são amplamente utilizados em sistemas computacionais para aumentar a confiabilidade do armazenamento de dados. No Yandex, eles são empregados em muitos projetos. Por exemplo, o uso de códigos de redundância em vez de replicação em nosso armazenamento de objetos interno economiza milhões sem comprometer a confiabilidade. No entanto, apesar da ampla disseminação, uma descrição clara de como funcionam os códigos de redundância é rara. Aqueles que desejam entender deparam-se com algo como o seguinte (de ):
Meu nome é Vadim, e no Yandex eu trabalho no desenvolvimento do armazenamento de objetos interno MDS. Neste artigo, explicarei de forma simples os fundamentos teóricos dos códigos de redundância (códigos de Reed-Solomon e LRC). Contarei como isso funciona, sem matemática complexa ou termos raros. No final, apresentarei exemplos de uso dos códigos de redundância no Yandex.
Uma série de detalhes matemáticos não será abordada com profundidade, mas forneceré links para aqueles que desejam se aprofundar. Também observarei que algumas definições matemáticas podem não ser rigorosas, uma vez que o artigo não é destinado a matemáticos, mas a engenheiros que desejam entender a essência da questão.
* Na literatura em língua inglesa, os códigos de redundância são frequentemente chamados de erasure codes.
1. A essência dos códigos de redundância
A essência de todos os códigos de redundância é extremamente simples: armazenar (ou transmitir) dados de maneira que não se percam em caso de erros (falhas de discos, erros na transmissão de dados, etc.).
Na maioria* dos códigos de redundância, os dados são divididos em n blocos de dados, para os quais são calculados m blocos de códigos de redundância, totalizando n + m blocos. Os códigos de redundância são construídos de forma que seja possível recuperar n blocos de dados utilizando apenas uma parte dos n + m blocos. A seguir, abordaremos apenas códigos de redundância em bloco, ou seja, aqueles em que os dados são divididos em blocos.
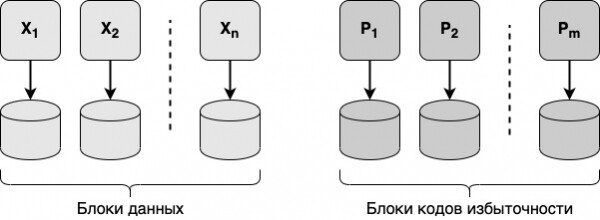
Para restaurar todos os n blocos de dados, é necessário ter pelo menos n de n + m blocos, pois não se pode obter n blocos tendo apenas n-1 bloco (neste caso, seria necessário obter 1 bloco 'do nada'). É suficiente ter n blocos arbitrários de n + m blocos para a restauração de todos os dados? Isso depende do tipo de códigos de redundância; por exemplo, os códigos de Reed-Solomon permitem restaurar todos os dados com n blocos arbitrários, enquanto os códigos de redundância LRC nem sempre o fazem.
Armazenamento de dados
Nos sistemas de armazenamento de dados, geralmente, cada um dos blocos de dados e blocos de códigos de redundância é gravado em um disco separado. Assim, ao falhar um disco qualquer, os dados originais ainda poderão ser recuperados e lidos. Os dados poderão ser recuperados mesmo em caso de falha simultânea de vários discos.
Transmissão de dados
Os códigos de redundância podem ser usados para uma transmissão confiável de dados em uma rede não confiável. Os dados transmitidos são divididos em blocos, e para eles são calculados os códigos de redundância. Tanto os blocos de dados quanto os blocos de códigos de redundância são transmitidos pela rede. Em caso de erro em blocos arbitrários (até um certo número de blocos), os dados ainda podem ser transmitidos pela rede de forma confiável. Os códigos de Reed-Solomon, por exemplo, são utilizados para a transmissão de dados por linhas ópticas de comunicação e em comunicações via satélite.
* Existem também códigos de redundância em que os dados não são divididos em blocos, como os códigos de Hamming e os códigos CRC, amplamente utilizados para transmissão de dados em redes Ethernet. Esses são códigos para codificação resistente a interferências, destinados à detecção de erros, e não à sua correção (o código de Hamming também permite corrigir erros parcialmente).
2. Códigos de Reed-Solomon
Os códigos de Reed-Solomon são um dos códigos de redundância mais amplamente utilizados, inventados na década de 1960 e que obtiveram aplicação generalizada em 1980 para a produção em série de CDs.
Duas questões chave para entender os códigos de Reed-Solomon são: 1) como criar blocos de códigos de redundância; 2) como recuperar dados usando blocos de códigos de redundância. Vamos encontrar respostas para elas.
Para simplificar, consideraremos a seguir que n=6 e m=4. Outros esquemas são considerados por analogia.
Como criar blocos de códigos de redundância
Cada bloco de códigos de redundância é considerado independentemente dos outros. Para o cálculo de cada bloco, são utilizados todos os n blocos de dados. No diagrama abaixo, X1-X6 representam os blocos de dados, enquanto P1–P4 são blocos de códigos de redundância.
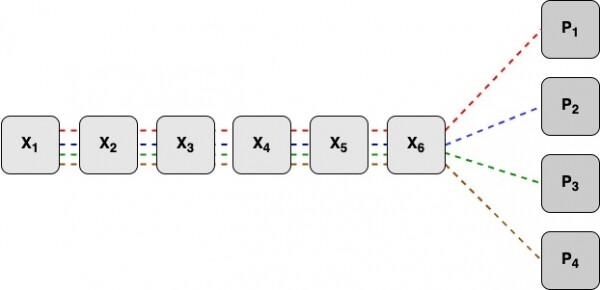
Todos os blocos de dados devem ter o mesmo tamanho; para o alinhamento, podem ser utilizados bits nulos. Os blocos de códigos de redundância resultantes terão o mesmo tamanho que os blocos de dados. Todos os blocos de dados são divididos em palavras (por exemplo, 16 bits). Suponha que dividimos os blocos de dados em k palavras. Assim, todos os blocos de códigos de redundância também serão divididos em k palavras.
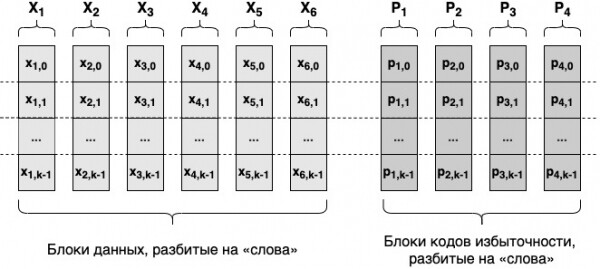
Para calcular a i-ésima palavra de cada bloco de redundância, utilizaremos as i-ésimas palavras de todos os blocos de dados. Elas serão calculadas pela seguinte fórmula:
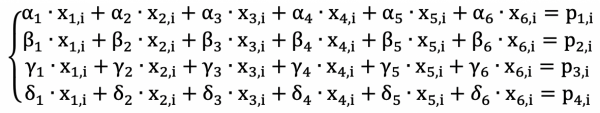
Aqui os valores x representam as palavras dos blocos de dados, p as palavras dos blocos de códigos de redundância, e todos os alfa, beta, gama e delta são números especialmente escolhidos, iguais para todos os i. É importante notar que todos esses valores não são números comuns, mas elementos de um campo de Galois; as operações +, -, *, / não são as operações habituais que conhecemos, mas operações especiais introduzidas sobre os elementos do campo de Galois.
Por que são necessários os campos de Galois
A princípio, parece simples: dividimos os dados em blocos, os blocos em palavras, e com as palavras dos blocos de dados calculamos as palavras dos blocos de códigos de redundância, obtendo assim os blocos de códigos de redundância. De forma geral, é assim que funciona, mas o diabo está nos detalhes:
- Como mencionado acima, o tamanho da palavra é fixo, em nosso exemplo 16 bits. As fórmulas acima para os códigos de Reed-Solomon são tais que, ao utilizar inteiros comuns, o resultado do cálculo de p pode não ser representável com uma palavra do tamanho permitido.
- Ao restaurar os dados, as fórmulas acima serão consideradas como um sistema de equações a ser resolvido para restaurar os dados. Durante o processo de resolução, pode haver a necessidade de dividir números inteiros entre si, resultando em um número real que não pode ser representado com precisão na memória do computador.
Esses problemas impedem o uso de números inteiros para os códigos de Reed-Solomon. A solução para o problema é original e pode ser descrita da seguinte forma: vamos criar números especiais que podem ser representados por palavras de um determinado tamanho (por exemplo, 16 bits), e o resultado de todas as operações realizadas sobre esses números (adição, subtração, multiplicação, divisão) também será representado na memória do computador usando palavras desse tamanho.
Esses números “especiais” são estudados há muito tempo pela matemática e são chamados de campos. Um campo é um conjunto de elementos com operações de adição, subtração, multiplicação e divisão definidas para eles.
Os campos de Galois* são campos para os quais existe e é único o resultado de cada operação (+, -, *, /) para quaisquer dois elementos do campo. Os campos de Galois podem ser construídos para números que são potências de 2: 2, 4, 8, 16, etc. (na verdade, potências de qualquer número primo p, mas na prática, estamos interessados apenas nas potências de 2). Por exemplo, para palavras de tamanho 16 bits, esse campo contém 65.536 elementos, para cada par dos quais é possível encontrar o resultado de qualquer operação (+, -, *, /). Os valores x, p, alfa, beta, gama, delta nas equações acima para cálculos serão considerados elementos do campo de Galois.
Assim, temos um sistema de equações que pode ser usado para construir blocos de códigos de redundância, escrevendo um programa de computador correspondente. Com esse mesmo sistema de equações, é possível realizar a recuperação de dados.
* Esta não é uma definição estrita, mas sim uma descrição.
Como recuperar dados
A recuperação é necessária quando, de n + m blocos, alguns blocos estão ausentes. Isso pode incluir tanto blocos de dados quanto blocos de códigos de redundância. A ausência de blocos de dados e/ou blocos de códigos de redundância significa que nas equações acima as variáveis correspondentes x e/ou p são desconhecidas.
As equações para os códigos de Reed-Solomon podem ser vistas como um sistema de equações em que todos os valores alfa, beta, gama, delta são constantes, todos os x e p correspondentes aos blocos disponíveis são variáveis conhecidas, e os demais x e p são desconhecidos.
Por exemplo, suponha que os blocos de dados 1, 2, 3 e o bloco de códigos de redundância 2 estejam indisponíveis, então para o i-ésimo grupo de palavras teremos o seguinte sistema de equações (as incógnitas estão marcadas em vermelho):
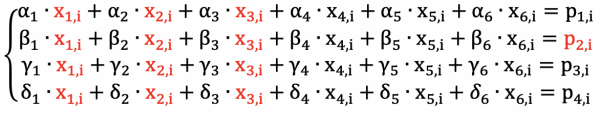
Temos um sistema de 4 equações com 4 incógnitas, portanto podemos resolvê-lo e recuperar os dados!
Dessa sistema de equações decorrem várias conclusões sobre a recuperação de dados para códigos de Reed-Solomon (n blocos de dados, m blocos de código de redundância):
- Os dados podem ser recuperados com a perda de até m blocos ou menos. Com a perda de m+1 ou mais blocos, os dados não podem ser recuperados: não é possível resolver um sistema de m equações com m + 1 incógnitas.
- Para recuperar até mesmo um bloco de dados, é necessário usar quaisquer n dos blocos restantes, podendo utilizar qualquer um dos códigos de redundância.
O que mais você precisa saber
Na descrição acima, deixo de lado uma série de questões importantes, cuja consideração requer um mergulho mais profundo na matemática. Em particular, não menciono o seguinte:
- O sistema de equações para os códigos de Reed-Solomon deve ter uma (única) solução para quaisquer combinações de incógnitas (não mais que m incógnitas). Com base nesse requisito, são selecionados os valores de alfa, beta, gama e delta.
- O sistema de equações precisa ser capaz de se construir automaticamente (dependendo de quais blocos estão indisponíveis) e ser resolvido.
- É preciso construir um campo de Galois: para um dado tamanho de palavra, ser capaz de encontrar o resultado de qualquer operação (+, -, *, /) para quaisquer dois elementos.
No final do artigo, há referências à literatura sobre essas questões importantes.
Escolha de n e m
Como escolher n e m na prática? Na prática, nos sistemas de armazenamento de dados, os códigos de redundância são usados para economizar espaço, portanto m é sempre escolhido menor que n. Seus valores específicos dependem de uma série de fatores, incluindo:
- Confiabilidade do armazenamento de dados. Quanto maior m, maior a quantidade de falhas de disco que pode ser suportada, ou seja, maior a confiabilidade.
- Redundância do armazenamento. Quanto maior a proporção m/n, maior será a redundância do armazenamento, e mais cara será a sistema.
- Tempo de processamento de consultas. Quanto maior a soma n + m, mais longo será o tempo de resposta às consultas. Como para ler os dados (durante a recuperação) é necessário ler n blocos armazenados em n discos diferentes, o tempo de leitura será determinado pelo disco mais lento.
Além disso, o armazenamento de dados em vários centros de dados impõe restrições adicionais à escolha de n e m: ao desligar 1 centro de dados, os dados ainda devem estar acessíveis para leitura. Por exemplo, ao armazenar dados em 3 centros de dados, deve-se cumprir a condição: m >= n/2, caso contrário, pode ocorrer uma situação em que os dados não estão disponíveis para leitura ao desligar 1 centro de dados.
3. LRC — Códigos de Reconstrução Local
Para restaurar dados usando os códigos de Reed-Solomon, é necessário usar n blocos de dados arbitrários. Este é um grande inconveniente para sistemas de armazenamento de dados distribuídos, pois para recuperar dados de um disco quebrado, é preciso ler dados da maioria dos outros, criando uma carga adicional significativa nos discos e na rede.
Os erros mais comuns são a falta de um bloco de dados devido à falha ou sobrecarga de um disco. É possível reduzir a carga excessiva para a recuperação de dados em tal (o mais comum) caso? Aparentemente, sim: para isso existem códigos de redundância LRC.
LRC (Códigos de Reconstrução Local) são códigos de redundância criados pela Microsoft para uso no Windows Azure Storage. A ideia do LRC é bastante simples: dividir todos os blocos de dados em dois (ou mais) grupos e calcular parte dos blocos de códigos de redundância para cada grupo separadamente. Assim, parte dos blocos de códigos de redundância será calculada usando todos os blocos de dados (no LRC eles são chamados de códigos globais de redundância), enquanto parte será calculada com um dos dois grupos de blocos de dados (esses são chamados de códigos locais de redundância).
O LRC é representado por três números: n-r-l, onde n é o número de blocos de dados, r é o número de blocos globais de códigos de redundância, l é o número de blocos locais de códigos de redundância. Para ler dados quando um bloco de dados não está disponível, é necessário ler apenas n/l blocos - isso é l vezes menos do que nos códigos de Reed-Solomon.
Como exemplo, consideremos o esquema LRC 6-2-2. X1–X6 — 6 blocos de dados, P1, P2 — 2 blocos globais de redundância, P3, P4 — 2 blocos locais de redundância.
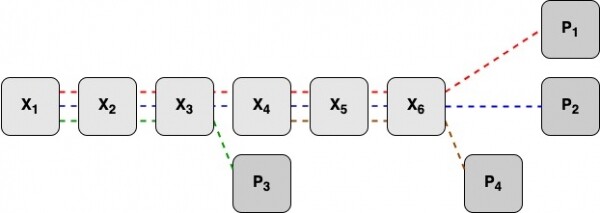
Os blocos de código de redundância P1, P2 são calculados usando todos os blocos de dados. O bloco de código de redundância P3 é calculado usando os blocos de dados X1–X3, e o bloco de código de redundância P4 é calculado usando os blocos de dados X4–X6.
O restante é feito no LRC de forma semelhante aos códigos de Reed-Solomon. As equações para calcular as palavras dos blocos de códigos de redundância serão as seguintes:
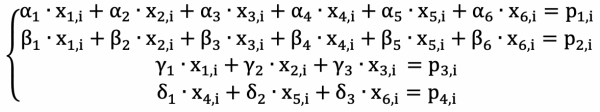
Para gerar os números alfa, beta, gama e delta, é necessário atender a uma série de condições que garantem a possibilidade de recuperação dos dados (ou seja, a solução do sistema de equações). Mais detalhes podem ser encontrados em .
Além disso, na prática, para calcular os códigos locais de redundância P3 e P4, usa-se a operação XOR.
Do sistema de equações para o LRC, várias conclusões podem ser tiradas:
- Para recuperar qualquer 1 bloco de dados, basta ler n/l blocos (n/2 no nosso exemplo).
- Se r + l blocos não estiverem disponíveis e todos os blocos pertencem ao mesmo grupo, os dados não podem ser recuperados. Isso pode ser explicado facilmente com um exemplo. Suponha que os blocos X1–X3 e P3 não estejam disponíveis: isso corresponde a r + l blocos de um único grupo, que são 4 no nosso caso. Portanto, temos um sistema de 3 equações com 4 incógnitas, que não pode ser resolvido.
- Em todos os outros casos de indisponibilidade de r + l blocos (quando pelo menos um bloco de cada grupo está disponível), os dados no LRC podem ser recuperados.
Assim, o LRC supera os códigos de Reed-Solomon na recuperação de dados após erros únicos. Nos códigos de Reed-Solomon, para recuperar até mesmo um bloco de dados, são necessários n blocos, enquanto no LRC é suficiente utilizar n/l blocos (n/2 no nosso exemplo) para recuperar um bloco de dados. Por outro lado, o LRC perde para os códigos de Reed-Solomon em relação ao número máximo de erros permitidos. Nos exemplos acima, os códigos de Reed-Solomon conseguem recuperar os dados com até 4 erros, enquanto no LRC existem 2 combinações de 4 erros em que os dados não podem ser recuperados.
O que é mais importante depende da situação específica, mas frequentemente a economia de carga redundante proporcionada pelo LRC supera a ligeiramente menor confiabilidade de armazenamento.
4. Outros códigos de redundância
Além dos códigos de Reed-Solomon e LRC, existem muitos outros códigos de redundância. Diferentes códigos de redundância utilizam matemáticas diferentes. Aqui estão alguns outros códigos de redundância:
- Código de redundância utilizando o operador XOR. A operação XOR é realizada sobre n blocos de dados, resultando em 1 bloco de códigos de redundância, ou seja, um esquema n+1 (n blocos de dados, 1 código de redundância). Utilizado em , onde os blocos de dados e os códigos de redundância são gravados ciclicamente em todos os discos do array.
- O algoritmo even-odd, baseado na operação XOR. Permite construir 2 blocos de códigos de redundância, ou seja, esquema n+2.
- O algoritmo STAR, baseado na operação XOR. Permite construir 3 blocos de códigos de redundância, ou seja, esquema n+3.
- Os códigos Pyramide — mais códigos de redundância da Microsoft.
5. Uso no Yandex
Vários projetos de infraestrutura do Yandex aplicam códigos de redundância para armazenamento confiável de dados. Aqui estão alguns exemplos:
- O armazenamento de objetos interno MDS, sobre o qual escrevi no início do artigo.
- — Sistema MapReduce do Yandex.
- (Yandex DataBase) — banco de dados distribuído newSQL.
No MDS, são utilizados códigos de redundância LRC, esquema 8-2-2. Os dados com códigos de redundância são gravados em 12 discos diferentes em diferentes servidores em 3 DCS: 4 servidores em cada DC. Para mais detalhes, leia em .
No YT, são usados tanto códigos de Reed-Solomon (esquema 6-3), que foram implementados primeiro, quanto códigos de redundância LRC (esquema 12-2-2), sendo que LRC é o método preferido de armazenamento.
No YDB, são utilizados códigos de redundância baseados em even-odd (esquema 4-2). Já se falou sobre códigos de redundância no YDB .
A aplicação de diferentes esquemas de códigos de redundância é determinada pelos diferentes requisitos impostos aos sistemas. Por exemplo, no MDS, os dados armazenados com LRC são distribuídos em 3 DCS. É importante que os dados permaneçam acessíveis para leitura em caso de falha em qualquer DC, portanto, os blocos devem ser distribuídos entre os DCS de modo que, ao ficar indisponível qualquer DC, a quantidade de blocos inacesíveis não ultrapasse o aceitável. No esquema 8-2-2, podem ser colocados 4 blocos em cada DC, então, ao desligar qualquer DC, 4 blocos ficarão indisponíveis e os dados poderão ser lidos. Qualquer que seja o esquema escolhido para alocação nos 3 DCS, em qualquer caso, deve ser (r + l) / n >= 0,5, ou seja, a redundância de armazenamento será de pelo menos 50%.
No YT, a situação é diferente: cada cluster YT está totalmente localizado em 1 DC (clusters diferentes em diferentes DCs), portanto não há essa limitação. O esquema 12-2-2 oferece uma redundância de 33%, ou seja, armazenar dados se torna mais barato, embora eles possam suportar até 4 falhas simultâneas de discos, assim como no esquema do MDS.
Ainda há muitas particularidades na aplicação de códigos de redundância em sistemas de armazenamento e processamento de dados: nuances na recuperação de dados, impacto da recuperação sobre o tempo de execução das solicitações, características da gravação de dados, entre outros. Vou me aprofundar separadamente nessas e outras características da aplicação de códigos de redundância na prática, se o tema for de interesse.
6. Links
- Série de artigos sobre os códigos de Reed-Solomon e campos de Galois:
Neles, é apresentada a matemática de forma acessível. - Artigo da Microsoft sobre LRC:
Na seção 2, a teoria é explicada brevemente, seguida da análise da experiência na aplicação do LRC na prática. - Esquema even-odd:
- Esquema STAR:
- Códigos de pirâmide:
- Códigos de redundância em MDS:
- Códigos de redundância em YT:
- Códigos de redundância em YDB:
Fonte: habr.com
