

Antecedentes
Como amante de hardware retrô, comprei certa vez um ZX Spectrum+ de um vendedor do Reino Unido. Veio com o próprio computador, algumas fitas cassete com jogos (na embalagem original com instruções), além de programas gravados em fitas sem identificação. Para minha surpresa, os dados das fitas de 40 anos atrás eram muito legíveis e consegui carregar quase todos os jogos e programas a partir delas.
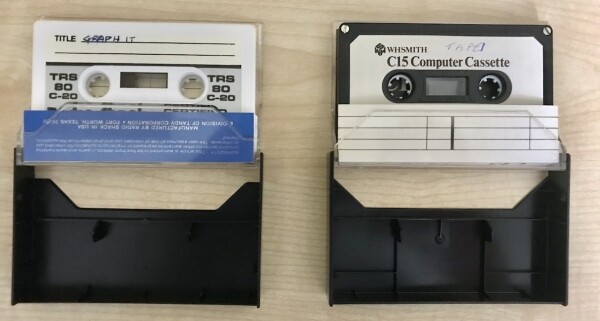
No entanto, em algumas fitas, descobri gravações que claramente não foram feitas em um computador ZX Spectrum. Elas soavam completamente diferentes e, ao contrário das gravações do computador mencionado, não começavam com um carregador BASIC curto, que geralmente está presente em todas as gravações de programas e jogos.
Isso me inquietou por um tempo — realmente queria saber o que estava oculto nelas. Se eu conseguisse ler o sinal de áudio como uma sequência de bytes, poderia procurar por caracteres ou algo que indicasse a origem do sinal. Uma espécie de arqueologia retrô.
Agora, quando olho todo o caminho que percorri e vejo os rótulos das próprias fitas, sorrio, porque
a resposta esteve bem diante dos meus olhos o tempo todo
No rótulo da fita da esquerda está o nome do computador TRS-80, e logo abaixo o nome do fabricante: "Manufactured by Radio Shack in USA"
(Se quiser manter a intriga até o fim, não acesse o spoiler)
Comparação de sinais de áudio
Primeiro vamos digitalizar as gravações de áudio. Podemos ouvir como isso soa:
E como geralmente soa uma gravação do computador ZX Spectrum:
Em ambos os casos, no início da gravação está presente o chamado tom piloto — som de uma única frequência (na primeira gravação é muito curto <1 seg, porém discernível). O tom piloto serve como um sinal para o computador de que ele deve se preparar para receber dados. Normalmente, cada computador reconhece apenas seu próprio tom piloto pela forma do sinal e sua frequência.
É importante notar a própria forma do sinal. Por exemplo, no ZX Spectrum, sua forma é retangular:
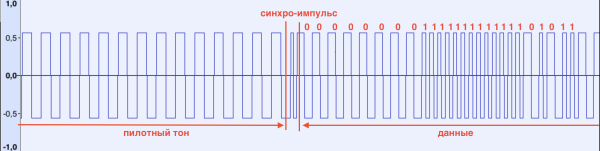
Ao detectar o tom piloto, o ZX Spectrum exibe listras alternadas em vermelho e azul na borda da tela, indicando que o sinal foi reconhecido. O tom piloto termina com um pulso de sincronização, que sinaliza ao computador que deve começar a receber dados. Ele é caracterizado por uma duração menor (em comparação com o tom piloto e os dados subsequentes) (veja a ilustração)
Após receber o pulso de sincronização, o computador registra cada subida/equipamento do sinal, medindo sua duração. Se a duração for menor que um limite definido, um bit 1 é armazenado na memória, caso contrário, 0. Os bits são agrupados em bytes e o processo se repete até que N bytes sejam recebidos. O número N é geralmente retirado do cabeçalho do arquivo que está sendo carregado. A sequência de carregamento é a seguinte:
- tom piloto
- cabeçalho (de comprimento fixo), contém o tamanho dos dados carregados (N), o nome e o tipo do arquivo
- tom piloto
- os próprios dados
Para garantir que os dados estão carregados corretamente, o ZX Spectrum lê o último byte chamado byte de paridade (parity byte), que é calculado ao salvar o arquivo usando a operação XOR em todos os bytes dos dados gravados. Ao ler o arquivo, o computador calcula o byte de paridade a partir dos dados recebidos e, se o resultado diferir do armazenado, exibe uma mensagem de erro 'Erro de carregamento R Tape'. Estritamente falando, o computador pode exibir essa mensagem antes, se ao ler não conseguir reconhecer o pulso (perdido ou sua duração não corresponder a certos limites)
Então, vamos ver agora como é o sinal desconhecido:
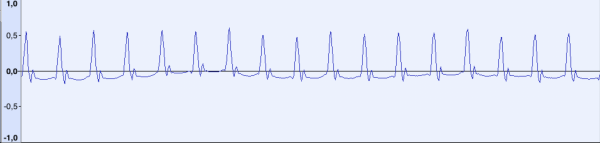
Este é o tom piloto. A forma do sinal difere significativamente, mas é visível que o sinal é composto por pulsos curtos repetidos de uma determinada frequência. Com uma frequência de amostragem de 44100 Hz, a distância entre os 'picos' é de aproximadamente 48 amostras (o que corresponde a uma frequência de ~918 Hz). Vamos lembrar esse número.
Agora vamos olhar para um fragmento com os dados:
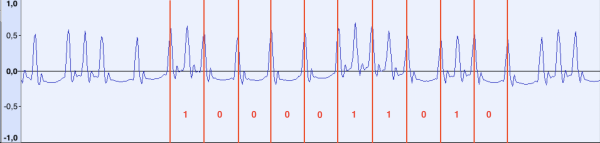
Se medirmos a distância entre os pulsos individuais, descobrirá que entre os 'pulsos longos', a distância permanece em ~48 amostras, enquanto entre os curtos — ~24. Antecipando um pouco, direi que, no final, verificou-se que os 'pulsos de referência' com frequência de 918 Hz seguem continuamente, do início ao fim do arquivo. Pode-se supor que na transmissão de dados, se entre os pulsos de referência ocorrer um pulso adicional, consideramos isso como bit 1, caso contrário, 0.
E quanto ao pulso de sincronização? Vamos olhar para o início dos dados:
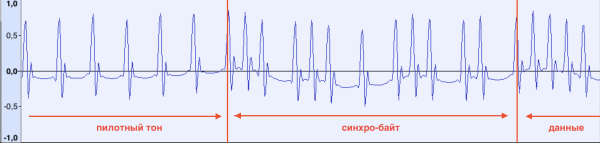
O tom piloto termina e os dados começam imediatamente. Um pouco mais tarde, ao analisar várias gravações de áudio diferentes, consegui descobrir que o primeiro byte de dados é sempre o mesmo (10100101b, A5h). É possível que o computador comece a ler os dados assim que os recebe.
Também podemos prestar atenção no deslocamento do primeiro impulso de referência logo após o último 1 no sincronismo de byte. Ele foi detectado bastante depois no processo de desenvolvimento do programa de reconhecimento de dados, quando os dados no início do arquivo não puderam ser lidos de forma estável.
Agora vamos tentar descrever o algoritmo que processará o arquivo de áudio e carregará os dados.
Carregamento de dados
Primeiro, vamos considerar algumas suposições para não complicar o algoritmo:
- Consideraremos arquivos apenas no formato WAV;
- O arquivo de áudio deve começar com o tom piloto e não deve conter silêncio no início;
- O arquivo de origem deve ter uma taxa de amostragem de 44100 Hz. Dessa forma, a distância entre os impulsos de referência em 48 amostras já está definida e não precisamos calculá-la programaticamente;
- O formato das amostras pode ser qualquer um (8/16 bits/ponto flutuante) — pois ao ler, podemos convertê-lo para o necessário;
- Assumimos que o arquivo de origem está normalizado em amplitude, o que deve estabilizar o resultado;
O algoritmo de leitura será o seguinte:
- Lemos o arquivo na memória, convertendo simultaneamente o formato das amostras para 8 bits;
- Determinamos a posição do primeiro impulso nos dados de áudio. Para isso, é necessário calcular o número da amostra com a amplitude máxima. Para simplificar, vamos contar uma vez manualmente. Armazenaremos na variável prev_pos;
- Adicionamos à posição do último impulso 48 (pos := prev_pos + 48)
- Como o aumento da posição em 48 não garante que atingiremos a posição do próximo impulso de referência (defeitos na fita, funcionamento instável do mecanismo de transporte de fita, etc.), é necessário corrigir a posição do impulso pos. Para isso, pegaremos um pequeno segmento de dados (pos-8;pos+8) e encontraremos o máximo do valor da amplitude. A posição correspondente ao máximo será armazenada em pos. Aqui, 8 = 48/6 — uma constante obtida experimentalmente, que garante que determinaremos o verdadeiro máximo e não interferiremos em outros impulsos que possam estar próximos. Em casos muito ruins, quando a distância entre os impulsos é muito menor ou maior que 48, pode-se implementar uma busca forçada pelo impulso, mas dentro deste artigo não descreverei isso no algoritmo;
- Na etapa anterior, também é necessário verificar se o impulso de referência foi realmente encontrado. Ou seja, se simplesmente procurar o máximo não garante que o impulso esteja presente nesse segmento. Em minha última implementação do programa de leitura, verifico a diferença entre o valor máximo e o mínimo da amplitude no segmento, e se ela ultrapassar um limite determinado, contabilizo a presença do impulso. A questão também é o que fazer se o impulso de referência não for encontrado. Existem 2 opções: ou os dados acabaram e a seguir há silêncio, ou isso deve ser considerado um erro de leitura. No entanto, vamos ignorar isso para simplificar o algoritmo;
- Na próxima etapa, precisamos determinar a presença de um impulso de dados (bit 0 ou 1), para isso pegamos o meio do segmento (prev_pos;pos) middle_pos igual a middle_pos := (prev_pos+pos)/2 e, em uma certa vizinhança de middle_pos no segmento (middle_pos-8;middle_pos+8), calculamos o máximo e o mínimo da amplitude. Se a diferença entre eles for maior que 10, gravamos o bit 1 no resultado, caso contrário, 0. 10 é uma constante obtida empiricamente;
- Salvamos a posição atual em prev_pos (prev_pos := pos)
- Repetimos a partir do passo 3, até que todo o arquivo seja lido;
- O array de bits obtido deve ser salvo como um conjunto de bytes. Como não consideramos o byte de sincronização durante a leitura, o número de bits pode não ser um múltiplo de 8, e também não sabemos o deslocamento necessário em bits. Na primeira implementação do algoritmo, eu não sabia da existência do byte de sincronização e, portanto, simplesmente salvava 8 arquivos com diferentes quantidades de deslocamento de bits. Um deles continha dados corretos. No algoritmo final, eu apenas removo todos os bits até A5h, o que permite obter imediatamente um arquivo correto na saída.
Algoritmo em Ruby, para quem se interessar.
Escolhi Ruby como a linguagem para escrever o programa, pois passo a maior parte do tempo programando nela. A versão não é de alto desempenho, mas o objetivo de tornar a velocidade de leitura o mais rápida possível não é uma prioridade.
# Используем gem 'wavefile'
require 'wavefile'

reader = WaveFile::Reader.new('input.wav')
samples = []
format = WaveFile::Format.new(:mono, :pcm_8, 44100)

# Читаем WAV файл, конвертируем в формат Mono, 8 bit
# Массив samples будет состоять из байт со значениями 0-255
reader.each_buffer(10000) do |buffer|
  samples += buffer.convert(format).samples
end

# Позиция первого импульса (вместо 0)
prev_pos = 0
# Расстояние между импульсами
distance = 48
# Значение расстояния для окрестности поиска локального максимума
delta = (distance / 6).floor
# Биты будем сохранять в виде строки из "0" и "1"
bits = ""

loop do
  # Рассчитываем позицию следующего импульса
  pos = prev_pos + distance

  # Выходим из цикла если данные закончились
  break if pos + delta >= samples.size

  # Корректируем позицию pos обнаружением максимума на отрезке [pos - delta;pos + delta]
  (pos - delta..pos + delta).each { |p| pos = p if samples[p] > samples[pos] }

  # Находим середину отрезка [prev_pos;pos]
  middle_pos = ((prev_pos + pos) / 2).floor

  # Берем окрестность в середине
  sample = samples[middle_pos - delta..middle_pos + delta]

  # Определяем бит как "1" если разница между максимальным и минимальным значением на отрезке превышает 10
  bit = sample.max - sample.min > 10
  bits += bit ? "1" : "0"
end

# Определяем синхро-байт и заменяем все предшествующие биты на 256 бит нулей (согласно спецификации формата)
bits.gsub! /^[01]*?10100101/, ("0" * 256) + "10100101"

# Сохраняем выходной файл, упаковывая биты в байты
File.write "output.cas", [bits].pack("B*")
Resultado
Depois de experimentar várias versões do algoritmo e constantes, tive a sorte de obter algo extremamente interessante:
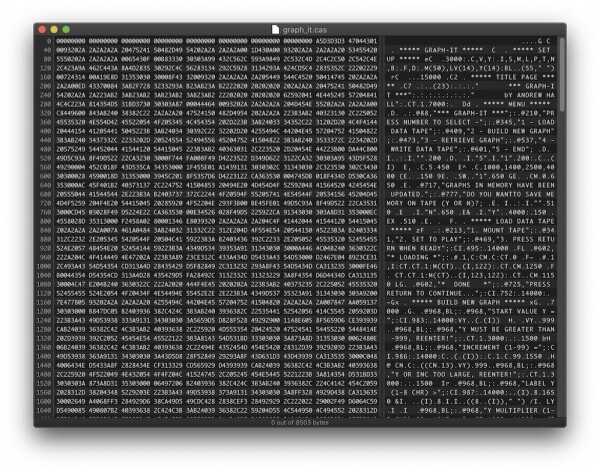
Assim, de acordo com as sequências de caracteres, temos um programa para construção de gráficos. No entanto, o texto do programa está faltando palavras-chave. Todas as palavras-chave estão codificadas como bytes (valores superiores a 80h). Agora é necessário descobrir qual computador dos anos 80 poderia salvar programas nesse formato.
Na verdade, isso se assemelha muito a um programa em linguagem BASIC. De forma semelhante, o computador ZX Spectrum armazena em memória e salva programas em fita nesse formato. Por via das dúvidas, verifiquei as palavras-chave em relação a . No entanto, o resultado foi, evidentemente, negativo.
Também verifiquei as palavras-chave BASIC dos computadores populares da época, como Atari, Commodore 64 e alguns outros, para os quais consegui encontrar documentação, mas sem sucesso — meus conhecimentos sobre as variedades de computadores retro não eram tão amplos.
Então, decidi seguir a , e aqui meu olhar recaiu sobre o nome do fabricante Radio Shack e do computador TRS-80. Esses nomes estavam exatamente nas etiquetas das fitas que estavam em minha mesa! Eu não conhecia esses nomes e não estava familiarizado com o computador TRS-80, portanto, parecia-me que a Radio Shack era um fabricante de fitas de áudio, como a BASF, Sony ou TDK, e o TRS-80 — a duração da reprodução. Por que não?
Computador Tandy/Radio Shack TRS-80
É muito provável que a gravação de áudio em questão, que usei como exemplo no início do artigo, tenha sido feita em um computador desse tipo:
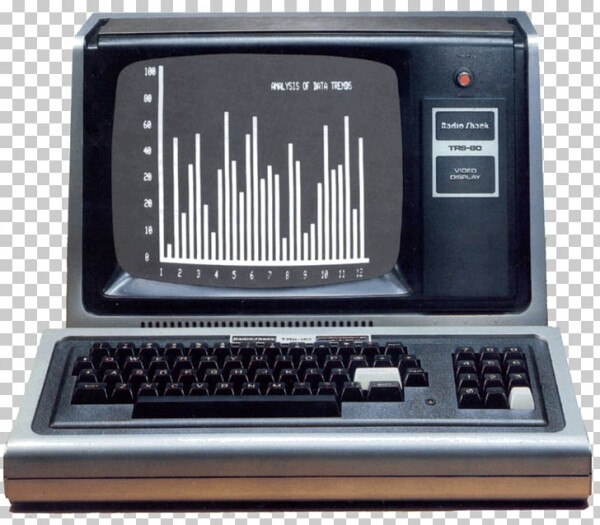
Descobriu-se que este computador e suas variantes (Model I/Model III/Model IV, etc.) eram muito populares na época (claro, não na Rússia). É notável que o processador usado neles também era o Z80. Sobre este computador, é possível encontrar . Nos anos 80, informações sobre computadores eram divulgadas em . Atualmente, existem vários do computador para diferentes plataformas.
Baixei o emulador e consegui ver pela primeira vez como esse computador funcionava. Claro, o computador não suportava saída colorida, a resolução da tela era apenas 128x48 pontos, mas havia muitas extensões e modificações que podiam aumentar a resolução da tela. Também havia diversas opções de sistemas operacionais para este computador e várias implementações da linguagem BASIC (que, ao contrário do ZX Spectrum, em alguns modelos nem estava "embarcada" na ROM e qualquer versão podia ser carregada a partir de disquetes, assim como o próprio sistema operacional)
Eu também encontrei para converter gravações de áudio no formato CAS, que é suportado pelos emuladores, mas, por algum motivo, não consegui ler as gravações das minhas fitas com ela.
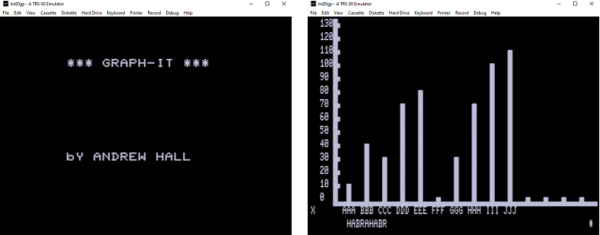
Após entender o formato do arquivo CAS (que se revelou ser apenas uma cópia bit a bit dos dados da fita que eu já tinha em mãos, exceto pelo cabeçalho contendo o byte de sincronização), fiz algumas modificações no meu programa e consegui gerar um arquivo CAS funcional que funcionou no emulador (TRS-80 Model III):
A última versão da ferramenta de conversão com detecção automática do primeiro pulso e a distância entre pulsos de referência eu compilei em um pacote GEM, o código-fonte está disponível no .
Conclusão
O caminho percorrido foi uma viagem fascinante ao passado, e estou feliz por ter encontrado a resposta no final. Além disso, eu:
- Entendi o formato de salvamento de dados no ZX Spectrum e estudei as sub-rotinas embutidas na ROM para salvar/ler dados de fitas cassete.
- Conheci o computador TRS-80 e suas variações, estudei o sistema operacional, examinei exemplos de programas e até tive a oportunidade de realizar depuração em códigos de máquina (afinal, todas as mnemônicas Z80 são bem familiares para mim)
- Escrevi um utilitário completo para converter gravações de áudio para o formato CAS, que pode ler dados que não são reconhecidos pelo utilitário 'oficial'
Fonte: habr.com
