

A tradução do artigo foi preparada em antecipação ao início do curso
O aprendizado distribuído em várias instâncias computacionais de alto desempenho pode reduzir o tempo de treinamento de redes neurais profundas em grandes volumes de dados de várias semanas para horas ou até minutos, tornando essa técnica de aprendizado predominante nas aplicações práticas de aprendizado profundo. Os usuários devem compreender como compartilhar e sincronizar dados em várias instâncias, o que, por sua vez, tem um grande impacto na eficiência de escalabilidade. Além disso, os usuários também precisam saber como implementar um script de treinamento que funcione em uma única instância em várias instâncias.
Neste artigo, falaremos sobre uma maneira rápida e simples de aprendizado distribuído usando a biblioteca de código aberto para aprendizado profundo Apache MXNet e o framework de aprendizado distribuído Horovod. Mostraremos claramente as vantagens do framework Horovod em termos de desempenho e demonstraremos como escrever um script de treinamento MXNet para que ele funcione de forma distribuída com Horovod.
O que é Apache MXNet
é um framework aberto para aprendizado profundo, usado para construir, treinar e implantar redes neurais profundas. O MXNet abstrai as complexidades associadas à implementação de redes neurais, possui alto desempenho e escalabilidade, e também oferece APIs para linguagens de programação populares, como , , , , , , e outros.
Aprendizado distribuído no MXNet com servidor de parâmetros
usa a abordagem de servidor de parâmetros (parameter server). Ele utiliza um conjunto de servidores de parâmetros para coletar gradientes de cada trabalhador, executar agregação e enviar os gradientes atualizados de volta aos trabalhadores para a próxima iteração de otimização. Definir a relação correta de servidores para trabalhadores é a chave para uma escalabilidade eficaz. Se houver apenas um servidor de parâmetros, ele pode se tornar um gargalo nas computações. Por outro lado, se forem usados muitos servidores, a conexão "muitos-para-muitos" pode congestioná-los.
O que é Horovod
– um framework aberto de aprendizado profundo distribuído, desenvolvido na Uber. Ele utiliza tecnologias eficientes de interação entre múltiplas GPUs e nós, como a NVIDIA Collective Communications Library (NCCL) e a Message Passing Interface (MPI) para a distribuição e agregação de parâmetros do modelo entre workers. Ele otimiza o uso da largura de banda da rede e se escala bem ao trabalhar com modelos de redes neurais profundas. Atualmente, suporta vários frameworks populares de aprendizado de máquina, nomeadamente , Tensorflow, Keras e PyTorch.
Integração do MXNet e do Horovod
O MXNet integra-se ao Horovod através da API de aprendizado distribuído definida no Horovod. Na API de comunicação do Horovod, horovod.broadcast(), horovod.allgather() e horovod.allreduce() são implementados com callbacks assíncronos do motor MXNet, como parte do seu grafo de tarefas. Assim, as dependências de dados entre comunicação e cálculos são facilmente geridas pelo motor MXNet, evitando perdas de desempenho devido à sincronização. O objeto distributed optimizer, definido no Horovod, horovod.DistributedOptimizer expande Optimizer no MXNet de forma que ele invoque as respectivas APIs do Horovod para a atualização distribuída dos parâmetros. Todos esses detalhes de implementação são transparentes para os usuários finais.
Início Rápido
Você pode rapidamente começar a treinar uma pequena rede neural convolucional no conjunto de dados MNIST usando MXNet e Horovod no seu MacBook.
Para começar, instale o mxnet e horovod do PyPI:
pip install mxnet
pip install horovod
Nota: Se você encontrar um erro ao executar pip install horovod, talvez você precise adicionar a variável MACOSX_DEPLOYMENT_TARGET=10.vv, onde vv – é a versão da sua versão do MacOS, por exemplo, para MacOSX Sierra, você precisará escrever MACOSX_DEPLOYMENT_TARGET=10.12 pip install horovod
Em seguida, instale o OpenMPI. .
Por fim, baixe o script de teste mxnet_mnist.py e execute os seguintes comandos no terminal do MacBook no diretório de trabalho:
mpirun -np 2 -H localhost:2 -bind-to none -map-by slot python mxnet_mnist.pyAssim, você iniciará o treinamento em dois núcleos do seu processador. A saída será a seguinte:
INFO:root:Epoch[0] Batch [0-50] Speed: 2248.71 samples/sec      accuracy=0.583640
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.89 samples/sec      accuracy=0.882812
INFO:root:Epoch[0] Batch [50-100] Speed: 2273.39 samples/sec      accuracy=0.870000
Demonstração de desempenho
Ao treinar o modelo ResNet50-v1 no conjunto de dados ImageNet com 64 GPUs em oito instâncias p3.16xlarge EC2, cada um contendo 8 GPUs NVIDIA Tesla V100 na nuvem AWS, alcançamos uma taxa de aprendizado de 45000 imagens/seg (ou seja, o número de amostras treinadas por segundo). O treinamento foi concluído em 44 minutos após 90 épocas, com a melhor precisão de 75,7%.
Comparamos isso com o treinamento distribuído MXNet usando a abordagem de servidores de parâmetros em 8, 16, 32 e 64 GPUs, com um servidor de parâmetro e uma relação servidores-trabalhadores de 1 para 1 e 2 para 1, respectivamente. O resultado pode ser visto na Figura 1 abaixo. No eixo y à esquerda, as barras refletem o número de imagens para treinamento por segundo, enquanto as linhas refletem a eficiência de escalamento (ou seja, a relação entre a largura de banda real e a ideal) no eixo y à direita. Como pode ver, a escolha do número de servidores impacta a eficiência de escalamento. Se houver apenas um servidor de parâmetros, a eficiência de escalamento cai para 38% em 64 GPUs. Para alcançar a mesma eficiência de escalamento que com o Horovod, é necessário dobrar o número de servidores em relação ao número de trabalhadores.
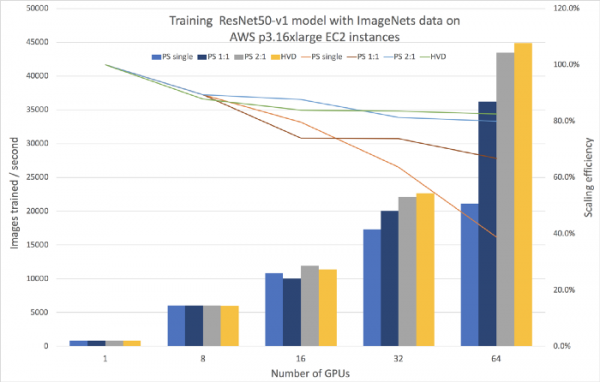
Figura 1. Comparação do treinamento distribuído usando MXNet com Horovod e com servidor de parâmetros.
Na Tabela 1 abaixo, comparamos o custo final do exemplo ao executar experimentos em 64 GPUs. O uso do MXNet junto com o Horovod proporciona a melhor largura de banda a um custo menor.
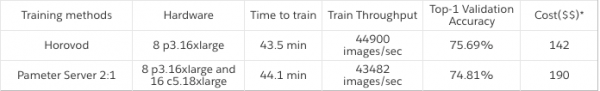
Tabela 1. Comparação de custos entre Horovod e servidor de parâmetros com uma relação servidores-trabalhadores de 2 para 1.
Passos para reprodução
Nos passos a seguir, explicaremos como reproduzir o resultado do treinamento distribuído usando MXNet e Horovod. Para saber mais sobre treinamento distribuído com MXNet, leia .
Passo 1
Crie um cluster de instâncias homogêneas com MXNet versão 1.4.0 ou superior e Horovod versão 0.16.0 ou superior para utilizar o treinamento distribuído. Você também precisará instalar bibliotecas para treinamento em GPU. Para nossas instâncias, escolhemos o Ubuntu 16.04 Linux, com Driver de GPU 396.44, CUDA 9.2, biblioteca cuDNN 7.2.1, comunicador NCCL 2.2.13 e OpenMPI 3.1.1. Você também pode usar , onde essas bibliotecas já estão pré-instaladas.
Passo 2
Adicione ao seu script de treinamento MXNet a capacidade de trabalhar com a API Horovod. O script abaixo, baseado na API MXNet Gluon, pode ser utilizado como um modelo simples. As linhas em negrito são necessárias caso você já tenha um script de treinamento correspondente. Aqui estão algumas alterações críticas que precisam ser feitas para o treinamento com Horovod:
- Defina o contexto de acordo com a classificação local do Horovod (linha 8), para garantir que o treinamento seja executado no núcleo gráfico correto.
- Transmita os parâmetros iniciais de um trabalhador para todos (linha 18), para garantir que todos os trabalhadores comecem o trabalho com os mesmos parâmetros iniciais.
- Crie o Horovod DistributedOptimizer (linha 25), para atualizar os parâmetros de forma distribuída.
Para obter o script completo, consulte os exemplos Horovod-MXNet e .
1  import mxnet as mx
2  import horovod.mxnet as hvd
3
4  # Horovod: inicializar Horovod
5  hvd.init()
6
7  # Horovod: vincular uma GPU a ser usada à classificação local
8  contexto = mx.gpu(hvd.local_rank())
9
10 # Construir modelo
11 modelo = ...
12
13 # Inicializar parâmetros
14 modelo.initialize(initializer, ctx=context)
15 params = modelo.collect_params()
16
17 # Horovod: transmitir parâmetros
18 hvd.broadcast_parameters(params, root_rank=0)
19
20 # Criar otimizador
21 optimizer_params = ...
22 opt = mx.optimizer.create('sgd', **optimizer_params)
23
24 # Horovod: envolver otimizador com DistributedOptimizer
25 opt = hvd.DistributedOptimizer(opt)
26
27 # Criar treinador e função de perda
28 trainer = mx.gluon.Trainer(params, opt, kvstore=None)
29 loss_fn = ...
30
31 # Treinar modelo
32 for epoch in range(num_epoch):
33    ...
Passo 3
Entre em um dos trabalhadores para iniciar o treinamento distribuído com a diretiva MPI. Neste exemplo, o treinamento distribuído é acionado em quatro instâncias com 4 GPUs em cada uma, totalizando 16 GPUs no cluster. Um otimizador de descida de gradiente estocástico (SGD) será utilizado com os seguintes hiperparâmetros:
- tamanho do mini-lote: 256
- taxa de aprendizado: 0.1
- momentum: 0.9
- decadência do peso: 0.0001
À medida que escalamos de uma GPU para 64 GPUs, aumentamos linearmente a taxa de aprendizado de acordo com a quantidade de GPUs (de 0,1 para 1 GPU até 6,4 para 64 GPUs), mantendo o número de imagens por GPU igual a 256 (de um lote de 256 imagens para 1 GPU até 16.384 para 64 GPUs). Os parâmetros de decadência do peso e momentum foram ajustados à medida que o número de GPUs aumentava. Utilizamos precisão mista de treinamento com o tipo de dados float16 durante a passagem direta e float32 para os gradientes, a fim de acelerar os cálculos em float16, suportados pelas GPUs NVIDIA Tesla.
$ mpirun -np 16
    -H server1:4,server2:4,server3:4,server4:4
    -bind-to none -map-by slot
    -mca pml ob1 -mca btl ^openib
    python mxnet_imagenet_resnet50.py
Conclusão
Neste artigo, abordamos uma abordagem escalável para treinamento distribuído de modelos usando Apache MXNet e Horovod. Mostramos a eficácia da escalabilidade e a viabilidade econômica em comparação com a abordagem utilizando um servidor de parâmetros em um conjunto de dados do ImageNet, onde o modelo ResNet50-v1 foi treinado. Também apresentamos os passos que você pode seguir para modificar um script existente e iniciar o treinamento em várias instâncias usando Horovod.
Se você está apenas começando a trabalhar com MXNet e aprendizado profundo, vá para a página de instalação , para primeiro compilar o MXNet. Também é altamente recomendável ler o artigo , para começar.
Se você já trabalhou com MXNet e deseja experimentar o aprendizado distribuído com Horovod, confira a , compile-o com o MXNet e siga o exemplo ou .
*o custo é calculado com base na da AWS para instâncias EC2
Pi-KVM — projeto de IP-KVM aberto no Raspberry Pi
Fonte: habr.com
