

A monitorização tornou-se um componente extremamente importante nas soluções em nuvem em crescimento, dadas as complexidades dos sistemas distribuídos. É essencial para entender seu comportamento. Precisamos de ferramentas escaláveis que consigam coletar dados de todos os serviços — e fornecer aos especialistas uma interface única com análise de desempenho, demonstração de erros, disponibilidade e registros.
Essas ferramentas também devem ser eficientes e produtivas. Neste artigo, examinaremos duas pilhas de tecnologia populares: EFK (Elasticsearch) e PLG (Loki), e analisaremos suas arquiteturas e diferenças.
Pilha EFK
Você pode já ter ouvido falar do muito popular ELK ou EFK. A pilha consiste em várias partes distintas: Elasticsearch (armazenamento de objetos), Logstash ou FluentD (coleta e agregação de logs) e Kibana para visualização.
Um diagrama típico de funcionamento é o seguinte:
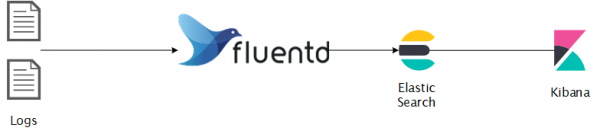
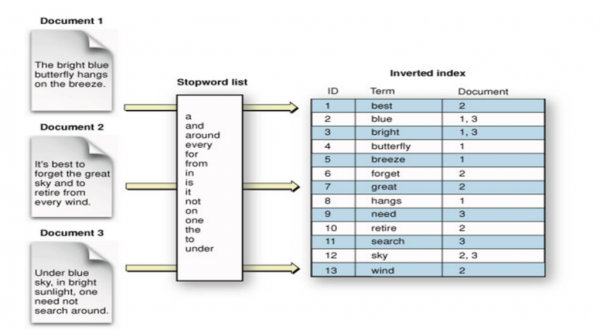
Elasticsearch — um armazenamento de objetos distribuído com pesquisa e análise em tempo real. Uma excelente solução para dados parcialmente estruturados, como logs. As informações são armazenadas como documentos JSON, indexados em tempo real e distribuídos ao longo dos nós do cluster. Um índice invertido é utilizado, contendo todas as palavras únicas e os documentos correspondentes para pesquisa de texto completo, que por sua vez é baseado no mecanismo de busca Apache Lucene.
FluentD — é um coletor de dados que realiza a unificação dos dados durante sua coleta e consumo. Ele tenta organizar os dados em JSON tanto quanto possível. Sua arquitetura é extensível, existindo mais de , suportadas pela comunidade, para todas as situações.
Kibana — uma ferramenta de visualização de dados para Elasticsearch com várias funcionalidades adicionais, como análise de séries temporais, gráficos, aprendizado de máquina e mais.
Arquitetura do Elasticsearch
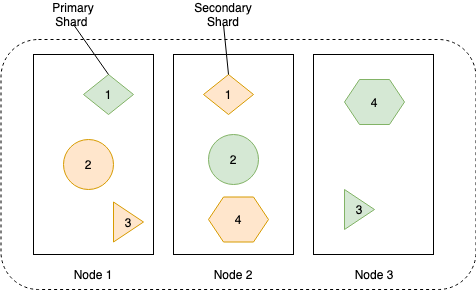
Os dados do cluster do Elasticsearch são armazenados distribuídos por todos os seus nós. O cluster consiste em vários nós para melhorar a disponibilidade e resistência. Qualquer nó pode desempenhar todas as funções do cluster, mas em grandes implantações escaláveis, os nós geralmente são atribuídos a tarefas separadas.
Tipos de nós do cluster:
- nó master — gerencia o cluster, sendo necessário no mínimo três, com um sempre ativo;
- nó de dados — armazena dados indexados e realiza várias tarefas com eles;
- nó de ingestão — organiza pipelines para transformação de dados antes da indexação;
- nó de coordenação — roteamento de solicitações, redução da fase de processamento de busca, coordenação da indexação em massa;
- nó de alerta — execução de tarefas de notificação;
- nó de aprendizado de máquina — processamento de tarefas de aprendizado de máquina.
O diagrama abaixo mostra como os dados são armazenados e replicados entre os nós para alcançar maior disponibilidade de dados.
Os dados de cada réplica são armazenados no índice invertido, o esquema abaixo mostra como isso acontece:
Instalação
Os detalhes podem ser vistos , eu vou usar o helm chart:
$ helm install efk-stack stable/elastic-stack --set logstash.enabled=false --set fluentd.enabled=true --set fluentd-elasticsStack PLG
Não se surpreenda se você não conseguir encontrar esse acrônimo, pois é mais conhecido como Grafana Loki. De qualquer forma, essa stack está ganhando popularidade, pois aplica soluções técnicas bem definidas. Você pode já ter ouvido falar do Grafana, uma ferramenta popular de visualização. Seus criadores, inspirando-se no Prometheus, desenvolveram o Loki, um sistema de agregação de logs de alto desempenho e escalável horizontalmente. O Loki indexa apenas metadados, mas não os próprios logs, essa solução técnica o tornou fácil de operar e economicamente viável.
Promtail — agente para enviar logs do sistema operacional para o cluster Loki. Grafana — ferramenta de visualização baseada em dados do Loki.
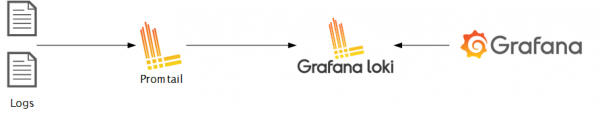
O Loki é construído nos mesmos princípios que o Prometheus, portanto, é adequado para armazenar e analisar logs do Kubernetes.
Arquitetura do Loki
O Loki pode ser executado tanto em modo de um único processo quanto em vários processos, o que fornece escalabilidade horizontal.
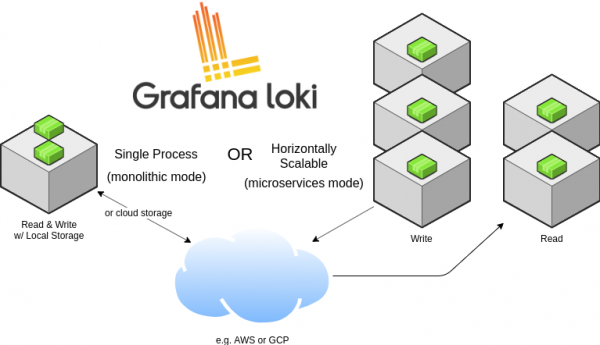
Ele também pode funcionar como um aplicativo monolítico ou como um microserviço. Executá-lo como um único processo pode ser útil para desenvolvimento local ou para monitoramento leve. Para implementação em produção e carga escalável, recomenda-se usar a versão de microserviço. Os caminhos de leitura e gravação de dados são separados, permitindo uma configuração e escalabilidade bastante refinadas conforme necessário.
Vamos dar uma olhada na arquitetura do sistema de coleta de logs sem muitos detalhes:
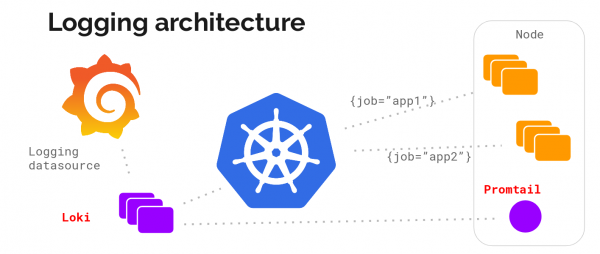
E aqui está a descrição (arquitetura de microserviço):
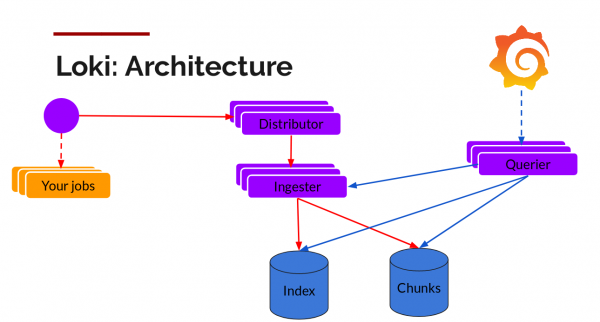
Componentes:
Promtail — agente instalado nos nós (na forma de um conjunto de serviços), ele captura logs das tarefas e acessa a API Kubernetes para obter metadados que serão usados para rotular os logs. Em seguida, ele envia o log para o serviço principal Loki. As mesmas regras de rotulação usadas no Prometheus são suportadas para correspondência de metadados.
Distribuidor — um serviço distribuidor que funciona como um buffer. Para processar milhões de registros, ele embala os dados de entrada, comprimindo-os em blocos à medida que chegam. Vários receptores de dados operam simultaneamente, mas os logs pertencentes a um único fluxo de dados de entrada devem estar apenas em um deles para todos os seus blocos. Isso é organizado na forma de um anel de receptores e hashing sequencial. Para resistência a falhas e redundância, isso é feito n vezes (3, se não configurado).
Ingester — um serviço receptor. Blocos de dados chegam comprimidos com logs adicionados. Assim que um bloco atinge um tamanho suficiente, ele é descarregado no banco de dados. Os metadados vão para o índice e os dados do bloco com o log vão para Chunks (geralmente um armazenamento de objetos). Após o descarregamento, o receptor cria um novo bloco, onde novas entradas serão adicionadas.
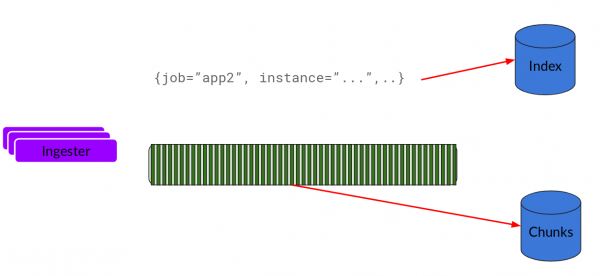
Index — banco de dados, DynamoDB, Cassandra, Google BigTable e outros.
Chunks — blocos de logs em forma comprimida, geralmente armazenados em armazenamento de objetos, como o S3.
Consultor — o caminho de leitura que faz todo o trabalho pesado. Ele verifica o intervalo de tempo e as etiquetas, depois consulta o índice para procurar correspondências. Em seguida, lê os blocos de dados e os filtra para obter o resultado.
Agora vamos ver tudo em ação.
Instalação
Para instalar no Kubernetes, o mais fácil é usar o helm. Suponha que você já o tenha instalado e configurado ( Nota do tradutor)
Adicionamos o repositório e instalamos o stack.
$ helm repo add loki https://grafana.github.io/loki/charts
$ helm repo update
$ helm upgrade --install loki loki/loki-stack --set grafana.enabled=true,prometheus.enabled=true,prometheus.alertmanager.persistentVolume.enabled=false,prometheus.server.persistentVolume.enabled=false
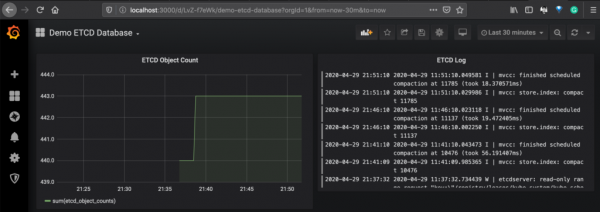
Abaixo está um exemplo de um painel que mostra dados do Prometheus para métricas Etcd e Loki para logs dos pods Etcd.
Agora vamos discutir a arquitetura de ambos os sistemas e comparar suas capacidades entre si.
Comparação
Linguagem de consulta
No Elasticsearch, utiliza-se o Query DSL e a linguagem de consulta Lucene, que permitem a pesquisa em texto completo. É um motor de busca poderoso e bem estabelecido, com ampla suporte a operadores. Com ele, é possível pesquisar no contexto e classificar por relevância.
Do outro lado do ringue está o LogQL, utilizado no Loki, herdeiro do PromQL (linguagem de consulta do Prometheus). Ele utiliza rótulos de logs para filtrar e selecionar dados de logs. Há a possibilidade de usar alguns operadores e aritmética, conforme descrito , mas em termos de recursos, ele fica atrás da linguagem Elastic.
Como as consultas no Loki estão associadas a rótulos — é fácil relacioná-las com métricas, resultando em um monitoramento operacional mais simples.
Escalabilidade
Ambas as pilhas são escaláveis horizontalmente, mas com o Loki isso é mais simples, pois ele tem caminhos separados para leitura e gravação de dados, além de uma arquitetura de microsserviços. O Loki pode ser configurado conforme suas necessidades e pode ser utilizado em volumes muito grandes de dados de logs.
Multi-inquilino
A multi-inquilino do cluster é um tema comum para a redução do OPEX, ambas as pilhas oferecem multi-inquilino. Para o Elasticsearch, existem várias de separar clientes: um índice separado para cada cliente, roteamento baseado em cliente, campos únicos para clientes, filtros de pesquisa. No Loki, há na forma do cabeçalho HTTP X-Scope-OrgID.
Custo
O Loki é bastante eficiente em termos de custos, pois não realiza a indexação de dados, apenas de metadados. Isso leva a e memória (cache), uma vez que o armazenamento de objetos é mais barato do que o de bloco, que é utilizado em clusters Elasticsearch.
Conclusão
A pilha EFK pode ser utilizada para diversos fins, oferecendo flexibilidade máxima e uma interface multifuncional do Kibana para análises, visualizações e consultas. Ela pode ser adicionalmente aprimorada com recursos de aprendizado de máquina.
A pilha Loki é útil no ecossistema Kubernetes por causa do mecanismo de descoberta de metadados. É fácil correlacionar dados para monitoramento baseado em séries temporais no Grafana e logs.
Quando se trata de custo e armazenamento a longo prazo de logs, o Loki é uma excelente escolha para quem está começando a migrar para soluções em nuvem.
Existem mais alternativas no mercado — algumas podem ser melhores para você. Por exemplo, para o GKE, há integração com o Stackdriver, que oferece uma excelente solução de monitoramento. Não as incluímos em nossa análise neste artigo.
Links:
O artigo foi traduzido e preparado para o Habr pelos colaboradores do — intensivos, videoaulas e treinamentos corporativos de especialistas em prática (Kubernetes, DevOps, Docker, Ansible, Ceph, SRE, Agile)
Fonte: habr.com
