

Introdução
Olá!
Neste artigo, compartilharei minha experiência na construção de uma arquitetura de microsserviços para um projeto que utiliza redes neurais.
Vamos discutir os requisitos da arquitetura, olhar diferentes Diagramas Estruturais, analisar cada um dos componentes da arquitetura pronta e também avaliar as métricas técnicas da solução.
Boa leitura!
Um pouco sobre a tarefa e sua solução
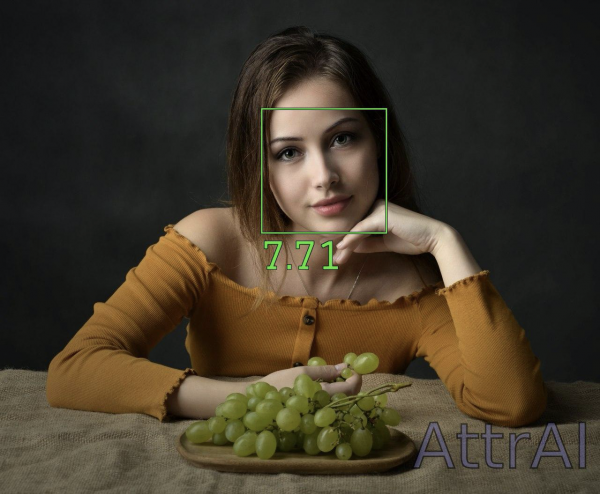
A ideia principal é avaliar a atratividade de uma pessoa com base em uma foto, utilizando uma escala de dez pontos.
Neste artigo, nos afastaremos da descrição das redes neurais utilizadas e do processo de preparação de dados e treinamento. No entanto, em uma das próximas publicações, certamente voltaremos à análise do pipeline de avaliação em um nível mais aprofundado.
Agora, faremos uma visão geral do pipeline de avaliação, concentrando-nos na interação dos microsserviços no contexto da arquitetura geral do projeto.
Ao trabalhar no pipeline de avaliação de atratividade, a tarefa foi decomposta nas seguintes partes:
- Detecção de rostos na foto
- Avaliação de cada um dos rostos
- Renderização do resultado
A primeira é resolvida com um modelo pré-treinado de . Para a segunda, uma rede neural convolucional foi treinada no PyTorch, usando como backbone – equilibrando "qualidade / velocidade de inferência em CPU"
Diagrama funcional do pipeline de avaliação
Análise dos requisitos da arquitetura do projeto
No ciclo de vida do projeto, as etapas de trabalho na arquitetura e automatização do despliegue do modelo são muitas vezes as mais dispendiosas em tempo e recursos.
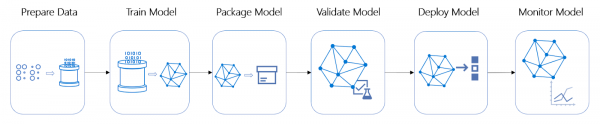
Ciclo de vida de um projeto de ML
Este projeto não é uma exceção - foi tomada a decisão de encapsular o pipeline de avaliação em um serviço online, para isso era necessário mergulhar na arquitetura. Foram definidos os seguintes requisitos básicos:
- Um repositório unificado de logs – todos os serviços devem registrar logs em um único lugar, que deve ser fácil de analisar.
- Capacidade de escalabilidade horizontal do serviço de avaliação — como o gargalo mais provável.
- Para cada imagem deve ser alocado o mesmo número de recursos de CPU — para evitar outliers na distribuição do tempo de inferência.
- Desdobramento (re)rápido tanto de serviços específicos quanto da pilha como um todo.
- Possibilidade, se necessário, de utilizar objetos comuns em diferentes serviços.
Arquitetura
Após a análise dos requisitos, ficou claro que a arquitetura de microsserviços se encaixa praticamente perfeito.
Para evitar problemas desnecessários, foi escolhido o Telegram API como frontend.
Primeiro, vamos considerar o diagrama estrutural da arquitetura pronta; em seguida, passaremos para a descrição de cada um dos componentes e formalizaremos o processo de processamento bem-sucedido da imagem.
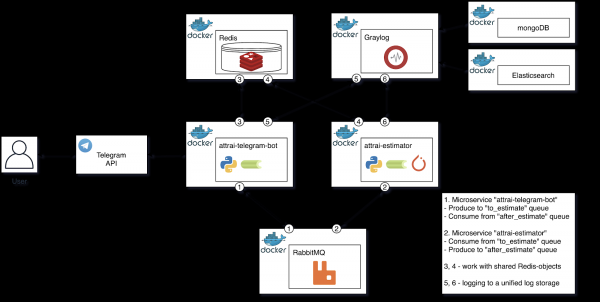
Diagrama estrutural da arquitetura pronta
Vamos falar mais sobre cada um dos componentes do diagrama, destacando sua Responsabilidade Única no processo de avaliação da imagem.
Microsserviço «attrai-telegram-bot»
Este microsserviço encapsula todas as interações com o Telegram API. Podemos destacar 2 cenários principais – trabalhar com a imagem do usuário e trabalhar com o resultado do pipeline de avaliação. Vamos analisar ambos os cenários de forma geral.
Ao receber a mensagem do usuário com a imagem:
- A filtragem é realizada, consistindo nas seguintes verificações:
- Se a imagem tem o tamanho ideal
- A quantidade de imagens do usuário que já estão na fila
- Ao passar pela filtragem inicial, a imagem é salva em um volume do Docker
- Uma tarefa é enviada para a fila “to_estimate”, que inclui, entre outras coisas, o caminho da imagem que está em nosso volume
- Se as etapas mencionadas acima forem concluídas com sucesso, o usuário receberá uma mensagem com o tempo estimado de processamento da imagem, calculado com base no número de tarefas na fila. Em caso de erro, o usuário será claramente informado – por meio do envio de uma mensagem com informações sobre o que pode ter dado errado.
Além disso, este microsserviço, como um trabalhador Celery, escuta a fila “after_estimate”, que é destinada a tarefas que passaram pelo pipeline de avaliação.
Ao receber uma nova tarefa de “after_estimate”:
- Se a imagem foi processada com sucesso – enviamos o resultado para o usuário; se não – informamos sobre o erro
- Removemos a imagem que é o resultado do pipeline de avaliação
Microsserviço de avaliação «attrai-estimator»
Este microsserviço é um trabalhador Celery e encapsula tudo o que está relacionado ao pipeline de avaliação da imagem. O algoritmo de operação aqui é único – vamos analisá-lo.
Ao receber uma nova tarefa de “to_estimate”:
- Passamos a imagem pelo pipeline de avaliação:
- Carregamos a imagem na memória
- Redimensionamos a imagem para o tamanho necessário
- Detectamos todos os rostos (MTCNN)
- Analisamos todos os rostos (envolvemos os rostos encontrados na etapa anterior em um batch e inferimos usando ResNet34)
- Renderizamos a imagem final
- Desenhamos bounding boxes
- Desenhamos as avaliações
- Removemos a imagem original do usuário
- Salvamos a saída do pipeline de avaliação
- Colocamos a tarefa na fila "after_estimate", que é ouvida pelo microserviço "attrai-telegram-bot" mencionado anteriormente
Graylog (+ mongoDB + Elasticsearch)
— é uma solução para gerenciamento centralizado de logs. Neste projeto, foi utilizada para seu propósito original.
Escolhemos essa opção em vez do popular stack, devido à conveniência de usá-lo com Python. Tudo o que é necessário fazer para registrar no Graylog é adicionar o GELFTCPHandler do pacote aos demais manipuladores de logger root do nosso microserviço em Python.
Como alguém que trabalhou apenas com a pilha ELK anteriormente, tive uma experiência positiva ao trabalhar com o Graylog. A única coisa decepcionante é a superioridade de recursos do Kibana sobre a interface web do Graylog.
RabbitMQ
— é um broker de mensagens baseado no protocolo AMQP.
Neste projeto, foi usado como para o Celery e funcionou em modo durable.
Redis
— é um sistema de gerenciamento de banco de dados NoSQL que trabalha com estruturas de dados do tipo "chave-valor".
Às vezes, é necessário usar objetos compartilhados em diferentes microserviços em Python que implementem algumas estruturas de dados.
Por exemplo, o Redis armazena um hashmap do tipo "telegram_user_id => número de tarefas ativas na fila", o que permite limitar o número de solicitações de um único usuário a um valor específico e, assim, prevenir ataques DoS.
Formalizamos o processo de tratamento bem-sucedido de imagens
- O usuário envia uma imagem para o bot do Telegram
- "attrai-telegram-bot" recebe a mensagem da API do Telegram e a processa
- A tarefa com a imagem é adicionada à fila assíncrona "to_estimate"
- O usuário recebe uma mensagem com o tempo estimado para avaliação
- "attrai-estimator" pega a tarefa da fila "to_estimate", processa através do pipeline de avaliação e produz a tarefa na fila "after_estimate"
- O "attrai-telegram-bot", monitorando a fila "after_estimate", envia o resultado ao usuário
DevOps
Finalmente, após revisar a arquitetura, podemos passar para uma parte igualmente interessante — DevOps
Mas isso significa que você pode usar o mesmo arquivo docker-compose no
– sistema de clusterização, cuja funcionalidade é implementada dentro do Docker Engine e está disponível por padrão.
Com a 'swarms', todos os nós do nosso cluster podem ser divididos em 2 tipos – worker e manager. Nas máquinas do primeiro tipo, grupos de contêineres (stacks) são implantados, enquanto as máquinas do segundo tipo são responsáveis pela escalabilidade, balanceamento e Os managers, por padrão, são também workers.
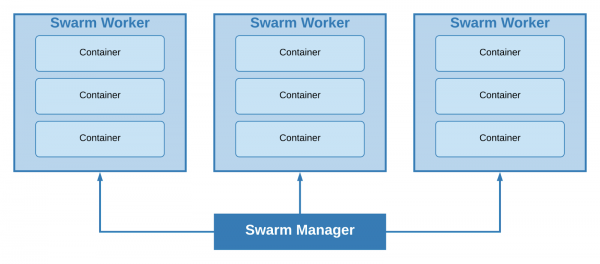
Cluster com um leader manager e três workers.
O tamanho mínimo possível de um cluster é de 1 nó, onde a única máquina atuará simultaneamente como leader manager e worker. Com base no tamanho do projeto e nas exigências mínimas de resiliência, foi decidido adotar exatamente essa abordagem.
Adiantando-me, posso dizer que desde a primeira entrega em produção, que ocorreu em meados de junho, não houve problemas relacionados à organização deste cluster (mas isso não significa que essa organização seja em qualquer nível aceitável em projetos de médio a grande porte que impõem exigências de resiliência).
Docker Stack
No modo 'swarms', o responsável pela implantação dos stacks (conjuntos de serviços docker) é
Ele suporta configurações do docker-compose, permitindo usar parâmetros de deploy adicionais.
Por exemplo, através destes parâmetros, os recursos em cada uma das instâncias do microsserviço de estimativa foram limitados (alocamos para N instâncias N núcleos, e no próprio microsserviço limitamos o número de núcleos usados pelo PyTorch a um).
attrai_estimator:
  image: 'erqups/attrai_estimator:1.2'
  deploy:
    replicas: 4
    resources:
      limits:
        cpus: '4'
    restart_policy:
      condition: on-failure
      …
É importante ressaltar que Redis, RabbitMQ e Graylog são serviços stateful e não podem ser escalados tão facilmente quanto o 'attrai-estimator'.
Antecipando a pergunta – por que não Kubernetes?
Parece que o uso do Kubernetes em projetos pequenos e médios é um overhead, toda a funcionalidade necessária pode ser obtida com o Docker Swarm, que é bastante amigável para o orquestrador de contêineres, além de ter uma baixa barreira de entrada.
Infraestrutura
Isso tudo foi implantado em um VDS com as seguintes características:
- CPU: 4 núcleos Intel® Xeon® Gold 5120 CPU @ 2.20GHz
- RAM: 8 GB
- SSD: 160 GB
Após testes de carga locais, parecia que, diante de um grande fluxo de usuários, essa máquina seria suficiente apenas na medida.
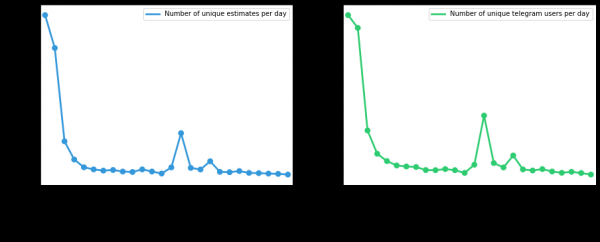
Mas, logo após o deployment, postei um link para um dos mais populares imageboards na CEI (sim, aquele mesmo), após o que as pessoas ficaram interessadas e, em poucas horas, o serviço processou com sucesso dezenas de milhares de imagens. Nesse momento, os recursos de CPU e RAM não foram utilizados nem pela metade, mesmo nos picos.
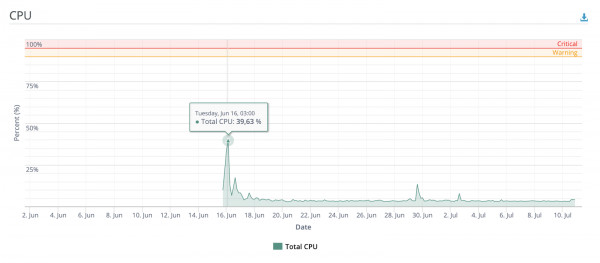
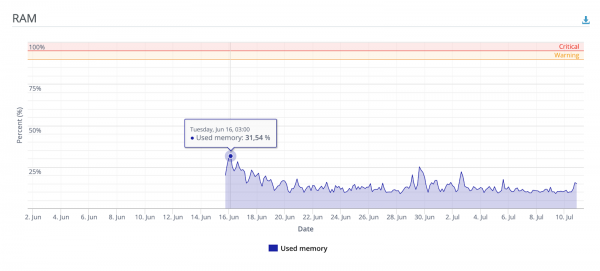
Mais um pouco de gráficos
Número de usuários únicos e solicitações de avaliação, desde o momento do deployment, dependendo do dia
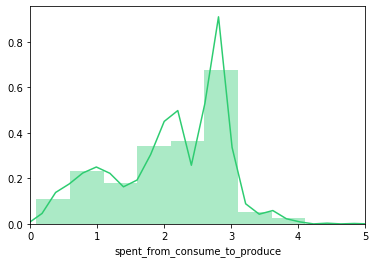
Distribuição do tempo de inferência do pipeline de avaliação
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
Resumindo, posso dizer que a arquitetura e a abordagem para a orquestração de contêineres se mostraram plenamente justificadas — mesmo nos picos, não houve quedas ou atrasos no tempo de processamento.
Acredito que projetos de pequeno e médio porte, que utilizam inferência em tempo real de redes neurais em CPU, podem adotar com sucesso as práticas descritas neste artigo.
Adiciono que originalmente o artigo era maior, mas, para não postar um longo texto, decidi omitir alguns pontos neste artigo — voltaremos a eles em publicações futuras.
Você pode interagir com o bot no Telegram — @AttraiBot, ele funcionará, pelo menos, até o final do outono de 2020. Lembro que nenhum dado do usuário é armazenado — nem as imagens originais, nem os resultados do pipeline de avaliação — tudo é deletado após o processamento.
Fonte: habr.com
