

Atualmente, existem 100.500 cursos de Data Science e já é bem conhecido que é através desses cursos que se pode ganhar mais dinheiro em Data Science (por que cavar, quando se pode vender pás?). O principal problema desses cursos é que eles não têm nada a ver com o trabalho real: ninguém irá fornecer dados limpos e processados no formato necessário. E quando você termina o curso e começa a resolver um problema real, surgem muitos nuances.
Por isso, começamos uma série de notas intituladas "O que pode dar errado com Data Science", baseadas em eventos reais que aconteceram comigo, meus amigos e colegas. Vamos analisar exemplos reais de tarefas típicas de Data Science: como isso realmente acontece. Hoje começaremos com a tarefa de coleta de dados.
E a primeira coisa em que as pessoas tropeçam ao trabalhar com dados reais é, na verdade, a coleta dos dados relevantes. A mensagem principal deste artigo é:
Subestimamos sistematicamente o tempo, os recursos e os esforços necessários para coletar, limpar e preparar os dados.
E o mais importante, discutiremos o que fazer para evitar isso.
De acordo com várias estimativas, a limpeza, transformação, processamento de dados, engenharia de características, etc. ocupam de 80 a 90% do tempo, enquanto a análise leva de 10 a 20%, enquanto quase todo o material didático foca exclusivamente na análise.
Vamos analisar um exemplo simples de uma tarefa analítica típica em três variantes e veremos quais são as "circunstâncias agravantes".
E para o exemplo, novamente, consideraremos variações semelhantes da tarefa de coleta de dados e comparação de comunidades para:
- Dois subreddits do Reddit
- Duas seções do Habr
- Dois grupos do Odnoklassniki
Uma abordagem condicional na teoria
Abra o site e leia os exemplos, se estiver claro, reserve algumas horas para leitura, algumas horas para codificação dos exemplos e depuração. Adicione algumas horas para coleta. Adicione algumas horas a mais (multiplique por dois e acrescente N horas).
O ponto chave: a estimativa de tempo é baseada em suposições e adivinhações sobre quanto tempo isso levará.
Começar a análise de tempo precisa ter uma estimativa dos seguintes parâmetros para a tarefa condicional descrita acima:
- Qual é o tamanho dos dados e quanto é necessário coletar fisicamente (*veja abaixo*).
- Qual o tempo de coleta de um registro e quanto é necessário esperar antes de poder coletar o segundo.
- Implementar a escrita de código que mantém o estado e reinicia quando (e não se) tudo falhar.
- Entender se precisamos de autorização e estipular o tempo para obter acesso via API.
- Registrar o número de erros como uma função da complexidade dos dados — avaliar com base em uma tarefa específica: estrutura, quantas transformações, o que e como extraímos.
- Considerar erros de rede e problemas com comportamentos incomuns do projeto.
- Avaliar se as funções necessárias estão na documentação e, se não, como e quanto será necessário para uma solução alternativa.
O mais importante para estimar o tempo — você realmente precisa dedicar tempo e esforço para uma 'exploração inicial' — somente assim seu planejamento será adequado. Portanto, por mais que lhe pressionem para dizer 'quanto tempo é necessário para coletar dados' — reserve um tempo para a análise preliminar e argumente que o tempo vai variar dependendo dos parâmetros reais da tarefa.
E agora, vamos demonstrar exemplos concretos onde tais parâmetros irão mudar.
Ponto chave: a estimativa baseia-se na análise de fatores-chave que influenciam o volume e a complexidade do trabalho.
Uma estimativa baseada em palpites é uma boa abordagem quando os elementos funcionais são relativamente pequenos e existem poucos fatores que podem impactar significativamente a estrutura da tarefa. Mas em uma série de tarefas de Data Science, muitos fatores surgem e essa abordagem torna-se inadequada.
Comparação de comunidades Reddit
Vamos começar com o caso mais simples (como se mostrará mais tarde). De fato, se formos completamente honestos, temos quase um caso ideal, vamos verificar nossa lista de verificação de complexidade:
- Há uma API clara, compreensível e documentada.
- É extremamente simples, e o mais importante, o token é gerado automaticamente.
- Há — com muitos exemplos.
- A comunidade que se dedica à análise e coleta de dados no Reddit (inclusive vídeos no YouTube que explicam como usar o python wrapper) .
- Os métodos que precisamos provavelmente estão disponíveis na API. Além disso, o código parece compacto e limpo, abaixo um exemplo de uma função que coleta comentários de um post.
def get_comments(submission_id):
    reddit = Reddit(check_for_updates=False, user_agent=AGENT)
    submission = reddit.submission(id=submission_id)
    more_comments = submission.comments.replace_more()
    if more_comments:
        skipped_comments = sum(x.count for x in more_comments)
        logger.debug('Skipped %d MoreComments (%d comments)',
                     len(more_comments), skipped_comments)
    return submission.comments.list()
Retirado de seleções de utilitários convenientes para empacotamento.
Embora estejamos diante do melhor caso, ainda devemos levar em conta uma série de fatores importantes da vida real:
- Limites da API — somos obrigados a coletar dados em lotes (pausando entre as requisições, etc.).
- Tempo de coleta — para uma análise e comparação completas, será necessário reservar um tempo considerável apenas para o spider percorrer o subreddt.
- O bot deve ser executado em um servidor — você não pode simplesmente inicializá-lo no seu notebook, colocar na mochila e sair para resolver questões. Portanto, eu executei tudo em um VPS. Usando o código promocional habrahabr10, é possível economizar 10% no custo.
- A inacessibilidade física de alguns dados (eles são visíveis apenas para administradores ou são muito complicados de coletar) — isso deve ser considerado, nem todos os dados podem ser coletados em um tempo razoável.
- Erros de rede: trabalhar com redes é um desafio.
- Estes são dados reais — eles não chegam limpos.
Claro, é necessário levar em conta esses detalhes no desenvolvimento. O tempo exato varia de acordo com a experiência em desenvolvimento ou experiência em tarefas semelhantes, no entanto, vemos que se trata de uma tarefa puramente de engenharia e não requer esforços adicionais para a solução — tudo pode ser muito bem avaliado, escrito e feito.
Comparação das seções do Habr
Vamos passar para um caso mais interessante e não trivial: comparar fluxos e/ou seções do Habr.
Vamos verificar nossa lista de verificação de complexidade — aqui, para entender cada item, será necessário um pouco de tentativa e erro na própria tarefa e experimentar.
- Primeiro, você pensa que há uma API, mas não há. Sim, o Habr tem uma API, mas ela só está disponível para administradores (ou pode nem funcionar).
- Depois, você simplesmente começa a fazer parsing de HTML — 'import requests', o que pode dar errado?
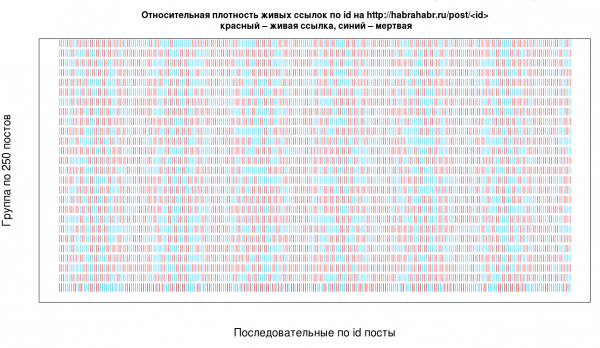
- E como você realmente faz parsing? A abordagem mais simples e frequentemente usada é iterar por ID, observando que não é a mais eficiente e será necessário lidar com diferentes casos — aqui está um exemplo da densidade de IDs reais entre todos os existentes.

Retirado de artigo. - Dados brutos envelopados em HTML pela rede são uma dor. Por exemplo, você quer coletar e armazenar a pontuação de um artigo: você raspou a pontuação do HTML e decidiu salvá-la como um número para processamento posterior.
1) int(score) gera um erro: pois no Habr o sinal negativo, como na string "–5" — é um hífen curto, e não um sinal de menos (surpreendente, não é?), portanto em algum momento foi necessário reativar o parser com essa correção horrível.
try:
      score_txt = post.find(class_="score").text.replace(u"–","-").replace(u"+","+")
      score = int(score_txt)
      if check_date(date):
        post_score += score
As datas, sinais de mais e menos podem nem estar presentes (como vemos acima pela função check_date e já foi o caso).
2) Caracteres especiais não escapados — eles aparecerão, precisamos estar preparados.
3) A estrutura muda dependendo do tipo de postagem.
4) Postagens antigas podem ter **estrutura estranha**.
- Basicamente, o tratamento de erros e o que pode ou não acontecer terão que ser tratados e não se pode prever com certeza o que dará errado e como a estrutura pode ser diferente e onde pode haver falhas — você terá que apenas tentar e considerar os erros que o parser gera.
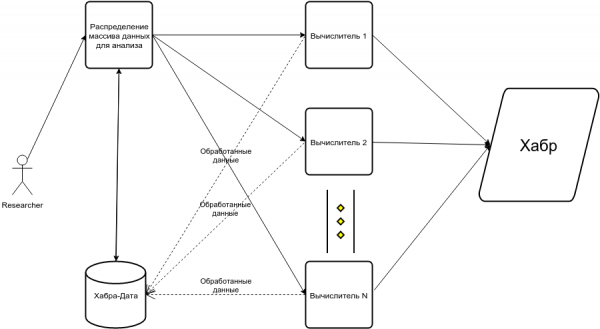
- Depois você percebe que precisa raspar em múltiplas threads, caso contrário, a raspagem em uma só levará 30+ horas (isso é apenas o tempo de execução de um parser funcional de thread única, que fica inativo e não cai sob nenhum banimento). Em um artigo, isso levou em algum momento a um esquema como este:
Resumo do checklist de complexidade:
- Trabalho com a rede e raspagem de HTML com iteração e looping por ID.
- Documentos de estrutura heterogênea.
- Muitos locais onde o código pode facilmente falhar.
- É necessário escrever || código.
- Falta a documentação necessária, exemplos de código e/ou comunidade.
A estimativa condicional de tempo para essa tarefa será de 3 a 5 vezes maior do que para a coleta de dados do Reddit.
Comparação de grupos do Odnoklassniki
Vamos passar para o caso tecnicamente mais interessante dos mencionados. Para mim, ele era interessante precisamente porque, à primeira vista, parece bastante trivial, mas não é — assim que você toca nele com um bastão.
Começaremos com nosso checklist de complexidade e notaremos que muitos deles se revelarão muito mais difíceis do que parecem no início:
- A API existe, mas quase não há funções necessárias nela.
- Para certas funções, é necessário solicitar acesso por e-mail, ou seja, a concessão de acesso não é instantânea.
- A documentação é péssima (como se começássemos com a confusão entre os termos russos e ingleses, de forma totalmente inconsistente — às vezes você simplesmente precisa adivinhar o que esperam de você em algum lugar) e, além disso, não é adequada para coleta de dados, por exemplo, .
- Requer sessão na documentação, mas na prática não a utiliza — e não há como entender todas as nuances dos modos da API, exceto tatear e torcer para que algo funcione.
- Faltam exemplos e comunidades, o único ponto de apoio para coleta de informações é um pequeno em Python (sem muitas exemplificações).
- A opção mais funcional parece ser o Selenium, já que muitos dos dados necessários estão trancados.
1) Ou seja, a autorização é feita através de um usuário fictício (e o cadastro manualmente).2) No entanto, com o Selenium não há garantias de funcionamento correto e repetível (pelo menos no caso do ok.ru, definitivamente).
3) O site Ok.ru apresenta erros de JavaScript e às vezes se comporta de forma estranha e inconsistente.
4) É necessário lidar com paginação, carregamento de elementos etc...
5) Erros da API que o wrapper fornece precisarão ser tratados de forma improvisada, por exemplo assim (um trecho de código experimental):
def get_comments(args, context, discussions):
    pause = 1
    if args.extract_comments:
        all_comments = set()
# faz sentido acompanhar discussões já processadas
        for discussion in tqdm(discussions):
            try:
                comments = get_comments_from_discussion_via_api(context, discussion)
            except odnoklassniki.api.OdnoklassnikiError as e:
                if "NOT_FOUND" in str(e):
                    comments = set()
                else:
                    print(e)
                    bp()
                    pass
            all_comments |= comments
            time.sleep(pause)
        return all_comments
Meu erro favorito foi:
OdnoklassnikiError("Error(code: 'None', description: 'HTTP error', method: 'discussions.getComments', params: …)")6) No final, a combinação Selenium + API parece ser a opção mais racional.
- É necessário manter o estado e reiniciar o sistema, tratando muitos erros, incluindo comportamentos inconsistentes do site — além disso, esses erros são bastante difíceis de imaginar (a menos que você escreva parsers profissionalmente, é claro).
A estimativa de tempo para esta tarefa seria de 3 a 5 vezes maior do que para coletar dados do Habr. Embora no caso do Habr estejamos usando uma abordagem direta de parser HTML, no caso do OK podemos trabalhar com a API em pontos críticos.
Como resultado, obtemos um serviço de "monitoramento como serviço", automatizado na linha de produção de integração contínua. O desenvolvedor ou testador precisa apenas definir a lista de métricas em um arquivo JSON, e tudo o mais acontece automaticamente. Obtemos um controle de qualidade transparente dos lançamentos: todas as notificações sobre desempenho, consumo de recursos ou regressões arquitetônicas.
Independentemente de como você é solicitado a avaliar os prazos "no local" (afinal, estamos em um processo de planejamento hoje!), a duração de módulos complexos de pipeline de processamento de dados é praticamente impossível de ser avaliada, mesmo de forma qualitativa, sem uma análise dos parâmetros da tarefa.
Falando de uma forma um pouco mais filosófica, as estratégias de avaliação ágil se aplicam bem a tarefas de engenharia, mas em tarefas mais experimentais e, de certa forma, "criativas" e de pesquisa, ou seja, menos previsíveis, surgem dificuldades, como nos exemplos que discutimos aqui.
Certamente, a coleta de dados é um exemplo ilustrativo — geralmente essa tarefa parece incrivelmente simples e tecnicamente não complexa, e é exatamente nos detalhes que frequentemente está o problema. E é nessa tarefa que podemos mostrar toda a gama de possíveis variações do que pode dar errado e quanto tempo o trabalho pode demorar.
Se olharmos rapidamente para as características da tarefa sem experimentos adicionais, Reddit e OK parecem semelhantes: ambos têm API e wrapper em python, mas, na verdade, a diferença é enorme. Julgando por esses parâmetros, o parser do Habr parece mais complicado do que o OK — mas na prática é exatamente o contrário e isso só pode ser descoberto realizando experimentos simples para analisar os parâmetros da tarefa.
Na minha experiência, a abordagem mais eficaz é uma estimativa aproximada do tempo necessário para a análise preliminar e os primeiros experimentos simples, a leitura da documentação — é isso que permitirá dar uma avaliação precisa para todo o trabalho. Em termos da metodologias ágeis populares — eu peço que abra um ticket para a "avaliação dos parâmetros da tarefa", com base no qual poderei estimar o que pode ser realizado dentro do "sprint" e fornecer uma estimativa mais precisa para cada tarefa.
Portanto, o argumento mais eficaz parece ser aquele que mostra a um especialista "não técnico" como o tempo e os recursos podem variar significativamente dependendo dos parâmetros que ainda precisam ser avaliados.
Fonte: habr.com
