

Caros leitores, bom dia. Hoje vamos falar um pouco sobre Apache Spark e suas perspectivas de desenvolvimento.
No mundo moderno de Big Data, o Apache Spark é considerado o padrão de fato para o desenvolvimento de tarefas de processamento em lote de dados. Além disso, ele também é utilizado para criar aplicações de streaming que operam no conceito de micro batch, processando e enviando dados em pequenas porções (Spark Structured Streaming). Tradicionalmente, ele fazia parte do ecossistema Hadoop, utilizando YARN como gerenciador de recursos (ou, em alguns casos, Apache Mesos). Até 2020, seu uso em sua forma tradicional para a maioria das empresas está sob grande questionamento devido à falta de distribuições adequadas do Hadoop — o desenvolvimento do HDP e CDH foi interrompido, o CDH não é suficientemente robusto e tem um custo elevado, e os outros fornecedores de Hadoop ou cessaram suas atividades ou têm um futuro incerto. Portanto, crescente interesse da comunidade e de grandes empresas surge ao lançar o Apache Spark usando Kubernetes — se tornando um padrão na orquestração de contêineres e gerenciamento de recursos em nuvens privadas e públicas, resolvendo o problema do agendamento complicado de tarefas Spark no YARN e fornecendo uma plataforma em evolução estável com diversas distribuições comerciais e abertas para empresas de todos os tamanhos e setores. Além disso, com a onda de popularidade, a maioria já conseguiu implementar algumas de suas instalações e acumular expertise em seu uso, facilitando a transição.
A partir da versão 2.3.0, o Apache Spark ganhou suporte oficial para executar tarefas em clusters Kubernetes e hoje, vamos discutir a maturidade atual dessa abordagem, diferentes opções de uso e os obstáculos que podem ser enfrentados na implementação.
Primeiramente, vamos examinar o processo de desenvolvimento de tarefas e aplicações com base no Apache Spark e destacar os casos típicos em que é necessário executar uma tarefa em um cluster Kubernetes. Para a preparação deste post, foi utilizado o OpenShift como distribuição e serão apresentandos os comandos relevantes para sua ferramenta de linha de comando (oc). Para outras distribuições do Kubernetes, podem ser utilizados os comandos correspondentes da ferramenta de linha de comando padrão do Kubernetes (kubectl) ou seus análogos (por exemplo, para oc adm policy).
A primeira opção de uso é o spark-submit
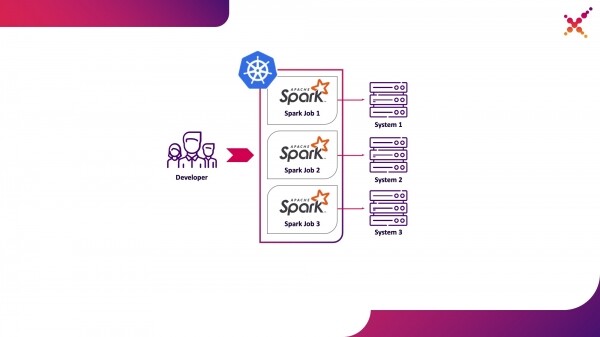
Durante o processo de desenvolvimento de tarefas e aplicativos, o desenvolvedor precisa executar tarefas para depuração de transformações de dados. Teoricamente, podem ser utilizados mocks para esses fins, mas o desenvolvimento com a participação de instâncias reais (mesmo que de teste) dos sistemas finais mostrou-se mais rápido e de melhor qualidade nesse tipo de tarefa. Quando depuramos em instâncias reais dos sistemas finais, existem dois cenários de funcionamento:
- o desenvolvedor executa a tarefa Spark localmente no modo standalone;

- o desenvolvedor executa a tarefa Spark em um cluster Kubernetes no ambiente de teste.
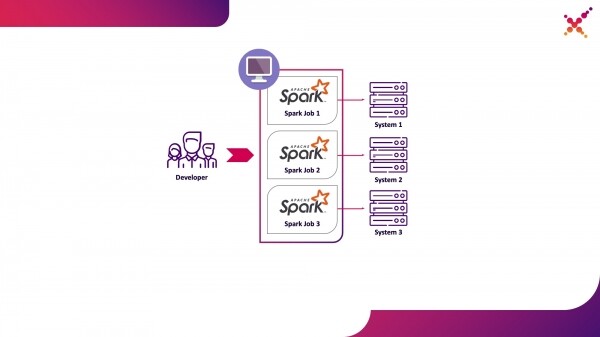
A primeira opção é viável, mas acarreta uma série de desvantagens:
- cada desenvolvedor precisa ter acesso do seu local de trabalho a todas as instâncias necessárias dos sistemas finais;
- a máquina de trabalho precisa ter recursos suficientes para executar a tarefa em desenvolvimento.
A segunda opção não possui essas desvantagens, pois o uso de um cluster Kubernetes permite alocar o conjunto de recursos necessário para a execução das tarefas e garantir os acessos necessários às instâncias dos sistemas finais, fornecendo acesso de forma flexível por meio de uma modelagem de papéis do Kubernetes para todos os membros da equipe de desenvolvimento. Vamos destacá-la como a primeira opção de uso — executar tarefas Spark da máquina local do desenvolvedor em um cluster Kubernetes no ambiente de teste.
Vamos falar mais sobre o processo de configuração do Spark para execução local. Para começar a usar o Spark, é necessário instalá-lo:
mkdir /opt/spark
cd /opt/spark
wget http://mirror.linux-ia64.org/apache/spark/spark-2.4.5/spark-2.4.5.tgz
tar zxvf spark-2.4.5.tgz
rm -f spark-2.4.5.tgz
Coletamos os pacotes necessários para trabalhar com Kubernetes:
cd spark-2.4.5/
./build/mvn -Pkubernetes -DskipTests clean package
A compilação completa leva muito tempo, e para criar imagens Docker e executá-las no cluster Kubernetes, na realidade, só são necessários os arquivos jar do diretório "assembly/", portanto, pode-se compilar apenas este subprojeto:
./build/mvn -f ./assembly/pom.xml -Pkubernetes -DskipTests clean package
Para executar tarefas Spark no Kubernetes, é necessário criar uma imagem Docker que será usada como base. Aqui, existem dois abordagens:
- A imagem Docker criada inclui o código executável da tarefa Spark;
- A imagem criada inclui apenas o Spark e as dependências necessárias, com o código executável hospedado remotamente (por exemplo, no HDFS).
Para começar, vamos construir uma imagem Docker contendo um exemplo de tarefa do Spark. Para criar imagens Docker, o Spark possui uma ferramenta chamada "docker-image-tool". Vamos revisar a ajuda dela:
./bin/docker-image-tool.sh --help
Com ela, é possível criar imagens Docker e carregá-las em repositórios remotos, mas por padrão, possui algumas desvantagens:
- sempre cria 3 imagens Docker — para Spark, PySpark e R;
- não permite especificar o nome da imagem.
Portanto, usaremos uma versão modificada dessa ferramenta, apresentada abaixo:
vi bin/docker-image-tool-upd.sh
#!/usr/bin/env bash

function error {
  echo "$@" 1>&2
  exit 1
}

if [ -z "${SPARK_HOME}" ]; then
  SPARK_HOME="$(cd "`dirname "$0"`"/..; pwd)"
fi
. "${SPARK_HOME}/bin/load-spark-env.sh"

function image_ref {
  local image="$1"
  local add_repo="${2:-1}"
  if [ $add_repo = 1 ] && [ -n "$REPO" ]; then
    image="$REPO/$image"
  fi
  if [ -n "$TAG" ]; then
    image="$image:$TAG"
  fi
  echo "$image"
}

function build {
  local BUILD_ARGS
  local IMG_PATH

  if [ ! -f "$SPARK_HOME/RELEASE" ]; then
    IMG_PATH=$BASEDOCKERFILE
    BUILD_ARGS=(
      ${BUILD_PARAMS}
      --build-arg
      img_path=$IMG_PATH
      --build-arg
      datagram_jars=datagram/runtimelibs
      --build-arg
      spark_jars=assembly/target/scala-$SPARK_SCALA_VERSION/jars
    )
  else
    IMG_PATH="kubernetes/dockerfiles"
    BUILD_ARGS=(${BUILD_PARAMS})
  fi

  if [ -z "$IMG_PATH" ]; then
    error "Cannot find docker image. This script must be run from a runnable distribution of Apache Spark."
  fi

  if [ -z "$IMAGE_REF" ]; then
    error "Cannot find docker image reference. Please add -i arg."
  fi

  local BINDING_BUILD_ARGS=(
    ${BUILD_PARAMS}
    --build-arg
    base_img=$(image_ref $IMAGE_REF)
  )
  local BASEDOCKERFILE=${BASEDOCKERFILE:-"$IMG_PATH/spark/docker/Dockerfile"}

  docker build $NOCACHEARG "${BUILD_ARGS[@]}"
    -t $(image_ref $IMAGE_REF)
    -f "$BASEDOCKERFILE" .
}

function push {
  docker push "$(image_ref $IMAGE_REF)"
}

function usage {
  cat <<EOF
Usage: $0 [options] [command]
Builds or pushes the built-in Spark Docker image.

Commands:
  build       Build image. Requires a repository address to be provided if the image will be
              pushed to a different registry.
  push        Push a pre-built image to a registry. Requires a repository address to be provided.

Options:
  -f file               Dockerfile to build for JVM based Jobs. By default builds the Dockerfile shipped with Spark.
  -p file               Dockerfile to build for PySpark Jobs. Builds Python dependencies and ships with Spark.
  -R file               Dockerfile to build for SparkR Jobs. Builds R dependencies and ships with Spark.
  -r repo               Repository address.
  -i name               Image name to apply to the built image, or to identify the image to be pushed.
  -t tag                Tag to apply to the built image, or to identify the image to be pushed.
  -m                    Use minikube's Docker daemon.
  -n                    Build docker image with --no-cache
  -b arg      Build arg to build or push the image. For multiple build args, this option needs to
              be used separately for each build arg.

Using minikube when building images will do so directly into minikube's Docker daemon.
There is no need to push the images into minikube in that case, they'll be automatically
available when running applications inside the minikube cluster.

Check the following documentation for more information on using the minikube Docker daemon:

  https://kubernetes.io/docs/getting-started-guides/minikube/#reusing-the-docker-daemon

Examples:
  - Build image in minikube with tag "testing"
    $0 -m -t testing build

  - Build and push image with tag "v2.3.0" to docker.io/myrepo
    $0 -r docker.io/myrepo -t v2.3.0 build
    $0 -r docker.io/myrepo -t v2.3.0 push
EOF
}

if [[ "$@" = *--help ]] || [[ "$@" = *-h ]]; then
  usage
  exit 0
fi

REPO=
TAG=
BASEDOCKERFILE=
NOCACHEARG=
BUILD_PARAMS=
IMAGE_REF=
while getopts f:mr:t:nb:i: option
do
 case "${option}"
 in
 f) BASEDOCKERFILE=${OPTARG};;
 r) REPO=${OPTARG};;
 t) TAG=${OPTARG};;
 n) NOCACHEARG="--no-cache";;
 i) IMAGE_REF=${OPTARG};;
 b) BUILD_PARAMS=${BUILD_PARAMS}" --build-arg "${OPTARG};;
 esac
done

case "${@: -1}" in
  build)
    build
    ;;
  push)
    if [ -z "$REPO" ]; then
      usage
      exit 1
    fi
    push
    ;;
  *)
    usage
    exit 1
    ;;
esac
Com ela, montamos uma imagem base do Spark contendo uma tarefa de teste para calcular o número Pi usando o Spark (aqui {docker-registry-url} é a URL do seu repositório de imagens Docker, {repo} é o nome do repositório dentro do registro, que coincide com o projeto no OpenShift, {image-name} é o nome da imagem (caso seja utilizado um esquema de três níveis para imagens, como no registro de imagens integrado Red Hat OpenShift), {tag} é a tag desta versão da imagem):
./bin/docker-image-tool-upd.sh -f resource-managers/kubernetes/docker/src/main/dockerfiles/spark/Dockerfile -r {docker-registry-url}/{repo} -i {image-name} -t {tag} build
Faremos login no cluster OKD usando a ferramenta de console (aqui {OKD-API-URL} é a URL da API do cluster OKD):
oc login {OKD-API-URL}
Obteremos o token do usuário atual para autenticação no Docker Registry:
oc whoami -t
Faremos login no Docker Registry interno do cluster OKD (usamos o token obtido com o comando anterior como senha):
docker login {docker-registry-url}
Vamos carregar a imagem Docker criada no Docker Registry OKD:
./bin/docker-image-tool-upd.sh -r {docker-registry-url}/{repo} -i {image-name} -t {tag} push
Verificamos se a imagem criada está disponível no OKD. Para isso, abrimos no navegador a URL com a lista de imagens do projeto correspondente (aqui {project} é o nome do projeto dentro do cluster OpenShift, {OKD-WEBUI-URL} é a URL da console web do OpenShift) — https://{OKD-WEBUI-URL}/console/project/{project}/browse/images/{image-name}.
Para executar tarefas, deve ser criado uma conta de serviço com permissões para executar pods como root (discutiremos esse ponto mais adiante):
oc create sa spark -n {project}
oc adm policy add-scc-to-user anyuid -z spark -n {project}
Executaremos o comando spark-submit para publicar a tarefa Spark no cluster OKD, especificando a conta de serviço criada e a imagem Docker:
/opt/spark/bin/spark-submit --name spark-test --class org.apache.spark.examples.SparkPi --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} local:///opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar
Aqui:
--name — o nome da tarefa, que fará parte da construção do nome dos pods Kubernetes;
—class — classe do arquivo executável chamado ao iniciar a tarefa;
—conf — parâmetros de configuração do Spark;
spark.executor.instances — número de executores do Spark a serem iniciados;
spark.kubernetes.authenticate.driver.serviceAccountName — nome da conta de serviço Kubernetes usada ao iniciar os pods (para definir o contexto de segurança e as permissões ao interagir com a API do Kubernetes);
spark.kubernetes.namespace — espaço de nomes do Kubernetes onde os pods do driver e dos executores serão iniciados;
spark.submit.deployMode — modo de implantação do Spark (para o spark-submit padrão, usa-se «cluster», para o Spark Operator e versões mais recentes do Spark, usa-se «client»);
spark.kubernetes.container.image — imagem Docker usada para iniciar os pods;
spark.master — URL da API do Kubernetes (indica-se o acesso externo a partir da máquina local);
local:// — caminho para o arquivo executável do Spark dentro da imagem Docker.
Acesse o projeto correspondente do OKD e examine os pods criados — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods.
Para simplificar o processo de desenvolvimento, pode-se usar uma opção alternativa, onde uma imagem base do Spark é criada e utilizada por todas as tarefas para execução, e os snapshots dos arquivos executáveis são publicados em um armazenamento externo (por exemplo, Hadoop) e especificados ao chamar spark-submit como um link. Nesse caso, é possível executar diferentes versões das tarefas Spark sem recompilar as imagens Docker, utilizando, por exemplo, o WebHDFS para publicação das imagens. Enviamos uma solicitação para criar um arquivo (aqui {host} — host do serviço WebHDFS, {port} — porta do serviço WebHDFS, {path-to-file-on-hdfs} — caminho desejado para o arquivo no HDFS):
curl -i -X PUT "http://{host}:{port}/webhdfs/v1/{path-to-file-on-hdfs}?op=CREATE
Neste caso, uma resposta será recebida (aqui {location} — é a URL que deve ser usada para fazer o upload do arquivo):
HTTP/1.1 307 TEMPORARY_REDIRECT
Location: {location}
Content-Length: 0
Carregue o arquivo executável do Spark no HDFS (aqui {path-to-local-file} — caminho para o arquivo executável do Spark no host atual):
curl -i -X PUT -T {path-to-local-file} "{location}"
Depois disso, podemos fazer spark-submit usando o arquivo Spark carregado no HDFS (aqui {class-name} — nome da classe que deve ser iniciada para executar a tarefa):
/opt/spark/bin/spark-submit --name spark-test --class {class-name} --conf spark.executor.instances=3 --conf spark.kubernetes.authenticate.driver.serviceAccountName=spark --conf spark.kubernetes.namespace={project} --conf spark.submit.deployMode=cluster --conf spark.kubernetes.container.image={docker-registry-url}/{repo}/{image-name}:{tag} --conf spark.master=k8s://https://{OKD-API-URL} hdfs://{host}:{port}/{path-to-file-on-hdfs}
Vale ressaltar que o acesso ao HDFS e o funcionamento da tarefa podem exigir alterações no Dockerfile e no script entrypoint.sh — adicionar uma diretiva no Dockerfile para copiar bibliotecas dependentes para o diretório /opt/spark/jars e incluir o arquivo de configuração HDFS no SPARK_CLASSPATH no entrypoint.sh.
A segunda opção de uso é o Apache Livy
Além disso, quando a tarefa é desenvolvida e é necessário testar o resultado obtido, surge a questão de sua execução dentro do processo CI/CD e o monitoramento dos status de sua execução. Claro, você pode executá-la também com a chamada local spark-submit, mas isso complica a infraestrutura CI/CD, pois requer a instalação e configuração do Spark nos agentes/runners do servidor CI e configurações de acesso à API do Kubernetes. Para este caso, a solução escolhida foi usar o Apache Livy como uma API REST para iniciar tarefas Spark, hospedada dentro do cluster Kubernetes. Com ele, é possível executar tarefas Spark no cluster Kubernetes utilizando simples requisições cURL, o que é facilmente implementável em qualquer solução CI, e sua colocação dentro do cluster Kubernetes resolve a questão da autenticação ao interagir com a API do Kubernetes.
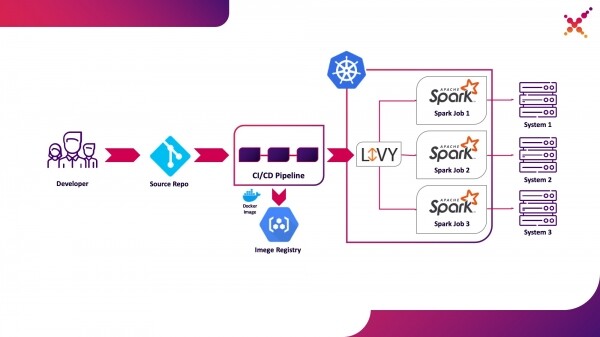
Vamos destacá-lo como a segunda opção de uso — a execução de tarefas Spark dentro do processo CI/CD em um cluster Kubernetes no ambiente de teste.
Um pouco sobre o Apache Livy — ele funciona como um servidor HTTP, proporcionando uma interface web e uma API RESTful, permitindo a execução remota de spark-submit, passando os parâmetros necessários. Tradicionalmente, ele vem como parte do pacote HDP, mas também pode ser implantado em OKD ou qualquer outra instalação do Kubernetes com o uso de um manifesto apropriado e um conjunto de imagens Docker, por exemplo, esta — . Para o nosso caso, uma imagem Docker semelhante foi construída, incluindo o Spark versão 2.4.5 deste Dockerfile:
FROM java:8-alpine

ENV SPARK_HOME=/opt/spark
ENV LIVY_HOME=/opt/livy
ENV HADOOP_CONF_DIR=/etc/hadoop/conf
ENV SPARK_USER=spark

WORKDIR /opt

RUN apk add --update openssl wget bash &&
    wget -P /opt https://downloads.apache.org/spark/spark-2.4.5/spark-2.4.5-bin-hadoop2.7.tgz &&
    tar xvzf spark-2.4.5-bin-hadoop2.7.tgz &&
    rm spark-2.4.5-bin-hadoop2.7.tgz &&
    ln -s /opt/spark-2.4.5-bin-hadoop2.7 /opt/spark

RUN wget http://mirror.its.dal.ca/apache/incubator/livy/0.7.0-incubating/apache-livy-0.7.0-incubating-bin.zip &&
    unzip apache-livy-0.7.0-incubating-bin.zip &&
    rm apache-livy-0.7.0-incubating-bin.zip &&
    ln -s /opt/apache-livy-0.7.0-incubating-bin /opt/livy &&
    mkdir /var/log/livy &&
    ln -s /var/log/livy /opt/livy/logs &&
    cp /opt/livy/conf/log4j.properties.template /opt/livy/conf/log4j.properties

ADD livy.conf /opt/livy/conf
ADD spark-defaults.conf /opt/spark/conf/spark-defaults.conf
ADD entrypoint.sh /entrypoint.sh

ENV PATH="/opt/livy/bin:${PATH}"

EXPOSE 8998

ENTRYPOINT ["/entrypoint.sh"]
CMD ["livy-server"]
A imagem criada pode ser compilada e carregada no seu repositório Docker existente, como o repositório interno OKD. Para a sua implantação, utiliza-se o seguinte manifesto ({registry-url} — URL do registro de imagens Docker, {image-name} — nome da imagem Docker, {tag} — etiqueta da imagem Docker, {livy-url} — URL desejada para o acesso ao servidor Livy; o manifesto "Route" é aplicado se a distribuição do Kubernetes em uso for o Red Hat OpenShift, caso contrário, usa-se o manifesto correspondente Ingress ou Service do tipo NodePort):
---
apiVersion: apps/v1
kind: Deployment
metadata:
  labels:
    component: livy
  name: livy
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      component: livy
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        component: livy
    spec:
      containers:
        - command:
            - livy-server
          env:
            - name: K8S_API_HOST
              value: localhost
            - name: SPARK_KUBERNETES_IMAGE
              value: 'gnut3ll4/spark:v1.0.14'
          image: '{registry-url}/{image-name}:{tag}'
          imagePullPolicy: Always
          name: livy
          ports:
            - containerPort: 8998
              name: livy-rest
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
          volumeMounts:
            - mountPath: /var/log/livy
              name: livy-log
            - mountPath: /opt/.livy-sessions/
              name: livy-sessions
            - mountPath: /opt/livy/conf/livy.conf
              name: livy-config
              subPath: livy.conf
            - mountPath: /opt/spark/conf/spark-defaults.conf
              name: spark-config
              subPath: spark-defaults.conf
        - command:
            - /usr/local/bin/kubectl
            - proxy
            - '--port'
            - '8443'
          image: 'gnut3ll4/kubectl-sidecar:latest'
          imagePullPolicy: Always
          name: kubectl
          ports:
            - containerPort: 8443
              name: k8s-api
              protocol: TCP
          resources: {}
          terminationMessagePath: /dev/termination-log
          terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      serviceAccount: spark
      serviceAccountName: spark
      terminationGracePeriodSeconds: 30
      volumes:
        - emptyDir: {}
          name: livy-log
        - emptyDir: {}
          name: livy-sessions
        - configMap:
            defaultMode: 420
            items:
              - key: livy.conf
                path: livy.conf
            name: livy-config
          name: livy-config
        - configMap:
            defaultMode: 420
            items:
              - key: spark-defaults.conf
                path: spark-defaults.conf
            name: livy-config
          name: spark-config
---
apiVersion: v1
kind: ConfigMap
metadata:
  name: livy-config
data:
  livy.conf: |-
    livy.spark.deploy-mode=cluster
    livy.file.local-dir-whitelist=/opt/.livy-sessions/
    livy.spark.master=k8s://http://localhost:8443
    livy.server.session.state-retain.sec = 8h
  spark-defaults.conf: 'spark.kubernetes.container.image        "gnut3ll4/spark:v1.0.14"'
---
apiVersion: v1
kind: Service
metadata:
  labels:
    app: livy
  name: livy
spec:
  ports:
    - name: livy-rest
      port: 8998
      protocol: TCP
      targetPort: 8998
  selector:
    component: livy
  sessionAffinity: None
  type: ClusterIP
---
apiVersion: route.openshift.io/v1
kind: Route
metadata:
  labels:
    app: livy
  name: livy
spec:
  host: {livy-url}
  port:
    targetPort: livy-rest
  to:
    kind: Service
    name: livy
    weight: 100
  wildcardPolicy: None
Após sua aplicação e o lançamento bem-sucedido do pod, a interface gráfica do Livy está disponível através do link: http://{livy-url}/ui. Com o Livy, podemos publicar nossa tarefa Spark utilizando uma solicitação REST, por exemplo, a partir do Postman. Um exemplo de coleção com as solicitações está apresentado abaixo (no array "args" podem ser enviados argumentos de configuração com as variáveis necessárias para o funcionamento da tarefa em execução):
{
    "info": {
        "_postman_id": "be135198-d2ff-47b6-a33e-0d27b9dba4c8",
        "name": "Spark Livy",
        "schema": "https://schema.getpostman.com/json/collection/v2.1.0/collection.json"
    },
    "item": [
        {
            "name": "1 Enviar trabalho com jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"local://opt/spark/examples/target/scala-2.11/jars/spark-examples_2.11-2.4.5.jar\", nt\"className\": \"org.apache.spark.examples.SparkPi\",nt\"numExecutors\":1,nt\"name\": \"spark-test-1\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt}n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        },
        {
            "name": "2 Enviar trabalho sem jar",
            "request": {
                "method": "POST",
                "header": [
                    {
                        "key": "Content-Type",
                        "value": "application/json"
                    }
                ],
                "body": {
                    "mode": "raw",
                    "raw": "{nt\"file\": \"hdfs://{host}:{port}/{path-to-file-on-hdfs}\", nt\"className\": \"{class-name}\",nt\"numExecutors\":1,nt\"name\": \"spark-test-2\",nt\"proxyUser\": \"0\",nt\"conf\": {ntt\"spark.jars.ivy\": \"/tmp/.ivy\",ntt\"spark.kubernetes.authenticate.driver.serviceAccountName\": \"spark\",ntt\"spark.kubernetes.namespace\": \"{project}\",ntt\"spark.kubernetes.container.image\": \"{docker-registry-url}/{repo}/{image-name}:{tag}\"nt},nt\"args\": [ntt\"HADOOP_CONF_DIR=/opt/spark/hadoop-conf\",ntt\"MASTER=k8s://https://kubernetes.default.svc:8443\"nt]n}"
                },
                "url": {
                    "raw": "http://{livy-url}/batches",
                    "protocol": "http",
                    "host": [
                        "{livy-url}"
                    ],
                    "path": [
                        "batches"
                    ]
                }
            },
            "response": []
        }
    ],
    "event": [
        {
            "listen": "prerequest",
            "script": {
                "id": "41bea1d0-278c-40c9-ad42-bf2e6268897d",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        },
        {
            "listen": "test",
            "script": {
                "id": "3cdd7736-a885-4a2d-9668-bd75798f4560",
                "type": "text/javascript",
                "exec": [
                    ""
                ]
            }
        }
    ],
    "protocolProfileBehavior": {}
}
Execute a primeira solicitação da coleção, acesse a interface OKD e verifique se a tarefa foi iniciada com sucesso — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods. Ao mesmo tempo, na interface do Livy (http://{livy-url}/ui) uma sessão aparecerá, onde, através da API do Livy ou da interface gráfica, você poderá acompanhar o progresso da execução da tarefa e examinar os logs da sessão.
Agora vamos mostrar o mecanismo de funcionamento do Livy. Para isso, vamos analisar os logs do contêiner Livy dentro do pod com o servidor Livy — https://{OKD-WEBUI-URL}/console/project/{project}/browse/pods/{livy-pod-name}?tab=logs. Neles, é possível ver que ao chamar a API REST Livy no contêiner nomeado como "livy" é executado um spark-submit, semelhante ao que utilizamos acima (aqui {livy-pod-name} é o nome do pod criado com o servidor Livy). A coleção também apresenta uma segunda solicitação, permitindo que tarefas sejam iniciadas com o arquivo executável do Spark remoto usando o servidor Livy.
A terceira opção de uso é o Spark Operator
Agora que a tarefa foi testada, surge a questão de sua execução regular. A maneira nativa de realizar a execução regular de tarefas em um cluster Kubernetes é a entidade CronJob, e ela pode ser utilizada, mas atualmente o uso de operadores para gerenciar aplicativos no Kubernetes é bastante popular, e para o Spark existe um operador suficientemente maduro, que é utilizado em soluções de nível Enterprise (por exemplo, Lightbend FastData Platform). Recomendamos seu uso — a versão estável atual do Spark (2.4.5) possui recursos bastante limitados para configurar a execução de tarefas Spark no Kubernetes, enquanto que na próxima versão principal (3.0.0) está prevista a suporte total ao Kubernetes, mas a data de seu lançamento permanece desconhecida. O Spark Operator compensa essa limitação, adicionando parâmetros de configuração importantes (por exemplo, montagem de ConfigMap com a configuração de acesso ao Hadoop nos pods Spark) e a possibilidade de executar tarefas regularmente com um cronograma.
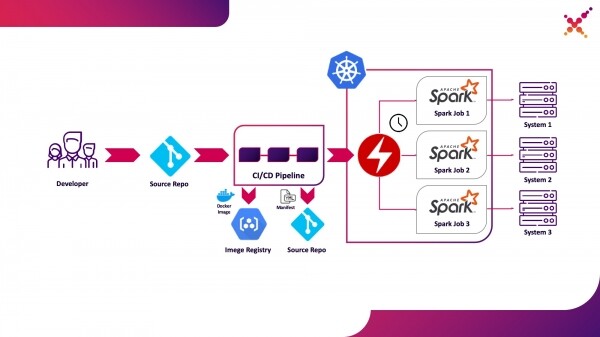
Destacamos ele como a terceira opção de uso — execução regular de tarefas Spark no cluster Kubernetes em produção.
O Spark Operator possui código aberto e é desenvolvido no Google Cloud Platform — . Sua instalação pode ser realizada de 3 maneiras:
- No âmbito da instalação da Lightbend FastData Platform/Cloudflow;
- Usando Helm:
helm repo add incubator http://storage.googleapis.com/kubernetes-charts-incubator helm install incubator/sparkoperator --namespace spark-operator - Usando manifestos do repositório oficial (https://github.com/GoogleCloudPlatform/spark-on-k8s-operator/tree/master/manifest). É importante notar que o Cloudflow contém um operador com a versão da API v1beta1. Se esse tipo de instalação for utilizado, as descrições dos manifestos das aplicações Spark devem ser elaboradas com base nos exemplos das tags no Git com a versão da API correspondente, por exemplo, "v1beta1-0.9.0-2.4.0". A versão do operador pode ser verificada na descrição do CRD que faz parte do operador no dicionário "versions":
oc get crd sparkapplications.sparkoperator.k8s.io -o yaml
Se o operador estiver instalado corretamente, um pod ativo com o operador Spark aparecerá no projeto correspondente (por exemplo, cloudflow-fdp-sparkoperator no espaço Cloudflow para a instalação do Cloudflow) e um tipo de recurso Kubernetes com o nome "sparkapplications" será criado. As aplicações Spark disponíveis podem ser visualizadas com o seguinte comando:
oc get sparkapplications -n {project}
Para executar tarefas com o Spark Operator, é necessário realizar 3 etapas:
- criar uma imagem Docker que inclua todas as bibliotecas necessárias, bem como os arquivos de configuração e executáveis. No cenário alvo, esta imagem é criada na fase CI/CD e testada em um cluster de teste;
- publicar a imagem Docker em um registro acessível a partir do cluster Kubernetes;
- elaborar um manifesto com o tipo "SparkApplication" e a descrição da tarefa a ser executada. Exemplos de manifestos estão disponíveis no repositório oficial (por exemplo, ). É importante notar alguns pontos sobre o manifesto:
- no dicionário "apiVersion", deve ser especificada a versão da API correspondente à versão do operador;
- no dicionário "metadata.namespace", deve ser indicado o espaço de nomes onde a aplicação será executada;
- no dicionário "spec.image", deve ser fornecido o endereço da imagem Docker criada no registro acessível;
- no dicionário "spec.mainClass", deve ser indicado o classe da tarefa Spark que deve ser executada ao iniciar o processo;
- no dicionário "spec.mainApplicationFile", deve ser especificado o caminho para o arquivo jar executável;
- no dicionário "spec.sparkVersion", deve ser indicada a versão do Spark utilizada;
- no dicionário "spec.driver.serviceAccount", deve ser indicada a conta de serviço dentro do espaço de nomes Kubernetes correspondente, que será utilizada para executar a aplicação;
- no dicionário "spec.executor", deve ser indicado o número de recursos alocados para a aplicação;
- No dicionário «spec.volumeMounts», deve ser especificado o diretório local onde os arquivos locais da tarefa Spark serão criados.
Exemplo de formação do manifesto (aqui {spark-service-account} é a conta de serviço dentro do cluster Kubernetes para executar tarefas Spark):
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 0.1
    coreLimit: "200m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: {spark-service-account}
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
Neste manifesto, foi especificada uma conta de serviço, para a qual é necessário criar as associações de funções necessárias antes de publicar o manifesto, fornecendo as permissões necessárias para a interação do aplicativo Spark com a API do Kubernetes (se necessário). No nosso caso, o aplicativo precisa de permissões para criar Pods. Vamos criar a associação de função necessária:
oc adm policy add-role-to-user edit system:serviceaccount:{project}:{spark-service-account} -n {project}
Vale ressaltar que na especificação deste manifesto pode ser especificado o parâmetro «hadoopConfigMap», que permite indicar um ConfigMap com a configuração do Hadoop sem a necessidade de colocar o arquivo correspondente na imagem Docker previamente. Ele também é adequado para a execução regular de tarefas — com o parâmetro «schedule», pode ser indicado o cronograma para a execução desta tarefa.
Depois disso, salvamos nosso manifesto no arquivo spark-pi.yaml e o aplicamos ao nosso cluster Kubernetes:
oc apply -f spark-pi.yaml
Isso resultará na criação de um objeto do tipo «sparkapplications»:
oc get sparkapplications -n {project}
> NAME       AGE
> spark-pi   22h
Isso resultará na criação de um pod com o aplicativo, cujo status será exibido no «sparkapplications» criado. Isso pode ser visto com o seguinte comando:
oc get sparkapplications spark-pi -o yaml -n {project}
Após a conclusão da tarefa, o POD mudará para o status «Completed», que também será atualizado no «sparkapplications». Os logs do aplicativo podem ser visualizados no navegador ou com o seguinte comando (aqui {sparkapplications-pod-name} é o nome do pod da tarefa executada):
oc logs {sparkapplications-pod-name} -n {project}
A gestão de tarefas do Spark também pode ser realizada com a ajuda da ferramenta especializada sparkctl. Para instalar, clonamos o repositório com seu código-fonte, instalamos o Go e compilamos a ferramenta:
git clone https://github.com/GoogleCloudPlatform/spark-on-k8s-operator.git
cd spark-on-k8s-operator/
wget https://dl.google.com/go/go1.13.3.linux-amd64.tar.gz
tar -xzf go1.13.3.linux-amd64.tar.gz
sudo mv go /usr/local
mkdir $HOME/Projects
export GOROOT=/usr/local/go
export GOPATH=$HOME/Projects
export PATH=$GOPATH/bin:$GOROOT/bin:$PATH
go version
cd sparkctl
go build -o sparkctl
sudo mv sparkctl /usr/local/bin
Vamos examinar a lista de tarefas do Spark em execução:
sparkctl list -n {project}
Vamos criar uma descrição para a tarefa Spark:
vi spark-app.yaml
apiVersion: "sparkoperator.k8s.io/v1beta1"
kind: SparkApplication
metadata:
  name: spark-pi
  namespace: {project}
spec:
  type: Scala
  mode: cluster
  image: "gcr.io/spark-operator/spark:v2.4.0"
  imagePullPolicy: Always
  mainClass: org.apache.spark.examples.SparkPi
  mainApplicationFile: "local:///opt/spark/examples/jars/spark-examples_2.11-2.4.0.jar"
  sparkVersion: "2.4.0"
  restartPolicy:
    type: Never
  volumes:
    - name: "test-volume"
      hostPath:
        path: "/tmp"
        type: Directory
  driver:
    cores: 1
    coreLimit: "1000m"
    memory: "512m"
    labels:
      version: 2.4.0
    serviceAccount: spark
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
  executor:
    cores: 1
    instances: 1
    memory: "512m"
    labels:
      version: 2.4.0
    volumeMounts:
      - name: "test-volume"
        mountPath: "/tmp"
Vamos iniciar a tarefa descrita com o sparkctl:
sparkctl create spark-app.yaml -n {project}
Vamos examinar a lista de tarefas do Spark em execução:
sparkctl list -n {project}
Vamos examinar a lista de eventos da tarefa Spark em execução:
sparkctl event spark-pi -n {project} -f
Vamos verificar o status da tarefa Spark em execução:
sparkctl status spark-pi -n {project}
Por fim, gostaríamos de discutir as desvantagens identificadas na utilização da versão estável atual do Spark (2.4.5) no Kubernetes:
- O primeiro e, provavelmente, o principal ponto negativo é a ausência de Localidade de Dados. Embora houvesse desvantagens no YARN, também havia vantagens em seu uso, como o princípio de entrega de código para os dados (em vez de dados para o código). Graças a isso, as tarefas do Spark eram executadas nos nós onde os dados estavam localizados, o que reduzia significativamente o tempo de transporte de dados pela rede. Ao usar o Kubernetes, enfrentamos a necessidade de mover pela rede dados envolvidos no trabalho da tarefa. Se esses dados forem grandes o suficiente, o tempo de execução da tarefa pode aumentar significativamente, além de exigir uma grande quantidade de espaço em disco alocado para as instâncias da tarefa Spark para armazenamento temporário. Essa desvantagem pode ser mitigada pelo uso de software especializado que proporciona a localidade de dados no Kubernetes (como o Alluxio), mas isso basicamente significa que é necessário manter uma cópia completa dos dados nos nós do cluster Kubernetes.
- O segundo ponto negativo importante é a segurança. Por padrão, as funções relacionadas à segurança no lançamento de tarefas do Spark estão desativadas, a opção de uso do Kerberos na documentação oficial não é abordada (embora os parâmetros correspondentes tenham aparecido na versão 3.0.0, o que exigirá um trabalho adicional), e na documentação sobre segurança ao usar o Spark (https://spark.apache.org/docs/2.4.5/security.html) os únicos repositórios de chaves mencionados são YARN, Mesos e Standalone Cluster. Além disso, o usuário sob o qual as tarefas do Spark são executadas não pode ser especificado diretamente — apenas definimos a conta de serviço sob a qual o Pod irá operar, e o usuário é escolhido com base nas políticas de segurança configuradas. Devido a isso, ou se utiliza o usuário root, o que não é seguro em um ambiente de produção, ou um usuário com UID aleatório, o que é inconveniente ao distribuir permissões de acesso aos dados (resolvível com a criação de PodSecurityPolicies e sua vinculação às contas de serviço correspondentes). Atualmente, a solução é colocar todos os arquivos necessários diretamente na imagem do Docker ou modificar o script de inicialização do Spark para usar o mecanismo de armazenamento e recuperação de segredos adotado pela sua organização.
- A execução de tarefas Spark usando Kubernetes ainda está oficialmente em modo experimental e no futuro podem haver mudanças significativas nos artefatos utilizados (arquivos de configuração, imagens de Docker e scripts de execução). De fato — ao preparar o material, foram testadas as versões 2.3.0 e 2.4.5, e o comportamento variou consideravelmente.
Vamos aguardar atualizações — recentemente foi lançada uma nova versão do Spark (3.0.0), que trouxe mudanças significativas no funcionamento do Spark no Kubernetes, mas manteve o status experimental do suporte a este gerenciador de recursos. É possível que as próximas atualizações realmente permitam recomendar a migração completa do YARN e a execução das tarefas Spark no Kubernetes, sem receios pela segurança do seu sistema e sem necessidade de adaptações manuais dos componentes funcionais.
Fim.
Fonte: habr.com
