

O teorema CAP é a pedra angular da teoria dos sistemas distribuídos. Claro, os debates sobre isso não cessam: as definições não são canônicas e não há uma prova rigorosa... No entanto, firmemente baseado na sensatez comum™, entendemos intuitivamente que a teorema está correta.
A única coisa que não é óbvia é o significado da letra "P". Quando o cluster se divide, ele decide – ou não responder até que um quórum seja alcançado, ou fornecer os dados que possui. Dependendo dos resultados dessa escolha, o sistema é classificado como CP ou AP. O Cassandra, por exemplo, pode se comportar de ambas as maneiras, dependendo não apenas das configurações do cluster, mas dos parâmetros de cada solicitação específica. Mas se o sistema não é "P", e ele se dividiu, então – o que acontece?
A resposta para essa pergunta é um pouco inesperada: um cluster CA não pode se dividir.
Que tipo de cluster é esse que não pode se dividir?
Um atributo essencial desse cluster é um sistema de armazenamento de dados comum. Na esmagadora maioria dos casos, isso significa conexão via SAN, o que limita a aplicação de soluções CA a grandes empresas capazes de manter uma infraestrutura SAN. Para que vários servidores possam trabalhar com os mesmos dados, é necessário um sistema de arquivos em cluster. Esses sistemas de arquivos estão disponíveis nos portfólios da HPE (CFS), Veritas (VxCFS) e IBM (GPFS).
Oracle RAC
A opção Real Application Cluster apareceu pela primeira vez em 2001 no lançamento do Oracle 9i. Em tal cluster, vários instâncias servidor trabalham com o mesmo banco de dados.
A Oracle pode operar tanto com um sistema de arquivos em cluster quanto com sua própria solução – ASM, Automatic Storage Management.
Cada instância mantém seu próprio log. A transação é realizada e registrada por uma instância. Em caso de falha de uma instância, um dos nós sobreviventes do cluster (instâncias) lê seu log e recupera os dados perdidos – é assim que a disponibilidade é garantida.
Todas as instâncias mantêm seu próprio cache, e as mesmas páginas (blocos) podem estar simultaneamente nos caches de várias instâncias. Além disso, se uma página for necessária para uma instância, e ela estiver no cache de outra instância, ela pode obtê-la do "vizinho" por meio do mecanismo de fusão de cache em vez de ler do disco.
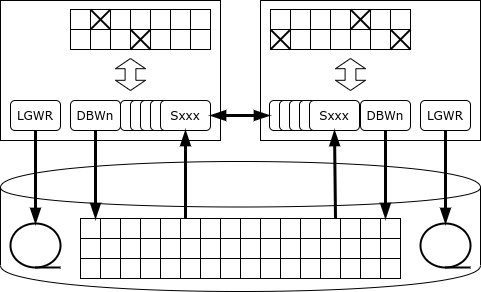
Mas o que acontece se um dos nós precisar modificar dados?
A característica do Oracle é que ele não possui um serviço de bloqueio dedicado: se o servidor deseja bloquear uma linha, o registro do bloqueio é colocado diretamente na página de memória onde a linha bloqueada reside. Graças a essa abordagem, o Oracle é campeão em desempenho entre bancos de dados monolíticos: o serviço de bloqueio nunca se torna um gargalo. No entanto, em uma configuração de cluster, essa arquitetura pode levar a uma troca intensa de rede e bloqueios mútuos.
Assim que um registro é bloqueado, o nó notifica todos os outros nós que a página em que esse registro está armazenado foi capturada em modo monopolista. Se outro nó precisar modificar o registro na mesma página, ele deve aguardar até que as alterações na página sejam confirmadas, ou seja, a informação sobre a alteração deve ser registrada no log no disco (durante isso, a transação pode continuar). Também pode ocorrer que a página seja modificada sequencialmente por vários nós, e nesse caso, ao escrever a página no disco, será necessário determinar quem possui a versão atual dessa página.
Atualizações aleatórias das mesmas páginas através de diferentes nós RAC resultam em uma queda acentuada no desempenho do banco de dados – a ponto de o desempenho do cluster ser inferior ao de um único nó.
O uso correto do Oracle RAC é o particionamento físico dos dados (por exemplo, através do mecanismo de tabelas particionadas) e o acesso a cada conjunto de partições através de um nó dedicado. O principal objetivo do RAC não se tornou escalabilidade horizontal, mas sim garantir a resistência a falhas.
Se um nó parar de responder ao heartbeat, o nó que detectar isso primeiro inicia o procedimento de votação no disco. Se mesmo assim o nó ausente não der sinal, um dos nós assume a responsabilidade de recuperar os dados:
- «congela» todas as páginas que estavam no cache do nó ausente;
- lê os logs (redo) do nó ausente e reaplica as alterações registradas nesses logs, ao mesmo tempo verificando se outros nós têm versões mais recentes das páginas modificadas;
- reverte transações incompletas.
Para facilitar a mudança entre nós, o Oracle introduziu o conceito de serviço – uma instância virtual. A instância pode atender a vários serviços, e um serviço pode ser transferido entre nós. Uma instância de aplicativo que atende a uma parte específica do banco (por exemplo, um grupo de clientes) opera com um serviço, enquanto o serviço responsável por essa parte do banco se transfere para outro nó em caso de falha do nó.
IBM Pure Data Systems for Transactions
A solução de cluster para bancos de dados surgiu no portfólio do Gigante Azul em 2009. Ideologicamente, é um sucessor do cluster Parallel Sysplex, construído em hardware 'comum'. O produto DB2 pureScale foi lançado em 2009 como um conjunto de software, e em 2012 a IBM apresentou um conjunto de hardware/software conhecido como Pure Data Systems for Transactions. Não deve ser confundido com o Pure Data Systems for Analytics, que é nada mais que um renomeado Netezza.
A arquitetura pureScale, à primeira vista, se assemelha ao Oracle RAC: vários nós estão conectados a um sistema de armazenamento de dados compartilhado, e em cada nó opera sua própria instância do banco de dados com suas áreas de memória e logs de transações. Porém, ao contrário do Oracle, no DB2 há um serviço dedicado de bloqueio, representado por um conjunto de processos db2LLM*. Na configuração de cluster, esse serviço é movido para um nó separado, que no Parallel Sysplex é chamado de coupling facility (CF), e no Pure Data – PowerHA.
PowerHA fornece os seguintes serviços:
- gerenciador de bloqueios;
- cache global em buffer;
- área de comunicação entre processos.
Para transferir dados entre o PowerHA e os nós do banco de dados e vice-versa, usa-se acesso remoto à memória, portanto, a interconexão do cluster deve suportar o protocolo RDMA. O PureScale pode usar tanto Infiniband quanto RDMA sobre Ethernet.
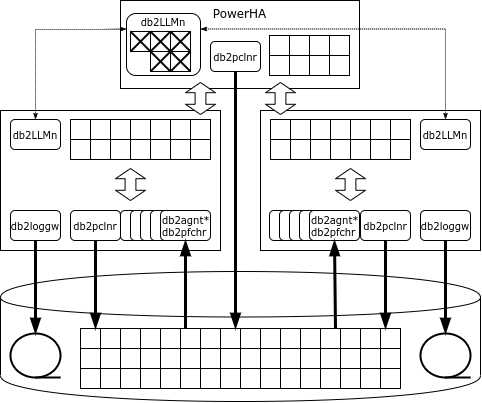
Se um nó precisa de uma página e essa página não está no cache, o nó solicita a página no cache global, e somente se ela também não estiver lá, a lê do disco. Diferente do Oracle, a solicitação vai exclusivamente para o PowerHA, e não para nós vizinhos.
Se uma instância estiver prestes a modificar uma linha, ela bloqueia a linha em modo exclusivo e a página que contém a linha em modo compartilhado. Todos os bloqueios são registrados no gerenciador de bloqueios global. Quando a transação é concluída, o nó envia uma mensagem para o gerenciador de bloqueios, que copia a página alterada para o cache global, libera os bloqueios e invalida a página alterada nos caches de outros nós.
Se a página que contém a linha modificável já estiver bloqueada, o gerenciador de bloqueios lerá a página alterada da memória do nó que fez as alterações, liberará o bloqueio, invalidará a página alterada nos caches de outros nós e concederá o bloqueio da página ao nó que a solicitou.
Páginas "sujas", ou seja, modificadas, podem ser gravadas no disco tanto de um nó comum quanto de um PowerHA (castout).
Em caso de falha de um dos nós pureScale, a recuperação é limitada apenas às transações que não foram concluídas no momento da falha: as páginas modificadas por esse nó em transações já concluídas estão no cache global no PowerHA. O nó é reiniciado em uma configuração reduzida em um dos servidores do cluster, reverte transações não concluídas e libera bloqueios.
O PowerHA opera em dois servidores, e o nó principal replica seu estado de forma síncrona. Em caso de falha do nó principal, o cluster PowerHA continua funcionando com o nó de backup.
Claro, se você acessar o conjunto de dados através de um único nó, o desempenho geral do cluster será melhor. O PureScale pode até notar que uma determinada área de dados está sendo processada por um nó, e então todos os bloqueios relacionados a essa área serão tratados localmente pelo nó, sem comunicação com o PowerHA. Mas assim que o aplicativo tentar acessar esses dados através de outro nó, o processamento centralizado dos bloqueios será retomado.
Os testes internos da IBM com uma carga composta de 90% de leitura e 10% de escrita, que se assemelha bastante a cargas industriais reais, mostram quase uma escalabilidade linear até 128 nós. Infelizmente, as condições de teste não são divulgadas.
HPE NonStop SQL
A sua própria plataforma de alta disponibilidade também está no portfólio da Hewlett-Packard Enterprise. Esta é a plataforma NonStop, lançada no mercado em 1976 pela Tandem Computers. Em 1997, a empresa foi adquirida pela Compaq, que, por sua vez, se fundiu com a Hewlett-Packard em 2002.
O NonStop é utilizado para construir aplicações críticas – como HLR ou processamento de cartões bancários. A plataforma é oferecida como um sistema integrado (appliance), incluindo nós de computação, sistema de armazenamento de dados e equipamentos de comunicação. A rede ServerNet (nas versões modernas – Infiniband) serve tanto para a troca entre nós quanto para o acesso ao sistema de armazenamento de dados.
Em versões anteriores do sistema, eram utilizados processadores proprietários que eram sincronizados entre si: todas as operações eram executadas de forma síncrona por vários processadores, e assim que um dos processadores falhava, ele era desligado, enquanto o segundo continuava funcionando. Posteriormente, o sistema adotou processadores comuns (primeiro MIPS, depois Itanium e, finalmente, x86), e outros mecanismos passaram a ser usados para sincronização:
- mensagens: cada processo do sistema possui um duplicado chamado “sombra”, que recebe periodicamente mensagens do processo ativo sobre seu estado; em caso de falha do processo principal, o processo sombra inicia sua operação a partir do ponto definido pela última mensagem;
- votação: o sistema de armazenamento de dados possui um componente de hardware especial que aceita várias solicitações idênticas e as executa somente se as solicitações coincidirem; em vez de sincronização física, os processadores operam de forma assíncrona, e os resultados de seu trabalho são comparados apenas em momentos de entrada/saída.
Desde 1987, a plataforma NonStop opera com um SGBD relacional – primeiro o SQL/MP e, mais tarde, o SQL/MX.
Toda a base de dados é dividida em partes, e cada parte é gerida por seu próprio processo Data Access Manager (DAM). Ele garante a gravação de dados, o cache e o mecanismo de bloqueios. O processamento de dados é realizado por processos executores (Executor Server Process), que operam nos mesmos nós que os respectivos gerentes de dados. O planejador SQL/MX distribui tarefas entre os executores e combina os resultados. Quando é necessário fazer mudanças consensuais, utiliza-se um protocolo de confirmação em duas fases, garantido pela biblioteca TMF (Transaction Management Facility).
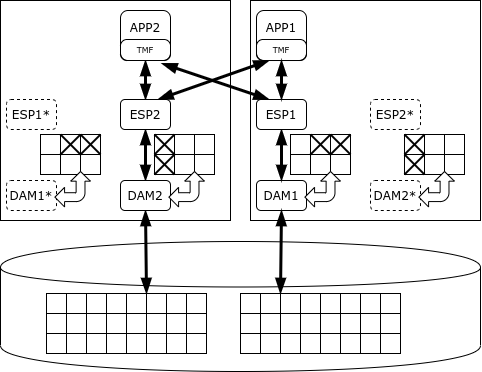
O NonStop SQL é capaz de priorizar processos de modo que longas consultas analíticas não interfiram na execução de transações. No entanto, seu propósito é exatamente o processamento de transações curtas, e não a análise. O desenvolvedor garante a disponibilidade do cluster NonStop em um nível de cinco “nove”, ou seja, a inatividade totaliza apenas 5 minutos por ano.
SAP HANA
O primeiro lançamento estável do SGBD HANA (1.0) ocorreu em novembro de 2010, e o pacote SAP ERP migrou para HANA em maio de 2013. A plataforma baseia-se em tecnologias adquiridas: TREX Search Engine (busca em repositórios de colunas), SGBD P*TIME e MAX DB.
A própria palavra “HANA” é um acrônimo para High performance ANalytical Appliance. Este SGBD é fornecido na forma de código, que pode ser executado em qualquer servidor x86, porém, as instalações industriais são permitidas apenas em equipamentos certificadas. Existem soluções da HP, Lenovo, Cisco, Dell, Fujitsu, Hitachi, NEC. Algumas configurações da Lenovo permitem até mesmo a operação sem SAN – o cluster GPFS nos discos locais desempenha o papel de armazenamento compartilhado.
Diferentemente das plataformas mencionadas acima, a HANA é um SGBD em memória, ou seja, a imagem primária dos dados é armazenada na memória RAM, e no disco são gravados apenas os registros e instantâneas periódicas – para recuperação em caso de falha.
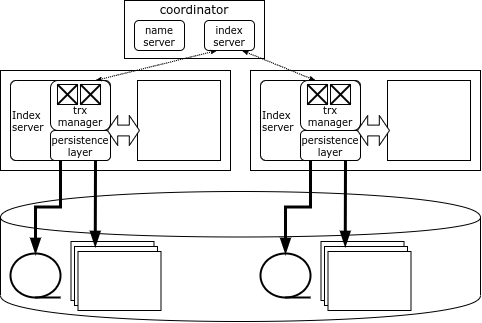
Cada nó do cluster HANA é responsável por sua parte dos dados, e o mapa de dados é armazenado em um componente especial – Name Server, localizado no nó coordenador. Os dados não são duplicados entre os nós. As informações sobre bloqueios também são armazenadas em cada nó, mas há um detector global de bloqueios mútuos no sistema.
O cliente HANA, ao se conectar ao cluster, carrega sua topologia e pode posteriormente se conectar diretamente a qualquer nó, dependendo dos dados que ele precisa. Se a transação envolver dados de um único nó, ela pode ser executada localmente por esse nó. No entanto, se os dados de vários nós forem alterados, o nó iniciador consulta o nó coordenador, que abre e coordena a transação distribuída, fixando-a por meio de um protocolo otimizado de dois estágios.
O nó coordenador é duplicado, portanto, se o coordenador falhar, o nó de reserva entra em operação imediatamente. No entanto, se um nó com dados falhar, a única maneira de acessar seus dados é reiniciar o nó. Normalmente, em clusters HANA, um servidor de reserva é mantido para reiniciar o nó perdido o mais rapidamente possível.
Fonte: habr.com
