

Embora haja muitos dados quase em todos os lugares agora, os bancos de dados analíticos ainda são bastante exóticos. Eles são pouco conhecidos e ainda mais difíceis de usar de forma eficaz. Muitos ainda continuam a "mastigar cacto" com MySQL ou PostgreSQL, que foram projetados para outros cenários, a sofrer com NoSQL ou a pagar demais por soluções comerciais. O ClickHouse muda as regras do jogo e reduz significativamente a barreira de entrada no mundo dos SGBDs analíticos.
Apresentação da BackEnd Conf 2018 e publicada com a permissão do palestrante.
Quem sou eu e por que estou falando sobre ClickHouse? Sou diretor de desenvolvimento na empresa LifeStreet, que utiliza ClickHouse. Além disso, sou fundador da Altinity. É um parceiro da Yandex que promove ClickHouse e ajuda a Yandex a torná-lo mais bem-sucedido. Também estou disposto a compartilhar conhecimentos sobre ClickHouse.
E ainda não sou irmão de Petya Zaitsev. Frequentemente perguntam-me sobre isso. Não, não somos irmãos.
«É de conhecimento geral» que ClickHouse:
- É muito rápido,
- É muito conveniente,
- É usado na Yandex.
É menos conhecido em quais empresas e como ele é utilizado.
Vou contar a vocês para que, onde e como o ClickHouse é usado, além da Yandex.
Vou explicar como tarefas específicas são resolvidas usando o ClickHouse em diferentes empresas, quais ferramentas ClickHouse você pode usar para suas tarefas e como elas foram utilizadas em várias empresas.
Escolhi três exemplos que mostram o ClickHouse de diferentes perspectivas. Acho que será interessante.
A primeira pergunta: «Por que usar ClickHouse?». Parece que a pergunta é bastante óbvia, mas as respostas são mais de uma.
- A primeira resposta é por causa do desempenho. ClickHouse é muito rápido. A análise no ClickHouse também é muito rápida. Ele pode ser usado frequentemente onde algo mais funciona muito lentamente ou muito mal.
- A segunda resposta é o custo. E, em primeiro lugar, o custo de escalonamento. Por exemplo, o Vertica é um banco de dados excelente. Funciona muito bem se você não tiver muitos terabytes de dados. Mas, quando se trata de centenas de terabytes ou petabytes, o custo da licença e do suporte chega a uma quantia bastante significativa. E isso é caro. E o ClickHouse é gratuito.
- A terceira resposta é o custo operacional. Este é um enfoque um pouco diferente. RedShift é uma excelente alternativa. No RedShift, é possível criar soluções muito rapidamente. Elas funcionarão bem, mas a cada hora, cada dia e cada mês, você pagará um valor considerável à Amazon, pois é um serviço bastante caro. O Google BigQuery também. Quem já o utilizou sabe que é possível executar várias consultas e, de repente, receber uma fatura de centenas de dólares.
No ClickHouse, esses problemas não existem.
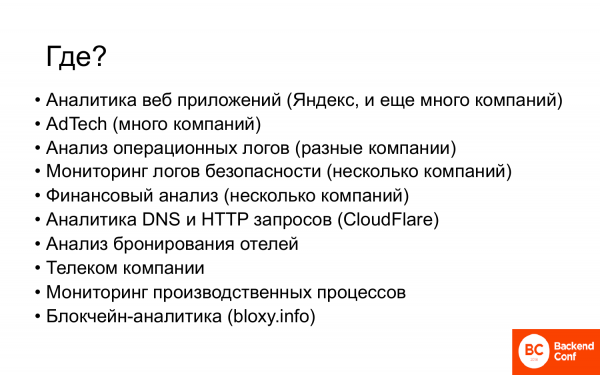
Onde o ClickHouse é utilizado atualmente? Além da Yandex, o ClickHouse é utilizado em uma série de diferentes negócios e empresas.
- Em primeiro lugar, é a análise de aplicações web, ou seja, é um caso de uso que veio da Yandex.
- Muitas empresas de AdTech utilizam o ClickHouse.
- Inúmeras empresas que precisam analisar logs operacionais de diversas fontes.
- Algumas empresas utilizam o ClickHouse para monitorar logs de segurança. Elas os carregam no ClickHouse, geram relatórios e obtêm os resultados necessários.
- As empresas começaram a utilizá-lo na análise financeira, ou seja, gradativamente, grandes negócios também estão se aproximando do ClickHouse.
- CloudFlare. Quem acompanha o ClickHouse certamente já ouviu o nome dessa empresa. É um dos contribuintes significativos da comunidade. E eles possuem uma instalação de ClickHouse bastante robusta. Por exemplo, eles criaram o Kafka Engine para o ClickHouse.
- As empresas de telecomunicações começaram a usar. Algumas empresas utilizam o ClickHouse ou como prova de conceito ou já em produção.
- Uma empresa utiliza o ClickHouse para monitorar processos produtivos. Elas testam chips, anotam uma série de parâmetros, cerca de 2.000 características, e depois analisam – é um bom lote ou um ruim.
- Análise de blockchain. Existe uma empresa russa chamada Bloxy.info. Eles fazem análise da rede Ethereum. Isso também foi feito no ClickHouse.
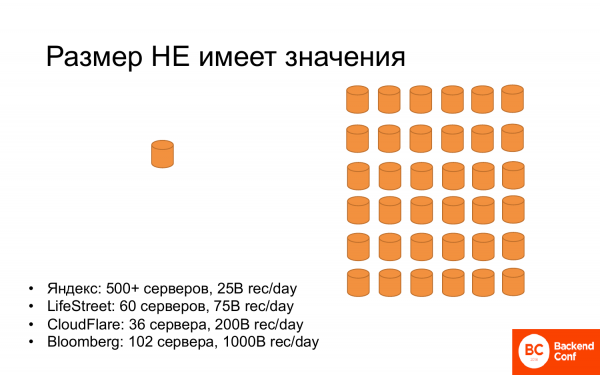
E o tamanho não importa. Há muitas empresas que utilizam um servidor pequeno. E isso lhes permite resolver seus problemas. E ainda mais empresas utilizam grandes clusters de muitos servidores ou dezenas de servidores.
E se olharmos para os recordes, temos:
- Yandex: mais de 500 servidores, 25 bilhões de registros por dia que eles armazenam lá.
- LifeStreet: 60 servidores, cerca de 75 bilhões de registros por dia. Menos servidores, mais registros do que no Yandex.
- CloudFlare: 36 servidores, 200 bilhões de registros por dia que eles mantêm. Eles têm ainda menos servidores e ainda mais dados que eles armazenam.
- Bloomberg: 102 servidor, aproximadamente um trilhão de registros por dia. Recordista em registros.
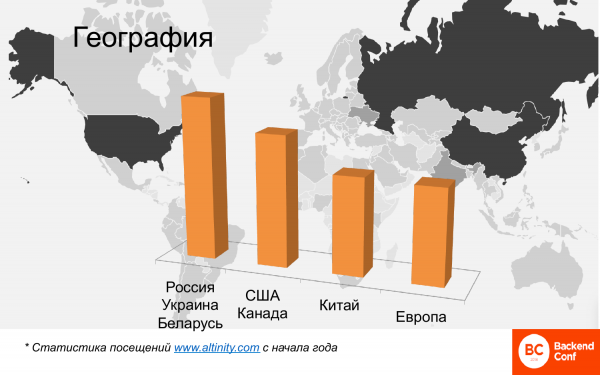
Geograficamente – isso também é muito. Este mapa mostra o heatmap onde o ClickHouse é utilizado no mundo. Aqui, Rússia, China e América se destacam. Existem poucas nações europeias. E podemos identificar 4 clusters.
Esta é uma análise comparativa, não é necessário buscar números absolutos. É uma análise dos visitantes que leem conteúdos em inglês no site da Altinity, pois não há usuários de língua russa lá. E a Rússia, Ucrânia e Bielorrússia, ou seja, a parte de língua russa da comunidade, são os usuários mais numerosos. Depois vêm os EUA e Canadá. A China está se aproximando rapidamente. Há seis meses, quase não havia tráfego da China, agora a China já ultrapassou a Europa e continua crescendo. A velha Europa também não fica para trás, e, surpreendentemente, o líder no uso do ClickHouse é a França.
Por que estou contando tudo isso? Para mostrar que o ClickHouse está se tornando a solução padrão para análise de grandes dados e já está sendo amplamente utilizado. Se você o utiliza, está seguindo a tendência correta. Se ainda não o utiliza, não se preocupe em ficar sozinho e sem ajuda, pois muitas pessoas já estão envolvidas com isso.
Estes são exemplos reais de uso do ClickHouse em várias empresas.
- O primeiro exemplo é uma rede de publicidade: migração do Vertica para o ClickHouse. E conheço várias empresas que migraram do Vertica ou estão em processo de migração.
- O segundo exemplo é um repositório transacional no ClickHouse. Este exemplo foi construído com base em antipadrões. Tudo o que não deve ser feito no ClickHouse, segundo os desenvolvedores, foi feito aqui. E, ainda assim, isso funciona. E funciona muito melhor do que uma solução transacional típica.
- O terceiro exemplo é o processamento distribuído no ClickHouse. Houve uma pergunta sobre como integrar o ClickHouse no ecossistema Hadoop. Vou mostrar um exemplo de como uma empresa fez algo semelhante a um contêiner de map reduce no ClickHouse, cuidando da localização dos dados, e assim por diante, para resolver uma tarefa muito não trivial.
- LifeStreet – É uma empresa de Ad Tech que possui todas as tecnologias relacionadas a uma rede de publicidade.
- Ela se ocupa da otimização de anúncios e do programmatic bidding.
- Muitos dados: cerca de 10 bilhões de eventos por dia. Além disso, esses eventos podem ser divididos em vários subeventos.
- Muitos clientes desses dados, e não são apenas pessoas, muito mais – são vários algoritmos que lidam com programmatic bidding.
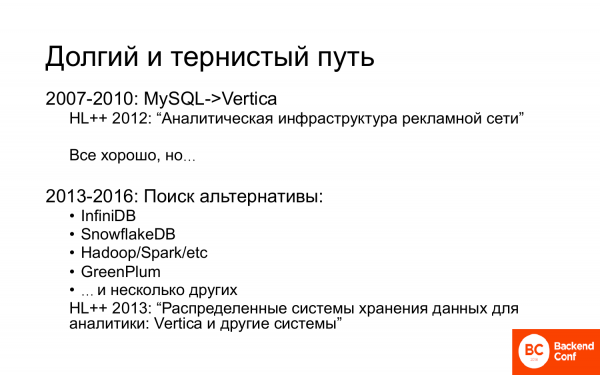
A empresa passou por um longo e difícil percurso. E eu falei sobre isso no HighLoad. Inicialmente, a LifeStreet migrou do MySQL (com uma breve parada no Oracle) para o Vertica. E você pode encontrar uma narrativa sobre isso.
E tudo estava muito bem, mas rapidamente ficou claro que os dados estavam crescendo e o Vertica era caro. Portanto, diversas alternativas foram buscadas. Algumas delas estão listadas aqui. E, na verdade, fizemos um proof of concept ou, às vezes, testes de desempenho em quase todos os bancos de dados que estavam disponíveis no mercado entre 2013 e 2016 e se adequavam em funcionalidade. E sobre alguns deles eu também falei no HighLoad.
A tarefa era migrar do Vertica em primeiro lugar, porque os dados estavam crescendo. E cresceram de forma exponencial por vários anos. Depois, eles estabilizaram, mas ainda assim. Prevendo esse crescimento, as exigências do negócio em relação ao volume de dados para os quais era necessário realizar alguma análise, ficou claro que em breve a conversa seria sobre petabytes. E pagar por petabytes já se tornava muito caro, então alternativas foram buscadas.
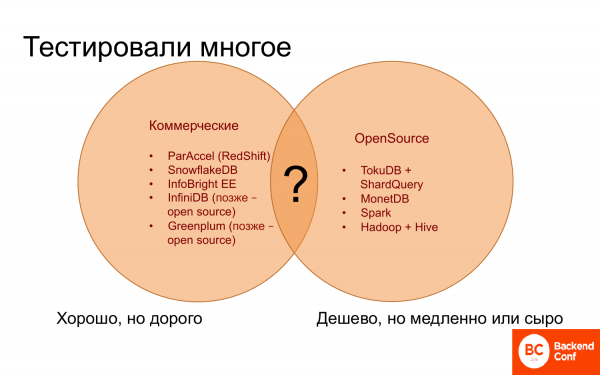
Para onde ir? E por muito tempo não ficou claro para onde ir, porque, por um lado, existem bancos de dados comerciais que parecem funcionar bem. Alguns funcionam quase tão bem quanto o Vertica, outros menos. Mas todos são caros, não houve sucesso em encontrar algo mais barato e melhor.
Por outro lado, existem soluções open source, que não são muitas, ou seja, para análise elas podem ser contadas nos dedos. E elas são gratuitas ou baratas, mas funcionam lentamente. E frequentemente carecem de funcionalidades necessárias e úteis.
E para que pudesse combinar o que há de bom nos bancos de dados comerciais com tudo o que é gratuito nos open source, não havia nada.
Nada havia até que, inesperadamente, o Yandex tirou, como um mágico tirando um coelho de uma cartola, o ClickHouse. E foi uma solução inesperada, ainda se pergunta: 'Por quê?', mas, no entanto.
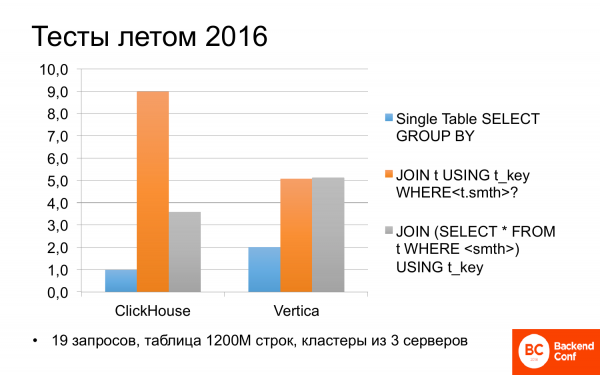
E logo no verão de 2016, começamos a explorar o que é o ClickHouse. E descobrimos que às vezes ele pode ser mais rápido que o Vertica. Testamos diferentes cenários em várias consultas. E se a consulta usasse apenas uma tabela, ou seja, sem nenhum tipo de join, o ClickHouse foi duas vezes mais rápido que o Vertica.
Não me dei ao trabalho e olhei outros testes do Yandex recentemente. O mesmo se aplica: o ClickHouse é duas vezes mais rápido que o Vertica, por isso falam muito sobre isso.
Mas se as consultas envolvem joins, as coisas ficam menos claras. E o ClickHouse pode ser duas vezes mais lento que o Vertica. Mas, se ajustarmos um pouco a consulta e reescrevê-la, os resultados ficam aproximadamente iguais. Não é ruim. E é gratuito.
Depois de obter os resultados dos testes e olhar de diferentes ângulos, a LifeStreet optou pelo ClickHouse.
Lembro que estamos em 2016. Foi como na piada sobre os ratos que choravam e se espetavam, mas continuavam a comer o cacto. Isso foi discutido em detalhes, há um vídeo sobre isso, etc.
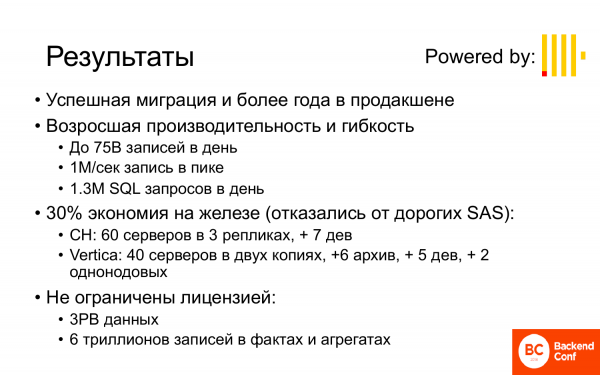
Portanto, não irei entrar em muitos detalhes sobre isso, falarei apenas sobre os resultados e algumas coisas interessantes que não mencionei na época.
Os resultados são:
- Migração bem-sucedida e o sistema já está em produção há mais de um ano.
- O desempenho e a flexibilidade aumentaram. Dos 10 bilhões de registros que podíamos armazenar por dia, e de forma temporária, agora a LifeStreet armazena 75 bilhões de registros por dia e pode manter isso por 3 meses ou mais. Em picos, isso representa até um milhão de eventos por segundo. Mais de um milhão de consultas SQL chegam a esse sistema diariamente, principalmente de vários robôs.
- Embora o ClickHouse tenha começado a usar mais servidores do que o Vertica, houve economia em hardware, pois no Vertica eram utilizados discos SAS bastante caros. No ClickHouse, usamos SATA. E por quê? Porque no Vertica, o insert é síncrono. E a sincronização exige que os discos não sejam muito lentos, assim como a rede, ou seja, é uma operação bastante cara. Já no ClickHouse, o insert é assíncrono. Além disso, você pode sempre gravar localmente, não há custos adicionais para isso, portanto os dados no ClickHouse podem ser inseridos muito mais rapidamente do que no Vertica, mesmo em discos que não são os mais rápidos. E a leitura é mais ou menos a mesma. A leitura em SATA, se estiverem em RAID, é bastante rápida.
- Não são limitados por licença, ou seja, 3 petabytes de dados em 60 servidores (20 servidores formam uma réplica) e 6 trilhões de registros em fatos e agregados. Nada semelhante podia ser permitido no Vertica.
Agora estou passando para as questões práticas deste exemplo.
- Primeiro – é um esquema eficiente. O esquema depende de muitas variáveis.
- Segundo – é a geração de SQL eficiente.
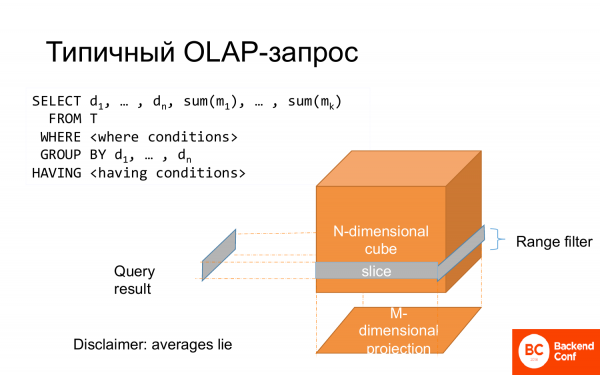
Uma consulta OLAP típica é um select. Parte das colunas vai para o group by, e parte vai para funções agregadas. Há um where, que pode ser visto como um corte do cubo. Todo o group by pode ser representado como uma projeção. E por isso é chamado de análise de dados multidimensional.
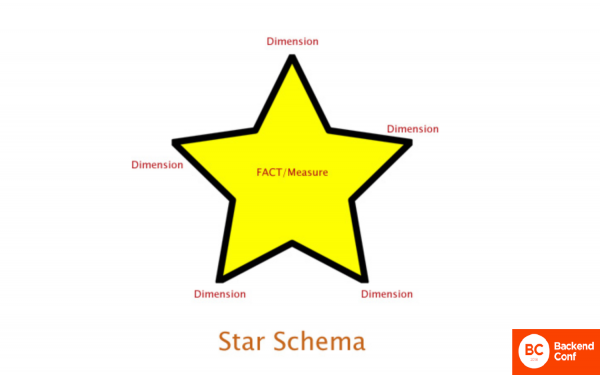
E isso geralmente é modelado como um esquema estrela, onde há um fato central e características desse fato dos lados, como raios.
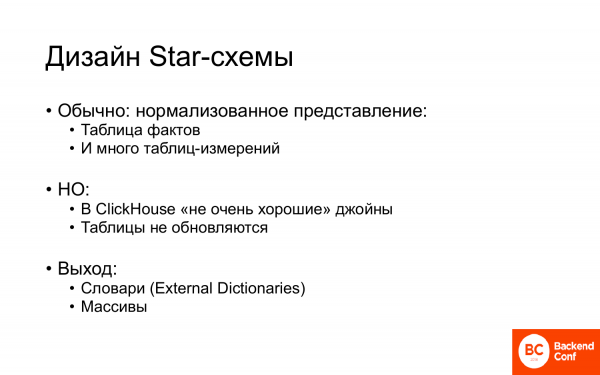
E do ponto de vista do design físico, de como isso se assenta na tabela, normalmente faz-se uma representação normalizada. Você pode desnormalizar, mas isso é caro em termos de disco e não é muito eficaz para consultas. Portanto, normalmente faz-se uma representação normalizada, ou seja, uma tabela de fatos e muitas tabelas de dimensões.
Mas no ClickHouse isso funciona mal. Há duas razões:
- A primeira – é porque no ClickHouse os joins não são muito bons, ou seja, há joins, mas são ruins. Por enquanto, ainda ruins.
- A segunda – é que as tabelas não são atualizadas. Normalmente, nessas tabelas ao redor do esquema estrela, é necessário mudar algo. Por exemplo, o nome do cliente, o nome da empresa, etc. E isso não funciona.
E há uma solução para isso no ClickHouse. Na verdade, são duas:
- A primeira – é o uso de dicionários. Dicionários Externos – isso ajuda a resolver 99% do problema com o esquema estrela, com atualizações e afins.
- A segunda – é o uso de arrays. Arrays também ajudam a evitar os joins e problemas com normalização.
- Não precisa de joins.
- Atualizáveis. Desde março de 2018, surgiu uma possibilidade não documentada (você não encontrará isso na documentação) de atualizar dicionários parcialmente, ou seja, apenas os registros que mudaram. Praticamente – é como uma tabela.
- Sempre na memória, portanto, os joins com o dicionário funcionam mais rápido do que se fosse uma tabela que está no disco e que não está garantido que esteja no cache, provavelmente não está.
- Também não precisa de joins.
- É uma representação compacta de um para muitos.
- E na minha opinião, arrays são feitos para os geeks. Isso envolve funções lambda e afins.
Isso não é para efeito de linguagem. É uma funcionalidade muito poderosa que permite fazer muitas coisas de maneira simples e elegante.
Exemplos típicos que ajudam a resolver arrays. Esses exemplos são simples e bastante ilustrativos:
- Busca por tags. Se você tem hashtags e quer encontrar algumas postagens por uma hashtag.
- Busca por pares key-value. Também há alguns atributos com valor.
- Armazenamento de listas de chaves que você precisa traduzir para algo diferente.
Todas essas tarefas podem ser resolvidas sem arrays. As tags podem ser colocadas em uma única linha e escolhidas com expressões regulares ou em uma tabela separada, mas isso exigirá fazer joins.
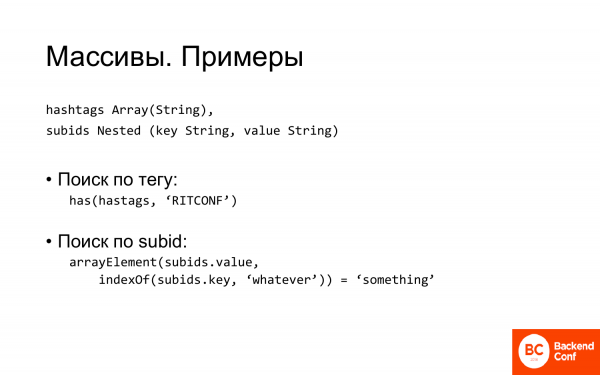
Mas no ClickHouse, você não precisa fazer nada, basta descrever um array string para hashtags ou criar uma estrutura aninhada para sistemas do tipo key-value.
A estrutura aninhada pode não ser o nome mais adequado. São dois arrays que têm uma parte comum no nome e algumas características relacionadas.
E a busca por tags é muito simples. Há uma função has, que verifica se um elemento está no array. Pronto, encontramos todos os registros que dizem respeito à nossa conferência.
A busca por subid é um pouco mais complicada. Primeiro, precisamos encontrar o índice da chave, e depois pegar o elemento com esse índice e verificar se o valor é o que precisamos. Mas, no entanto, é muito simples e compacto.
A expressão regular que você gostaria de escrever, se você armazenasse tudo em uma única linha, seria, em primeiro lugar, desajeitada. E, em segundo lugar, funcionaria muito mais devagar do que dois arrays.
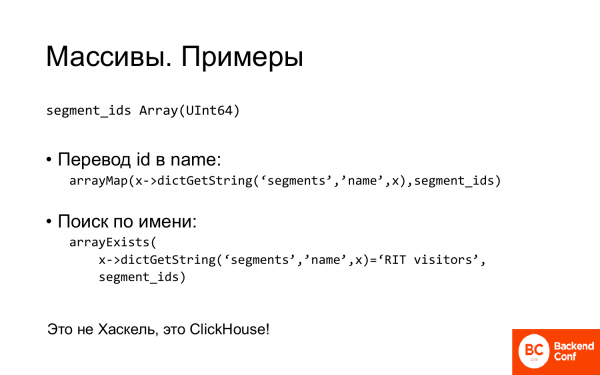
Outro exemplo. Você tem um array onde armazena IDs. E pode traduzi-los para nomes. A função arrayMap. Essa é uma função lambda típica. Você passa expressões lambda para ela. E ela extrai o valor do nome para cada ID do dicionário.
De maneira semelhante, a busca também pode ser feita. Uma função preditiva é passada que verifica quais elementos correspondem.
Essas coisas simplificam muito o esquema e resolvem uma série de problemas.
Mas o próximo problema que encontramos e que gostaria de mencionar é sobre consultas eficientes.
- No ClickHouse, não há um planejador de consultas. Não existe.
- Mas, mesmo assim, consultas complexas ainda precisam ser planejadas. Em quais casos?
- Se no pedido houver vários joins que você encapsula em subconsultas, a ordem em que são executados é importante.
- E o segundo ponto é se o pedido é distribuído. Porque em um pedido distribuído, apenas a subconsulta mais interna é executada de forma distribuída, enquanto todo o resto é enviado para um único servidor ao qual você está conectado e executado lá. Portanto, se você tem pedidos distribuídos com muitos joins, é necessário escolher a ordem.
E mesmo em casos mais simples, às vezes é necessário fazer o trabalho do planejador e reescrever um pouco as consultas.
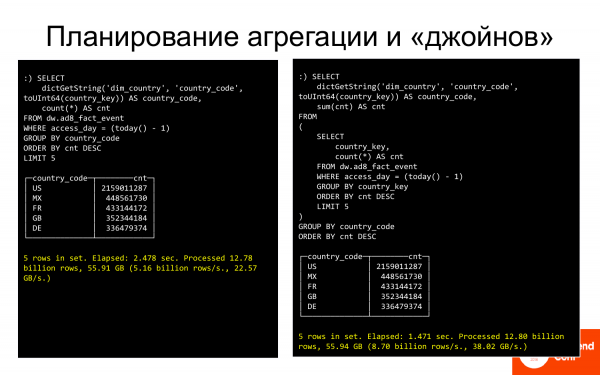
Aqui está um exemplo. À esquerda, uma consulta que mostra o top 5 países, que leva 2,5 segundos para ser executada, se não me engano. E à direita, a mesma consulta, mas ligeiramente reescrita. Em vez de agrupar por string, começamos a agrupar por uma chave (int). E isso é mais rápido. Depois, conectamos um dicionário ao resultado. Em vez de 2,5 segundos, a consulta leva 1,5 segundos. Isso é bom.
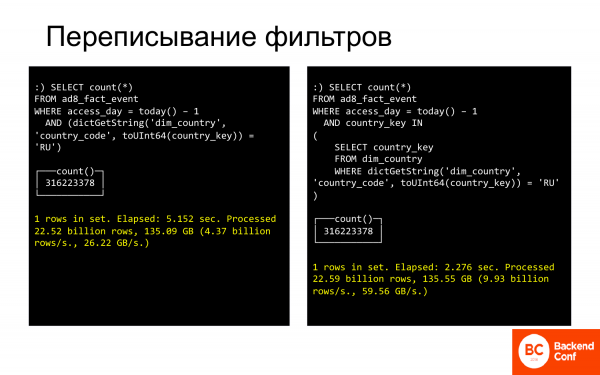
Um exemplo semelhante é a reescrita de filtros. Aqui está uma consulta sobre a Rússia, que leva 5 segundos. Se a reescrevermos de forma que comparemos novamente não por string, mas por números com um conjunto de chaves relacionadas à Rússia, será muito mais rápido.
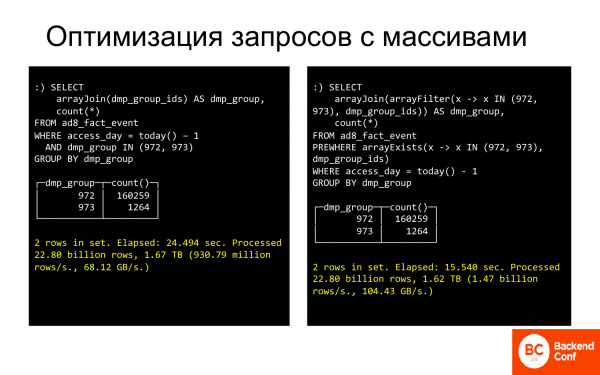
Existem muitos desses truques. E eles permitem acelerar significativamente as consultas que você acha que já estão funcionando rapidamente ou, ao contrário, estão funcionando lentamente. Elas podem ser feitas ainda mais rápidas.
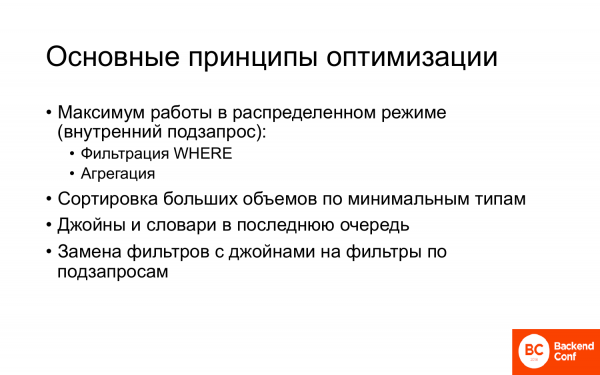
- Máximo trabalho em modo distribuído.
- Ordenação por tipos mínimos, como eu fiz com os inteiros.
- Se houver alguns joins, dicionários, é melhor fazê-los por último, quando você já tiver os dados pelo menos parcialmente agrupados, assim a operação de join ou a chamada do dicionário será feita menos vezes e será mais rápida.
- Substituição de filtros.
Existem outras técnicas, não apenas aquelas que demonstrei. E todas elas, às vezes, permitem acelerar significativamente a execução das consultas.
Vamos para o próximo exemplo. A empresa X dos EUA. O que ela faz?
Havia uma tarefa:
- Vinculação offline de transações de publicidade.
- Modelagem de diferentes modelos de vinculação.
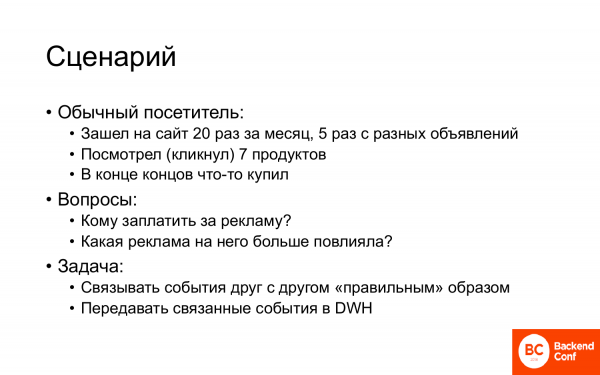
Qual é o cenário?
Um visitante comum acessa o site, por exemplo, 20 vezes por mês a partir de diferentes anúncios ou, às vezes, vem sem nenhum anúncio, porque se lembra deste site. Ele observa alguns produtos, coloca-os no carrinho, retira-os do carrinho. E, no final, acaba comprando algo.
Perguntas pertinentes: "Quem deve pagar pelo anúncio, se necessário?" e "Qual anúncio teve influência, se teve?" Ou seja, por que ele comprou e como fazer para que pessoas semelhantes a ele também comprem?
Para resolver essa questão, é necessário conectar os eventos que ocorrem no site de forma adequada, ou seja, criar alguma relação entre eles. Depois, esses dados devem ser enviados para análise no DWH. Com base nessa análise, modelos serão construídos para determinar a quem e qual anúncio mostrar.
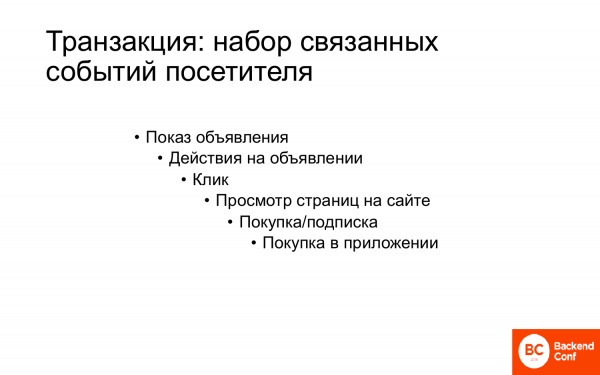
Uma transação publicitária é um conjunto de eventos relacionados ao usuário, que começa com a exibição do anúncio, depois algo acontece, pode haver uma compra e, em seguida, podem ocorrer compras adicionais. Por exemplo, se for um aplicativo móvel ou um jogo móvel, normalmente a instalação do aplicativo é gratuita, mas se algo adicional for necessário, pode haver custos associados. E quanto mais o usuário gastar no aplicativo, mais valioso ele se torna. Mas para isso, é preciso vincular tudo.
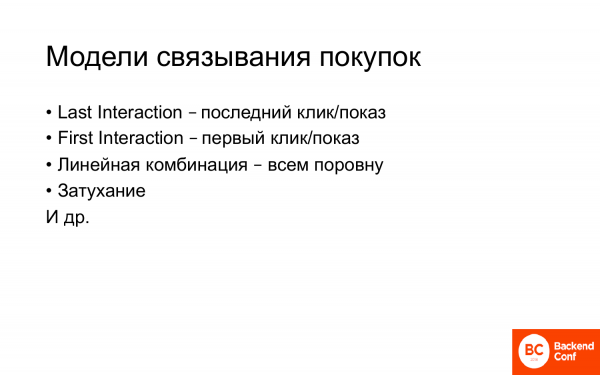
Existem vários modelos de vinculação.
Os mais populares são:
- Última Interação, onde interação pode ser um clique ou uma exibição.
- Primeira Interação, ou seja, o primeiro momento que trouxe o usuário ao site.
- Combinação Linear – todos têm a mesma importância.
- Desvanecimento.
- E outros.
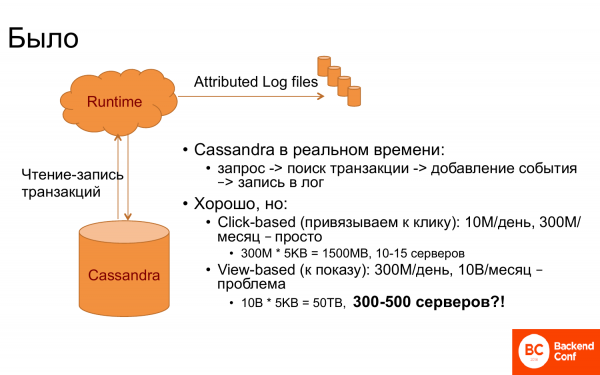
E como tudo isso funcionava originalmente? Havia o Runtime e o Cassandra. O Cassandra era usado como armazenamento de transações, ou seja, todas as transações relacionadas eram armazenadas nele. Quando um evento chegava ao Runtime, por exemplo, a exibição de uma página ou algo mais, uma consulta era feita ao Cassandra – se essa pessoa existia ou não. Depois, as transações relacionadas eram obtidas e a vinculação era realizada.
E se tivesse sorte, que na consulta houvesse um id de transação, seria fácil. Mas geralmente não há sorte. Portanto, era necessário encontrar a última transação ou a transação com o último clique, e assim por diante.
E tudo isso funcionou muito bem enquanto a vinculação era feita ao último clique. Porque temos 10 milhões de cliques por dia, 300 milhões por mês, se colocarmos uma janela mensal. E como no Cassandra tudo precisa estar na memória para que funcione rapidamente, porque o Runtime precisa responder de forma rápida, eram necessários cerca de 10 a 15 servidores.
Mas quando decidiram vincular a transação à exibição, imediatamente não ficou tão divertido. E por que? É evidente que precisamos armazenar 30 vezes mais eventos. E, consequentemente, precisamos de 30 vezes mais servidores. E resulta numa cifra astronômica. Manter até 500 servidores para realizar a vinculação, considerando que no Runtime tem significativamente menos, é um número fora do normal. E começaram a pensar no que fazer.
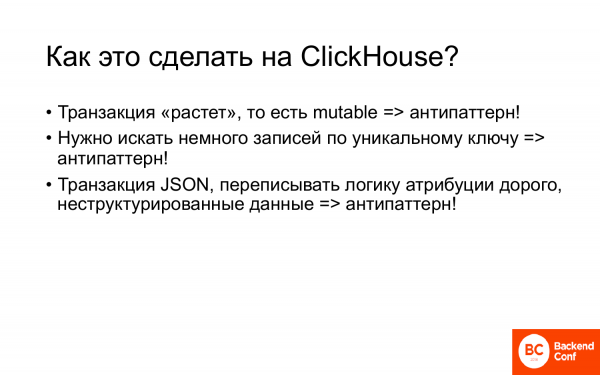
E chegaram ao ClickHouse. Mas como fazer isso no ClickHouse? À primeira vista, parece um conjunto de antipadrões.
- A transação cresce, e vamos conectando novos e novos eventos a ela, ou seja, ela é mutável, e o ClickHouse não trabalha muito bem com objetos mutáveis.
- Quando um visitante chega a nós, precisamos extrair suas transações pela chave, pelo seu visit id. Isso também é uma consulta pontual, o que não se faz no ClickHouse. Normalmente, no ClickHouse realizam-se grandes… escaneamentos, e aqui precisamos recuperar várias gravações. Também é um antipadrão.
- Além disso, a transação estava em json, mas não queriam reescrever, portanto, desejavam armazenar o json de maneira não estruturada, e se necessário, extrair algo dele. E isso também é um antipadrão.
Ou seja, um conjunto de antipadrões.
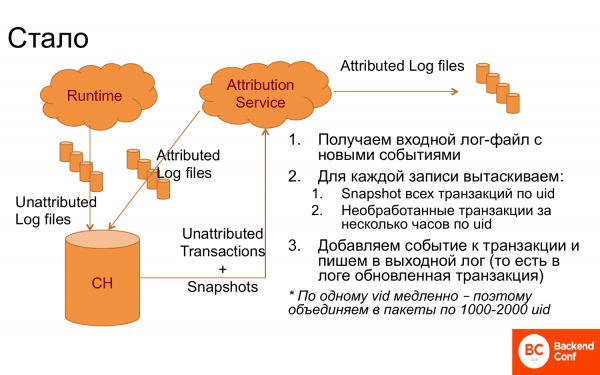
Mas, no entanto, conseguiram criar um sistema que funcionava de forma muito eficiente.
O que foi feito? O ClickHouse foi introduzido, onde os logs eram enviados, divididos em registros. Foi criado um serviço atribuído que recebia os logs do ClickHouse. Depois disso, para cada registro por visit id, obteve transações que poderiam ainda não ter sido processadas e além disso, snapshots, ou seja, transações já vinculadas, que eram o resultado do trabalho anterior. A partir delas, elaborou a lógica, selecionou a transação correta e conectou novos eventos. Registrou novamente no log. O log retornava ao ClickHouse, ou seja, era um sistema cíclico constante. Além disso, era enviado ao DWH para análise.
Foi exatamente assim que não funcionou muito bem. E para facilitar a ClickHouse, quando a consulta era feita pelo id de visita, agrupavam essas consultas em blocos de 1.000 a 2.000 ids de visita e extraíam todas as transações para 1.000 a 2.000 pessoas. E então tudo começou a funcionar.
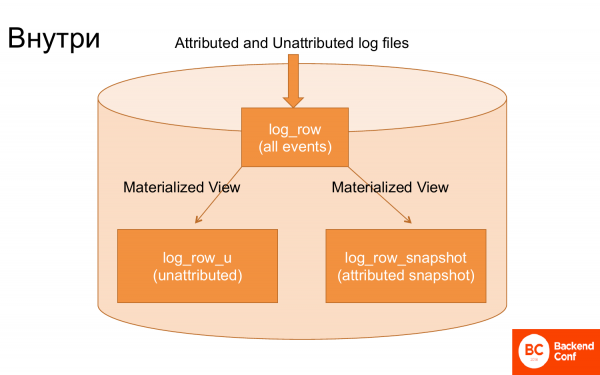
Se olharmos para dentro do ClickHouse, lá existem apenas 3 tabelas principais que atendem a tudo isso.
A primeira tabela, na qual os logs são carregados, sendo que os logs são carregados praticamente sem processamento.
A segunda tabela. Através de uma view materializada, eram extraídos logs que ainda não tinham eventos atribuídos, ou seja, não estavam relacionados. E por meio da view materializada, as transações eram extraídas para construção do snapshot. Ou seja, uma view materializada especial construía um snapshot, especificamente o último estado acumulado da transação.
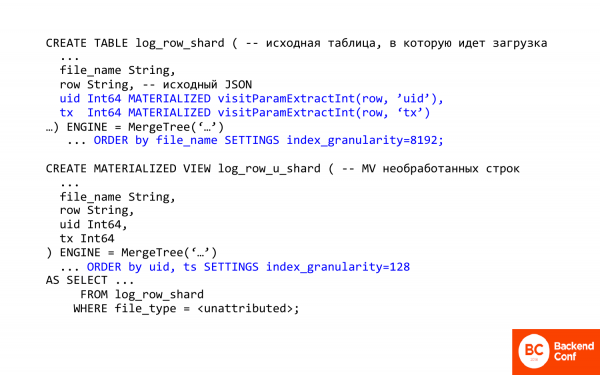
Aqui está um texto em SQL. Eu gostaria de comentar sobre algumas coisas importantes nele.
A primeira coisa importante é a possibilidade no ClickHouse de extrair colunas de json, ou seja, no ClickHouse existem alguns métodos para trabalhar com json. Eles são muito, muito primitivos.
visitParamExtractInt permite extrair atributos de um json, ou seja, a primeira ocorrência é acionada. E assim é possível extrair o id da transação ou o id da visita. Isso é um.
A segunda – aqui foi usado um campo materializado engenhoso. O que isso significa? Isso significa que você não pode inseri-lo na tabela, ou seja, ele não é inserido, ele é calculado e armazenado na inserção. Durante a inserção, ClickHouse realiza o trabalho para você. E já extrai do json aquilo que você precisará depois.
Neste caso, a view materializada é para linhas não processadas. E exatamente a primeira tabela com logs quase brutos é utilizada. E o que ela faz? Primeiro, altera a ordenação, ou seja, a ordenação agora é feita pelo id da visita, porque precisamos extrair rapidamente a transação específica de uma pessoa.
A segunda coisa importante é a index_granularity. Se você viu o MergeTree, geralmente por padrão a index_granularity é 8.192. O que é isso? É um parâmetro de esparsidade do índice. No ClickHouse, o índice é esparso, ele nunca indexa cada registro. Ele faz isso a cada 8.192. E isso é bom quando é necessário contar uma grande quantidade de dados, mas ruim quando é pouco, porque há um grande overhead. E se você diminuir a granulação do índice, reduzimos o overhead. Não é possível reduzir para um, porque a memória pode não ser suficiente. O índice é sempre armazenado na memória.
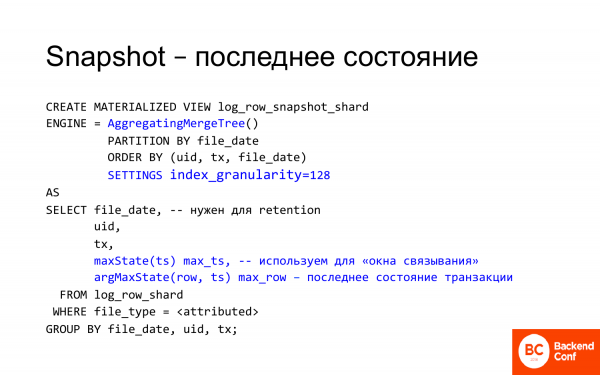
E o snapshot utiliza algumas funções interessantes do ClickHouse.
Primeiro, temos o AggregatingMergeTree. No AggregatingMergeTree, é armazenado o argMax, ou seja, é o estado da transação correspondente ao último timestamp. Transações novas são constantemente geradas para este visitante. E no estado mais recente desta transação, adicionamos um evento e tivemos um novo estado. Ele novamente entrou no ClickHouse. E através do argMax nesta view materializada, sempre podemos obter o estado atual.
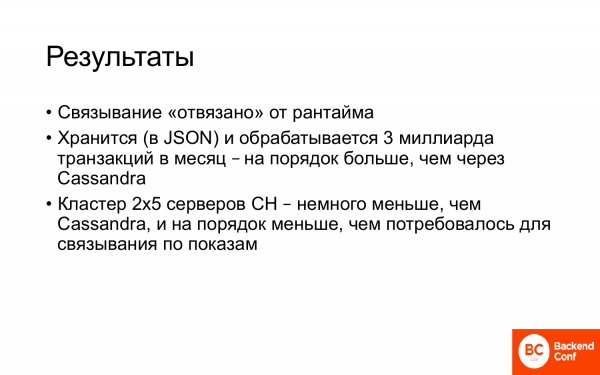
- A vinculação está "desvinculada" do Runtime.
- Até 3 bilhões de transações são armazenadas e processadas por mês. Isso é uma ordem de magnitude maior do que era no Cassandra, ou seja, em um sistema transacional típico.
- Cluster de 2x5 servidores ClickHouse. 5 servidores e cada servidor tem uma réplica. Isso é até menos do que era no Cassandra para realizar atribuição baseada em clique, e aqui temos atribuição baseada em impressão. Ou seja, em vez de aumentar o número de servidores em 30 vezes, conseguimos reduzi-lo.
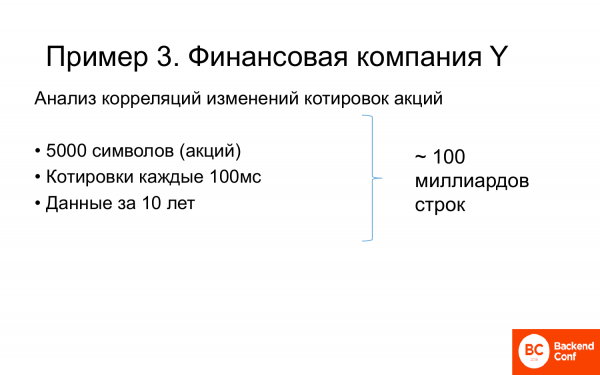
E o último exemplo é a empresa financeira Y, que analisava correlações nas mudanças de cotações de ações.
E a tarefa era a seguinte:
- Existem cerca de 5.000 ações.
- As cotações são atualizadas a cada 100 milissegundos.
- Os dados foram acumulados ao longo de 10 anos. Evidentemente, para algumas empresas mais, para outras menos.
- No total, cerca de 100 bilhões de linhas.
Era necessário calcular a correlação das mudanças.
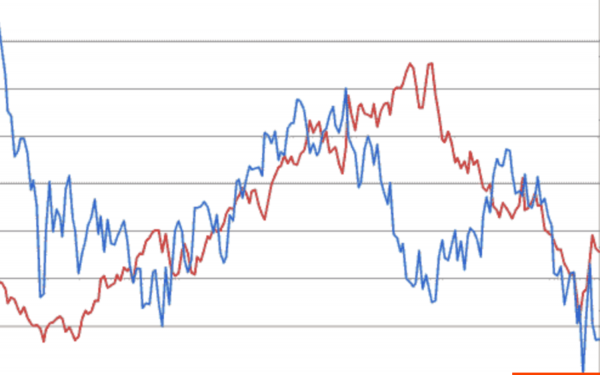
Aqui temos duas ações e suas cotações. Se uma sobe e a outra também sobe, isso é uma correlação positiva, ou seja, uma cresce, a outra cresce. Se uma sobe, como no final do gráfico, e a outra desce, isso é uma correlação negativa, ou seja, quando uma cresce, a outra cai.
Ao analisar essas mudanças mútuas, é possível fazer previsões no mercado financeiro.
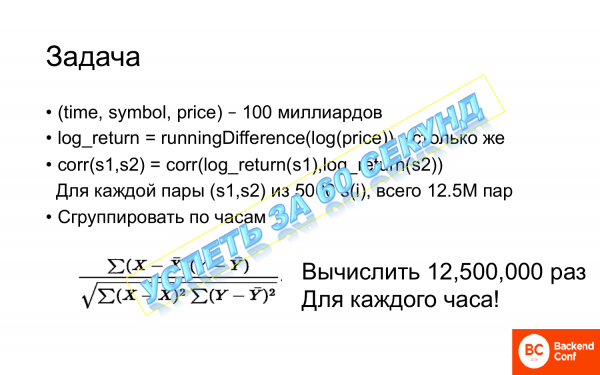
Mas a tarefa é complexa. O que é feito para isso? Temos 100 bilhões de registros, que contêm: tempo, ação e preço. Precisamos primeiro calcular 100 bilhões de vezes o runningDifference do algoritmo de preço. RunningDifference é uma função no ClickHouse que calcula a diferença entre duas linhas sequencialmente.
E após isso, precisamos calcular a correlação, sendo que a correlação deve ser feita para cada par. Para 5.000 ações, são 12,5 milhões de pares. E isso é muito, ou seja, precisamos calcular essa função de correlação 12,5 vezes.
E se alguém esqueceu, então x e y são a expectativa matemática da amostra. Ou seja, não é apenas contar raízes e somas, mas também calcular outras somas dentro dessas somas. É necessário realizar uma infinidade de cálculos 12,5 milhões de vezes, e ainda agrupar por horas. E temos muitas horas também. E precisamos fazer tudo isso em 60 segundos. É uma piada.
Precisávamos conseguir isso de alguma forma, porque tudo estava funcionando muito, muito lentamente, antes da chegada do ClickHouse.
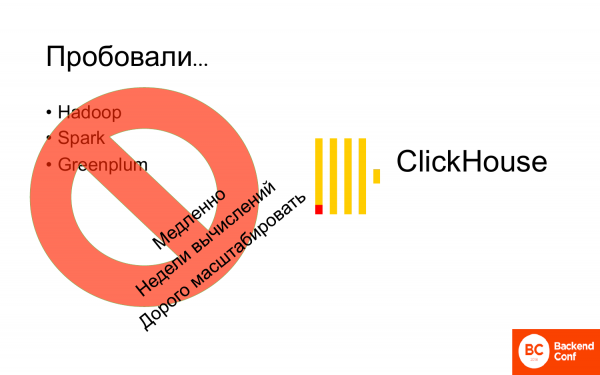
Eles tentaram calcular isso no Hadoop, no Spark e no Greenplum. E tudo isso era muito lento ou caro. Ou seja, era possível calcular de alguma forma, mas depois era caro.
Aí veio o ClickHouse e tudo melhorou muito.
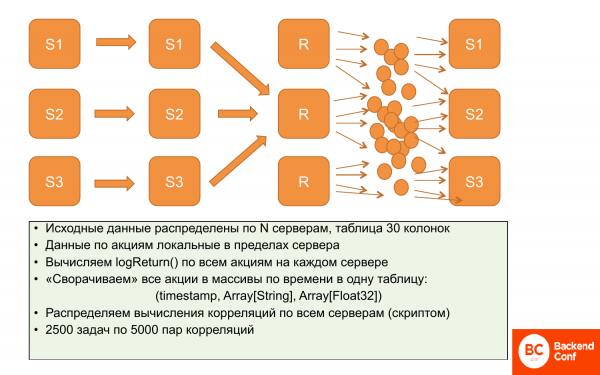
Lembro que o problema é a localidade dos dados, pois as correlações não podem ser localizadas. Não podemos dividir parte dos dados em um servidor, parte em outro e calcular; todos os dados precisam estar em todos os lugares.
O que eles fizeram? Inicialmente, os dados eram localizados. Em cada um dos servidores, são armazenados dados de precificação de um conjunto específico de ações. E eles não se sobrepõem. Por isso, podemos calcular logReturn de forma paralela e independente, tudo isso ocorre ao mesmo tempo de forma paralela e distribuída.
Depois, decidiram reduzir esses dados sem perder expressividade. Reduzir usando arrays, ou seja, para cada intervalo de tempo criar um array de ações e um array de preços. Assim, isso ocupa muito menos espaço. E é um pouco mais fácil trabalhar com eles. São operações quase paralelas, ou seja, calculamos parte delas em paralelo e depois gravamos no servidor.
Após isso, podemos replicar. A letra 'r' significa que esses dados foram replicados. Ou seja, temos os mesmos dados em todos os três servidores – esses arrays.
E, em seguida, com um script especial, desse conjunto de 12,5 milhões de correlações a serem calculadas, podemos criar pacotes. Ou seja, 2.500 tarefas com 5.000 pares de correlações. E essa tarefa é calculada em um servidor específico do ClickHouse. Todos os dados estão lá, pois os dados são iguais e ele pode computá-los sequencialmente.
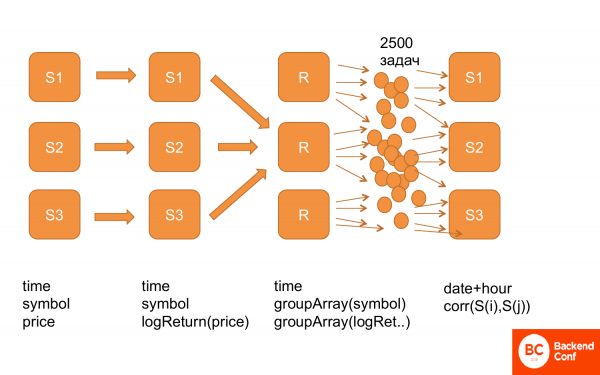
Mais uma vez, como isso funciona. Primeiro, temos todos os dados nesta estrutura: tempo, ações, preço. Depois calculamos o logReturn, ou seja, os dados da mesma estrutura, mas em vez de preço, já temos logReturn. Em seguida, os reorganizamos, resultando em tempo e groupArray para ações e preços. Fizemos a replicação. E depois disso, geramos um monte de tarefas e alimentamos o ClickHouse para que ele pudesse processá-las. E isso funciona.
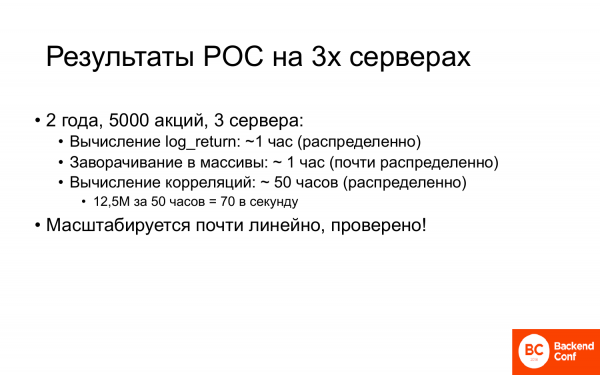
No proof of concept, a tarefa era uma subtarefa, ou seja, pegamos menos dados. E foi tudo em três servidores.
As duas primeiras etapas: cálculo do Log_return e embalagem em arrays levaram cerca de uma hora cada.
Já o cálculo da correlação levou cerca de 50 horas. Mas 50 horas é pouco, porque antes isso funcionava por semanas. Isso foi um grande sucesso. E se contabilizar, tudo foi calculado 70 vezes por segundo neste cluster.
Mas o mais importante é que este sistema praticamente não tem gargalos, ou seja, ele escala quase linearmente. E eles verificaram isso. Escalaram-no com sucesso.
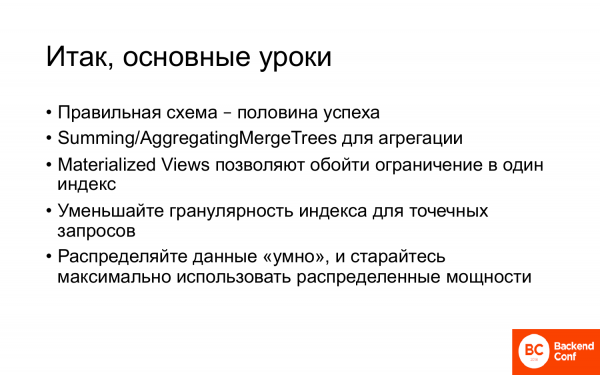
- Um esquema correto é metade do sucesso. E um esquema correto é utilizar todas as tecnologias necessárias do ClickHouse.
- Summing/AggregatingMergeTrees são tecnologias que permitem agregar ou contabilizar o snapshot state como um caso especial. E isso simplifica muitas coisas.
- As Views Materializadas permitem contornar a limitação de um índice. Talvez eu não tenha explicado isso muito claramente, mas quando carregamos os logs, os logs brutos estavam em uma tabela com um índice, enquanto os logs de atributo estavam em outra tabela, ou seja, os mesmos dados, apenas filtrados, mas o índice era totalmente diferente. Parecia que eram os mesmos dados, mas com diferentes ordenações. E as Views Materializadas permitem, se necessário, contornar tal limitação do ClickHouse.
- Reduza a granularidade do índice para consultas pontuais.
- E distribua os dados de forma inteligente, tente maximizar a localização dos dados dentro do servidor. E busque garantir que as consultas também utilizem essa localização sempre que possível.
E resumindo esta breve apresentação, pode-se dizer que o ClickHouse agora ocupa firmemente o território tanto de bancos de dados comerciais quanto de bancos de dados open source, ou seja, especificamente para análise. Ele se integrou maravilhosamente a esse cenário. E mais, ele lentamente começa a expulsar outros, porque, com ClickHouse, você não precisa do InfiniDB. A Vertica pode, em breve, não ser mais necessária, se eles oferecerem um suporte SQL adequado. Aproveitem!
—Obrigado pela apresentação! Muito interessante! Houve alguma comparação com o Apache Phoenix?
- Não, não ouvi falar de ninguém que tenha comparado. Nós e o Yandex tentamos acompanhar todas as comparações do ClickHouse com diferentes bancos de dados. Porque se por acaso algo for mais rápido que o ClickHouse, Alexei Milovidov não consegue dormir à noite e começa a acelerá-lo rapidamente. Não ouvi falar de tal comparação.
(Alexei Milovidov) Apache Phoenix é um motor SQL sobre HBase. O HBase é principalmente projetado para cenários de trabalho do tipo key-value. Em cada linha, pode haver um número arbitrário de colunas com nomes arbitrários. Isso pode ser dito sobre sistemas como HBase e Cassandra. E para consultas analíticas pesadas, eles não funcionarão de forma adequada. Ou você pode pensar que eles funcionam bem, se não teve nenhuma experiência com o ClickHouse.
Obrigado
Bom dia! Já estou bastante interessado nesse tema, pois tenho um subsistema de análise. Mas quando olho para o ClickHouse, tenho a sensação de que o ClickHouse é muito bom para a análise de eventos, mutáveis. E se eu precisar analisar muitos dados de negócios com diversos grandes tabelas, então, pelo que entendi, ClickHouse pode não ser muito adequado para mim? Especialmente se eles mudarem. Isso está correto ou existem exemplos que podem contradizer isso?
Isso é correto. E isso é verdade para a maioria dos bancos de dados analíticos especializados. Eles são projetados para ter uma ou várias grandes tabelas que são mutáveis, e muitas pequenas que mudam lentamente. Ou seja, ClickHouse não é como Oracle, onde você pode colocar tudo e construir consultas muito complexas. Para utilizar ClickHouse de forma eficaz, é necessário construir o esquema de uma maneira que funcione bem no ClickHouse. Ou seja, evitar normalização excessiva, usar dicionários, e tentar fazer menos relações longas. Se o esquema for estruturado dessa forma, tarefas de negócios similares no ClickHouse podem ser resolvidas muito mais eficientemente do que em um banco de dados relacional tradicional.
Obrigado pela apresentação! Eu tenho uma pergunta sobre o último caso financeiro. Eles tinham análises. Era necessário comparar como as coisas subiam e desciam. E eu entendo que você construiu o sistema especificamente para essa análise? Se eles precisarem, digamos, de um outro relatório sobre esses dados amanhã, será necessário reconstruir o esquema e recarregar os dados? Ou seja, fazer algum pré-processamento para obter a consulta?
Claro, isso é o uso do ClickHouse para uma tarefa bastante específica. Tradicionalmente, poderia ser resolvida dentro do Hadoop. Para o Hadoop, essa é uma tarefa ideal. Mas no Hadoop isso é muito lento. Meu objetivo é demonstrar que é possível resolver no ClickHouse tarefas que normalmente são abordadas com meios muito diferentes, mas de forma muito mais eficaz. Está ajustado para uma tarefa específica. É compreensível que, se houver uma tarefa semelhante, ela possa ser resolvida de maneira parecida.
Entendi. Você disse que foram 50 horas de processamento. Isso conta desde o início, quando os dados foram carregados ou quando os resultados foram obtidos?
Sim, sim.
Muito bem, muito obrigado.
Isso em um cluster de 3 servidores.
Saudações! Obrigado pela apresentação! Tudo é muito interessante. Eu gostaria de perguntar um pouco não sobre a funcionalidade, mas sobre o uso do ClickHouse em termos de estabilidade. Ou seja, você teve algum problema, precisou recuperar? Como o ClickHouse se comporta nesses casos? E já aconteceu de uma réplica cair também? Nós, por exemplo, já tivemos problemas com o ClickHouse quando ele, de fato, ultrapassou seu limite e falhou.
Claro, não existem sistemas perfeitos. E o ClickHouse também tem seus problemas. Mas você já ouviu falar de casos em que o Yandex.Metrica não funcionou por muito tempo? Provavelmente não. Ela funciona de forma confiável desde 2012-2013 no ClickHouse. Também posso falar sobre minha experiência. Nunca tivemos falhas totais. Alguns problemas parciais podiam ocorrer, mas nunca foram críticos a ponto de impactar seriamente os negócios. Nunca aconteceu. O ClickHouse é bastante confiável e não trava aleatoriamente. Pode-se ficar tranquilo quanto a isso. Não é algo cru. Isso foi comprovado por muitas empresas.
Olá! Você mencionou que é necessário planejar bem o esquema de dados desde o início. E se isso não foi feito? Meus dados estão fluindo continuamente. Passa um semestre, e eu percebo que não dá mais para viver assim, preciso reprocessar os dados e fazer algo a respeito.
Isso depende, claro, do seu sistema. Existem várias maneiras de fazer isso praticamente sem interrupção. Por exemplo, você pode criar uma Materialized View, onde pode ter uma estrutura de dados diferente, desde que ela possa ser mapeada de forma clara. Ou seja, se permite mapeamento por meio do ClickHouse, como extrair alguns elementos, mudar a chave primária, alterar a partição, você pode fazer uma Materialized View. Reescreva seus dados antigos nela, e os novos serão inseridos automaticamente. Depois, basta mudar para usar a Materialized View, mudar a gravação e eliminar a tabela antiga. Esse é um método que pode ser feito sem interrupções.
Obrigado.
Fonte: habr.com
