

Nota do tradutor.: o autor deste artigo (Luc Perkins) — defensor de desenvolvedores na organização CNCF, que é o lar de projetos de código aberto como Linkerd, SMI (Service Mesh Interface) e Kuma (a propósito, você também se perguntou por que este lista não inclui Istio?). Novamente, tentando trazer para a comunidade DevOps uma melhor compreensão da atual tendência chamada "service mesh", ele apresenta 16 funcionalidades características que essas soluções oferecem.
Hoje — um dos tópicos mais quentes no campo da engenharia de software (e com razão!). Eu considero essa tecnologia incrivelmente promissora e sonho em testemunhar sua ampla adoção (claro, quando fizer sentido). No entanto, ela ainda está envolta em um véu de mistério para a maioria das pessoas. Mesmo aqueles que estão bem familiarizados com ela frequentemente têm dificuldades em articular seus benefícios e o que ela realmente representa (incluindo seu humilde servo). Neste artigo, tentarei corrigir essa situação, listando diversos cenários de uso "service meshes"*.
* Nota do tradutor: aqui e adiante no artigo será utilizado esse termo traduzido como "service mesh" para o ainda novo termo service mesh.
Mas antes quero fazer alguns comentários:
- Nunca trabalhei com service meshes e não as usei fora de projetos iniciados para minha própria educação. Por outro lado, eu escrevi uma montanha de documentação para a service mesh interna da empresa Twitter em 2015 (naquela época, ela ainda não era chamada de "service mesh") e participei do desenvolvimento do site e da documentação para , então isso significa alguma coisa.
- Minha lista é meramente indicativa e incompleta. É bem possível que existam cenários de uso que eu não conheço, e novos casos certamente surgirão com o avanço da tecnologia e o aumento de sua popularidade.
- Ao mesmo tempo, nem toda implementação existente de service mesh suporta todos os casos de uso listados. Portanto, minhas afirmações como "service mesh pode..." devem ser lidas como "implementações específicas, e possivelmente todas as implementações populares de service mesh podem...".
- A ordem dos exemplos não tem importância.
Lista resumida:
- descobrimento de serviços;
- criptografia;
- autenticação e autorização;
- balanceamento de carga;
- circuit breaking;
- autoscalamento;
- desdobramentos canário;
- desdobramentos azul-verde;
- verificação de saúde;
- drenagem de carga;
- espelhamento de tráfego;
- isolamento;
- limitação de frequência de solicitações, tentativas repetidas e timeouts;
- telemetria;
- auditoria;
- visualização.
1. Detecção de serviços
TL;DR: Conecte-se a outros serviços na rede usando nomes simples.
Os serviços devem ser capazes de "encontrar" uns aos outros automaticamente por meio de nomes adequados – por exemplo, service.api.production, pets/staging ou cassandra. Os ambientes em nuvem se destacam por sua elasticidade, e por trás de um nome pode haver várias instâncias de serviço. É claro que, em tal situação, é fisicamente impossível codificar todos os endereços IP.
Além disso, quando um serviço encontra outro, ele deve ser capaz de enviar solicitações a esse serviço sem receio de que elas cheguem a uma instância inativa. Em outras palavras, a service mesh deve monitorar a saúde de todas as instâncias de serviços e manter uma lista de hosts sempre atualizada.
Cada service mesh implementa o mecanismo de detecção de serviços de maneira diferente. Atualmente, a forma mais comum é delegar para processos externos, como o DNS do Kubernetes. No passado, no Twitter, usamos um sistema de nomenclatura . Além disso, a tecnologia da service mesh torna possível o surgimento de mecanismos de nomenclatura personalizados (embora eu ainda não tenha encontrado uma implementação de SM com tal funcionalidade).
2. Criptografia
TL;DR: Elimine o tráfego não criptografado entre serviços e torne esse processo automatizado e escalável.
É bom saber que os invasores não conseguem penetrar em sua rede interna. Firewalls são ótimos para isso. Mas o que acontecerá se um hacker conseguir entrar? Ele poderá fazer o que quiser com o tráfego interno do serviço? Vamos torcer para que isso nunca aconteça. Para prevenir esse tipo de cenário, deve-se implementar uma rede de confiança zero (zero-trust), onde todo o tráfego entre serviços é criptografado. A maioria das redes de serviços modernas alcança isso por meio de um mecanismo de (mutual TLS, mTLS). Em alguns casos, o mTLS funciona em nuvens e clusters inteiros (acredito que comunicações interplanetárias um dia serão organizadas de maneira semelhante).
Claro, para a service mesh de mTLS não é obrigatória. Cada serviço pode cuidar de seu próprio TLS, mas isso significa que você precisará encontrar uma maneira de gerar certificados, distribuí-los entre os hosts do serviço e incluir no aplicativo um código que carregará esses certificados de arquivos. Ah, e não se esqueça de renovar esses certificados após certos períodos de tempo. As malhas de serviço automatizam o mTLS com sistemas como , que, por sua vez, automatizam o processo de emissão e rotação de certificados.
3. Autenticação e autorização
TL;DR: Estabeleça quem é o iniciador da solicitação e determine o que é permitido fazer antes que a solicitação alcance o serviço.
Os serviços frequentemente querem saber ele é. quem está fazendo a solicitação (autenticação), e, com essa informação, decidirem o usuário (ou invasor) está tentando fazer, mas também o que esse sujeito está autorizado a fazer (autorização). Neste caso, o pronome "quem" pode se referir a:
- Outros serviços. Isso é chamado de "autenticação de peer".Por exemplo, um serviço
webquer acessar o serviçodb. As malhas de serviço geralmente resolvem esses problemas usando mTLS: os certificados, neste caso, atuam como a identidade necessária. - Alguns usuários humanos. Isso é chamado de "autenticação de solicitação".Por exemplo, o usuário
haxor69quer comprar uma nova lâmpada. As malhas de serviço oferecem vários mecanismos, como .Muitos de nós já fizemos isso no código do aplicativo. Chega uma solicitação, olhamos a tabela
tinham endereços de e-mail em domínios, encontramos o usuário e comparamos a senha, depois verificamos a colunapermissionsetc. No caso de malhas de serviço, isso acontece ainda antes de a solicitação alcançar o serviço.
Depois de determinar de onde veio a solicitação, precisamos definir o que esse sujeito está autorizado a fazer. Algumas malhas de serviço permitem definir políticas básicas (sobre quem e o que pode ser feito) em arquivos YAML ou na linha de comando, enquanto outras oferecem integração com estruturas como . O objetivo final é garantir que seus serviços aceitem qualquer solicitação, assumindo sem medo que ela venha de uma fonte confiável, e se essa ação é permitida.
4. Balanceamento de carga
TL;DR: Distribua a carga entre as instâncias do serviço de acordo com um padrão específico.
O «Serviço» dentro de uma seita de serviços muitas vezes consiste em várias cópias idênticas. Por exemplo, hoje o serviço cache consiste em 5 cópias, mas amanhã esse número pode aumentar para 11. As solicitações que chegam a cache, devem ser distribuídas de acordo com um objetivo específico. Por exemplo, minimizar a latência ou maximizar a probabilidade de acessar uma instância funcional. O algoritmo mais comumente usado é o round-robin, mas existem muitos outros — como o método de solicitações ponderadas (weighted) , hash em anel (ring) , (uso de hash consistente para hosts upstream) ou o método de menor número de solicitações (preferência é dada à instância com o menor número de solicitações).
Balanceadores clássicos têm outras funções, como cache HTTP e proteção contra DDoS, mas não são muito relevantes para o tráfego do tipo east-west (ou seja, para tráfego que flui dentro do data center — nota do tradutor) (área típica de aplicação da service mesh). Claro, não é obrigatório usar uma service mesh para balanceamento de carga, no entanto, ela permite definir e controlar políticas de balanceamento para cada serviço a partir de uma camada de gerenciamento centralizada, eliminando assim a necessidade de executar e configurar balanceadores separados na pilha de rede.
5. Quebra de circuito (circuit breaking)
TL;DR: Pare o tráfego para o serviço problemático e controle os danos em cenários adversos.
Se, por qualquer motivo, o serviço não consegue lidar com o tráfego, a service mesh oferece várias opções para resolver esse problema (outras serão abordadas em seções correspondentes). A quebra de circuito é a opção mais rigorosa de desconectar o serviço do tráfego. No entanto, por si só, não faz sentido — um plano de contingência é necessário. Pode-se considerar a utilização da pressão reversa () para os serviços que fazem as solicitações (apenas não se esqueça de configurar sua service mesh para isso!), ou, por exemplo, também tingir a página de status de vermelho e redirecionar os usuários para uma opção alternativa da página com um «baleia caindo» («Twitter está fora do ar»).
As service meshes permitem não apenas definir quando a desconexão deve ocorrer e o usuário (ou invasor) está tentando fazer, mas também Isso seguirá. Nesse caso, "quando" pode incluir qualquer combinação de parâmetros definidos: o número total de solicitações em um determinado período, o número de conexões paralelas, solicitações em espera, tentativas ativas de repetição, etc.
Você provavelmente não quer abusar do circuit breaking, mas é bom saber que existe um plano B para casos extremos.
6. Autoscaling
TL;DR: Aumente ou diminua o número de instâncias do serviço com base nos critérios definidos.
Os service meshes não são agendadores, portanto não realizam escalonamento por conta própria. No entanto, eles podem fornecer informações com as quais os agendadores tomarão decisões. Como os service meshes têm acesso a todo o tráfego entre serviços, eles possuem informações abrangentes sobre o que está acontecendo: quais serviços estão enfrentando problemas, quais estão sendo pouco utilizados (e a capacidade alocada está sendo desperdiçada), etc.
Por exemplo, o Kubernetes escala serviços com base no uso de CPU e memória pelos pods (veja nossa apresentação "' - nota do tradutor.)", mas se você decidir escalar com base em qualquer outra métrica (neste caso - relacionada ao tráfego), uma métrica especial será necessária. Guias mostram como fazer isso com , e , mas o próprio processo é bastante complicado. Gostaríamos que o service mesh simplificasse isso, permitindo definir condições como "aumente o número de instâncias do serviço auth, se o número de solicitações aguardando execução exceder o limite por um minuto."
7. Implantação canary
TL;DR: Teste novos recursos ou versões do serviço em um subconjunto de usuários.
Vamos supor que você está desenvolvendo um produto SaaS e pretende lançar uma nova versão incrível. Você a testou em staging e funcionou perfeitamente. Mas ainda assim, surgem algumas preocupações sobre seu desempenho em condições reais. Em outras palavras, é necessário verificar a nova versão em tarefas reais, sem arriscar a confiança dos usuários. Os lançamentos canário são ideais para isso. Eles permitem mostrar uma nova funcionalidade a um subconjunto de usuários. Esse subconjunto pode ser composto pelos usuários mais fiéis, pelos que usam a versão gratuita do produto, ou por usuários que se mostraram dispostos a serem 'cobaias'.
Os meshes de serviço realizam isso, permitindo especificar critérios que determinam quem verá qual versão do aplicativo, roteando o tráfego de acordo. Para os próprios serviços, nada muda. A versão 1.0 do serviço acredita que todas as solicitações vêm de usuários que devem vê-la, enquanto a versão 1.1 considera o mesmo em relação aos seus usuários. E você, enquanto isso, pode alterar a porcentagem de tráfego entre a versão antiga e a nova, redirecionando um número crescente de usuários para a nova, caso ela funcione de maneira estável e seus 'cobaias' aprovam.
8. Lançamentos Azul-Verde
TL;DR: Lance uma nova funcionalidade incrível, mas esteja pronto para reverter imediatamente se necessário.
Significado é lançar um novo serviço 'azul', executando-o em paralelo ao antigo 'verde'. Se tudo correr bem e o novo serviço se mostrar eficaz, o antigo poderá ser gradualmente desativado. (Infelizmente, um dia esse novo serviço 'azul' também encontrará o seu destino e desaparecerá…) Os lançamentos azul-verde diferem dos canários, pois a nova funcionalidade abrange todos os usuários (e não apenas uma parte); a ideia aqui é ter uma 'reserva' pronta, caso algo não saia como esperado.
As malhas de serviço oferecem uma maneira muito conveniente de testar o serviço "azul" e alternar instantaneamente para o serviço "verde" em caso de problemas. Sem mencionar que, ao mesmo tempo, fornecem uma quantidade significativa de informações (veja a seção "Telemetria" abaixo) sobre o funcionamento do "azul", o que ajuda a entender se ele está pronto para uma operação completa.
Nota do tradutor.: Mais informações sobre diferentes estratégias de implantação no Kubernetes (incluindo as mencionadas canary, blue/green e outras) podem ser encontradas em .
9. Verificação de saúde
TL;DR: Monitore quais instâncias de serviços estão operacionais e reaja àquelas que deixarem de estar.
Verificação de saúde (health check) ajuda a decidir se as instâncias do serviço estão prontas para receber e processar tráfego. Por exemplo, em serviços HTTP, a verificação de saúde pode ser um pedido GET para o endpoint /health. A resposta 200 OK significará que a instância está saudável, qualquer outra significará que não está pronta para receber tráfego. As malhas de serviço permitem especificar tanto o método de verificação de operação quanto a frequência com que essa verificação será realizada. Essas informações podem ser utilizadas para outros fins — por exemplo, para balanceamento de carga e circuit breaking.
Assim, a verificação de saúde não é um cenário de uso autônomo, mas geralmente é usada para alcançar outros objetivos. Além disso, dependendo dos resultados das verificações de saúde, podem ser necessárias ações externas (em relação a outros objetivos das malhas de serviço): por exemplo, atualizar a página de status, criar uma issue no GitHub ou preencher um ticket no JIRA. E a malha de serviço oferece um mecanismo conveniente para automatizar tudo isso.
10. Descarte de carga (load shedding)
TL;DR: Redirecione o tráfego em resposta a um pico temporário de uso.
Se um serviço estiver sobrecarregado com tráfego, você pode temporariamente redirecionar parte desse tráfego para outro lugar (ou seja, "descartar", "despejar" (shed) ele lá). Por exemplo, para um serviço de backup ou data center, ou para um permanente tópico. Como resultado, o serviço continuará a processar parte dos pedidos em vez de falhar e parar de processar tudo. O desligamento da carga é preferível a uma ruptura total, mas ainda assim não deve ser abusado. Ele permite evitar falhas em cascata que podem derrubar serviços downstream.
11. Paralelização/espelhamento de tráfego
TL;DR: Envie um pedido para vários locais ao mesmo tempo.
Às vezes, há a necessidade de enviar um pedido (ou uma seleção de pedidos) para vários serviços ao mesmo tempo. Um exemplo típico é o envio de uma parte do tráfego de produção para um serviço de staging. O servidor web principal da produção envia um pedido para o serviço downstream products.production e apenas para ele. E a service mesh copia inteligentemente esse pedido e o envia para products.staging, do qual o servidor web não possui conhecimento.
Outro cenário de uso relacionado à service mesh que pode ser implementado sobre a paralelização do tráfego é o . Este envolve enviar os mesmos pedidos para diferentes versões do serviço e verificar se todas as versões se comportam da mesma forma. Até agora, não encontrei uma implementação de service mesh com um sistema de testes de regressão integrado como o , mas a ideia em si parece promissora.
12. Isolamento
TL;DR: Divida sua service mesh em mini-redes.
Também conhecido como segmentação, o isolamento é a arte de dividir a service mesh em segmentos logicamente separados, que não têm conhecimento uns dos outros. O isolamento é um pouco semelhante à criação de redes privadas virtuais. Porém, a diferença principal é que você ainda pode aproveitar todas as vantagens da service mesh (como a descoberta de serviços), mas com segurança adicional. Por exemplo, se um invasor conseguir infiltrar-se em um serviço em uma das sub-redes, ele não poderá ver quais serviços estão em execução em outras sub-redes ou interceptar seu tráfego.
Além disso, as vantagens podem ser organizacionais. Pode ser desejável dividir os serviços em sub-redes com base na estrutura da empresa e liberar os desenvolvedores da carga cognitiva de ter que manter em mente toda a service mesh.
13. Limitação da taxa de solicitações, tentativas de repetição e timeouts
TL;DR: Não é mais necessário incluir na base de código tarefas urgentes de gerenciamento de solicitações.
Todas essas coisas poderiam ser vistas como casos de uso separados, mas decidi agrupá-las devido a uma característica comum: elas assumem as tarefas de gerenciamento do ciclo de vida das solicitações, geralmente tratadas por bibliotecas de aplicativos. Se você estiver desenvolvendo um servidor web em Ruby on Rails (não integrado com service mesh), que faz solicitações a serviços de backend através de , o aplicativo precisará decidir o que fazer se N solicitações falharem. Também será necessário descobrir qual volume de tráfego esses serviços conseguem processar e 'hardcode' esses parâmetros utilizando uma biblioteca especial. Além disso, o aplicativo deve resolver quando é a hora de desistir e permitir que a solicitação expire (por timeout). Para modificar qualquer um dos parâmetros acima, o servidor web precisará ser parado, reconfigurado e reiniciado.
Transferir essas tarefas para a service mesh significa não apenas que os desenvolvedores de serviços não precisarão se preocupar com elas, mas também que elas poderão ser vistas de uma maneira mais global. Se uma cadeia complexa de serviços estiver em uso, digamos, A → B → C → D → E, é necessário considerar todo o ciclo de vida da solicitação. Se a tarefa for aumentar os timeouts no serviço C, é lógico fazê-lo de uma só vez, e não em partes: atualizando o código do serviço e aguardando até que a pull request seja aceita e o sistema CI desplante o serviço atualizado.
14. Telemetria
TL;DR: Coletar todas as informações necessárias (e nem tão necessárias) dos serviços.
Telemetria é um termo genérico que abrange métricas, rastreamento distribuído e logs. As service meshes oferecem mecanismos para coletar e processar todos os três tipos de dados. Aqui as coisas ficam um pouco vagas, pois o número de possibilidades é muito grande. Para coleta de métricas, existem e outras ferramentas, para coleta de logs pode-se usar , , e outras. (como ClickHouse com nosso para K8s — nota do tradutor.), para rastreamento distribuído existe e assim por diante. Cada service mesh pode suportar algumas ferramentas e não suportar outras. Será interessante ver se o projeto pode proporcionar alguma convergência.
Neste caso, a vantagem da tecnologia service mesh é que os containers sidecar podem, em princípio, coletar todos os dados mencionados de seus serviços. Em outras palavras, você obtém um sistema unificado de coleta de telemetria, e o service mesh pode processar essas informações de várias maneiras. Por exemplo:
- monitorar logs de um determinado serviço no CLI;
- acompanhar o volume de requisições no painel de controle do service mesh;
- coletar rastreamentos distribuídos e redirecioná-los para um sistema como o Jaeger.
Atenção, opinião subjetiva: De modo geral, a telemetria é uma área onde a intervenção do service mesh é indesejável. Coletar informações básicas e monitorar em tempo real algumas "métricas essenciais" como a porcentagem de requisições bem-sucedidas e latências é aceitável, mas vamos torcer para não testemunharmos o surgimento de pilhas Frankenstein que tentem substituir sistemas especializados, alguns dos quais já estão bem estabelecidos e estudados.
15. Auditoria
TL;DR: Quem esquece as lições da história está condenado a repeti-las.
A auditoria é a arte de observar eventos importantes em um sistema. No caso do service mesh, isso pode significar monitorar quem fez requisições a endpoints específicos de certos serviços ou quantas vezes, no último mês, ocorreu um determinado evento relacionado à segurança.
É claro que a auditoria está muito relacionada à telemetria. A diferença é que a telemetria geralmente se associa a aspectos como desempenho e eficiência técnica, enquanto a auditoria pode envolver questões legais e outras que vão além do âmbito técnico estrito (por exemplo, conformidade com o GDPR ― Regulamento Geral sobre a Proteção de Dados da UE).
16. Visualização
TL;DR: Viva o React.js ― uma fonte inesgotável de interfaces peculiares.
Pode haver um termo mais adequado, mas eu não o conheço. Estou me referindo à representação gráfica do service mesh ou de alguns de seus componentes. Essas visualizações podem incluir indicadores como latências médias, informações sobre a configuração dos containers sidecar, resultados de verificações de saúde e alertas.
Trabalhar em um ambiente orientado a serviços envolve uma carga cognitiva muito maior em comparação com Sua Majestade o Monólito. Portanto, a pressão cognitiva deve ser reduzida a qualquer custo. Uma interface gráfica banal para service mesh com a possibilidade de clicar em um botão e obter o resultado desejado pode ser decisiva para o aumento da popularidade dessa tecnologia.
Não foram incluídos na lista
Inicialmente, eu pretendia incluir mais alguns cenários de uso na lista, mas depois decidi não fazer isso. Aqui estão eles, juntamente com as razões da minha decisão:
- Multi-data center. Na minha visão, isso não é tanto um cenário de uso, mas uma área estreita e específica de aplicação de service meshes ou de um conjunto de funcionalidades como descoberta de serviços.
- Ingress e egress. Esta é uma área relacionada, mas limitei-me (talvez de forma artificial) ao cenário de uso 'tráfego leste-oeste'. Ingress e egress merecem um artigo separado.
Conclusão
Por enquanto é tudo! Novamente, esta lista é bastante condicional e provavelmente incompleta. Se você acha que eu deixei algo de fora ou cometi um erro, entre em contato comigo no Twitter (). Por favor, mantenha as normas de respeito.
P.S. do tradutor
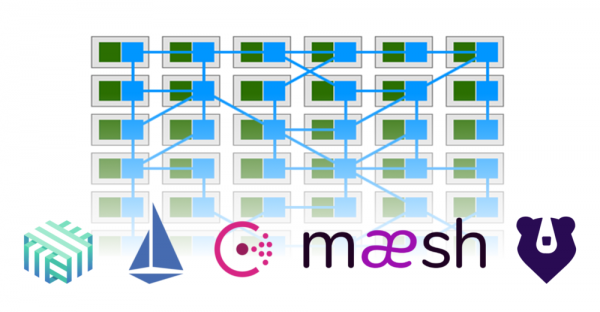
Como base para a ilustração de capa do artigo, foi utilizado um imagem da matéria '' (autor — Gregory MacKinnon). Nela, é mostrado como parte da funcionalidade dos aplicativos (em verde) foi transferida para o service mesh, que garante as interconexões entre eles (em azul).
Confira também em nosso blog:
- «»;
- «»;
- «».
Fonte: habr.com
