

No SQL, você descreve 'o que' deseja obter, e não 'como' isso deve ser executado. Portanto, o problema do desenvolvimento de consultas SQL no estilo 'como se escreve' ocupa o seu lugar de honra, ao lado de .
Hoje, através de exemplos extremamente simples, veremos a que isso pode levar no contexto do uso de GROUP/DISTINCT e LIMIT junto com eles.
Se você escreveu na consulta 'primeiro junte essas tabelas, e depois elimine todos os duplicados, deve permanecer apenas uma instância para cada chave' — é exatamente assim que funcionará, mesmo que a junção não fosse necessária.
E às vezes é sorte que 'simplesmente funciona', às vezes, isso afeta negativamente o desempenho, e às vezes resulta em efeitos totalmente inesperados do ponto de vista do desenvolvedor.
Bem, talvez não tão espetaculares, mas...
'Dois em um': JOIN + DISTINCT
SELECT DISTINCT
  X.*
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
WHERE
  Y.bool_condition;
É claro que queríamos selecionar registros X para os quais existem relacionados em Y com a condição em execução.Escrevemos a consulta e JOIN recebemos alguns valores pk várias vezes (exatamente quantas entradas correspondentes havia em Y). Como remover? Claro DISTINCT!
Especialmente 'alegre', quando para cada registro X há várias centenas de registros Y relacionados, e então os duplicados são heroicamente removidos...
Como corrigir? Para começar, perceber que a tarefa pode ser modificada para 'selecionar registros X para os quais em Y há PELO MENOS UMA entrada relacionada com a condição em execução' — pois da própria entrada Y não precisamos de nada.
EXISTS aninhado
SELECT
  *
FROM
  X
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  );
Algumas versões do PostgreSQL entendem que no EXISTS é suficiente encontrar o primeiro registro que aparece, as mais antigas não. Portanto, prefiro sempre indicar LIMIT 1 dentro EXISTS.
LATERAL JOIN
SELECT
  X.*
FROM
  X
, LATERAL (
    SELECT
      Y.*
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  ) Y
WHERE
  Y IS DISTINCT FROM NULL;
Essa mesma opção permite, se necessário, retornar imediatamente alguns dados do registro Y encontrado. Uma variante semelhante é abordada no artigo .
'Por que pagar mais': DISTINCT [ON] + LIMIT 1
Uma vantagem adicional dessa transformação de consulta é a possibilidade de facilmente restringir a seleção de registros, caso precise de apenas um/ou alguns deles, como no seguinte caso:
SELECT DISTINCT ON(X.pk)
  *
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Agora vamos ler a consulta e tentar entender o que se propõe a fazer o SGBD:
- unindo tabelas
- tornando únicas pelas X.pk
- das posições restantes, selecionamos uma
Então, o que obtemos? «Algum registro» das unicidades — e se pegarmos este um dos não únicos, o resultado mudará de alguma forma?.. «E se não houver diferença, por que pagar mais?»
SELECT
  *
FROM
  (
    SELECT
      *
    FROM
      X
    -- aqui podem ser inseridas condições adequadas
    LIMIT 1 -- +1 Limite
  ) X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
E o mesmo tema com GROUP BY + LIMIT 1.
«Só para perguntar»: GROUP implícito + LIMIT
Essas situações ocorrem em várias verificações de não vazios tabelas ou CTE durante a execução da consulta:
...
CASE
  WHEN (
    SELECT
      count(*)
    FROM
      X
    LIMIT 1
  ) = 0 THEN ...
Funções agregadas (count/min/max/sum/...) são executadas com sucesso em todo o conjunto, mesmo sem indicação explícita GROUP BY. Mas com LIMIT não são muito amigos.
O desenvolvedor pode achar «se houver registros, então preciso de no máximo LIMIT». Mas não deve ser assim! Porque para o banco é:
- conte o que precisam retorne tantas linhas quanto solicitado
- Dependendo das condições alvo, aqui é apropriado realizar uma das substituições:
(count + LIMIT 1) = 0
NOT EXISTS(LIMIT 1)para(count + LIMIT 1) > 0EXISTS(LIMIT 1)paracount >= N(SELECT count(*) FROM (... LIMIT N))para«Quanto pesar em gramas»: DISTINCT + LIMIT
SELECT DISTINCT pk FROM X LIMIT $1
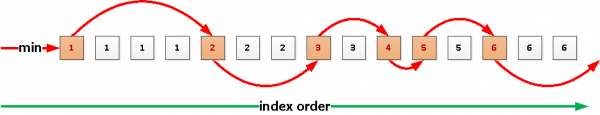
Um desenvolvedor ingênuo pode sinceramente acreditar que a execução da consulta será interrompida,assim que encontrarmos os $1 primeiros valores diferentes que aparecerem Um dia no futuro, isso pode funcionar assim, graças a um novo nó.
Index Skip Scan , cuja implementação está sendo trabalhada atualmente, mas por enquanto — não acontece.Por enquanto, primeiro
todos os registros serão extraídos , tornados únicos, e somente deles será retornado o quanto foi solicitado. É especialmente triste se queríamos algo como, mas os registros na tabela são centenas de milhares... $1 = 4Para não ficar triste à toa, vamos usar uma consulta recursiva
«DISTINCT para os pobres» do PostgreSQL Wiki :
Fonte: habr.com
