

Olá, Habr! Neste momento, a OTUS está com inscrições abertas para uma nova turma do curso. Na véspera do início do curso, preparamos para você a tradução de um material interessante.
Todos os dias, mais de cem milhões de pessoas acessam o Twitter para saber o que está acontecendo no mundo e discutir isso. Cada tweet e qualquer outra ação do usuário geram um evento disponível para análise interna de dados no Twitter. Centenas de funcionários analisam e visualizam esses dados, e melhorar sua experiência é a principal prioridade da equipe da Plataforma de Dados do Twitter.
Acreditamos que usuários com uma ampla gama de habilidades técnicas devem ter a capacidade de encontrar dados e acesso a ferramentas eficazes de análise e visualização baseadas em SQL. Isso permitiria a um novo grupo de usuários com menos inclinações técnicas, incluindo analistas de dados e gerentes de produto, extrair insights dos dados, permitindo-lhes entender e aproveitar melhor as oportunidades do Twitter. Assim, democratizamos a análise de dados no Twitter.
À medida que aprimoramos nossas ferramentas e capacidades para análise interna de dados, testemunhamos melhorias no serviço do Twitter. No entanto, ainda há espaço para crescer. As ferramentas atuais, como o Scalding, requerem experiência em programação. As ferramentas de análise baseadas em SQL, como Presto e Vertica, enfrentam problemas de desempenho em grande escala. Também temos um desafio no compartilhamento de dados entre vários sistemas sem acesso contínuo a eles.
No ano passado, anunciamos uma , na qual estamos migrando partes de nossa para o Google Cloud Platform (GCP). Concluímos que as ferramentas do Google Cloud podem nos ajudar em nossas iniciativas de democratização da análise, visualização e aprendizado de máquina no Twitter:
- : armazenamento corporativo de dados com mecanismo SQL baseado em , que é conhecido pela rapidez, simplicidade e capacidade de lidar com .
- uma ferramenta de visualização de grandes dados com recursos de colaboração, como no Google Docs.
Neste artigo, você aprenderá sobre nossa experiência com essas ferramentas: o que fizemos, o que aprendemos e o que faremos a seguir. Agora, vamos nos concentrar em análises em lote e interativas. A análise em tempo real será discutida no próximo artigo.
A história dos data warehouses no Twitter
Antes de nos aprofundarmos no BigQuery, é importante resumir brevemente a história dos data warehouses no Twitter. Em 2011, a análise de dados no Twitter era realizada no Vertica e Hadoop. Para criar o MapReduce no Hadoop, utilizávamos o Pig. Em 2012, substituímos o Pig pelo Scalding, que tinha uma API em Scala e oferecia vantagens como a capacidade de criar pipelines complexos e simplicidade nos testes. No entanto, para muitos analistas de dados e gerentes de produto, que se sentiam mais confortáveis trabalhando com SQL, isso representava uma curva de aprendizado bastante acentuada. Aproximadamente em 2016, começamos a usar o Presto como interface SQL para os dados do Hadoop. O Spark oferecia uma interface em Python, o que o tornava uma boa escolha para pesquisas ad hoc e aprendizado de máquina.
Desde 2018, utilizamos as seguintes ferramentas para análise e visualização de dados:
- Scalding para pipelines de produção
- Scalding e Spark para análise ad hoc de dados e aprendizado de máquina
- Vertica e Presto para análise SQL ad hoc e interativa
- Druid para acesso interativo, exploratório e de baixa latência a métricas de séries temporais
- Tableau, Zeppelin e Pivot para visualização de dados
Descobrimos que, embora essas ferramentas ofereçam recursos poderosos, enfrentávamos desafios em disponibilizar essas capacidades para um público mais amplo no Twitter. Ao expandir nossa plataforma com o Google Cloud, estamos focando na simplificação de nossas ferramentas analíticas para todo o Twitter.
O armazém de dados BigQuery do Google
Várias equipes no Twitter já incorporaram o BigQuery em alguns de seus pipelines de produção. Usando suas experiências, começamos a avaliar as capacidades do BigQuery para todos os cenários de uso no Twitter. Nosso objetivo era disponibilizar o BigQuery para toda a empresa, além de padronizá-lo e mantê-lo dentro do conjunto de ferramentas da Data Platform. Isso apresentou muitas dificuldades. Precisávamos desenvolver a infraestrutura para receber grandes volumes de dados de forma confiável, suportar a gestão de dados em escala empresarial, garantir controle de acesso adequado e proteger a privacidade dos clientes. Também tivemos que criar sistemas para distribuição de recursos, monitoramento e cobrança, para que as equipes pudessem utilizar o BigQuery de forma eficaz.
Em novembro de 2018, lançamos a versão alfa do BigQuery e do Data Studio para toda a empresa. Oferecemos aos funcionários do Twitter algumas das nossas tabelas mais utilizadas com dados pessoais limpos. O BigQuery foi utilizado por mais de 250 usuários de diferentes equipes, incluindo engenharia, finanças e marketing. Recentemente, eles realizaram cerca de 8 mil consultas, processando cerca de 100 PB por mês, sem contar as consultas agendadas. Recebendo feedbacks muito positivos, decidimos avançar e oferecer o BigQuery como o recurso principal para interação com dados no Twitter.
Aqui está o esquema de arquitetura de alto nível do nosso armazém de dados Google BigQuery.
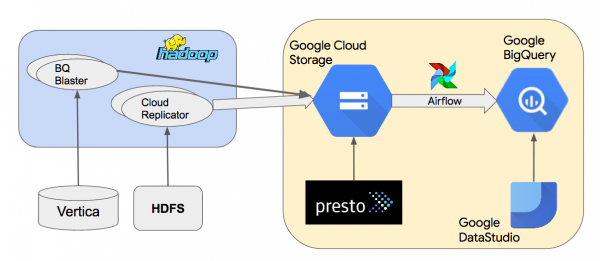
Copiamos dados de clusters Hadoop locais para o Google Cloud Storage (GCS), usando uma ferramenta interna chamada Cloud Replicator. Em seguida, usamos o Apache Airflow para criar pipelines que utilizam "" para carregar dados do GCS no BigQuery. Usamos o Presto para consultar conjuntos de dados Parquet ou Thrift-LZO no GCS. O BQ Blaster é uma ferramenta interna Scalding para carregar conjuntos de dados HDFS Vertica e Thrift-LZO no BigQuery.
Nas seções seguintes, discutiremos nossa abordagem e conhecimento em relação à facilidade de uso, desempenho, gerenciamento de dados, confiabilidade do sistema e custo.
Facilidade de uso
Descobrimos que os usuários tinham facilidade em começar a usar o BigQuery, pois não era necessário instalar software e os usuários podiam acessá-lo através de uma interface web intuitiva. No entanto, os usuários precisavam se familiarizar com algumas funcionalidades do GCP e suas concepções, incluindo recursos como projetos, conjuntos de dados e tabelas. Desenvolvemos materiais de treinamento e tutoriais para ajudar os usuários a começarem. Com uma compreensão básica, os usuários conseguiram navegar facilmente pelos conjuntos de dados, visualizar o esquema e os dados das tabelas, realizar consultas simples e visualizar os resultados no Data Studio.
Nosso objetivo em relação à entrada de dados no BigQuery era garantir o carregamento suave de conjuntos de dados HDFS ou GCS com um clique. Consideramos (Airflow gerenciado), mas não conseguimos utilizá-lo devido ao nosso modelo de segurança "Compartilhamento Restrito de Domínio" (mais detalhes na seção "Gerenciamento de Dados" abaixo). Experimentamos usar o Google Data Transfer Service (DTS) para organizar tarefas de carga no BigQuery. Embora o DTS tenha sido rapidamente configurado, ele não era flexível para construir pipelines com dependências. Para nossa versão alfa, criamos nosso próprio ambiente Apache Airflow no GCE e o estamos preparando para produção e para suportar mais fontes de dados, como Vertica.
Para transformar dados em BigQuery, os usuários criam pipelines de dados SQL simples utilizando consultas agendadas. Para pipelines complexos em múltiplas etapas com dependências, planejamos usar nossa própria infraestrutura Airflow ou o Cloud Composer junto com .
Desempenho
O BigQuery é projetado para consultas SQL de propósito geral que processam grandes volumes de dados. Não é destinado a consultas de baixa latência e alta capacidade, necessárias para bancos de dados transacionais, ou para análise de séries temporais com baixa latência, implementadas . Para consultas analíticas interativas, nossos usuários esperam um tempo de resposta inferior a um minuto. Precisávamos projetar o uso do BigQuery de forma a atender a essas expectativas. Para garantir um desempenho previsível para nossos usuários, utilizamos os recursos do BigQuery disponíveis para clientes com pagamento fixo, que permite aos proprietários de projetos reservar slots mínimos para suas consultas. O BigQuery é uma unidade de poder computacional necessária para executar consultas SQL.
Analisamos mais de 800 consultas, que processam cerca de 1 TB de dados cada, e descobrimos que o tempo médio de execução foi de 30 segundos. Também aprendemos que o desempenho depende muito do uso de nosso slot em diversos projetos e tarefas. Precisávamos distinguir claramente nossas reservas de slots para produção e ad hoc, a fim de manter o desempenho para cenários de uso produtivo e análise interativa. Isso influenciou bastante nosso design para a reserva de slots e a hierarquia dos projetos.
Sobre a gestão de dados, funcionalidades e custos dos sistemas, falaremos nos próximos dias na segunda parte da tradução, mas agora convidamos todos os interessados para um , onde será possível saber mais sobre o curso e também fazer perguntas ao nosso especialista — Yegor Mateshuk (Engenheiro de Dados Sênior, MaximaTelecom).
Leia mais:
Fonte: habr.com
