

Meu nome é Victor Yagofarov e eu sou responsável pelo desenvolvimento da plataforma Kubernetes na empresa DomClick como líder técnico da equipe de Ops. Gostaria de falar sobre como nossos processos de Dev Ops estão organizados, as particularidades da operação de um dos maiores clusters de k8s na Rússia, assim como as práticas de DevOps/SRE que nossa equipe aplica.
Equipe de Ops
Atualmente, a equipe de Ops conta com 15 pessoas. Três delas são responsáveis pelo escritório, duas trabalham em outro fuso horário e estão disponíveis, inclusive, à noite. Assim, sempre há alguém da Ops diante do monitor, pronto para reagir a incidentes de qualquer complexidade. Não temos plantões noturnos, o que ajuda a preservar nossa saúde mental e permite que todos descansem e aproveitem o tempo livre não apenas diante do computador.
As competências são variadas: especialistas em redes, DBA, profissionais de stack ELK, administradores/desenvolvedores de Kubernetes, especialistas em monitoramento, virtualização, hardware, etc. O que une a todos é que cada um pode substituir, em certa medida, qualquer um de nós: por exemplo, adicionar novos nós ao cluster k8s, atualizar o PostgreSQL, escrever pipelines CI/CD + Ansible, automatizar algo em Python/Bash/Go, conectar hardware no data center. Ter competências fortes em uma área não impede mudar de direção e começar a se desenvolver em outra. Por exemplo, entrei na empresa como especialista em PostgreSQL, e agora minha principal responsabilidade são os clusters Kubernetes. Na equipe, qualquer crescimento é bem-vindo e existe um forte senso de camaradagem.
Aliás, estamos contratando. Os requisitos para os candidatos são bastante padrão. Pessoalmente, acho importante que a pessoa se encaixe na equipe, seja pacífica, mas também saiba defender seu ponto de vista, deseje se desenvolver e não tenha medo de fazer algo novo, propondo suas próprias ideias. Além disso, habilidades de programação em linguagens de script são obrigatórias, assim como o conhecimento básico de Linux e inglês. O inglês é necessário apenas para que, em caso de problemas, a pessoa possa buscar uma solução em 10 segundos, e não em 10 minutos. Especialistas com profundo conhecimento de Linux são muito difíceis de encontrar hoje em dia: é engraçado, mas dois candidatos em três não conseguem responder à pergunta 'O que é Load Average? De onde ele vem?'. E consideram que a pergunta 'Como coletar um core dump de um programa em C' é algo de um mundo de superhumanos... ou dinossauros. Temos que conviver com isso, já que normalmente as pessoas têm outras competências muito desenvolvidas, e nós ensinaremos sobre 'Linux'. A resposta para a pergunta 'por que tudo isso é importante para um engenheiro DevOps no mundo moderno das nuvens' terá que ficar de fora deste artigo, mas, em três palavras: tudo isso é necessário.
Equipe de Ferramentas
A equipe de Ferramentas desempenha um papel significativo na automação. Sua principal tarefa é criar ferramentas gráficas e CLI convenientes para desenvolvedores. Por exemplo, nosso desenvolvimento interno Confer permite, literalmente, com alguns cliques do mouse, implantar um aplicativo no Kubernetes, configurar recursos, chaves do vault, etc. Antes, usávamos Jenkins + Helm 2, mas tivemos que desenvolver nossa própria ferramenta para eliminar a necessidade de copiar e colar e trazer uniformidade ao ciclo de vida do software.
A equipe Ops não escreve pipelines para os desenvolvedores, mas pode oferecer consultoria sobre qualquer dúvida em sua elaboração (alguns ainda têm Helm 3).
DevOps
No que diz respeito ao DevOps, vemos dessa forma:
As equipes de Dev escrevem código e o implantam através do Confer em dev -> qa/stage -> prod. A responsabilidade por garantir que o código não trave e não gere erros recai sobre as equipes de Dev e Ops. Durante o dia, a primeira pessoa a reagir a um incidente com seu aplicativo deve ser, em primeiro lugar, o responsável da equipe Ops, e durante a noite e no período da madrugada, o administrador de plantão (Ops) deve acordar o desenvolvedor de plantão, se souber com certeza que o problema não está na infraestrutura. Todas as métricas e alertas na monitoramento aparecem automaticamente ou semi-automaticamente.
A área de responsabilidade das Ops começa a partir do momento em que a aplicação é implantada em produção, mas a responsabilidade dos Devs não termina aqui — estamos todos juntos na mesma jornada.
Os desenvolvedores consultam os administradores se precisarem de ajuda na criação de um microserviço administrativo (por exemplo, backend em Go + HTML5), e os administradores consultam os desenvolvedores sobre quaisquer questões relacionadas à infraestrutura ou ao k8s.
A propósito, não temos um monólito, apenas microserviços. O número oscila entre 900 e 1000 no cluster k8s em produção, se medido pela quantidade. implantaçõesO número de pods varia entre 1700 e 2000. Atualmente, há cerca de 2000 pods no cluster de produção.
Não posso fornecer números exatos, pois monitoramos microserviços desnecessários e os eliminamos de forma semi-automática. O monitoramento de entidades desnecessárias em k8s é facilitado pelo , o que economiza recursos e dinheiro.
Gerenciamento de recursos
Monitoramento
Um pilar fundamental na operação de um grande cluster é um monitoramento bem estruturado e informativo. Até o momento, não encontramos uma solução universal que atenda 100% das necessidades de monitoramento, por isso, ocasionalmente criamos diferentes soluções personalizadas nesse ambiente.
- Zabbix. O monitoramento tradicional, que serve principalmente para rastrear o estado geral da infraestrutura. Ele nos informa quando um nó falha devido à CPU, memória, discos, rede, e assim por diante. Nada de extraordinário, mas também temos um DaemonSet separado de agentes que, por exemplo, monitoram o estado do DNS no cluster: procuramos pods coredns com problemas e verificamos a acessibilidade de hosts externos. À primeira vista, pode parecer desnecessário, mas em grandes volumes de tráfego, esse componente é um ponto crítico de falha. Já mencionei anteriormente , como lidei com a performance do DNS no cluster.
- Prometheus Operator. Um conjunto de diferentes exportadores oferece uma visão abrangente de todos os componentes do cluster. Em seguida, visualizamos tudo isso em grandes painéis no Grafana, e para notificações, usamos o alertmanager.
Outro instrumento útil para nós foi . Nós o desenvolvemos após enfrentarmos várias vezes a situação em que uma equipe sobrepõe suas configurações de Ingress com as de outra equipe, resultando em erros 50x. Agora, antes de fazer o deploy em produção, os desenvolvedores verificam se não vão afetar ninguém, e para minha equipe, isso é uma boa ferramenta para diagnóstico inicial de problemas com Ingress. Curiosamente, ele foi inicialmente criado para administradores e tinha uma aparência bastante 'rústica', mas depois que a ferramenta se tornou popular entre as equipes de desenvolvimento, ela se transformou bastante e passou a não parecer mais 'uma interface feita por um administrador para administradores'. Em breve, abandonaremos essa ferramenta e situações como essas serão validadas antes do lançamento do pipeline.
Recursos de equipes no ‘Kube’
Antes de iniciarmos os exemplos, é importante explicar como funcionamos na alocação de recursos para microsserviços.
Para entender quais equipes e em que quantidades utilizam seus recursos (CPU, memória, SSD local), alocamos para cada equipe seu próprio namespace no ‘Kube’ e limitamos suas capacidades máximas em termos de CPU, memória e disco, previamente discutindo as necessidades das equipes. Assim, uma equipe, em geral, não bloqueia o cluster inteiro para deploy, alocando milhares de núcleos e terabytes de memória para si. Os acessos no namespace são concedidos através do AD (utilizamos RBAC). Os namespaces e seus limites são adicionados através de um pull request no repositório GIT, e em seguida, tudo é automaticamente implementado através do pipeline Ansible.
Exemplo de alocação de recursos para uma equipe:
namespaces:

  chat-team:
    pods: 23
    limits:
      cpu: 11
      memory: 20Gi
    requests:
      cpu: 11
      memory: 20Gi
Requisições e limites
No ‘Kube’ Request é a quantidade de recursos garantidamente reservados para pod (um ou mais contêineres Docker) no cluster. Limit — é o máximo não garantido. Muitas vezes, é possível observar em gráficos que uma equipe atribuiu muitos requests para todos os seus aplicativos e não consegue fazer o deploy de um aplicativo no ‘Kube’, pois sob seu namespace todos os requests já foram 'usados'.
A saída correta de tal situação: observar o consumo real de recursos e comparar com a quantidade solicitada (Request).
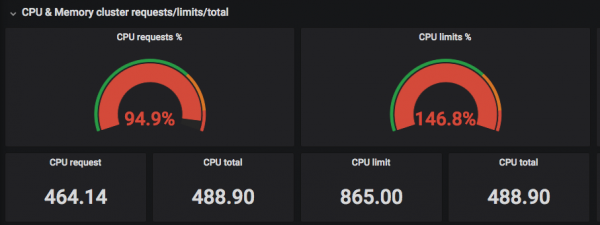
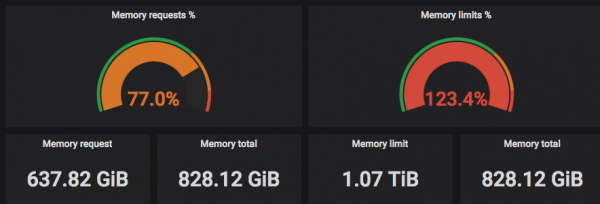
Nas capturas de tela acima, é possível ver que os 'solicitados' (Requested) de CPU estão se aproximando da quantidade real de threads, enquanto os Limits podem exceder a quantidade real de threads dos processadores centrais.
Agora vamos analisar detalhadamente um namespace (escolhi o namespace kube-system — o namespace do sistema para os componentes do próprio ‘Kubernetes’) e observar a relação entre o tempo de CPU e memória realmente utilizados e o que foi solicitado:
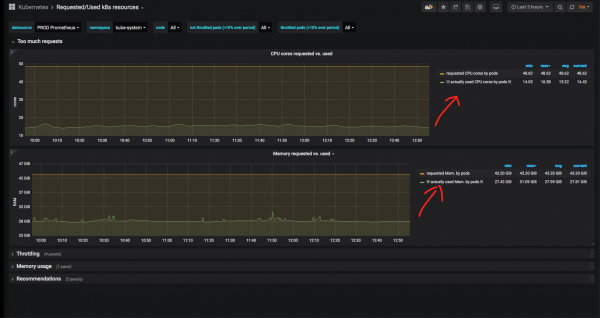
É evidente que a memória e o CPU reservados para os serviços do sistema são muito maiores do que os realmente utilizados. No caso do kube-system, isso é justificado: houve momentos em que o nginx ingress controller ou o nodelocaldns estavam no limite do CPU e consumiam muita RAM, então essa reserva é justificável. Além disso, não podemos confiar em gráficos das últimas 3 horas: é desejável ver métricas históricas de um período longo.
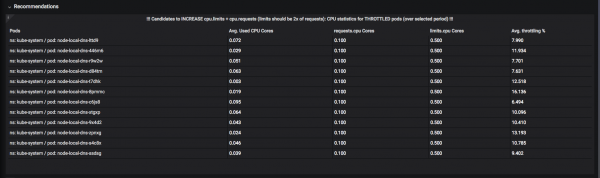
Foi desenvolvida um sistema de ‘recomendações’. Por exemplo, aqui podemos ver quais recursos seria melhor aumentar os ‘limites’ (o teto permitido), para evitar ‘throttling’ (estrangulamento): o momento em que já se gastou CPU ou memória dentro do seu tempo alocado e está aguardando ser ‘descongelado’:
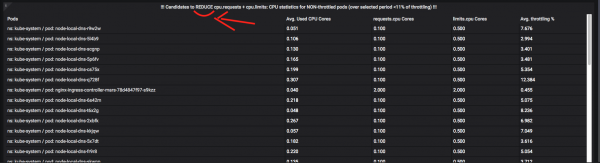
E aqui estão os pods que deveriam moderar seus apetites:
Sobre throttling + monitoramento de recursos pode render várias matérias, então perguntem nos comentários. Em poucas palavras, posso dizer que a tarefa de automatizar essas métricas é bastante complexa e exige muito tempo e malabarismos com funções ‘window’ e ‘CTE’ no Prometheus / VictoriaMetrics (esses termos estão entre aspas, pois no PromQL praticamente não há algo assim, e precisamos criar consultas complexas em vários painéis de texto e otimizá-las).
Em resumo, os desenvolvedores têm ferramentas para monitorar seus namespaces no ‘Kubernetes’, e eles podem escolher onde e em que momento recursos podem ser ‘cortados’ e quais pods podem receber todo o CPU a noite inteira.
Metodologias
Na empresa, como agora está na moda, seguimos práticas de DevOps e SRE- práticas. Quando há 1000 microsserviços na empresa, cerca de 350 desenvolvedores e 15 administradores para toda a infraestrutura, é preciso ‘estar na moda’: por trás de todos esses ‘buzzwords’ há uma necessidade urgente de automatização de tudo, e os administradores não devem ser o gargalo nos processos.
Como Ops, fornecemos várias métricas e dashboards para os desenvolvedores, relacionados à velocidade de resposta dos serviços e seus erros.
Utilizamos metodologias como: , e , combinando-os. Tentamos minimizar o número de dashboards para que, à primeira vista, seja claro qual serviço está em degradação (por exemplo, códigos de resposta por segundo, tempo de resposta no percentil 99), e assim por diante. Assim que novas métricas são necessárias para nossos dashboards gerais, as desenhamos e adicionamos imediatamente.
Não desenhei gráficos há um mês. Provavelmente, isso é um bom sinal: significa que a maioria dos desejos já foi realizada. Houve momentos em que, em uma semana, eu desenhava pelo menos um novo gráfico por dia.
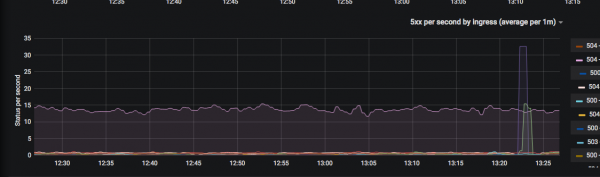
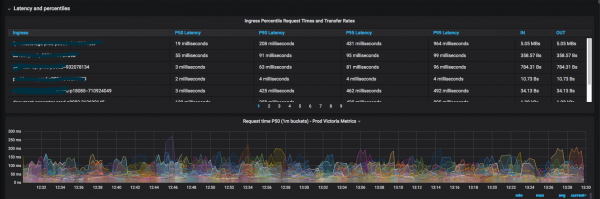
O resultado obtido é valioso porque agora os desenvolvedores raramente vão aos administradores com perguntas sobre 'onde verificar uma métrica'.
Implementação Service Mesh não está longe e deve facilitar muito a vida de todos; os colegas da equipe de Ferramentas estão perto de implementar uma versão abstrata do 'Istio de um usuário saudável': o ciclo de vida de cada solicitação HTTP(s) será visível no monitoramento, e será possível entender 'em qual etapa tudo falhou' durante a interação entre serviços (e não só). Inscreva-se para as novidades do hub da empresa DomClick. =)
Apoio à infraestrutura do Kubernetes
Historicamente, usamos uma versão patchada Kubespray — Função Ansible para implantação, expansão e atualização do Kubernetes. Em algum momento, o suporte a instalações não kubeadm foi removido da branch principal, e o processo de transição para kubeadm não foi proposto. Como resultado, a empresa Southbridge fez seu fork (com suporte a kubeadm e rápida correção de problemas críticos).
O processo de atualização de todos os clusters k8s é o seguinte:
- Pegamos Kubespray da Southbridge, comparamos com nossa branch e mesclamos.
- Vamos liberar a atualização em Stress- 'Kube'.
- Fazemos a atualização nó por nó (em Ansible isso é 'serial: 1') em Dev- 'Kube'.
- Atualizamos Prod no sábado à noite nó por nó.
No futuro, temos planos de substituir Kubespray por algo mais rápido e migrar para kubeadm.
Temos três 'Kubes': Stress, Dev e Prod. Planejamos lançar mais um (hot standby) Kube Prod no segundo Data Center. Stress e Dev vivem em 'máquinas virtuais' (oVirt para Stress e VMWare cloud para Dev). Prod- 'Kube' vive em 'bare metal': são nós iguais com 32 threads de CPU, 64-128 Gb de RAM e 300 Gb de SSD RAID 10 — ao todo são 50. Três nós 'finos' são dedicados ao 'mestre' do Prod- 'Kube': 16 Gb de RAM, 12 threads de CPU.
Para produção, preferimos usar 'bare metal' e evitar camadas desnecessárias como OpenStack: não precisamos de 'vizinhos barulhentos' e CPU steal time. E a complexidade da administração aumenta aproximadamente em duas vezes no caso do OpenStack in-house.
Para CI/CD de "Kubernetes" e outros componentes de infraestrutura, usamos um servidor GIT separado, Helm 3 (passamos por uma transição bastante difícil do Helm 2, mas estamos muito satisfeitos com a opção atomic), Jenkins, Ansible e Docker. Gostamos de branches de feature e de implementar em diferentes ambientes a partir de um único repositório.
Conclusão
Assim, de maneira geral, o processo DevOps na empresa DomClick parece do ponto de vista de um engenheiro de operações. O artigo ficou menos técnico do que eu esperava: portanto, fique atento às novidades da DomClick no Habré: haverá artigos mais "hardcore" sobre Kubernetes e muito mais.
Fonte: habr.com
