

Olá a todos! Meu nome é Nikolai Golov. Antes, trabalhei na Avito e por seis anos liderava a Data Platform, ou seja, lidava com todos os bancos de dados: analíticos (Vertica, ClickHouse), de fluxo e OLTP (Redis, Tarantool, VoltDB, MongoDB, PostgreSQL). Durante esse tempo, me aprofundei em uma grande variedade de bancos de dados — os mais diversos e incomuns, assim como casos de uso não convencionais.
Atualmente, trabalho na ManyChat. Basicamente, é uma startup — nova, ambiciosa e em rápido crescimento. E quando eu entrei na empresa, surgiu a pergunta clássica: "O que uma startup jovem deve escolher no mercado de SGBDs e bancos de dados?".
Neste artigo, baseado na minha apresentação no , responderei a essa pergunta. A versão em vídeo da apresentação está disponível em .
Bancos de dados bem conhecidos de 2020
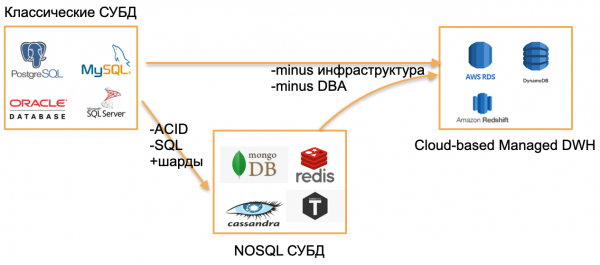
Estamos em 2020, olhei ao meu redor e vi três tipos de bancos de dados.
O primeiro tipo — bancos OLTP clássicos: PostgreSQL, SQL Server, Oracle, MySQL. Eles foram criados há muito tempo, mas ainda são relevantes, pois são bem conhecidos pela comunidade de desenvolvedores.
O segundo tipo — bancos dos anos 2000. Eles tentaram se distanciar dos padrões clássicos abandonando o SQL, estruturas tradicionais e ACID, introduzindo sharding embutido e outras funcionalidades atraentes. Por exemplo, Cassandra, MongoDB, Redis ou Tarantool. Todas essas soluções queriam oferecer algo realmente novo ao mercado e encontraram seu nicho, pois se mostraram extremamente convenientes para tarefas específicas. Esses bancos serão designados pelo termo genérico NOSQL.
"Os anos 2000" acabaram, os bancos NOSQL se tornaram familiares, e o mundo, na minha visão, deu o próximo passo — para bancos gerenciados. Com esses bancos, o núcleo é o mesmo dos bancos OLTP clássicos ou dos novos NoSQL. Mas eles não têm a necessidade de DBA e DevOps e operam em hardware gerenciado na nuvem. Para o desenvolvedor, é "apenas um banco", que funciona em algum lugar, e como foi instalado no servidor, quem configurou o servidor e quem o atualiza, ninguém se importa.
Exemplos desses bancos:
- AWS RDS — camada gerenciada sobre PostgreSQL/MySQL.
- DynamoDB — análogo da AWS de um banco baseado em documentos, parece com Redis e MongoDB.
- Amazon Redshift — banco analítico gerenciado.
São bancos antigos, mas elevados em um ambiente gerenciado, sem a necessidade de trabalhar com hardware.
Nota. Os exemplos foram retirados do ambiente AWS, mas seus análogos também existem no Microsoft Azure, Google Cloud ou Yandex.Cloud.
O que há de novo nisso? Em 2020, nada disso.
A conceito Serverless
O que realmente é novo no mercado em 2020 são as soluções serverless ou sem servidor.
Vou tentar explicar o que isso significa, usando o exemplo de um serviço comum ou de um aplicativo backend.
Para implantar um aplicativo backend comum, compramos ou alugamos um servidor, copiamos o código para ele, publicamos um endpoint para o exterior e pagamos regularmente pelo aluguel, eletricidade e serviços do data center. Este é o esquema padrão.
Há uma maneira diferente de fazer isso? Com serviços serverless é possível.
Qual é o foco dessa abordagem: sem servidor, sem mesmo alugar uma instância virtual na nuvem. Para implantar o serviço, apenas copiamos o código (funções) para um repositório e publicamos um endpoint. Depois, pagamos apenas por cada chamada dessa função, ignorando totalmente o hardware onde ela é executada.
Vou tentar ilustrar essa abordagem com imagens.
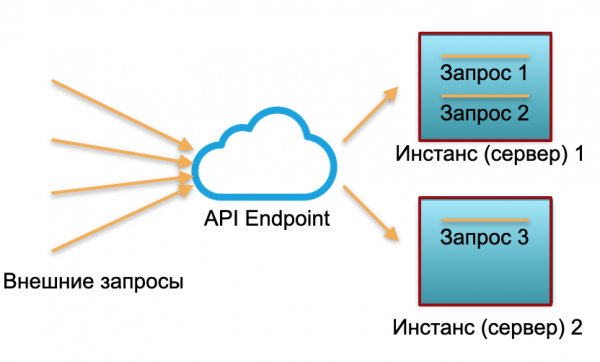
Implantação clássica. Temos um serviço com uma carga específica. Subimos duas instâncias: servidores físicos ou instâncias na AWS. As solicitações externas são direcionadas para essas instâncias, onde são processadas.
Como pode ser visto na imagem, os servidores não estão sendo utilizados de maneira uniforme. Um está 100% utilizado, com duas solicitações, enquanto o outro está apenas 50% utilizado — parcialmente inativo. Se recebemos não três solicitações, mas 30, o sistema não conseguirá suportar a carga e começará a desacelerar.
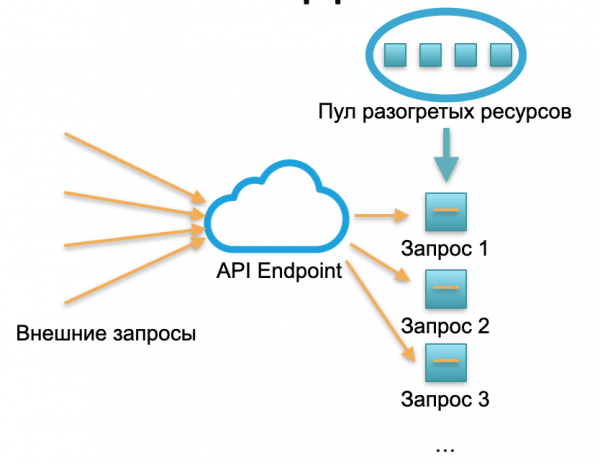
Implantação serverless. Em um ambiente serverless, esse tipo de serviço não possui instâncias ou servidores. Existe uma certa quantidade de recursos aquecidos — pequenos contêineres Docker preparados com o código da função implantada. O sistema recebe solicitações externas e para cada uma delas, o framework serverless inicia um pequeno contêiner com o código: processa exatamente essa solicitação e encerra o contêiner.
Uma solicitação — um contêiner iniciado, 1000 solicitações — 1000 contêineres. E a implantação em servidores físicos é trabalho do provedor da nuvem. Isso está completamente oculto pelo framework serverless. Nesta concepção, pagamos por cada chamada. Por exemplo, se chega uma chamada por dia — pagamos por uma chamada, se chegam um milhão por minuto — pagamos por um milhão. Ou por segundo, o que também acontece.
O conceito de publicar uma função serverless é adequado para serviços stateless. Mas se você precisa de um serviço statefull, adicionamos um banco de dados ao serviço. Nesse caso, quando se trata de trabalhar com o state, cada função statefull simplesmente lê e grava no banco de dados. E isso pode ser feito em qualquer um dos três tipos de banco de dados descritos no início do artigo.
Qual é a limitação comum a todos esses bancos? Os custos de um servidor em nuvem ou físico (ou vários servidores) em uso constante. Não importa se usamos um banco clássico ou gerenciado, se temos DevOps e um administrador ou não, ainda assim pagamos 24 horas por dia, 7 dias por semana, pelo hardware, eletricidade e locação do data center. Se temos um banco clássico, pagamos pelo master e pelo slave. Se é um banco sharded de alta carga — pagamos por 10, 20 ou 30 servidores e pagamos constantemente.
A presença de servidores constantemente reservados na estrutura de custos era antes vista como um mal necessário. Bancos convencionais também enfrentam outras complexidades, como limites no número de conexões, restrições de escalabilidade, consenso geodistribuído — algumas delas podem ser resolvidas em certos bancos, mas não todas ao mesmo tempo e de forma ideal.
Banco de dados serverless — teoria
Pergunta de 2020: é possível tornar um banco de dados serverless também? Todos ouviram sobre o backend serverless... então, por que não tentar tornar o banco de dados serverless?
Isso soa estranho, porque um banco de dados é um serviço statefull, não muito adequado para infraestruturas serverless. Além disso, o state de um banco de dados é muito grande: gigabytes, terabytes e, em bancos de dados analíticos, até petabytes. Isso não é fácil de executar em contêineres Docker leves.
Por outro lado, praticamente todos os bancos modernos envolvem uma enorme quantidade de lógica e componentes: transações, validação de integridade, procedimentos, dependências relacionais e muita lógica. Uma parte considerável da lógica de um banco de dados requer um state pequeno. Gigabytes e terabytes são usados apenas por uma pequena parte da lógica do banco de dados, relacionada à execução direta das consultas.
Assim, a ideia é: se parte da lógica permite execução stateless, por que não dividir o banco em partes Stateful e Stateless.
Serverless para soluções OLAP
Vamos ver como pode ser a divisão de um banco de dados em partes Stateful e Stateless através de exemplos práticos.
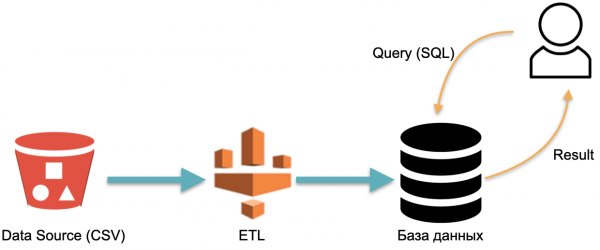
Por exemplo, temos um banco de dados analítico: dados externos (cilindro vermelho à esquerda), um processo ETL que carrega dados no banco e um analista que envia consultas SQL para o banco. Este é o esquema clássico de funcionamento de um armazém de dados.
Neste esquema, condicionalmente, o ETL é executado uma vez. Depois, precisamos pagar continuamente pelos servidores nos quais o banco com os dados carregados pelo ETL opera, para que haja algo para enviar consultas.
Vamos considerar uma abordagem alternativa implementada no banco AWS Athena Serverless. Aqui, não há hardware designado constantemente onde os dados carregados são armazenados. Em vez disso:
- O usuário envia uma consulta SQL para o Athena. O otimizador do Athena analisa a consulta SQL e procura no armazenamento de metadados os dados específicos necessários para executar a consulta.
- Com base nos dados coletados, o otimizador extrai os dados necessários de fontes externas para um armazenamento temporário (banco de dados temporário).
- No armazenamento temporário, a consulta SQL do usuário é executada e o resultado é retornado ao usuário.
- O armazenamento temporário é limpo e os recursos são liberados.
Nesta arquitetura, pagamos apenas pelo processo de execução da consulta. Não há consultas — não há gastos.
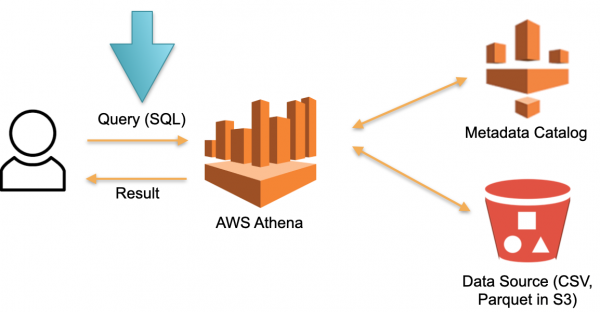
Esta é uma abordagem funcional e é implementada não apenas no Athena Serverless, mas também no Redshift Spectrum (na AWS).
No exemplo do Athena, fica claro que o banco de dados Serverless funciona com consultas reais contendo dezenas e centenas de terabytes de dados. Para centenas de terabytes, precisaríamos de centenas de servidores, mas não precisamos pagar por eles — pagamos pelas consultas. A velocidade de cada consulta é (muito) baixa em comparação com bancos de dados analíticos especializados como o Vertica, mas, em troca, não pagamos por períodos de inatividade.
Esse banco de dados é aplicável para consultas analíticas ad-hoc raras. Por exemplo, quando decidimos espontaneamente verificar uma hipótese em um volume gigantesco de dados. Para esses casos, o Athena é ideal. Para consultas regulares, esse sistema se torna caro. Neste caso, faça cache dos dados em alguma solução especializada.
Serverless para soluções OLTP
No exemplo anterior, foram consideradas tarefas OLAP (analíticas). Agora, vamos considerar tarefas OLTP.
Vamos apresentar um PostgreSQL ou MySQL escalável. Vamos levantar uma instância gerenciada comum de PostgreSQL ou MySQL com recursos mínimos. Quando a instância enfrentar uma carga maior, adicionaremos réplicas adicionais, nas quais distribuiremos parte da carga de leitura. Se não houver solicitações e carga, desativamos as réplicas. A primeira instância é o mestre, e as demais são as réplicas.
Essa ideia está implementada em uma base chamada Aurora Serverless da AWS. O princípio é simples: as solicitações de aplicativos externos são recebidas por uma frota de proxy. Ao perceber um aumento na carga, ela allocate recursos computacionais das instâncias mínimas previamente aquecidas — a conexão é realizada o mais rápido possível. A desativação das instâncias ocorre da mesma forma.
Dentro da Aurora, existe o conceito de Unidade de Capacidade Aurora, ACU. Isso é (condicionalmente) uma instância (servidor). Cada ACU específico pode ser mestre ou escravo. Cada Unidade de Capacidade possui sua própria memória RAM, processador e disco mínimo. Portanto, um é o mestre, e os demais são réplicas somente de leitura.
O número dessas Unidades de Capacidade Aurora em funcionamento é um parâmetro configurável. O número mínimo pode ser um ou zero (neste caso, a base não funciona se não houver solicitações).
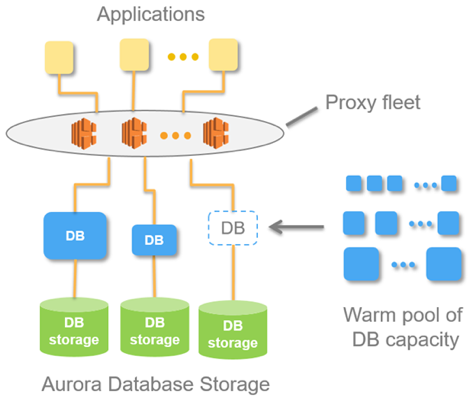
Quando a base recebe solicitações, a frota de proxy ativa as Unidades de Capacidade Aurora, aumentando os recursos produtivos do sistema. A capacidade de aumentar e diminuir recursos permite que o sistema "jogue" com os recursos: desativando automaticamente ACUs individuais (substituindo-os por novos) e aplicando todas as atualizações relevantes nos recursos desativados.
A base Aurora Serverless pode escalar a carga de leitura. Mas isso não é dito explicitamente na documentação. Pode parecer que eles conseguem levantar um multi-mestre. No entanto, não há nenhuma mágica.
Essa base é ideal para evitar gastar grandes quantias em sistemas com acesso imprevisível. Por exemplo, ao criar um MVP ou sites de marketing, geralmente não esperamos uma carga estável. Assim, na ausência de acesso, não pagamos por instâncias. Quando uma carga inesperada ocorre, como após uma conferência ou campanha publicitária, grandes volumes de visitantes acessam o site e a carga aumenta rapidamente; o Aurora Serverless assume automaticamente essa carga e conecta rapidamente os recursos ausentes (ACU). Depois da conferência, todos esquecem do protótipo, os servidores (ACU) desligam e os custos caem para zero — é conveniente.
Esta solução não é adequada para alta carga estável, pois não consegue escalar a carga de gravação. Todas essas conexões e desconexões de recursos ocorrem no chamado "ponto de escala" — o momento em que a base não está bloqueada por uma transação ou por tabelas temporárias. Por exemplo, ao longo de uma semana, o ponto de escala pode não ocorrer, e a base opera com os mesmos recursos sem poder se expandir ou se contrair.
Não há mágica — é um PostgreSQL comum. Mas o processo de adicionar máquinas e desconectar é parcialmente automatizado.
Serverless por design
O Aurora Serverless é uma base antiga reescrita para a nuvem, aproveitando as vantagens do Serverless. Agora, deixe-me falar sobre uma base que foi escrita desde o início para a nuvem, com uma abordagem serverless — Serverless-by-design. Ela foi desenvolvida sem a suposição de que funcionaria em servidores físicos.
Essa base é chamada Snowflake. Ela possui três blocos principais.
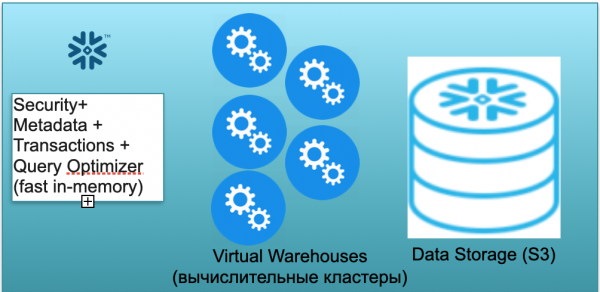
O primeiro — é o bloco de metadados. É um serviço rápido em memória que resolve questões relacionadas à segurança, metadados, transações e otimização de consultas (na ilustração à esquerda).
O segundo bloco — é um conjunto de vários clusters computacionais virtuais para cálculos (na ilustração — um conjunto de círculos azuis).
O terceiro bloco — é um sistema de armazenamento de dados baseado em S3. O S3 é um armazenamento de objetos escalável na AWS, semelhante a um Dropbox sem limites para empresas.
Vamos ver como o Snowflake funciona, assumindo um início a frio. Ou seja, o banco de dados existe, os dados estão carregados, mas não há consultas em execução. Assim, se não há consultas ao banco, temos um rápido serviço de Metadados em memória levantado (o primeiro bloco). E temos um armazenamento S3, onde os dados das tabelas estão armazenados, divididos em chamadas micrôpartições. Para simplificar: se a tabela contém negócios, as micrôpartições são dias de negócios. Cada dia é uma micrôpartição separada, um arquivo separado. E quando o banco está operando nesse modo, você paga apenas pelo espaço ocupado pelos dados. Além disso, a tarifa por espaço é muito baixa (especialmente considerando a compressão significativa). O serviço de metadados também está sempre ativo, mas para otimização de consultas, não precisa de muitos recursos, e o serviço pode ser considerado condicionalmente gratuito.
Agora, vamos imaginar que um usuário se conectou ao nosso banco de dados e enviou uma consulta SQL. A consulta SQL é imediatamente enviada para processamento pelo serviço de Metadados. Assim, ao receber a consulta, esse serviço analisa a consulta, os dados disponíveis, as permissões do usuário e, se tudo estiver bem, elabora um plano de processamento da consulta.
Em seguida, o serviço inicia a execução de um cluster de computação. O cluster de computação é um conjunto de servidores que realizam cálculos. Ou seja, é um cluster que pode conter 1 servidor, 2 servidores, 4, 8, 16, 32 — quantos você quiser. Você envia a consulta e, imediatamente, o início desse cluster começa. Isso realmente leva apenas alguns segundos.
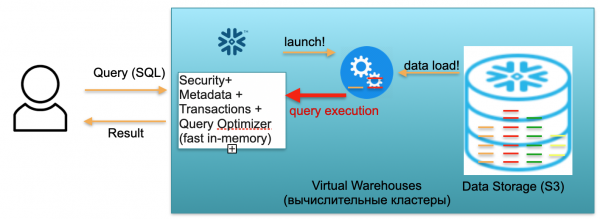
Depois que o cluster é iniciado, micropartições necessárias para processar a sua solicitação começam a ser copiadas do S3 para o cluster. Ou seja, suponha que para executar uma consulta SQL sejam necessárias duas partições de uma tabela e uma de outra. Nesse caso, somente três partições necessárias serão copiadas para o cluster, e não todas as tabelas inteiras. É por isso que, devido a tudo estar dentro de um único data center e conectado por canais muito rápidos, todo o processo de transferência ocorre muito rapidamente: em segundos, e raramente em minutos, a menos que se trate de consultas extremamente complexas. Assim, as micropartições são copiadas para o cluster computacional, e, ao final, essa consulta SQL é executada nesse cluster. O resultado dessa consulta pode ser uma linha, várias linhas ou uma tabela — que são enviadas para o usuário, para que ele possa exportar, exibir em sua ferramenta de BI, ou utilizá-las de qualquer outra forma.
Cada consulta SQL pode não apenas calcular agregados a partir de dados previamente carregados, mas também carregar/formar novos dados no banco. Ou seja, pode ser uma consulta que, por exemplo, insere novos registros em outra tabela, o que resulta na criação de uma nova partição no cluster computacional, que, por sua vez, é automaticamente salva no armazenamento S3 unificado.
O cenário descrito acima, desde a chegada do usuário até a ativação do cluster, carregamento de dados, execução de consultas e obtenção de resultados, é cobrado por tarifa por minutos de uso do cluster computacional virtual ativado, o warehouse virtual. A tarifa varia dependendo da zona AWS e do tamanho do cluster, mas, em média, custa alguns dólares por hora. Um cluster de quatro máquinas é duas vezes mais caro do que um de duas máquinas, e um de oito máquinas é ainda duas vezes mais caro. Estão disponíveis opções de 16, 32 máquinas, dependendo da complexidade das consultas. Mas você paga apenas pelos minutos em que o cluster realmente está em operação, pois, quando não há consultas, você 'retira a mão', e após 5-10 minutos de espera (um parâmetro configurável), ele se desligará automaticamente, liberando recursos e tornando-se gratuito.
É completamente viável que você faça uma solicitação, e o cluster apareça, digamos, em um minuto, depois ele leva mais um minuto para calcular, em seguida, cinco minutos para desligar, e no final você paga apenas por sete minutos de operação desse cluster, e não por meses ou anos.
O primeiro cenário descreveu o uso do Snowflake em um modo para um único usuário. Agora vamos imaginar que há muitos usuários, o que já se aproxima de um cenário real.
Suponha que temos muitos analistas e relatórios do Tableau que estão constantemente bombardeando nosso banco de dados com uma grande quantidade de consultas SQL analíticas simples.
Além disso, suponha que temos Data Scientists inventivos que estão tentando fazer coisas monstruosas com os dados, lidando com dezenas de Terabytes, analisando bilhões e trilhões de linhas de dados.
Para os dois tipos de carga descritos acima, o Snowflake permite a criação de vários clusters de computação independentes de diferentes potências. Esses clusters de computação funcionam de maneira independente, mas com dados comuns e consistentes.
Para um grande número de consultas leves, é possível criar 2-3 pequenos clusters, com, digamos, 2 máquinas cada. Esse comportamento é viável, inclusive, por meio de configurações automáticas. Ou seja, você diz: "Snowflake, levante um pequeno cluster. Se a carga aumentar além de um parâmetro específico, levante um segundo ou terceiro semelhante. Quando a carga diminuir, desligue os extras." Assim, independentemente de quantos analistas se apresentem e comecem a olhar os relatórios, todos terão recursos suficientes.
Nesse caso, se os analistas estiverem dormindo e ninguém estiver olhando os relatórios, os clusters podem ser completamente desligados, e você para de pagar por eles.
Para consultas pesadas (dos Data Scientists), você pode levantar um grande cluster com cerca de 32 máquinas. Esse cluster também será cobrado apenas pelos minutos e horas em que sua consulta gigante estiver sendo executada.
A possibilidade descrita acima permite dividir em clusters não apenas 2, mas também mais tipos de carga (ETL, monitoramento, materialização de relatórios,...).
Vamos resumir sobre o Snowflake. A base combina uma ideia bonita com uma implementação funcional. No ManyChat, usamos o Snowflake para a análise de todos os dados disponíveis. Temos clusters não três, como no exemplo, mas entre 5 e 9, de tamanhos diferentes. Temos clusters de 16 máquinas, de 2 máquinas e até super pequenos, com 1 máquina para algumas tarefas. Eles distribuem a carga com sucesso e nos permitem economizar significativamente.
A base escala com sucesso a carga de leitura e escrita. Esta é uma grande diferença e um grande avanço em comparação com a 'Aurora', que apenas suportava a carga de leitura. O Snowflake permite escalar também a carga de escrita com esses clusters computacionais. Ou seja, como mencionei, usamos vários clusters no ManyChat, sendo que os pequenos e super pequenos clusters são usados principalmente para ETL, para carregar dados. E os analistas operam em clusters médios, que não são afetados pela carga de ETL, portanto trabalham muito rapidamente.
Assim, a base é bem adequada para tarefas OLAP. No entanto, infelizmente, ainda não é aplicável a cargas OLTP. Primeiro, esta base é coluna, com todas as consequência que isso traz. Em segundo lugar, essa abordagem, onde se cria um cluster computacional para cada consulta à medida que necessário e o alimenta com dados, infelizmente, não é rápida o suficiente para cargas OLTP. Segundos de espera para tarefas OLAP são aceitáveis, mas para OLTP, é inaceitável, é melhor ter 100 ms, e ainda melhor — 10 ms.
Resultado
A base de dados sem servidor é possível devido à separação da base de dados em partes Stateless e Stateful. Você deve ter notado que em todos os exemplos citados, a parte Stateful é, por assim dizer, o armazenamento de micropartições no S3, enquanto a parte Stateless é o otimizador, a manipulação de metadados e o tratamento de questões de segurança, que podem ser levantadas como serviços Stateless leves e independentes.
A execução de consultas SQL também pode ser vista como serviços com estado leve, que podem surgir em modo sem servidor, como clusters computacionais do Snowflake, baixar apenas os dados necessários, executar a consulta e 'desligar-se'.
As bases de dados serverless de nível de produção já estão disponíveis para uso e estão operacionais. Essas bases de dados serverless já estão prontas para lidar com tarefas OLAP. Infelizmente, para tarefas OLTP, elas são aplicadas... com nuances, uma vez que existem limitações. Por um lado, isso é uma desvantagem. Mas, por outro lado, é uma oportunidade. É possível que algum dos leitores encontre uma maneira de tornar uma base de dados OLTP completamente serverless, sem as limitações do Aurora.
Espero que tenha achado interessante. Rumo ao futuro serverless 🙂
Fonte: habr.com
