

10 de agosto começou em Sloerm , onde analisamos completamente — desde as abstrações básicas até parâmetros de rede.
Neste artigo, vamos falar sobre a história do Docker e suas principais abstrações: Image, CLI, Dockerfile. A palestra é voltada para iniciantes, por isso dificilmente será interessante para usuários experientes. Não haverá sangue, apendicite ou mergulhos profundos. Apenas o básico.
O que é Docker
Vamos conferir a definição do Docker na Wikipédia.
Docker é um software para automação do deploy e gestão de aplicações em ambientes que suportam containerização.
Dessa definição, nada é claro. Especialmente o que significa 'em ambientes que suportam containerização'. Para entender, vamos voltar no tempo. Começaremos na época que chamo de 'Era Monolítica'.
Era Monolítica
A Era Monolítica é o início dos anos 2000, quando todas as aplicações eram monolíticas, com muitas dependências. O desenvolvimento era demorado. Naquela época, havia poucos servidores, conhecíamos todos pelo nome e monitorávamos. Há uma comparação interessante:
Pets — são animais de estimação. Na era monolítica, tratávamos nossos servidores como animais de estimação, cuidávamos e os zelávamos, tirando a poeira. E para melhor gestão dos recursos, utilizávamos virtualização: pegávamos um servidor e dividíamos em várias máquinas virtuais, garantindo assim o isolamento do ambiente.
Sistemas de virtualização baseados em hipervisor
Certamente, todos já ouviram falar de sistemas de virtualização: VMware, VirtualBox, Hyper-V, Qemu KVM etc. Eles fornecem isolamento de aplicações e gestão de recursos, mas têm suas desvantagens. Para fazer a virtualização, é necessário um hipervisor. E um hipervisor significa um overhead de recursos. Além disso, a própria máquina virtual geralmente é grande — uma imagem pesada, com sistema operacional, Nginx, Apache e possivelmente MySQL. A imagem é grande, operar com a máquina virtual pode ser inconveniente. Como consequência, o trabalho com máquinas virtuais pode ser lento. Para resolver esse problema, foram criados sistemas de virtualização em nível de kernel.
Sistemas de virtualização em nível de kernel
A virtualização em nível de kernel é suportada por sistemas como OpenVZ, Systemd-nspawn, LXC. Um exemplo claro dessa virtualização é o LXC (Linux Containers).
LXC — um sistema de virtualização no nível do sistema operacional que permite executar várias instâncias isoladas do sistema operacional Linux em um único nó. LXC não utiliza máquinas virtuais, mas cria um ambiente virtual com seu próprio espaço de processos e pilha de rede.
Basicamente, o LXC cria contêineres. Qual é a diferença entre máquinas virtuais e contêineres?
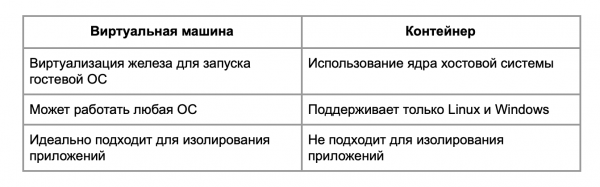
Um contêiner não é adequado para isolar processos: em sistemas de virtualização no nível do kernel, foram encontradas vulnerabilidades que permitem escapar do contêiner para o host. Portanto, se você precisa isolar algo, é melhor usar uma máquina virtual.
As diferenças entre virtualização e conteinerização podem ser vistas no esquema.
Existem hipervisores de hardware, hipervisores sobre o sistema operacional e contêineres.
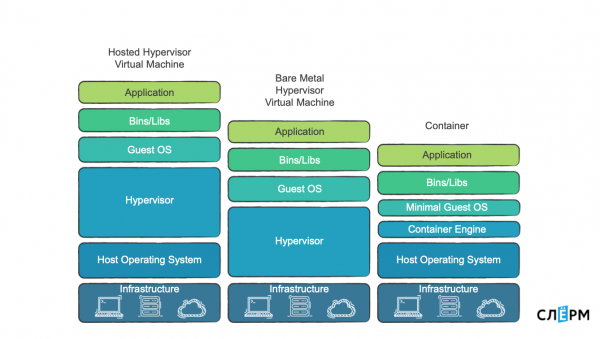
Os hipervisores 'de ferro' são uma ótima solução, se você realmente quer isolar algo. Porque existe a possibilidade de isolar no nível das páginas de memória e dos processadores.
Existem hipervisores como programas, e há contêineres, que será nosso foco a seguir. Em sistemas de conteinerização, não há hipervisor, mas existe um Container Engine, que cria e gerencia os contêineres. Essa abordagem é mais leve, portanto, devido à interação com o kernel, a sobrecarga é menor ou inexistente.
O que é usado para conteinerização no nível do kernel
As principais tecnologias que permitem criar contêineres isolados de outros processos são o Namespaces e os Control Groups.
Namespaces: PID, Networking, Mount e User. Existem outros, mas para simplificar, vamos nos concentrar nesses.
O Namespace de PID limita os processos. Quando, por exemplo, criamos um Namespace de PID e colocamos um processo nele, ele se torna PID 1. Normalmente, em sistemas, o PID 1 é o systemd ou init. Portanto, ao colocarmos um processo em um novo namespace, ele também recebe o PID 1.
O Networking Namespace permite limitar/isolacionar a rede e dentro dele, alocar suas próprias interfaces. Mount é a limitação do sistema de arquivos. User é a limitação de usuários.
Control Groups: Memória, CPU, IOPS, Rede — cerca de 12 configurações no total. Também são conhecidos como Cgroups ('C groups').
Os Control Groups gerenciam os recursos para o contêiner. Através dos Control Groups, podemos especificar que o contêiner não deve consumir mais do que uma certa quantidade de recursos.
Para que a containerização funcione plenamente, são utilizadas tecnologias adicionais: Capabilities, Copy-on-write e outras.
Capabilities são quando informamos ao processo o que ele pode ou não pode fazer. No nível do kernel, isso é apenas uma máscara de bits com uma série de parâmetros. Por exemplo, o usuário root tem plenas permissões e pode fazer tudo. Um servidor de tempo pode alterar a hora do sistema: ele tem capabilities sobre o Time Capsule, e é isso. Com as permissões, é possível configurar restrições de forma flexível para os processos, garantindo assim a segurança.
O sistema Copy-on-write nos permite trabalhar com imagens Docker, tornando seu uso mais eficiente.
Atualmente, o Docker tem problemas de compatibilidade com Cgroups v2, por isso, este artigo se concentra especificamente em Cgroups v1.
Mas vamos voltar à história.
Quando os sistemas de virtualização no nível do kernel surgiram, começaram a ser amplamente utilizados. O overhead do hypervisor desapareceu, mas alguns problemas permaneceram:
- imagens grandes: no OpenVZ, por exemplo, empurram o sistema operacional, bibliotecas e uma série de softwares, e no final, a imagem ainda acaba sendo considerável;
- não há um padrão adequado para empacotamento e entrega, portanto, a questão das dependências continua. Às vezes, duas partes de código usam uma biblioteca, mas com versões diferentes. Entre elas pode ocorrer um conflito.
Para resolver todos esses problemas, chegou a era seguinte.
A Era dos Contêineres
Quando a Era dos Contêineres chegou, a filosofia de trabalho com eles mudou:
- Um processo — um contêiner.
- Todas as dependências necessárias para o processo são entregues no seu contêiner. Isso requer desmembrar monólitos em microsserviços.
- Quanto menor a imagem, melhor — menor a possibilidade de vulnerabilidades, mais rápido a implantação, e assim por diante.
- As instâncias tornam-se efêmeras.
Lembre-se, eu mencionei sobre pets vs cattle? Antes, as instâncias eram como animais de estimação, agora tornaram-se como gado. Antes, havia um monólito — um único aplicativo. Agora são 100 microsserviços, 100 contêineres. Algumas contêineres podem ter 2-3 réplicas. Não é tão importante controlar cada contêiner. O que importa mais é a disponibilidade do serviço em si: o que esse conjunto de contêineres faz. Isso muda as abordagens de monitoramento.
Entre 2014-2015, houve um auge do Docker — a tecnologia da qual falaremos agora.
Docker mudou a filosofia e padronizou o empacotamento de aplicações. Com o Docker, podemos empacotar uma aplicação, enviá-la para um repositório, baixá-la e implantá-la.
Em um contêiner Docker, incluímos tudo o que é necessário, portanto, o problema das dependências é resolvido. O Docker garante a reprodutibilidade. Acredito que muitos já enfrentaram problemas de reprodutibilidade: tudo funciona para você, você faz o push para a produção e lá para de funcionar. Com o Docker, esse problema desaparece. Se o seu contêiner Docker inicia e faz o que precisa, há uma grande probabilidade de que ele inicie na produção e faça a mesma coisa.
Uma digressão sobre overhead
Sobre o overhead, há constantes debates. Alguns acreditam que o Docker não introduz carga adicional, pois utiliza o núcleo do Linux e todos os seus processos necessários para a contenorização. Dizem: 'se você afirma que o Docker é um overhead, então o núcleo do Linux também é um overhead'.
Por outro lado, se olharmos mais de perto, há realmente algumas coisas no Docker que podem ser discutidas como overhead.
A primeira é o namespace PID. Quando colocamos um processo em um namespace, ele recebe o PID 1. Ao mesmo tempo, esse processo tem outro PID, que está no namespace do host, fora do contêiner. Por exemplo, se iniciarmos o Nginx em um contêiner, ele se torna o PID 1 (processo mestre). E no host, seu PID é 12623. E é difícil dizer quão significativo é esse overhead.
A segunda questão são os Cgroups. Vamos considerar os Cgroups de memória, ou seja, a capacidade de limitar a memória de um contêiner. Quando isso é ativado, contadores são ativados, contabilização de memória: o núcleo precisa entender quantas páginas foram alocadas e quantas ainda estão livres para este contêiner. Isso pode ser overhead, mas não encontrei estudos precisos sobre como isso afeta o desempenho, e eu mesmo não percebi que uma aplicação executada no Docker subitamente perdesse desempenho.
E mais uma observação sobre desempenho. Alguns parâmetros do núcleo são passados do host para o contêiner. Em particular, alguns parâmetros de rede. Portanto, se você quiser executar algo de alto desempenho no Docker, como algo que utilize intensivamente a rede, pelo menos você precisará ajustar esses parâmetros. Alguma coisa como nf_conntrack, por exemplo.
Sobre o conceito de Docker
O Docker consiste em vários componentes:
- Docker Daemon — o próprio Container Engine; executa contêineres.
- Docker CII — ferramenta para gerenciar Docker.
- Dockerfile — instrução sobre como construir uma imagem.
- Imagem — a imagem a partir da qual o contêiner é criado.
- Contêiner.
- Docker registry — repositório de imagens.
Esquematicamente, isso se parece com isso:
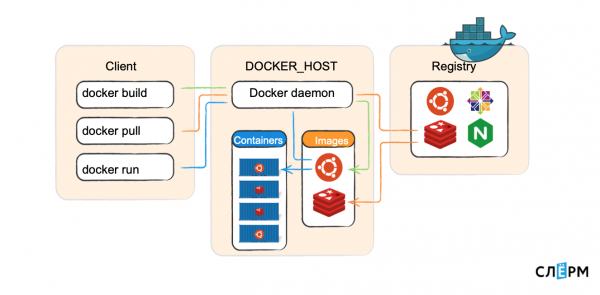
No Docker_host, o Docker daemon executa contêineres. Há um Cliente que envia comandos: crie uma imagem, baixe uma imagem, inicie um contêiner. O Docker daemon consulta o registro e executa-os. O cliente Docker pode se conectar localmente (ao socket Unix) e via TCP a um host remoto.
Vamos passar por cada componente.
Docker daemon (daemon) — é a parte do servidor, ela opera na máquina host: baixa imagens e inicia contêineres a partir delas, cria redes entre contêineres, coleta logs. Quando dizemos 'crie uma imagem', isso também é feito pelo daemon.
Docker CLI — parte do cliente do Docker, uma ferramenta de linha de comando para trabalhar com o daemon. Reitero, ela pode funcionar não apenas localmente, mas também pela rede.
Comandos básicos:
docker ps — mostrar contêineres que estão atualmente em execução no host Docker.
docker images — mostrar imagens baixadas localmente.
docker search — procura por uma imagem no registro.
docker pull — baixa uma imagem do registro para a máquina.
docker build <> — constrói uma imagem.
docker run — inicia um contêiner.
docker rm — remove um contêiner.
docker logs — logs do contêiner.
docker start/stop/restart — manuseio do contêiner.
Se você dominar esses comandos e os usar com confiança, considere que você dominou 70% do Docker no nível do usuário.
Dockerfile — instrução para criar uma imagem. Quase cada comando dentro da instrução é uma nova camada. Vamos ver com um exemplo.
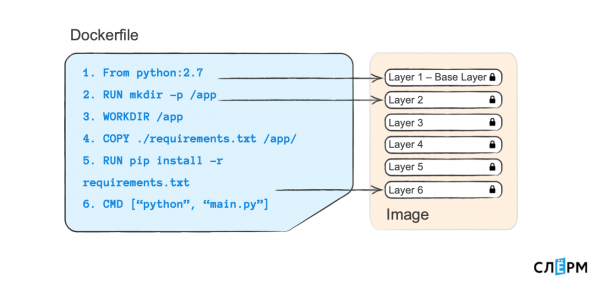
Mais ou menos assim parece um Dockerfile: à esquerda os comandos, à direita — os argumentos. Cada comando que está presente aqui (e é escrito no Dockerfile) cria uma nova camada na Imagem.
Mesmo olhando para a parte esquerda, podemos entender o que está acontecendo. Dizemos: 'crie uma pasta' — isso é uma camada. 'Torne a pasta a pasta de trabalho' — isso é outra camada, e assim por diante. O bolo em camadas facilita a vida. Se eu criar outro Dockerfile e mudar algo na última linha — em vez de 'python main.py', executar algo diferente, ou instalar dependências de outro arquivo — então as camadas anteriores serão reutilizadas, como cache.
Imagem — é a embalagem do contêiner, a partir da qual os contêineres são iniciados. Se olharmos para o Docker como um gerenciador de pacotes (como se estivéssemos lidando com pacotes deb ou rpm), a imagem é, na essência, um pacote rpm. Através do yum install, podemos instalar o aplicativo, removê-lo, encontrá-lo no repositório, baixá-lo. Aqui é aproximadamente a mesma coisa: contêineres são iniciados a partir da imagem, eles são armazenados no Docker registry (analogamente ao yum, no repositório), e cada imagem possui um hash SHA-256, nome e tag.
A imagem é criada a partir das instruções do Dockerfile. Cada instrução no Dockerfile cria uma nova camada. As camadas podem ser reutilizadas.
Docker registry — é o repositório de imagens Docker. Analogamente aos sistemas operacionais, o Docker possui um registro público padrão — dockerhub. Mas é possível construir seu próprio repositório, seu próprio Docker registry.
Contêiner — é o que é iniciado a partir da imagem. A partir das instruções do Dockerfile, criamos a imagem e então iniciamos a partir dessa imagem. Este contêiner é isolado dos outros contêineres, e deve conter tudo o que é necessário para o funcionamento do aplicativo. Nesse contexto, um contêiner corresponde a um único processo. Às vezes, é necessário ter dois processos, mas isso contraria um pouco a ideologia do Docker.
A exigência de "um contêiner — um processo" está relacionada ao PID Namespace. Quando um processo com PID 1 é iniciado no Namespace, se ele morrer de repente, todo o contêiner também morrerá. No entanto, se houver dois processos em execução: um permanece ativo e o outro morre, o contêiner continuará vivo. Mas isso diz respeito às Melhores Práticas; falaremos sobre elas em outros materiais.
Para estudar mais detalhadamente as características e o conteúdo completo do curso, você pode acessar o link: "».
Autor: Marcel Ibraev, administrador do Kubernetes certificado, engenheiro em atividade na empresa Southbridge, palestrante e desenvolvedor de cursos da Slurm.
Fonte: habr.com
