

Compartilho a partir da experiência pessoal o que foi útil, onde e quando. De forma resumida e objetiva, para que fique claro o que e onde você pode aprofundar — mas aqui estou apenas refletindo minha experiência pessoal, que pode ser bastante diferente da sua.
Por que é importante saber e saber como trabalhar com linguagens de consulta? Na verdade, em Data Science, existem várias etapas importantes de trabalho e a primeira e mais fundamental (sem a qual nada funcionará!) é a obtenção ou extração de dados. Na maioria das vezes, os dados estão armazenados em algum lugar e precisam ser "extraídos".
As linguagens de consulta são realmente o que permite extrair esses dados! E hoje eu vou falar sobre as linguagens de consulta que me foram úteis e mostrar onde e como exatamente — por que é importante aprender isso.
Nesta artigo, vamos analisar três blocos principais de tipos de consultas a dados:
- Linguagens de consulta "padrão" — o que geralmente pensamos quando falamos de linguagens de consulta, como álgebra relacional ou SQL.
- Linguagens de consulta de script: por exemplo, coisas em Python como pandas, numpy ou shell scripting.
- Linguagens de consulta para grafos de conhecimento e bancos de dados orientados a grafos.
Tudo o que está escrito aqui é apenas uma experiência pessoal do que foi útil, com descrições de situações e "por que foi necessário" — cada um pode considerar quão semelhantes essas situações podem surgir para você e tentar se preparar para elas, aprendendo essas linguagens antes de precisar usá-las (de forma urgente) em um projeto ou mesmo entrar em um projeto que necessite delas.
Linguagens de consulta "padrão"
Linguagens de consulta padrão no sentido de que costumamos pensar nelas quando falamos sobre consultas.
Álgebra relacional
Por que a álgebra relacional é necessária hoje? Para ter uma boa compreensão de por que as linguagens de consulta são estruturadas de determinada maneira e usá-las conscientemente, é preciso entender o núcleo que as fundamenta.
O que é álgebra relacional?
A definição formal é a seguinte: álgebra relacional é um sistema fechado de operações sobre relações no modelo relacional de dados. Em termos mais simples, é um sistema de operações sobre tabelas, de tal forma que o resultado também seja sempre uma tabela.
Veja todas as operações relacionais em artigo do Habr — aqui descrevemos por que é importante saber e onde isso é útil.
Por quê?
Você começa a entender como as linguagens de consulta se formam e quais operações estão por trás das expressões específicas dessas linguagens — isso frequentemente proporciona uma compreensão mais profunda do que e como funciona nas linguagens de consulta.
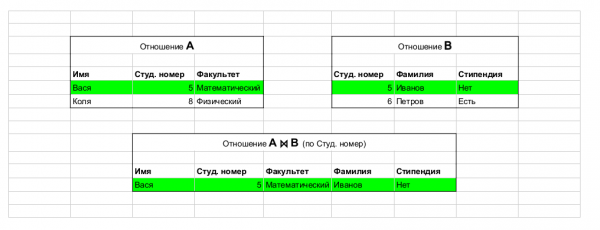
Retirado de artigo. Exemplo de operação: join, que une tabelas.
Materiais para estudo:
. Na verdade, existem muitos materiais sobre álgebra relacional e teoria — Coursera, Udacity. Também há uma enorme quantidade de materiais online, incluindo bons . Meu conselho pessoal: você deve entender a álgebra relacional muito bem — é a base de tudo.
SQL
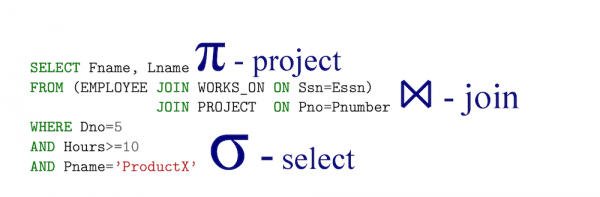
Retirado de artigo.
SQL é, na essência, uma implementação da álgebra relacional — com uma importante ressalva: SQL é declarativo! Ou seja, ao escrever uma consulta na linguagem da álgebra relacional, você está essencialmente dizendo como deve ser calculado — enquanto que no SQL você especifica o que deseja extrair, e então o SGBD gera (expressões eficazes) na linguagem da álgebra relacional (sua equivalência é conhecida como ).
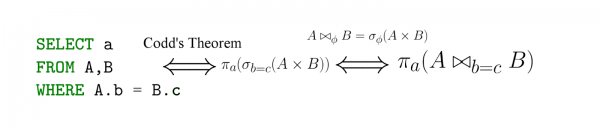
Retirado de artigo.
Por quê?
SGBDs relacionais: Oracle, Postgres, SQL Server, etc — continuam a estar praticamente em toda parte e a chance de que você tenha que interagir com eles é imensa, o que significa que você terá que ler SQL (o que é muito provável) ou mesmo escrever (também não é pouco provável).
O que ler e estudar
Pelos mesmos links acima (sobre álgebra relacional), há uma quantidade inacreditável de material, como por exemplo, .
E a propósito, o que é NoSQL?
"Vale ressaltar mais uma vez que o termo 'NoSQL' tem uma origem absolutamente espontânea e não possui uma definição amplamente reconhecida ou uma instituição científica por trás dele." O material correspondente no Habr.
Na essência, as pessoas perceberam que o modelo relacional completo não é necessário para resolver muitos problemas, especialmente aqueles em que, por exemplo, o desempenho é fundamental e certas consultas simples com agregação predominam — é crítico calcular métricas rapidamente e gravá-las no banco de dados, e a maioria das características da abordagem relacional se mostrou não apenas inútil, mas até prejudicial — por que normalizar algo, se isso irá comprometer o que é mais importante para nós (para uma tarefa específica) — o desempenho?
Além disso, muitas vezes são necessárias esquemas flexíveis em vez de esquemas matemáticos fixos do modelo relacional clássico — e isso simplifica incrivelmente o desenvolvimento de aplicações, quando é crítico implementar um sistema e começar a trabalhar rapidamente, processando resultados — ou o esquema e os tipos de dados armazenados não são tão importantes.
Por exemplo, criamos um sistema especialista e queremos armazenar informações de um determinado domínio junto com algumas metainformações — podemos não conhecer todos os campos e simplesmente armazenar JSON para cada registro — isso nos dá um ambiente muito flexível para expandir o modelo de dados e iterar rapidamente — portanto, nesse caso, NoSQL será até preferível e mais legível. Um exemplo de registro (de um dos meus projetos, onde NoSQL foi exatamente onde precisava).
{"en_wikipedia_url":"https://en.wikipedia.org/wiki/Johnny_Cash",
"ru_wikipedia_url":"https://ru.wikipedia.org/wiki/?curid=301643",
"ru_wiki_pagecount":149616,
"entity":[42775,"Джонни Кэш","ru"],
"en_wiki_pagecount":2338861}
Você pode ler mais sobre NoSQL.
O que estudar?
Aqui, mais do que qualquer coisa, é necessário analisar bem a sua tarefa, quais são suas propriedades e quais sistemas NoSQL se encaixam nessa descrição — e então começar a estudar esse sistema.
Linguagens de consulta de script
A princípio, parece que Python não tem nada a ver com isso — é uma linguagem de programação, e não se trata de consultas de forma alguma.
- Pandas é como um canivete suíço para Data Science, muitas transformações, agregações de dados, etc., acontecem nele.
- Numpy — cálculos vetoriais, matrizes e álgebra linear estão lá.
- Scipy — muitas matemáticas neste pacote, especialmente estatísticas.
- Jupyter lab — muitas análises exploratórias de dados se encaixam bem em notebooks — é útil saber.
- Requests — manipulação de rede.
- Pyspark — muito popular entre engenheiros de dados, provavelmente você terá que interagir com este ou Spark, apenas pela sua popularidade.
- *Selenium — muito útil para coletar dados de sites e recursos, às vezes simplesmente não há outra forma de obter os dados.
Meu principal conselho: aprenda Python!
Pandas
Vamos usar o seguinte código como exemplo:
import pandas as pd
df = pd.read_csv("data/dataset.csv")
# Calcular e renomear agregações
all_together = (df[df[‘trip_type’] == "return"]
    .groupby(['start_station_name','end_station_name'])
                       .agg({'trip_duration_seconds': [np.size, np.mean, np.min, np.max]})
                       .rename(columns={'size': 'num_trips',
           'mean': 'avg_duration_seconds',
           'amin': min_duration_seconds',
           'amax': 'max_duration_seconds'}))
Na essência, vemos que o código se encaixa no padrão clássico de SQL.
SELECT start_station_name, end_station_name, count(trip_duration_seconds) as size, …..
FROM dataset
WHERE trip_type = 'return'
GROUP BY start_station_name, end_station_name
Mas a parte importante é que este código faz parte de um script e pipeline, na verdade, estamos integrando consultas no pipeline em Python. Nessa situação, a linguagem de consulta nos vem de bibliotecas, como Pandas ou pySpark.
De forma geral, em pySpark, vemos um tipo semelhante de transformação de dados através da linguagem de consulta no estilo:
df.filter(df.trip_type = 'return')
  .groupby('day')
  .agg({duration: 'mean'})
  .sort()
Onde e o que ler
Sobre Python em geral encontrar materiais para estudo. Na internet, há uma enorme quantidade de tutoriais sobre , e cursos sobre (assim como sobre ). No geral, aqui os materiais são facilmente encontrados e se eu tivesse que escolher um pacote no qual vale a pena se concentrar — seria pandas, claro. Em relação à ligação DS+Python, também há .
Shell como linguagem de consulta
Muitos projetos de processamento e análise de dados com os quais trabalhei são, na verdade, scripts shell que chamam código em Python, em Java e, propriamente dito, os próprios comandos shell. Portanto, no geral, podemos considerar pipelines em bash/zsh/etc. como algum tipo de consulta de alto nível (é possível, claro, incluir laços, mas isso não é típico de código DS em linguagens shell), apresentaremos um exemplo simples — eu precisava fazer um mapeamento de QID da Wikidata e links completos para a Wikipédia em russo e inglês, para isso escrevi uma simples consulta de comandos em bash e para a saída escrevi um script em Python que juntei assim:
pv 'data/latest-all.json.gz' |
unpigz -c  |
jq --stream $JQ_QUERY |
python3 scripts/post_process.py 'output.csv'
onde
JQ_QUERY = 'select((.[0][1] == "sitelinks" and (.[0][2]=="enwiki" or .[0][2] =="ruwiki") and .[0][3] =="title") or .[0][1] == "id")' Esse foi, na verdade, todo o pipeline que criava o mapeamento necessário, como podemos ver, tudo funcionou em modo de fluxo:
- pv filepath — fornece uma barra de progresso com base no tamanho do arquivo e passa seu conteúdo adiante
- unpigz -c lia parte do arquivo compactado e entregava ao jq
- jq com a chave — stream fornecia imediatamente o resultado e o passava para o pós-processador (assim como no primeiro exemplo) em Python
- dentro do pós-processador — é uma simples máquina de estados que formatava a saída
Um pipeline complexo que opera em modo de fluxo em grandes dados (0,5 TB), sem recursos significativos e feito a partir de um pipeline simples e algumas ferramentas.
Mais um conselho importante: saiba trabalhar bem e de forma eficaz no terminal e escrever em bash/zsh/etc.
Onde isso é útil? Quase em todos os lugares — há MUITOS materiais disponíveis para estudo na internet. Em particular, aqui está meu artigo anterior.
R scripting
Novamente, o leitor pode exclamar — bem, isso é uma linguagem de programação inteira! E, claro, ele estará certo. No entanto, geralmente me deparei com R sempre em um contexto onde, na verdade, era muito semelhante a uma linguagem de consultas.
R é um ambiente de cálculos estatísticos e uma linguagem de cálculos e visualizações estatísticas (de acordo com ).
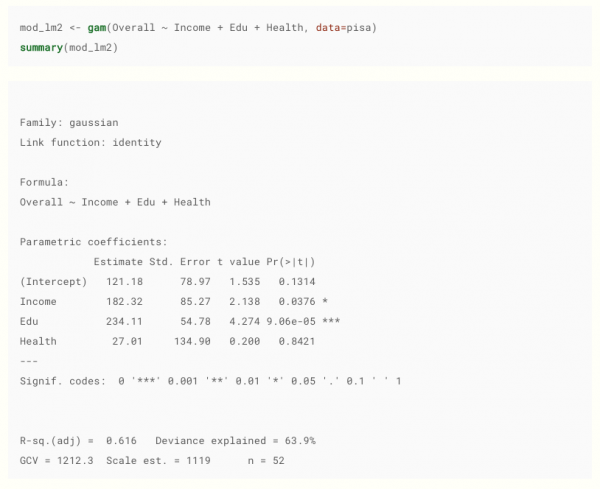
Retirado . A propósito, recomendo, é um bom material.
Por que um cientista de dados deve saber R? Pelo menos porque há um grande número de pessoas fora da TI que trabalham com análise de dados em R. Encontrei em vários lugares:
- Setor farmacêutico.
- Biólogos.
- Setor financeiro.
- Pessoas com formação puramente matemática que trabalham com estatísticas.
- Modelos estatísticos especializados e modelos de aprendizado de máquina (que muitas vezes podem ser encontrados apenas em versões autorais como pacotes R).
Por que isso é de fato uma linguagem de consultas? Na forma como frequentemente aparece, é de fato uma consulta para criar um modelo, incluindo a leitura de dados e a definição de parâmetros da consulta (modelos), além da visualização de dados em pacotes como ggplot2 — isso também é uma forma de escrever consultas.
Exemplo de consultas para visualização
ggplot(data = beav,
       aes(x = id, y = temp,
           group = activ, color = activ)) +
  geom_line() +
  geom_point() +
  scale_color_manual(values = c("red", "blue"))
No geral, muitas ideias de R foram transferidas para pacotes Python, como pandas, numpy ou scipy, como dataframes e vetorização de dados — portanto, muitas coisas em R parecerão familiares e convenientes para você.
Há muitas fontes para estudo, por exemplo, .
Grafos de conhecimento (Knowledge graph)
Aqui tenho uma experiência um pouco incomum, pois frequentemente trabalho com grafos de conhecimento e linguagens de consultas para grafos. Por isso, vamos passar rapidamente pelos fundamentos, pois essa parte é um pouco mais exótica.
Em bancos de dados relacionais clássicos, temos um esquema fixo — aqui, no entanto, o esquema é flexível, cada predicado é de fato uma 'coluna' e até mais.
Imagine que você está modelando uma pessoa e queria descrever aspectos-chave; vamos pegar uma pessoa específica, Douglas Adams, e usar esta descrição como base.
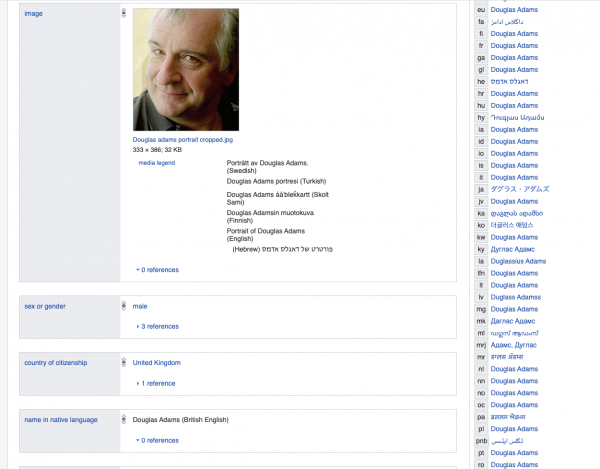
Se usássemos um banco de dados relacional, teríamos que criar uma enorme tabela ou tabelas com um vasto número de colunas, a maior parte das quais seria NULL ou preenchida com algum valor padrão de falso; por exemplo, é improvável que muitos de nós tenham um registro na biblioteca nacional coreana — claro, poderíamos retirá-los para tabelas separadas, mas isso acabaria sendo uma tentativa de modelar um esquema lógico flexível com predicados usando um modelo relacional fixo.
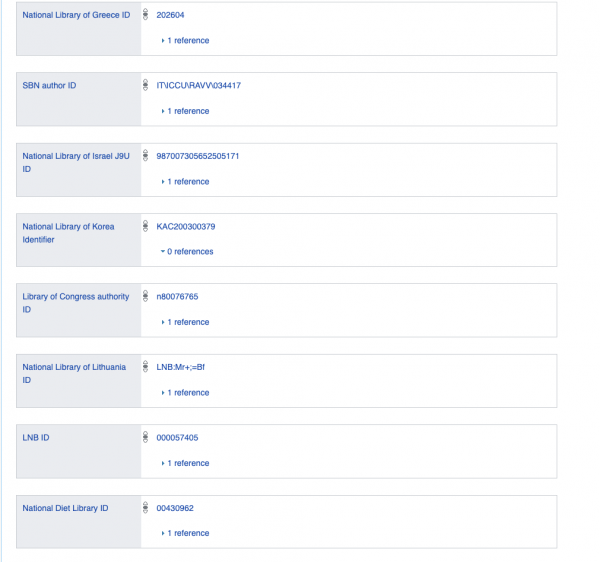
Portanto, imagine que todos os dados estão armazenados na forma de um grafo ou em expressões lógicas binárias e unárias.
Onde você pode encontrar isso? Em primeiro lugar, trabalhando com , assim como em qualquer banco de dados gráfico ou dados conectados.
A seguir estão as principais linguagens de consulta que eu precisava aplicar e com as quais trabalhei.
SPARQL
Wiki:
SPARQL ( de SPARQL Protocol and RDF Query Language) — , apresentados no modelo , além de para a transmissão dessas consultas e respostas. SPARQL é uma recomendação e uma das tecnologias .
Na verdade, esta é uma linguagem de consulta para predicados lógicos unários e binários. Você simplesmente indica condicionalmente o que é fixo em uma expressão lógica e o que não é (de forma bastante simplificada).
O próprio banco RDF (Resource Description Framework), sobre o qual as consultas SPARQL são realizadas, consiste em uma tríade objeto, predicado, sujeito — e a consulta seleciona as tríades necessárias com base nas restrições especificadas do tipo: encontrar tal X que p_55(X, q_33) seja verdadeiro — onde, claro, p_55 é alguma relação com ID 55, e q_33 é o objeto com ID 33 (é isso, novamente deixando de lado todos os detalhes possíveis).
Exemplo de representação de dados:
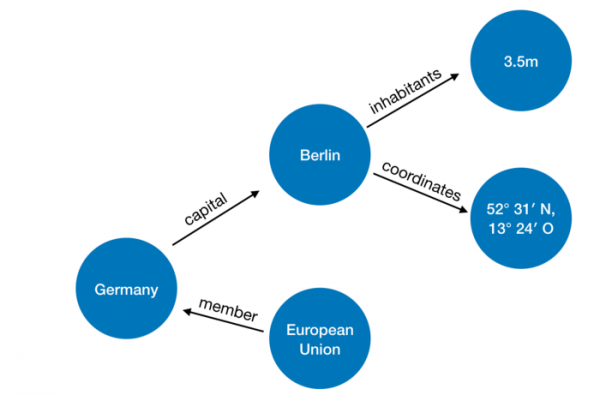
Imagens e um exemplo com países aqui .
Exemplo de consulta básica
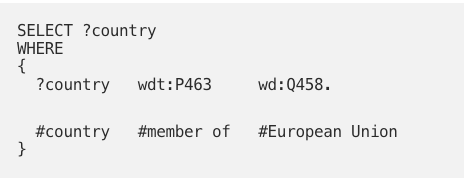
Na verdade, queremos encontrar o valor da variável ?country, tal que para o predicado
member_of, é verdadeiro que member_of(?country,q458), e q458 é o ID da União Europeia.
Exemplo de uma consulta SPARQL real dentro do motor Python:
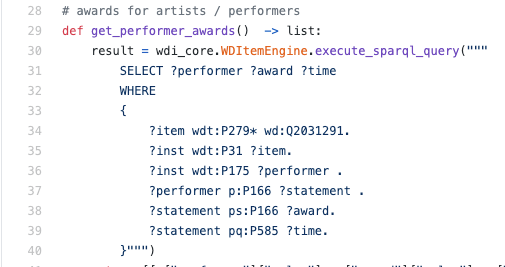
Normalmente, eu precisava ler SPARQL em vez de escrevê-lo — nessa situação, provavelmente será útil entender a linguagem pelo menos em um nível básico para compreender como os dados são extraídos.
Há muitos materiais online para aprender: por exemplo, aqui está e . Normalmente, eu busco no Google construções e exemplos específicos, e até agora tem sido suficiente.
Linguagens lógicas de consulta
Você pode ler mais sobre o tema no meu artigo . Aqui, apenas abordaremos brevemente por que as linguagens lógicas são adequadas para escrever consultas. Essencialmente, o RDF é apenas um conjunto de afirmações lógicas do tipo p(X) e h(X,Y), e a consulta lógica tem a seguinte forma:
output(X) :- country(X), member_of(X, "EU").
Aqui estamos falando sobre a criação de um novo predicado output/1 (o /1 significa unário), sob a condição de que para X é verdade que country(X) — ou seja, X é um país e também member_of(X, "EU").
Isso significa que tanto os dados quanto as regras são representados da mesma forma, o que permite modelar tarefas de maneira muito fácil e eficaz.
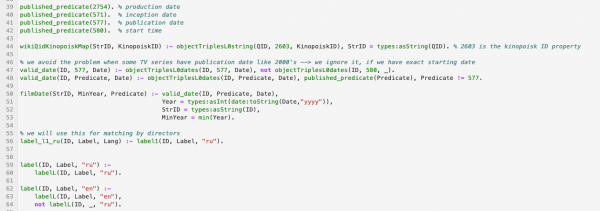
Onde foram encontradas na indústria: um grande projeto com uma empresa que escreve consultas nesse tipo de linguagem, além do projeto atual no núcleo do sistema — parece uma coisa bastante exótica, mas às vezes aparece.
Exemplo de um fragmento de código em uma linguagem lógica que processa wikidata:
Materiais: aqui estão alguns links sobre a linguagem de programação lógica moderna chamada Answer Set Programming — recomendaria estudar exatamente isso:
Fonte: habr.com
