

Olá, comunidade Habr. Como já mencionamos, este mês a OTUS lançará dois cursos sobre aprendizado de máquina, sendo eles e . Em razão disso, continuamos a compartilhar materiais úteis.
O objetivo deste artigo é relatar nossa primeira experiência com .
Começaremos a revisão com seu servidor de rastreamento e registraremos todas as iterações da pesquisa. Em seguida, compartilharemos nossa experiência conectando o Spark ao MLflow usando UDF.
Contexto
Nós na usa aprendizado de máquina e inteligência artificial para capacitar as pessoas a cuidarem de sua saúde e bem-estar. Por isso, os modelos de aprendizado de máquina são fundamentais nos produtos de processamento de dados que desenvolvemos, e é por isso que nos interessamos pelo MLflow — uma plataforma de código aberto que abrange todos os aspectos do ciclo de vida do aprendizado de máquina.
MLflow
O principal objetivo do MLflow é fornecer uma camada adicional sobre o aprendizado de máquina que permita aos especialistas em ciência de dados trabalhar com praticamente qualquer biblioteca de aprendizado de máquina (, , , , e ), elevando seu funcionamento a um novo nível.
O MLflow fornece três componentes:
- Rastreamento – registro e consultas de experimentos: código, dados, configuração e resultados. Monitorar o processo de criação do modelo é muito importante.
- Projetos – Formato de empacotamento para execução em qualquer plataforma (por exemplo, )
- Modelos – um formato comum para enviar modelos para diversas ferramentas de implantação.
O MLflow (na data da redação deste artigo, em versão alpha) é uma plataforma de código aberto que permite gerenciar o ciclo de vida do aprendizado de máquina, incluindo experimentos, reutilização e implantação.
Configuração do MLflow
Para usar o MLflow, é necessário primeiramente configurar todo o ambiente Python. Para isso, usaremos (para instalar o Python no Mac, consulte ). Assim, poderemos criar um ambiente virtual onde instalaremos todas as bibliotecas necessárias para a execução.
```
pyenv install 3.7.0
pyenv global 3.7.0 # Use Python 3.7
mkvirtualenv mlflow # Crie um ambiente virtual com Python 3.7
workon mlflow
```
Vamos instalar as bibliotecas necessárias.
```
pip install mlflow==0.7.0
            Cython==0.29
            numpy==1.14.5
            pandas==0.23.4
            pyarrow==0.11.0
```
Nota: estamos usando o PyArrow para executar modelos como UDF. As versões do PyArrow e do Numpy precisavam ser corrigidas, pois as versões mais recentes estavam conflitando entre si.
Iniciando a interface de rastreamento
O MLflow Tracking nos permite registrar e consultar experimentos usando Python e API. Além disso, é possível definir onde armazenar os artefatos do modelo (localhost, , , ou ). Como na Alpha Health utilizamos AWS, o armazenamento de artefatos será S3.
# Running a Tracking Server
mlflow server
    --file-store /tmp/mlflow/fileStore
    --default-artifact-root s3://<bucket>/mlflow/artifacts/
    --host localhost
    --port 5000
O MLflow recomenda usar um armazenamento de arquivos permanente. Um armazenamento de arquivos é um local onde o servidor armazenará os metadados das execuções e experimentos. Ao iniciar o servidor, certifique-se de que ele aponta para um armazenamento de arquivos permanente. Aqui, para o experimento, vamos simplesmente usar /tmp.
Lembre-se de que, se quisermos usar o servidor mlflow para executar experimentos antigos, eles devem estar presentes no armazenamento de arquivos. No entanto, mesmo sem isso, poderíamos utilizá-los no UDF, uma vez que precisamos apenas do caminho até o modelo.
Nota: Tenha em mente que a interface do Tracking e o cliente do modelo devem ter acesso ao local do artefato. Isso significa que, independentemente de a interface do Tracking estar em uma instância EC2, ao executar localmente o MLflow, a máquina deve ter acesso direto ao S3 para gravar modelos artefatos.
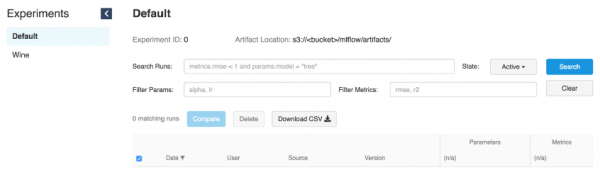
A interface do Tracking armazena artefatos no bucket S3
Executando modelos
Assim que o servidor de Tracking estiver funcionando, você pode começar a treinar modelos.
Como exemplo, usaremos a modificação do vinho do exemplo do MLflow em .
MLFLOW_TRACKING_URI=http://localhost:5000 python wine_quality.py
  --alpha 0.9
  --l1_ration 0.5
  --wine_file ./data/winequality-red.csv
Como já mencionamos, o MLflow permite registrar parâmetros, métricas e artefatos dos modelos para que possamos acompanhar como eles se desenvolvem ao longo das iterações. Essa função é extremamente útil, pois assim podemos reproduzir o melhor modelo, consultando o servidor de Tracking ou entendendo qual código executou a iteração necessária, usando os logs de hash de commit do git.
with mlflow.start_run():

    ... model ...

    mlflow.log_param("source", wine_path)
    mlflow.log_param("alpha", alpha)
    mlflow.log_param("l1_ratio", l1_ratio)

    mlflow.log_metric("rmse", rmse)
    mlflow.log_metric("r2", r2)
    mlflow.log_metric("mae", mae)

    mlflow.set_tag('domain', 'wine')
    mlflow.set_tag('predict', 'quality')
mlflow.sklearn.log_model(lr, "model") 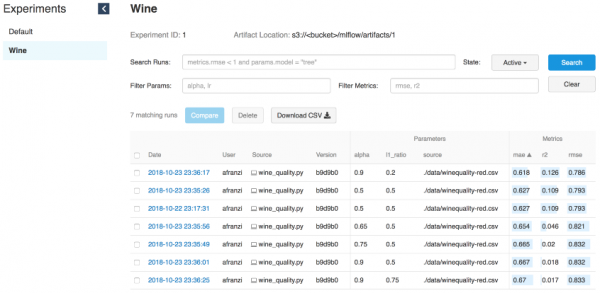
Iterações do vinho
Parte do servidor para o modelo
O servidor de rastreamento MLflow, iniciado com o comando “mlflow server”, possui uma API REST para rastrear execuções e gravar dados no sistema de arquivos local. Você pode especificar o endereço do servidor de rastreamento com a variável de ambiente «MLFLOW_TRACKING_URI», e a API de rastreamento do MLflow se conectará automaticamente ao servidor de rastreamento nesse endereço para criar/obter informações sobre a execução, métricas de logs, etc.
Fonte:
Para fornecer um servidor para o modelo, precisaremos de um servidor de rastreamento em execução (veja a interface de inicialização) e o ID da execução do modelo.
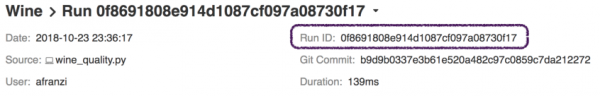
ID da Execução
# Serve a sklearn model through 127.0.0.0:5005
MLFLOW_TRACKING_URI=http://0.0.0.0:5000 mlflow sklearn serve
  --port 5005
  --run_id 0f8691808e914d1087cf097a08730f17
  --model-path model
Para gerenciar modelos com a funcionalidade MLflow serve, precisaremos de acesso à UI de Rastreamento, para obter informações sobre o modelo simplesmente especificando --run_id.
Assim que o modelo se conecta ao servidor de rastreamento, podemos obter um novo ponto final do modelo.
# Query Tracking Server Endpoint
curl -X POST
  http://127.0.0.1:5005/invocations
  -H 'Content-Type: application/json'
  -d '[
	{
		"fixed acidity": 3.42,
		"volatile acidity": 1.66,
		"citric acid": 0.48,
		"residual sugar": 4.2,
		"chloridessssss": 0.229,
		"free sulfur dsioxide": 19,
		"total sulfur dioxide": 25,
		"density": 1.98,
		"pH": 5.33,
		"sulphates": 4.39,
		"alcohol": 10.8
	}
]'

> {"predictions": [5.825055635303461]}
Executando modelos a partir do Spark
Embora o servidor de rastreamento seja potente o suficiente para gerenciar modelos em tempo real, seu treinamento e uso da funcionalidade serve (fonte: ), a aplicação do Spark (em lote ou streaming) é uma solução ainda mais robusta devido à sua distribuição.
Imagine que você acabou de treinar offline e, em seguida, aplicou o modelo resultante a todos os seus dados. É aqui que o Spark e o MLflow mostram seu melhor desempenho.
Instalando PySpark + Jupyter + Spark
Fonte:
Para mostrar como aplicamos modelos do MLflow a DataFrames do Spark, precisamos configurar a colaboração entre notebooks Jupyter e PySpark.
Comece instalando a versão estável mais recente :
cd ~/Downloads/
tar -xzf spark-2.4.3-bin-hadoop2.7.tgz
mv ~/Downloads/spark-2.4.3-bin-hadoop2.7 ~/
ln -s ~/spark-2.4.3-bin-hadoop2.7 ~/spark
Instale o PySpark e o Jupyter em um ambiente virtual:
pip install pyspark jupyterConfigure variáveis de ambiente:
export SPARK_HOME=~/spark
export PATH=$SPARK_HOME/bin:$PATH
export PYSPARK_DRIVER_PYTHON=jupyter
export PYSPARK_DRIVER_PYTHON_OPTS="notebook --notebook-dir=${HOME}/Projects/notebooks"
Definindo notebook-dir, poderemos armazenar nossos notebooks na pasta desejada.
Iniciando o Jupyter a partir do PySpark
Como conseguiremos configurar o Jupyter como driver do PySpark, agora podemos iniciar o notebook Jupyter no contexto do PySpark.
(mlflow) afranzi:~$ pyspark
[I 19:05:01.572 NotebookApp] extensão sparkmagic habilitada!
[I 19:05:01.573 NotebookApp] Servindo notebooks do diretório local: /Users/afranzi/Projects/notebooks
[I 19:05:01.573 NotebookApp] O Jupyter Notebook está rodando em:
[I 19:05:01.573 NotebookApp] http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745
[I 19:05:01.573 NotebookApp] Utilize Control-C para parar este servidor e desligar todos os kernels (duas vezes para pular a confirmação).
[C 19:05:01.574 NotebookApp]

    Copie/cole este URL no seu navegador quando você se conectar pela primeira vez,
    para fazer login com um token:
http://localhost:8888/?token=c06252daa6a12cfdd33c1d2e96c8d3b19d90e9f6fc171745 
Como mencionado anteriormente, o MLflow fornece uma função de logging de artefatos de modelo no S3. Assim que temos em mãos o modelo selecionado, podemos importá-lo como UDF usando o módulo mlflow.pyfunc.
import mlflow.pyfunc

model_path = 's3:///mlflow/artifacts/1/0f8691808e914d1087cf097a08730f17/artifacts/model'
wine_path = '/Users/afranzi/Projects/data/winequality-red.csv'
wine_udf = mlflow.pyfunc.spark_udf(spark, model_path)

df = spark.read.format("csv").option("header", "true").option('delimiter', ';').load(wine_path)
columns = [ "acidicidade fixa", "acidicidade volátil", "ácido cítrico",
            "açúcar residual", "cloretos", "dióxido de enxofre livre",
            "dióxido de enxofre total", "densidade", "pH",
            "sulfatos", "álcool"
          ]

df.withColumn('previsão', wine_udf(*columns)).show(100, False) 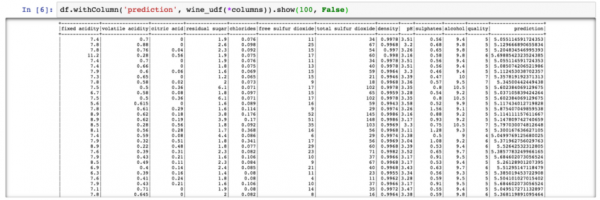
PySpark – Resultado da previsão da qualidade do vinho
Até este ponto, discutimos como usar PySpark com MLflow, executando a previsão da qualidade do vinho em todo o conjunto de dados do vinho. Mas o que fazer se precisarmos usar os módulos Python do MLflow a partir do Scala Spark?
Nós testamos isso, compartilhando o contexto do Spark entre Scala e Python. Ou seja, registramos o UDF do MLflow em Python e o utilizamos a partir do Scala (sim, pode não ser a melhor solução, mas é o que temos).
Scala Spark + MLflow
Para este exemplo, vamos adicionar ao Jupyter existente.
Instalando Spark + Toree + Jupyter
pip install toree
jupyter toree install --spark_home=${SPARK_HOME} --sys-prefix
jupyter kernelspec list
```
```
Kernels disponíveis:
  apache_toree_scala    /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/apache_toree_scala
  python3               /Users/afranzi/.virtualenvs/mlflow/share/jupyter/kernels/python3
```
Como pode ser visto no notebook anexado, o UDF é usado conjuntamente com Spark e PySpark. Esperamos que esta parte seja útil para aqueles que amam Scala e querem implantar modelos de machine learning em produção.
import org.apache.spark.sql.functions.col
import org.apache.spark.sql.types.StructType
import org.apache.spark.sql.{Column, DataFrame}
import scala.util.matching.Regex

val FirstAtRe: Regex = "^_".r
val AliasRe: Regex = "[\s_.:@]+".r

def getFieldAlias(field_name: String): String = {
    FirstAtRe.replaceAllIn(AliasRe.replaceAllIn(field_name, "_"), "")
}

def selectFieldsNormalized(columns: List[String])(df: DataFrame): DataFrame = {
    val fieldsToSelect: List[Column] = columns.map(field =>
        col(field).as(getFieldAlias(field))
    )
    df.select(fieldsToSelect: _*)
}

def normalizeSchema(df: DataFrame): DataFrame = {
    val schema = df.columns.toList
    df.transform(selectFieldsNormalized(schema))
}

FirstAtRe = ^_
AliasRe = [s_.:@]+

getFieldAlias: (field_name: String)String
selectFieldsNormalized: (columns: List[String])(df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
normalizeSchema: (df: org.apache.spark.sql.DataFrame)org.apache.spark.sql.DataFrame
Out[1]:
[s_.:@]+
In [2]:
val winePath = "~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv"
val modelPath = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"

winePath = ~\/Research\/mlflow-workshop\/examples\/wine_quality\/data\/winequality-red.csv
modelPath = \/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
Out[2]:
\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model
In [3]:
val df = spark.read
              .format("csv")
              .option("header", "true")
              .option("delimiter", ";")
              .load(winePath)
              .transform(normalizeSchema)

df = [fixed_acidity: string, volatile_acidity: string ... 10 more fields]
Out[3]:
[fixed_acidity: string, volatile_acidity: string ... 10 more fields]
In [4]:
%%PySpark
import mlflow
from mlflow import pyfunc

model_path = "\/tmp\/mlflow\/artifactStore\/0\/96cba14c6e4b452e937eb5072467bf79\/artifacts\/model"
wine_quality_udf = mlflow.pyfunc.spark_udf(spark, model_path)

spark.udf.register("wineQuality", wine_quality_udf)
Out[4]:
<function spark_udf..predict at 0x1116a98c8>
In [6]:
df.createOrReplaceTempView("wines")
In [10]:
%%SQL
SELECT
    quality,
    wineQuality(
        fixed_acidity,
        volatile_acidity,
        citric_acid,
        residual_sugar,
        chlorides,
        free_sulfur_dioxide,
        total_sulfur_dioxide,
        density,
        pH,
        sulphates,
        alcohol
    ) AS prediction
FROM wines
LIMIT 10
Out[10]:
+-------+------------------+
|quality|        prediction|
+-------+------------------+
|      5| 5.576883967129615|
|      5|  5.50664776916154|
|      5| 5.525504822954496|
|      6| 5.504311247097457|
|      5| 5.576883967129615|
|      5|5.5556903912725755|
|      5| 5.467882654744997|
|      7| 5.710602976324739|
|      7| 5.657319539336507|
|      5| 5.345098606538708|
+-------+------------------+

In [17]:
spark.catalog.listFunctions.filter('name like "%wineQuality%").show(20, false)

+-----------+--------+-----------+---------+-----------+
|name       |database|description|className|isTemporary|
+-----------+--------+-----------+---------+-----------+
|wineQuality|null    |null       |null     |true       |
+-----------+--------+-----------+---------+-----------+
Próximos passos
Apesar de, no momento da redação deste artigo, o MLflow estar na versão Alpha, ele parece bastante promissor. A capacidade de executar vários frameworks de aprendizado de máquina e utilizá-los a partir de um único ponto de acesso eleva os sistemas de recomendação a um novo patamar.
Além disso, o MLflow aproxima os engenheiros de dados e os especialistas em Data Science, criando uma camada comum entre eles.
Após esta pesquisa sobre o MLflow, estamos confiantes de que avançaremos e o utilizaremos para nossos pipelines do Spark e em sistemas de recomendação.
Seria interessante sincronizar o armazenamento de arquivos com a base de dados, ao invés de utilizar o sistema de arquivos. Assim, devemos obter vários endpoints que podem usar o mesmo armazenamento de arquivos. Por exemplo, utilizar várias instâncias e com o mesmo Glue metastore.
Em resumo, gostaria de agradecer à comunidade do MLFlow por tornar nosso trabalho com dados mais interessante.
Se você está testando o MLflow, não hesite em nos escrever e contar como você o está utilizando, especialmente se estiver em produção.
Saiba mais sobre os cursos:
Leia mais:
Fonte: habr.com
