

Introdução
Há algum tempo, fui encarregado de desenvolver um cluster de alta disponibilidade para , operando em vários centros de dados interconectados por fibra óptica dentro de uma única cidade, e capaz de suportar a falha (por exemplo, perda de energia) de um centro de dados. Como software responsável pela alta disponibilidade, escolhi , porque é a solução oficial da RedHat para a criação de clusters de alta disponibilidade. É favorável, pois a RedHat oferece suporte, e é uma solução universal (modular). Com isso, será possível garantir a alta disponibilidade não apenas do PostgreSQL, mas também de outros serviços, seja através de módulos padrão ou criando-os para necessidades específicas.
A essa solução surgiu uma pergunta pertinente: quão resiliente será o cluster de alta disponibilidade? Para investigar isso, desenvolvi um ambiente de teste que simula várias falhas nos nós do cluster, aguarda a recuperação do funcionamento, restaura o nó que falhou e continua o teste em ciclo. Inicialmente, este projeto se chamava hapgsql, mas com o tempo fiquei entediado com o nome, que tinha apenas uma vogal. Portanto, comecei a nomear as bases de dados de alta disponibilidade (e o IP flutuante que as aponta) de krogan (um personagem de um jogo de computador que tem todos os órgãos importantes duplicados), e os nós, clusters e o próprio projeto de tuchanka (o planeta onde vivem os krogan).
Atualmente, a gerência autorizou . O README será em breve traduzido para o inglês (pois espera-se que os principais usuários sejam desenvolvedores do Pacemaker e PostgreSQL), e decidi formatar a versão antiga em russo do README (parcialmente) como este artigo.
Os clusters são implantados em máquinas virtuais . No total, serão implantadas 12 máquinas virtuais (totalizando 36GiB), que formam 4 clusters de alta disponibilidade (diferentes variantes). Os dois primeiros clusters são compostos por dois servidores PostgreSQL, que estão localizados em diferentes centros de dados, e um servidor compartilhado witness c quorum device (localizado em uma máquina virtual barata em um terceiro centro de dados), que resolve a ambiguidade 50%/50%, dando seu voto a um dos lados. O terceiro cluster abrange três centros de dados: um mestre, dois escravos, sem quorum device. O quarto cluster é composto por quatro servidores PostgreSQL, dois em cada data center: um mestre e os outros como réplicas, e também utiliza witness c quorum device. O quarto suporta a falha de dois servidores ou de um data center. Esta solução pode ser escalada para um maior número de réplicas, se necessário.
Serviço de Hora Precisa também está configurado para resistência a falhas, mas utiliza o método de ntpd (modo orphan). O servidor geral witness atua como o servidor NTP central, distribuindo sua hora para todos os clusters, sincronizando assim todos os servidores entre si. Se witness falhar ou ficar isolado, um dos servidores do cluster começará a distribuir seu tempo (dentro do cluster). Um cache de apoio proxy HTTP também foi levantado em witness, com isso as outras máquinas virtuais têm acesso aos repositórios Yum. Na realidade, serviços como hora precisa e proxy provavelmente serão hospedados em servidores dedicados, enquanto na configuração atual estão alocados em witness apenas para economizar virtual machines e espaço.
Versões
v0. Funciona com CentOS 7 e PostgreSQL 11 no VirtualBox 6.1.
Estrutura dos Clusters
Todos os clusters foram projetados para serem localizados em vários data centers, unidos em uma rede plana e deve suportar a falha ou o isolamento de um data center. Portanto, é impossível usar para proteção contra split-brain a tecnologia padrão do Pacemaker, chamada de STONITH (Shoot The Other Node In The Head) ou fencing. A essência: se os nós no cluster começam a suspeitar que um dos nós está apresentando problemas, não responde ou se comporta de maneira errada, eles o desligam forçosamente através de dispositivos 'externos', como um cartão controlador IPMI ou UPS. Mas isso só funcionará nos casos em que, em uma única falha de servidor, o IPMI ou UPS continuem operando. Aqui, a proteção está prevista para uma falha muito mais catastrófica, quando todo o data center falha (por exemplo, perde a energia). E com essa falha, todos os dispositivos stonith (IPMI, UPS, etc.) também não funcionarão.Em vez disso, o sistema baseia-se na ideia de quórum. Todos os nós têm voz, e só podem trabalhar aqueles que veem mais da metade de todos os nós. Esta quantidade 'metade+1' é chamada de
quórum .. Se o quórum não for alcançado, o nó decide que está em isolamento de rede e deve desligar seus recursos, ou seja, é uma proteção contra split-brain. Se o software que gerencia esse comportamento não funcionar, um watchdog deve entrar em ação, por exemplo, baseado em IPMI.
Se o número de nós for par (cluster em dois data centers), pode ocorrer o que se chama incerteza 50%/50% (cinquenta/cinquenta), quando o isolamento de rede divide o cluster exatamente ao meio. Portanto, para um número par de nós, é adicionado quorum device — um daemon que não exige muitos recursos, que pode ser executado na máquina virtual mais barata de um terceiro data center. Ele dá seu voto a um dos segmentos (que vê), assim resolvendo a incerteza 50%/50%. O servidor onde será executado o dispositivo de quórum eu chamei de witness (terminologia do repmgr, que achei interessante).
Os recursos podem ser movidos de um lugar para outro, por exemplo, de servidores defeituosos para servidores funcionando, ou por comando dos administradores. Para que os clientes saibam onde estão os recursos que necessitam (para onde se conectar?), são utilizados IPs flutuantes (float IP). Esses IPs, que o Pacemaker pode mover entre os nós (tudo está em uma rede plana), simbolizam um recurso (serviço) e estarão onde é necessário se conectar para ter acesso a esse serviço (no nosso caso, ao BD).
Tuchanka1 (esquema com compactação)
Estrutura
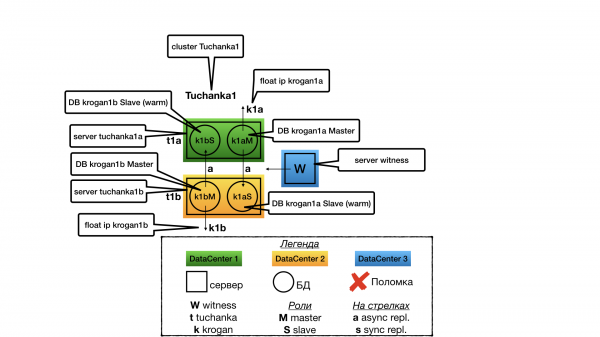
A ideia foi que temos muitos pequenos bancos de dados com baixa carga, pelos quais não compensa manter um servidor slave dedicado em modo de hot standby para transações de leitura (não há necessidade de tal desperdício de recursos).
Em cada data center há um servidor. Em cada servidor, existem duas instâncias do PostgreSQL (na terminologia do PostgreSQL, elas são chamadas de clusters, mas para evitar confusão, eu as chamarei de instâncias (por analogia com outros bancos de dados), e chamarei de clusters apenas os clusters do Pacemaker). Uma instância opera no modo mestre, e apenas ela presta serviços (apenas ela recebe o IP flutuante). A segunda instância opera como escravo para o segundo data center e prestará serviços apenas se seu mestre falhar. Uma vez que a maior parte do tempo a prestação de serviços (execução de consultas) será realizada apenas por uma das duas instâncias (o mestre), todos os recursos do servidor são otimizados para o mestre (memória é alocada para o cache shared_buffers, etc.), mas de modo que haja recursos suficientes para a segunda instância (mesmo que para um funcionamento subótimo através do cache do sistema de arquivos) em caso de falha de um dos data centers. O escravo não presta serviços (não executa consultas read only) durante a operação normal do cluster, para evitar competição por recursos com o mestre na mesma máquina.
No caso de dois nós, a alta disponibilidade só é possível com replicação assíncrona, pois na replicação síncrona, a falha do escravo levará à parada do mestre.
Falha do witness
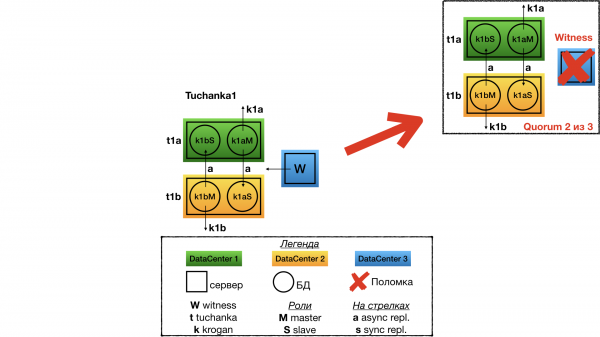
Falha do witness (quorum device) eu vou considerar apenas para o cluster Tuchanka1, a história será a mesma para todos os outros. Em caso de falha do witness na estrutura do cluster, nada mudará, tudo continuará a funcionar como antes. Mas o quórum se tornará igual a 2 em 3, e portanto qualquer falha subsequente será fatal para o cluster. Afinal, terá que ser urgente consertado.
Falha do Tuchanka1
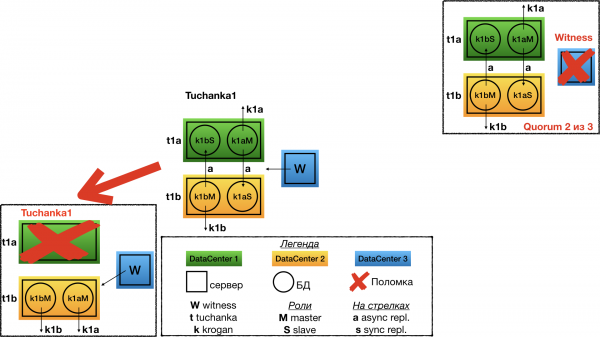
Falha de um dos data centers para o Tuchanka1. Nesse caso witness cederá seu voto ao segundo nó no segundo data center. Lá, o antigo escravo se transforma em mestre, resultando em que ambos os mestres operam em um servidor e ambos recebem seus IPs flutuantes.
Tuchanka2 (clássico)
Estrutura
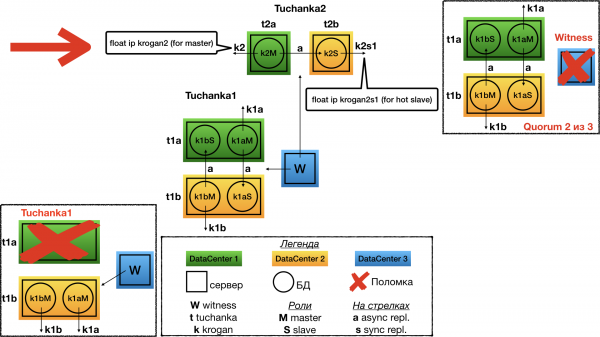
Esquema clássico de dois nós. Em um, opera o mestre; no outro, o escravo. Ambos podem executar consultas (escravo apenas read only), portanto ambos têm IPs flutuantes: krogan2 — para o mestre, krogan2s1 — para o escravo. A alta disponibilidade será mantida tanto para o mestre quanto para o escravo.
No caso de dois nós, a alta disponibilidade só é possível com replicação assíncrona, pois na replicação síncrona, a falha do escravo levará à parada do mestre.
Falha do Tuchanka2
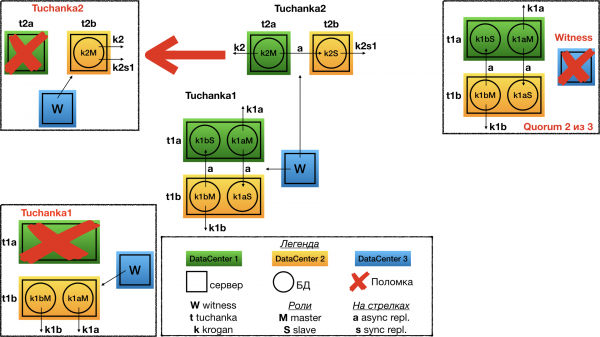
Na falha de um dos data centers witness vota pelo segundo. No único data center em funcionamento, um mestre será levantado, e ambos os IPs flutuantes — o do mestre e o do escravo — apontarão para ele. Naturalmente, a instância deve ser configurada de forma a ter recursos suficientes (limites de conexão, etc.) para lidar simultaneamente com todas as conexões e solicitações dos IPs flutuantes mestre e escravo. Ou seja, durante o funcionamento normal, deve haver uma margem suficiente nos limites.
Tuchanka4 (muitos escravos)
Estrutura
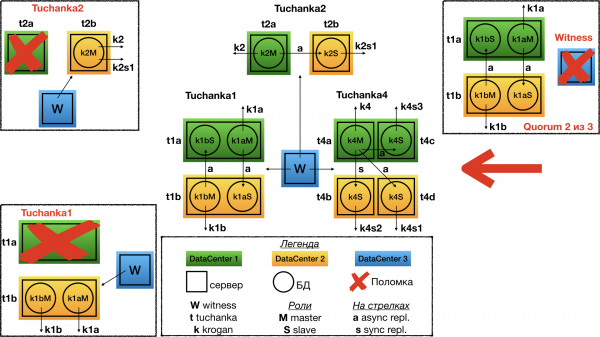
Já é outra extremidade. Existem bancos de dados que recebem muitas solicitações somente de leitura (um caso típico de um site de alta carga). Tuchanka4 é uma situação onde pode haver três ou mais escravos para processar tais solicitações, mas ainda assim não muito. Com um número muito grande de escravos, será necessário inventar um sistema hierárquico de replicação. No caso mínimo (na imagem), há dois servidores em cada um dos dois data centers, em cada um dos quais reside uma instância do PostgreSQL.
Outra característica desse esquema é que aqui já é possível organizar uma replicação síncrona. Ela é configurada para replicar, sempre que possível, para outro data center, e não para a réplica no mesmo data center que o mestre. Tanto o mestre quanto cada escravo apontam para um IP flutuante. Idealmente, entre os escravos, deve haver balanceamento de solicitações por algum proxy SQL, por exemplo, do lado do cliente. Diferentes tipos de clientes podem exigir diferentes tipos de proxy SQL, e somente os desenvolvedores dos clientes sabem quem precisa de qual. Essa funcionalidade pode ser implementada tanto como um demônio externo quanto como uma biblioteca de cliente (pool de conexões), etc. Tudo isso está além do escopo do tema de um cluster de banco de dados tolerante a falhas (a tolerância a falhas proxy SQL pode ser implementada de forma independente, juntamente com a tolerância a falhas do cliente).
Falha Tuchanka4
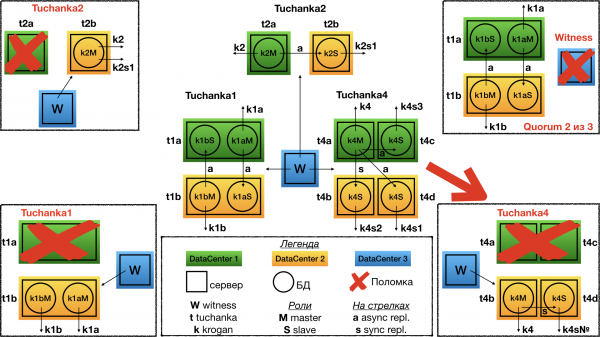
No caso de falha de um data center (ou seja, de dois servidores), o witness vota pelo segundo. Como resultado, funcionam dois servidores no segundo data center: em um está o mestre, e nele aponta o IP flutuante do mestre (para aceitar solicitações de leitura e gravação); e no segundo servidor, funciona um escravo com replicação síncrona, e nele aponta um dos IPs flutuantes dos escravos (para solicitações somente de leitura).
A primeira coisa a ser observada: não serão todos os IPs flutuantes dos escravos que estarão ativos, mas apenas um. E para o funcionamento correto com ele, será necessário que proxy SQL redirecionou todas as solicitações para o único IP float restante; se não, proxy SQL pode listar todos os IPs float dos escravos separados por vírgula na URL de conexão. Nesse caso, libpq a conexão será feita ao primeiro IP de trabalho, assim foi feito no sistema de testes automáticos. Pode ser que em outras bibliotecas, como JDBC, isso não funcione e seja necessário proxy SQL. Isso foi feito porque os IPs float dos escravos não podem ser levantados simultaneamente em um servidor, para que sejam distribuídos uniformemente entre os servidores escravos, caso haja vários em funcionamento.
Segunda: mesmo em caso de falha do data center, a replicação síncrona será mantida. E mesmo que haja uma segunda falha, ou seja, um dos dois servidores no data center restante falhe, o cluster, embora deixe de prestar serviços, ainda manterá informações sobre todas as transações comprometidas, para as quais ele deu confirmação de commit (não haverá perda de informações em caso de falha secundária).
Tuchanka3 (3 data centers)
Estrutura
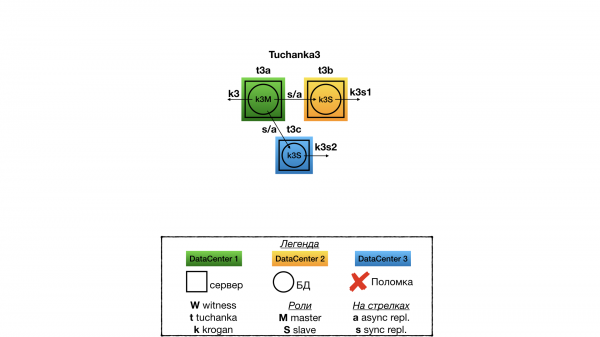
Este é um cluster para situações em que existem três data centers plenamente operacionais, em cada um dos quais há um servidor de banco de dados totalmente funcional. Nesse caso, quorum device não é necessário. Em um data center, o mestre opera, enquanto nos outros dois, os escravos. A replicação é síncrona, do tipo ANY (slave1, slave2), ou seja, o cliente receberá confirmação de commit quando qualquer um dos escravos responder primeiro que aceitou o commit. Um IP float é designado para o mestre e dois para os escravos. Ao contrário do Tuchanka4, todos os três IPs float são tolerantes a falhas. Para balancear consultas SQL somente leitura, você pode usar proxy SQL (com tolerância a falhas separada), ou designar um IP float escravo para metade dos clientes e o outro para a outra metade.
Falha do Tuchanka3
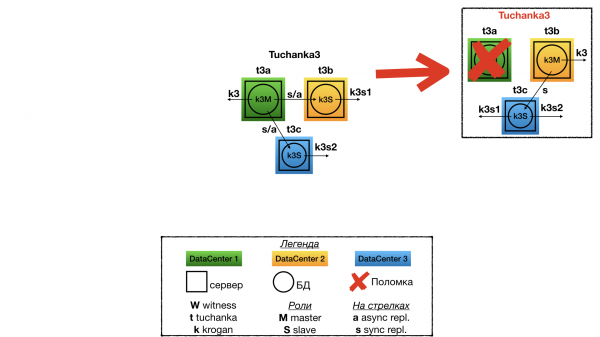
Em caso de falha de um dos data centers, permanecem dois. Em um, o mestre e o IP float do mestre estão ativos; no segundo, o escravo e ambos os IPs float dos escravos (a instância deve ter um suprimento de recursos duplicado para aceitar todas as conexões de ambos os IPs float dos escravos). Entre o mestre e o escravo há replicação síncrona. O cluster também manterá informações sobre transações comprometidas e confirmadas (não haverá perda de informações) em caso de destruição de dois data centers (se forem destruídos não simultaneamente).
Decidi não incluir uma descrição detalhada da estrutura de arquivos e implantação. Quem quiser experimentar, pode ler tudo isso no README. Apresento apenas a descrição do teste automático.
Sistema de teste automático
Para verificar a resistência a falhas dos clusters simulando várias falhas, foi criado um sistema de teste automático. É iniciado por um script test/failure. O script pode aceitar como parâmetros os números dos clusters que deseja testar. Por exemplo, este comando:
test/failure 2 3testará apenas o segundo e o terceiro cluster. Se os parâmetros não forem especificados, todos os clusters serão testados. Todos os clusters são testados em paralelo, e o resultado é exibido no painel tmux. O tmux utiliza um servidor tmux dedicado, portanto o script pode ser executado a partir do tmux padrão, resultando em tmux aninhado. Recomendo usar um terminal com uma janela grande e fonte pequena. Antes de iniciar o teste, todas as máquinas virtuais são revertidas para um snapshot no momento do término do script. setup.
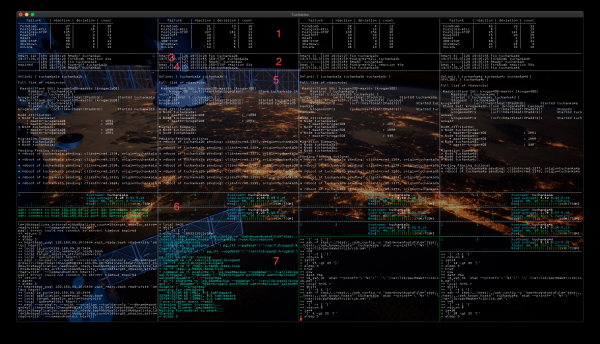
O terminal é dividido em colunas conforme o número de clusters testados, por padrão (na captura de tela) são quatro. O conteúdo das colunas será detalhado usando Tuchanka2 como exemplo. Os painéis na captura de tela estão numerados:
- Aqui é exibida a estatística dos testes. Colunas:
- failure — o nome do teste (função no script) que simula uma falha.
- reaction — a média aritmética do tempo em segundos que o cluster levou para restaurar sua funcionalidade. É medido desde o início do funcionamento do script que simula a falha até o momento em que o cluster recupera sua funcionalidade e é capaz de continuar prestando serviços. Se o tempo for muito curto, por exemplo, seis segundos (o que acontece em clusters com vários escravos (Tuchanka3 e Tuchanka4)), isso significa que a falha ocorreu em um escravo assíncrono e não afetou a funcionalidade, não houve mudanças no estado do cluster.
- deviation — mostra a dispersão (precisão) do valor reaction pelo método de ‘desvio padrão’.
- count — quantas vezes esse teste foi realizado.
- Um registro breve permite avaliar o que o cluster está fazendo no momento atual. É exibido o número da iteração (teste), a timestamp e o nome da operação. Um tempo de execução muito longo (> 5 minutos) indica algum problema.
- heart (coração) — tempo atual. Para avaliação visual da funcionalidade mestre em sua tabela, o tempo atual é constantemente escrito usando o IP float do mestre. Em caso de sucesso, o resultado é exibido neste painel.
- batida (pulso) — "tempo atual" que foi anteriormente registrado pelo script heart no mestre, agora é lido do escravo através de seu IP float. Permite avaliar visualmente a funcionalidade do escravo e da replicação. Em Tuchanka1, não há escravos com IP flutuante (não há escravos fornecendo serviços), mas há duas instâncias (BD), portanto, aqui será exibido não batida, e heart da segunda instância.
- Monitoramento do estado do cluster utilizando a ferramenta
pcs mon. Mostra a estrutura, distribuição de recursos pelos nós e outras informações úteis. - Aqui é exibido o monitoramento do sistema de cada virtualização do cluster. Pode haver mais painéis — quantas virtualizações houver no cluster. Dois gráficos Carga da CPU (nas virtualizações com dois processadores), nome da virtualização, Carga do Sistema (denominado como Média de Carga, pois é calculado pela média de 5, 10 e 15 minutos), dados sobre os processos e distribuição da memória.
- Rastreamento do script que realiza testes. Em caso de falha — interrupção repentina ou ciclo infinito de espera — aqui será possível ver a razão desse comportamento.
Os testes são realizados em duas etapas. Primeiro, o script percorre todas as variedades de testes, escolhendo aleatoriamente a virtualização à qual aplicar este teste. Em seguida, um ciclo infinito de testes é executado, onde a virtualização e a falha são selecionadas aleatoriamente a cada vez. A conclusão repentina do script de teste (painel inferior) ou um ciclo infinito de espera de algo (> 5 minutos de tempo de execução de uma operação, isso é visível no rastreamento) indica que algum dos testes neste cluster falhou.
Cada teste consiste nas seguintes operações:
- Iniciar função que emula a falha.
- Pronto? — aguardando a recuperação do cluster (quando todos os serviços são restabelecidos).
- Mostra o tempo de espera pela recuperação do cluster (reaction).
- Consertar — o cluster está "sendo consertado". Após isso, ele deve retornar ao estado totalmente funcional e preparado para a próxima falha.
Aqui está uma lista de testes com uma descrição do que eles fazem:
- ForkBomb: cria "Out of memory" com o uso de uma fork-bomb.
- OutOfSpace: enche o disco rígido. No entanto, o teste é mais simbólico, dado a carga insignificante que é gerada durante o teste, em caso de sobrecarga do disco rígido, geralmente não ocorre falha no PostgreSQL.
- Postgres-KILL: mata o PostgreSQL com o comando
killall -KILL postgres. - Postgres-STOP: suspende o PostgreSQL com o comando
killall -STOP postgres. - PowerOff: “desliga” a máquina virtual com o comando
VBoxManage controlvm "máquina virtual" poweroff. - Reset: reinicia a máquina virtual com o comando
VBoxManage controlvm "máquina virtual" reset. - SBD-STOP: suspende o daemon SBD com o comando
killall -STOP sbd. - ShutDown: envia para a máquina virtual um comando via SSH
systemctl poweroff, o sistema encerra corretamente. - UnLink: isolamento de rede, comando
VBoxManage controlvm "máquina virtual" setlinkstate1 off.
A finalização do teste pode ser feita com o comando padrão tmux "kill-window" Ctrl-b &, ou com o comando "detach-client" Ctrl-b d: nesse caso, o teste é encerrado, o tmux é fechado e as máquinas virtuais são desligadas.
Problemas identificados no teste
No momento o daemon watchdog sbd processa a parada dos daemons monitorados, mas não a sua suspensão. E, como consequência, falhas que levam à suspensão de apenas Corosync e Pacemaker, mas não suspende sbd. Para verificação Corosync já existe , aceito na branch master. Prometeram (em PR#83) que algo similar também será feito para o Pacemaker, espero que até RedHat 8 eles consigam. Mas tais “falhas” são hipotéticas, facilmente simuladas artificialmente com, por exemplo,
killall -STOP corosync, mas nunca ocorrem na vida real.Na Pacemaker versão para CentOS 7 o parâmetro sync_timeout u quorum deviceestá incorretamente definido, como resultado , para o qual o mestre deveria ter migrado. Isso foi corrigido aumentando sync_timeout u quorum device durante a implantação (no script
setup/setup1). Esta correção não foi aceita pelos desenvolvedores Pacemaker, em vez disso, prometeram reformular a infraestrutura de tal maneira (num futuro indefinido), que esse tempo limite seria calculado automaticamente.Se, ao configurar o banco de dados, foi especificado que em
LC_MESSAGES(mensagens de texto) pode ser usado Unicode, por exemplo,ru_RU.UTF-8, ao iniciar postgres em um ambiente onde o locale não é UTF-8, digamos, em um ambiente vazio (aqui pacemaker+pgsqlms(paf) inicia postgres), então . Os desenvolvedores do PostgreSQL ainda não conseguiram chegar a um acordo sobre o que fazer neste caso. Isso pode ser contornado, é necessário instalarLC_MESSAGES=pt_BR.UTF-8ao configurar (criar) uma instância de banco de dados.Se o wal_receiver_timeout estiver definido (por padrão, é 60s), então ao testar o PostgreSQL-STOP no mestre nos clusters tuchanka3 e tuchanka4 . A replicação é síncrona, portanto, não apenas o escravo, mas também o novo mestre para, sendo necessário definir wal_receiver_timeout=0 ao configurar o PostgreSQL.
Raramente observei a replicação do PostgreSQL travar no teste ForkBomb (sobrecarga de memória). . Eu só encontrei isso nos clusters tuchanka3 e tuchanka4, onde, devido à replicação ser síncrona, o mestre travou. O problema se resolvedeu sozinho após um tempo prolongado (cerca de duas horas). É necessária uma investigação adicional para corrigir isso. Pelo sintomas, parece um bug anterior, causado por outra razão, mas com consequências semelhantes.
A imagem do krogan foi retirada de com a permissão do autor:
Fonte: habr.com
